Command Palette
Search for a command to run...
涓滴皆有用:以少量查询实现最优失真度
涓滴皆有用:以少量查询实现最优失真度
Soroush Ebadian Nisarg Shah
摘要
多智能体系统中的一项基本任务是将 n 个智能体匹配到 n 个备选方案(例如资源或任务)。这一过程通常通过获取智能体对备选方案的序数排名而非其精确的数值效用来实现。尽管这简化了偏好获取过程,但不完整的信息会导致效率损失,这种损失通常由一种最坏情况度量——失真度——来刻画。近期研究表明,每个智能体仅进行少量基数效用查询即可显著改善失真度,Amanatidis 等人(2024)通过每个智能体两次查询实现了 O(n) 的失真度。我们将该结果推广至每个智能体进行 λ 次查询的情形,实现了 O(n1/λ) 的失真度(其中 λ 为任意常数),结合 Amanatidis 等人(2022)的先前下界结果,该结论在常数因子意义下已是最优的。我们将这一发现推广至更一般的社会选择问题,即基于 n 个智能体的偏好从 m 个备选方案中选择一个,实现了 O((minn,m)1/λ) 的失真度(其中 λ 为任意常数),结合已有结果该结论同样是最优的。因此,我们的工作解决了两种设定下关于固定数量基数值查询所能达到的最优失真度的开放问题。
一句话总结
多伦多大学研究人员在多 agent 匹配中,通过每个 agent 进行 λ 次基数效用查询,实现了 O(n1/λ) 的最优失真;并在具有 m 个候选方案的一般社会选择问题中实现了 O((min{n,m})1/λ)。这确定了在固定查询次数下可达到的最优失真这一开放问题。
核心贡献
- 在单边匹配中,n agents 基于序数排名被指派给 n 个候选方案。基数值查询算法对于任意常数 lambda,在给定每个 agent lambda 次查询时实现 O(n^{1/lambda}) 失真,推广了两次查询的 O(sqrt n) 上界,并在常数因子内匹配了先前下界。
- 对于具有 n 个选民和 m 个候选方案的单胜者选举,一种通用方法在给定每个选民 lambda 次基数查询时实现 O((min{n,m})^{1/lambda}) 失真,覆盖了此前 m=o(n) 的开放情形,并在先前下界结果下达到最优失真。
- 对于 1 <= lambda <= log(min{n,m}),算法提供有限查询权衡:O(lambda * min{n,m}^{1/lambda}) 失真,其中包括使用 O(log(min{n,m})) 次查询实现确定性 O(log(min{n,m})) 失真。这种基于 min 的界限还允许将单边匹配建模为具有 n! 个候选方案的单胜者选举,同时在常数因子内保持 O(n^{1/lambda}) 界限。
引言
论文研究人们仅报告排名时如何做出更好的群体决策,例如分配办公空间或选择诊所位置,因为排名可以捕捉偏好顺序,但无法捕捉偏好强度。这对于在保持对参与者的提问认知负担较低的同时最大化社会福利很重要。关于失真的先前工作表明,仅使用序数信息的机制存在较强近似限制,而基数查询可以改善结果;但每个 agent 仅回答少量查询时的最优权衡,尤其是两次查询到对数级查询之间的情形,仍不清楚。作者利用有限数量的基数查询、稳定委员会思想以及改进的序列独裁,设计了确定性多项式算法。对于单边匹配,作者在给定每个 agent 常数 lambda 次查询时实现了渐近最优失真 O(n^{1/\lambda});对于单胜者选举,实现了 O(min{n,m}^{1/\lambda}),包括 agent 数量远多于候选方案数量的开放情形。
方法
作者将核心方法表述为一种自适应机制:从纯序数偏好出发,向每个 agent 发出少量基数值查询,以改善福利保证。该机制族包含两种设定:单边匹配,其中每个 agent 必须被指派一个不同候选方案;单胜者选举,其中选出一个候选方案。两种设定使用相同的算法骨架:偏好决定一个结构化候选集合或匹配集合,基数查询揭示该结构的价值,然后利用揭示出的效用再次设计下一批查询集合。
对于单边匹配,输入包含 n 个 agent 的集合 N 和 n 个候选方案 A。每个 agent i 有一个隐藏效用函数 ui:A→R≥0,但机制最初只观察到诱导出的偏好排序 σi。匹配 M 是 agent 到候选方案的双射,在效用分布 u 下匹配的福利为
sw(M)=i∈N∑ui(M(i)).允许每个 agent 进行 λ 次查询的序数匹配机制,除了偏好分布外,还可以向每个 agent 至多提出 λ 次值查询。查询形式为 Q(i,a),返回 ui(a)。目标是输出一个福利足以与最优福利最大化匹配 OPT(u) 相竞争的匹配,用失真衡量
dist(M)=u▹σmaxsw(M(σ,{Q(i,ai,j)}))sw(OPT(u)),其中,u▹σ 表示隐藏效用与报告的序数偏好一致。
第一个主要模块是通过容量为 k 的序列独裁构造的稳定匹配集合。该子程序接受序数偏好分布 σ、agent 权重 w 和容量参数 k。它从一个包含每个候选方案 k 份副本的多重集开始。按权重非递增顺序处理 agent。当 agent i 出现时,她在仍有剩余容量的候选方案中选择其排名最高的候选方案。输出为映射 g:N→A,其中每个候选方案最多分配给 k 个 agent。
映射 g 随后被分解为 k 个匹配。对于每个候选方案 a,收集所有映射到 a 的 agent,并将第一个这样的 agent 指派给第一个匹配,第二个 agent 指派给第二个匹配,依此类推。由于没有候选方案接收超过 k 个 agent,这会创建 k 个部分匹配,每个部分匹配都可以任意补全为完整匹配。所得的 k 个匹配集合是稳定的,含义如下:不存在另一个匹配 M′ 和一组总权重至少为 w(N)/k 的 agent N′,使得 N′ 中的每个 agent 都严格偏好 M′ 超过构造集合中的每一个匹配。
稳定性论证基于序列独裁的阻碍结构。如果一组 N′ 可以偏离到某个匹配 M′,且 N′ 的所有成员都更偏好 M′ 而非构造集合,那么当算法处理 N′ 中的某个 agent i 时,候选方案 M′(i) 必定已经用完了其 k 份副本。因此,k 个更早处理的 agent 必定选择了 M′(i),并且由于这些更早处理的 agent 在 i 之前被处理,每个权重至少为 w(i)。N′ 中不同 agent 的阻碍者集合互不相交,且 N′ 中的最后一个 agent 无法阻碍 N′ 中的另一个 agent。将所有这类阻碍者的权重相加,总和严格大于 kw(N′),这与 w(N′)≥w(N)/k 矛盾。因此,构造的匹配集合是稳定的。
主要的 λ 次查询匹配机制将该稳定集合子程序用作查询设计模块。它运行多轮,每轮产生一个映射 gr,然后向每个 agent 询问该映射对应候选方案的效用。第一轮使用均匀权重初始化,并运行容量为 n 的序列独裁。由于容量 n 在 agent 全部分配完之前不会被耗尽,每个 agent 都会获得其排名最高的候选方案
g1(i)=σi(1).机制随后向每个 agent 询问 ui(g1(i))。这些揭示出的效用成为下一轮的权重
w2(i)=ui(g1(i)).在第 r 轮,算法设定
αr=n1−(r−1)/λ.它使用权重 wr 和偏好分布 σ 运行容量为 αr 的序列独裁,得到映射 gr,并向每个 agent 询问 ui(gr(i))。下一轮的权重更新为
wr+1(i)=ui(gr(i)).因此该过程是自适应的:第一批查询集合完全由偏好决定,而后续查询集合则由偏好和此前几轮学到的基数值共同决定。
在所有 λ 轮之后,算法构造一个代理效用分布 u。对于每个 agent i 和候选方案 a,代理效用是在已查询候选方案中由偏好支配关系保证的最大基数值。形式化地,
ui(a)=max{ui(b):a≽ib and ui(b) was queried},如果未学到相关效用,则 ui(a)=0。这利用了如下事实:如果 agent i 更偏好 a 而非某个已查询候选方案 b,那么其对 a 的真实效用至少为 ui(b)。机制最终返回最大化代理福利的匹配
M=argMmaxi∈N∑ui(M(i)).福利分析依赖每一轮产生的稳定匹配集合。因为容量为 αr 的序列独裁的输出 gr 可以分解为 αr 个匹配,平均论证表明该分解中至少有一个匹配的代理福利相对于揭示出的效用 ui(gr(i)) 足够大。由于 M 对代理效用是最优的,其福利也至少等于这个平均值。
要将此转化为失真保证,需要根据最优匹配相对于算法查询映射的优势程度对 agent 进行划分。更偏好 OPT 而非 g2 的 agent 构成第一组,更偏好 OPT 而非 g3 但并非更偏好 OPT 而非 g2 的 agent 构成第二组,依此类推。稳定匹配集合的稳定性限制了每个偏离组的总权重,所依据的是该轮使用的权重向量。由于每个权重向量由那些对于该组而言至少与最优候选方案一样好的候选方案的效用构成,因此每组对最优福利的贡献被限制为机制福利乘以因子 n1/λ。对 λ 组求和得到失真
λ⋅n1/λ.该架构可扩展到单胜者选举。输入现在包含 m 个候选方案 C,机制选出一个候选方案。序数部分不变:每个 agent 报告对候选方案的排序。基数部分仍然询问特定候选方案的值。主要算法差异在于,稳定匹配集合被一个近似稳定委员会取代。
大小 k 的委员会 X⊂C 是近似稳定的,如果不存在某个不在 X 中的候选方案 c′∈/X,被总权重过大的 agent 群体一致更偏好于 X 的所有成员。更形式化地,设
V(c′,X)={i∈N:c′≻ic for all c∈X}.那么,当满足
w(V(c′,X))<β⋅kw(N)for all c′∈C∖X.时,X 具有 β 稳定性。
投票机制构造一系列委员会,其大小从大致 min{n,m} 开始几何式缩小,趋向较小的委员会。在每一轮中,机制向每个 agent 询问当前委员会内其最偏好候选方案的效用。答案再次成为该 agent 下一轮的权重。查询阶段结束后,机制使用偏好支配关系,在所有候选方案上构造代理效用,与匹配设定完全相同,并选择代理福利最大的候选方案。
这种对 min{n,m} 而非仅依赖 m 的依赖来自偏好分布顶部的平均论证。如果候选方案数量多于 agent 数量,那么出现于顶部的不同候选方案数量至多为 n,因此可以只对实际出现在顶部的候选方案取平均。如果候选方案数量少于 agent 数量,则对所有 m 个候选方案取平均是合适的。这给出投票失真界限
O(λ⋅min{n,m}1/λ),在仅存在近似稳定委员会的情况下,该界限至多相差稳定因子 β。
该方法也可表述为从匹配或分配问题到投票问题的黑箱归约。给定一个单边匹配实例,可以构造一个单胜者选举,其候选方案为所有可能的匹配。每个 agent 根据自己在那个匹配中获得的候选方案的位置对这些选举候选方案进行排序。对选举中的候选方案进行值查询,等价于询问 agent 在匹配中获得的指派候选方案的效用。由于匹配数量为 n!,投票界限中的相关最大值变为
min{n,n!}=n.将该投票机制应用于诱导出的选举,可得到一种失真形式为 λn1/λ 的匹配机制;如果仅使用近似稳定委员会,还会多出一个常数因子。若使用精确稳定匹配集合子程序,则针对匹配问题的构造可以恢复相同形式,而无需依赖更大的选举候选空间。相同观点也可用于资源分配,其中候选方案可以是所有可能的分配,尽管这样做需要访问指数级大的结果空间上的序数排名。
实验
分析研究标准序数设定下不带值查询的随机投票规则,聚焦受限效用类,尤其是在选民数量和候选方案数量不均衡时,关注单位范围效用和单位和效用。结果表明效用限制导致不同的失真行为:对于单位范围效用,稳定彩票规则在依赖选民数量方面表现更好;而单位和效用则继续迫使失真随选民数量增长而更大。整体而言,研究发现揭示了两类效用模型之间的清晰对比,并证明了在单位和效用下观察到的失真下界对随机规则不可避免。
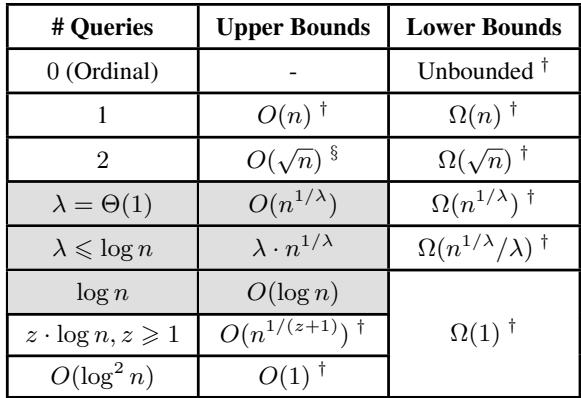
比较概括了在无限制效用条件下,单边匹配中每个 agent 的基数查询数量与最坏情况失真之间的权衡。每个 agent 进行常数数量查询即可实现渐近最优失真,增加查询预算会以实例规模的更小幂次降低失真。结果还在对数级查询预算下改进了先前权衡,用比先前工作更少的查询实现强失真。若没有基数查询,则在无限制效用下,序数匹配可能出现无界失真。对于常数查询预算,新上界在常数因子内匹配已知下界。增加每个 agent 的查询数量会显著降低可达失真界限。新分析使用三次查询即可实现强失真,而较早结果需要对数级查询。
该比较展示了单胜者选举的失真保证如何随每个 agent 的基数值查询数量变化。若没有查询,在无限制效用下,序数规则可能出现无界失真;而更多查询会产生逐渐更紧的上界。一些新界限依赖 agent 数量与候选方案数量中的较小值,这使其在 agent 数量相对于候选方案较少时强于仅依赖候选方案的界限。在没有查询且效用无限制时,序数规则会出现无界失真。常数查询预算实现次线性失真,对数级查询预算实现对数失真。涉及 agent 数量与候选方案数量较小值的界限改进先前仅依赖候选方案的界限。对于受限效用类,无查询失真可以是有限的,并同时依赖 agent 数量与候选方案数量。
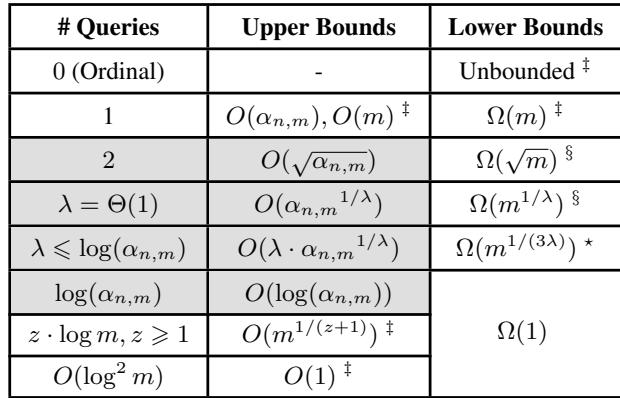
该比较考察在最坏情况失真如何随每个 agent 的基数值查询数量变化,以评估无限制效用条件下的单边匹配和单胜者选举。结果表明基数查询是必要的:没有此类查询的序数机制可能出现无界失真;即便常数级别的小数量查询,也能为匹配提供强且渐近接近最优的保证。在两种设定中,增加查询预算都会逐步改善失真界限,新结果提供了优于先前分析的查询与失真权衡,其中包括保证依赖 agent 数量与候选方案数量中较小值的情形。