Command Palette
Search for a command to run...
JoLT:面向临床时间序列解读的语言与时间序列联合表征学习(学生摘要)
JoLT:面向临床时间序列解读的语言与时间序列联合表征学习(学生摘要)
Yifu Cai Arvind Srinivasan Mononito Goswami Arjun Choudhry Artur Dubrawski
摘要
时间序列与文本数据在医疗领域广泛存在且经常共存,但通常被孤立建模。即便是联合建模时间序列与文本的研究,也往往将时间序列转换为图像或图。我们假设,将时间序列与文本显式地联合建模,可以提升时间序列数据的摘要生成和问答等任务的表现,而这些任务目前关注较少。为弥补这一空白,我们提出 JoLT,从预训练的时间序列模型和文本模型中联合学习所需的表征。JoLT 利用查询 Transformer(Q-Former)对齐时间序列与文本的表征。我们在大规模真实心电图数据集上开展医学时间序列摘要任务的实验,结果表明 JoLT 优于当前最先进的图像描述生成方法。
一句话总结
卡内基梅隆大学的 Auton Lab 提出了 JoLT,该方法通过 Querying Transformer (Q-Former) 联合学习预训练时间序列和文本模型的对齐表示,而非将时间序列转换为图像或图表,从而在医疗时间序列数据的心电图摘要和问答任务上实现了最先进的性能。
核心贡献
- JoLT 被引入作为一种神经模型,通过联合学习预训练时间序列和文本模型的表示,根据时间序列和文本提示生成文本。它显式地对临床时间序列和文本进行建模,而不是分别建模或将时间序列转换为图像或图表。
- 引入 Querying Transformer (Q-Former) 以对齐时间序列和文本表示,提供了将波形信号与自然语言输出连接起来的机制。
- 在 PTB-XL 心电图数据集上进行的医疗时间序列摘要实验表明,JoLT 优于包括 BLIP 和 BLIP-2 在内的最先进图像描述方法,支持了显式时间序列建模的有效性。
引言
临床时间序列和文本数据在常规患者护理中很常见,但解读它们通常需要医疗专业人员付出大量努力。以往的工作大多单独处理这些模态,依赖基于规则的联合方法,或者将时间序列数据转换为图像或图表,而不是直接对原始信号进行建模。作者引入了 JoLT,这是一种学习语言和 time-series 联合表示的神经模型,能够根据 time-series 和文本提示生成文本。在 PTB-XL 数据集上评估 ECG 摘要任务时,JoLT 被展示为首批显式对 time-series 建模以生成有意义文本的自动 ECG 解读方法之一,其性能优于 BLIP 和 BLIP-2 等图像描述基线。
数据集
-
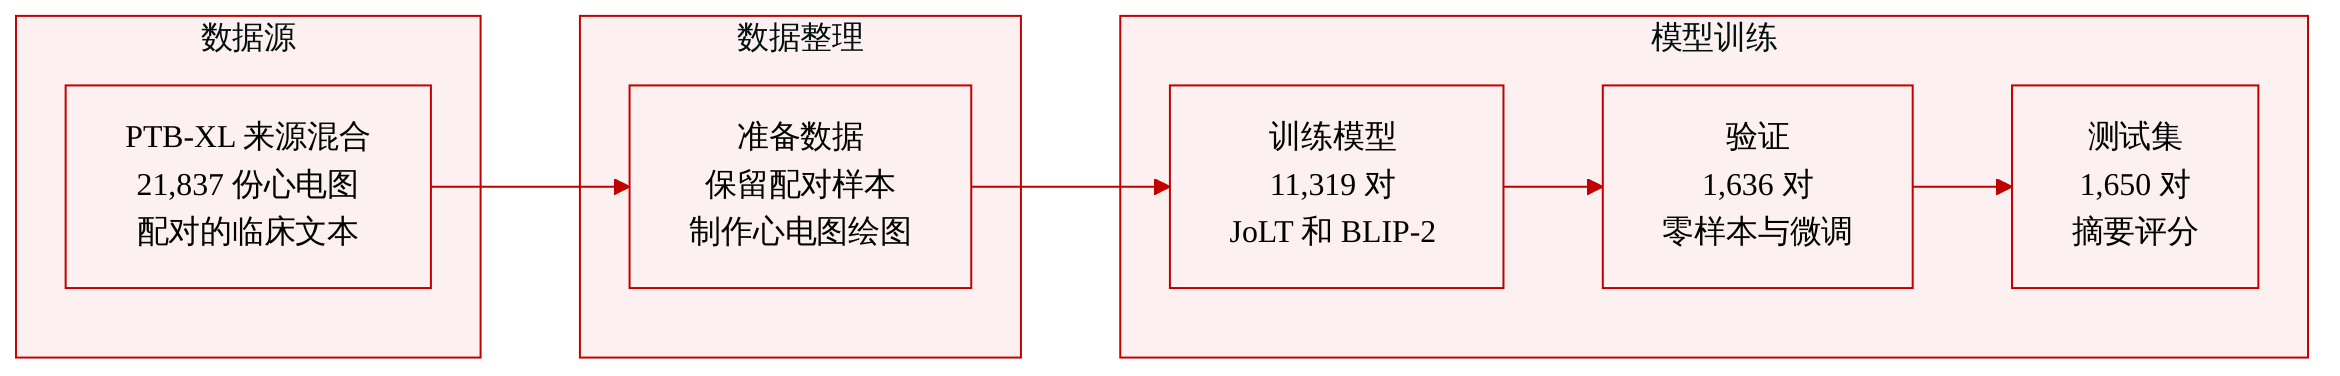
来源和规模:作者使用 PTB-XL 数据集进行 ECG 解读任务。该数据集包含来自 18,885 名患者的 21,837 段十二导联 ECG 记录,每段记录时长为 10 秒。
-
监督子集:部分记录配有金标准临床解读。这些配对的时间序列和文本样本用于训练和微调模型。论文报告了 11,319 个训练样本、1,636 个验证样本和 1,650 个测试样本。
-
结构和标签:每个示例包含一段 ECG 波形记录及其对应的临床文本解读。因此,该数据集支持时间序列到文本的生成,模型从 ECG 信号中生成临床摘要。
-
数据使用方式:作者在配对的 ECG 和解读样本上训练和微调 JoLT。它们还与 BLIP 和 BLIP-2 进行比较,首先在零样本设置下进行比较,然后将 BLIP-2 在相同的 PTB-XL 配对数据上进行微调。
-
输入处理:对于图像描述基线,ECG 时间序列先通过 ECG 绘图工具转换为图形图像,然后输入模型。JoLT 被描述为更直接地对 time-series 特征进行建模,其编码器在少量 PTB-XL 时间序列数据上进行了预训练。
-
其他细节:摘录中未报告除固定 10 秒记录和可用的配对临床文本解读之外的裁剪策略或进一步的元数据构建。
方法
JoLT 将时间序列摘要表述为跨模态生成任务。给定一个具有 C 个通道和长度 L 的多元信号 T∈RC×L,模型被训练以在目标领域产生显著时间模式的文本描述。该架构结合三个组件:基于 transformer 的时间序列编码器、OPT 语言解码器和 Querying Transformer (Q-Former),后者作为 time-series 和 text 表示之间的对齐桥梁。参考框架图:
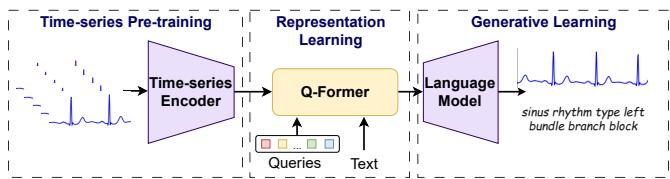
训练过程分为三个阶段。在 time-series 预训练阶段,每个输入信号被分割成不相交的子序列,即 patches。一小部分 patches 被均匀随机掩码,编码器被训练使用均方误差损失重建缺失值。该目标鼓励编码器从无标签时间序列数据中学习有用的潜在表示。
在表示学习阶段,预训练的 time-series 编码器被冻结,Q-Former 被训练以学习捕获与伴随文本相关特征的查询嵌入。Q-Former 通过三个互补目标进行优化。对比损失通过鼓励互信息嵌入来对齐 time-series 和 text 表示。文本生成损失训练 Q-Former 根据 time-series 输入生成文本。时间序列文本匹配损失在配对的或不匹配的时间序列和文本表示之间提供更细粒度的对齐。
在生成学习阶段,time-series 编码器、Q-Former 和 OPT 解码器被连接成单个生成管道。Q-Former 输出学习到的查询嵌入,这些嵌入作为 soft prompts 插入语言解码器中。这些提示引导解码器根据输入 time-series 生成摘要。然后,模型使用因果语言建模损失进行优化,使桥接模块能够将 time-series 证据转换为连贯的自然语言描述。
实验
实验在 PTB-XL 数据集上评估 JoLT 从 ECG 记录生成临床解读的能力,并将其与使用图形 ECG 输入的图像描述基线(如 BLIP 和 BLIP-2)进行比较。结果表明,领域特定的微调对于临床波形解读至关重要,且显式对 time-series 特征进行建模产生的摘要比基于图像的方法更接近临床真实情况。这些发现支持了专门的时间序列表示和更广泛的预训练对医疗文本生成的价值。
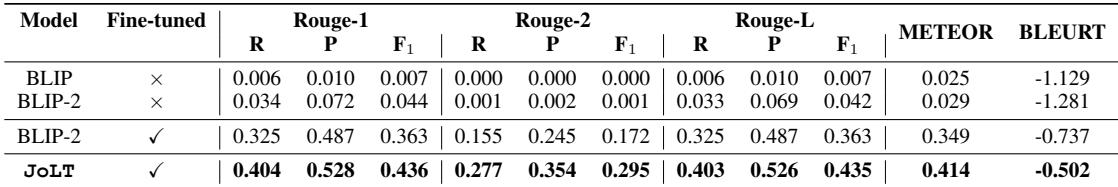
JoLT 生成的 ECG 解读在多个文本质量指标下都比零样本和微调的图像描述基线更接近金标准临床文本。零样本 BLIP 和 BLIP-2 表现出非常弱的性能,而微调后的 BLIP-2 有显著改进,突显了领域特定适应的重要性。JoLT 最强的结果表明,显式对 time-series 特征进行建模有助于产生更有意义的临床摘要。JoLT 在 ECG 解读质量上优于零样本和微调的图像描述基线。微调至关重要,因为零样本 BLIP-2 的性能远差于其微调版本。直接对 time-series 特征进行建模导致解读结果更接近临床真实情况。
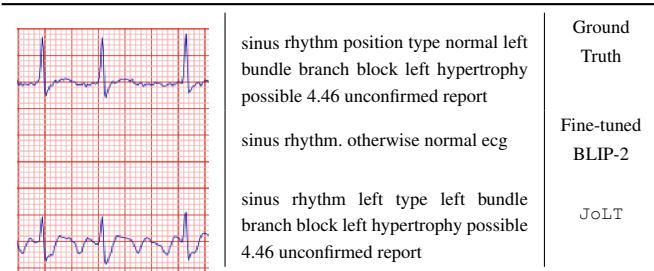
定性比较显示,JoLT 生成的 ECG 解读与真实情况紧密对齐。相比之下,微调后的 BLIP-2 模型识别出正常窦性心律基类,但添加了不准确的发现,使其摘要在临床上不够忠实。JoLT 生成的摘要更紧密地匹配真实情况的 ECG 描述。微调后的 BLIP-2 捕捉到了基心律类,但错误描述了额外的样本细节。该示例表明,直接对 time-series 进行建模可以支持比基于图像的描述更准确的临床摘要。
实验比较了 JoLT 与零样本和微调图像描述基线在 ECG 解读上的表现,使用了文本质量指标和定性示例。结果表明,零样本描述表现较弱,微调改善了与临床文本的对齐,但 JoLT 仍然最接近真实情况的解读,因为它直接对 ECG time-series 特征进行建模。这些发现表明,领域特定的适应和直接的时间建模对于产生临床忠实的 ECG 摘要至关重要。