Command Palette
Search for a command to run...
可靠的冲突多视图学习
可靠的冲突多视图学习
Cai Xu Jiajun Si Ziyu Guan Wei Zhao Yue Wu Xiyue Gao
摘要
多视图学习旨在融合多种特征,以实现对数据更全面的描述。现有大多数工作假设多个视图是严格对齐的。然而,真实世界中的多视图数据可能包含低质量的冲突样本,这些样本在不同视图中表现出矛盾信息。针对该问题的已有方法主要关注通过移除冲突数据或替换冲突视图来消除冲突样本。然而,实际应用场景通常需要对冲突样本做出决策,而不仅仅是将其消除。为解决这一问题,我们提出了一个新颖的可靠冲突多视图学习(Reliable Conflictive Multi-View Learning, RCML)问题,要求模型针对冲突多视图数据给出决策结果及其附带的可靠性。我们针对该问题提出了一种证据式冲突多视图学习(Evidential Conflictive Multi-View Learning, ECML)方法。ECML 首先学习视图特定证据,即从数据中收集到的对各类别的支持程度;进而,可以构建由决策结果和可靠性组成的视图特定意见。在多视图融合阶段,我们提出了一种冲突意见聚合策略,并从理论上证明了该策略能够精确建模多视图公共可靠性与视图特定可靠性之间的关系。在 6 个数据集上的实验验证了 ECML 的有效性。代码已发布于 https://github.com/jiajunsi/RCML 。
一句话总结
来自西安电子科技大学的作者提出可靠冲突性多视图学习(Reliable Conflictive Multi-View Learning, RCML)问题,该问题要求模型为冲突多视图数据提供附带可靠性的决策,并开发了一种证据冲突性多视图学习(Evidential Conflictive Multi-View Learning, ECML)方法,该方法学习视图特定证据以构建带可靠性估计的意见,并引入具有理论保证的冲突意见聚合策略,用于建模多视图共性可靠性与视图特定可靠性。
核心贡献
- 本文引入了可靠冲突性多视图学习设定,要求模型对冲突多视图数据输出决策及相关可靠性,而不是消除或替换冲突视图。
- 本文提出了证据冲突性多视图学习方法,该方法学习视图特定证据,构建包含决策信念和可靠性的视图特定意见,并使用一种已被证明可建模多视图共性可靠性与视图特定可靠性之间关系的策略来聚合冲突意见。
- 在六个公开数据集上的实验表明,ECML 在准确性、可靠性和鲁棒性方面优于最先进的多视图学习基线。
引言
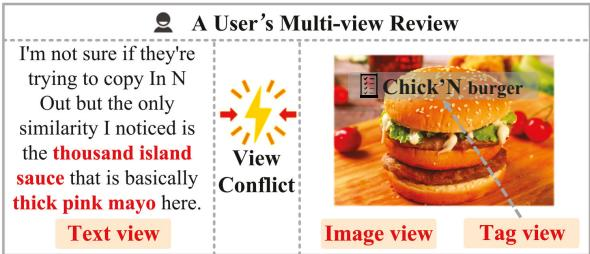
多视图人工智能系统,例如自动驾驶车辆和推荐系统,会从传感器或生成内容中结合互补信息,使得可靠融合成为聚类、检索和推荐的核心。以往方法通常假设视图对齐,或通过检测异常值、丢弃实例、重新对齐等方式解决冲突,但在应用必须对模糊且冲突的数据作出决策时,这些策略并不充分。作者利用证据深度学习来解决这一局限,定义了可靠冲突性多视图学习问题并提出 ECML。该方法学习视图特定证据,将其转化为基于 Dirichlet 的意见,包含信念质量和可靠性,度量跨视图冲突,并聚合意见,使冲突实例获得更低的最终可靠性估计。
数据集
-
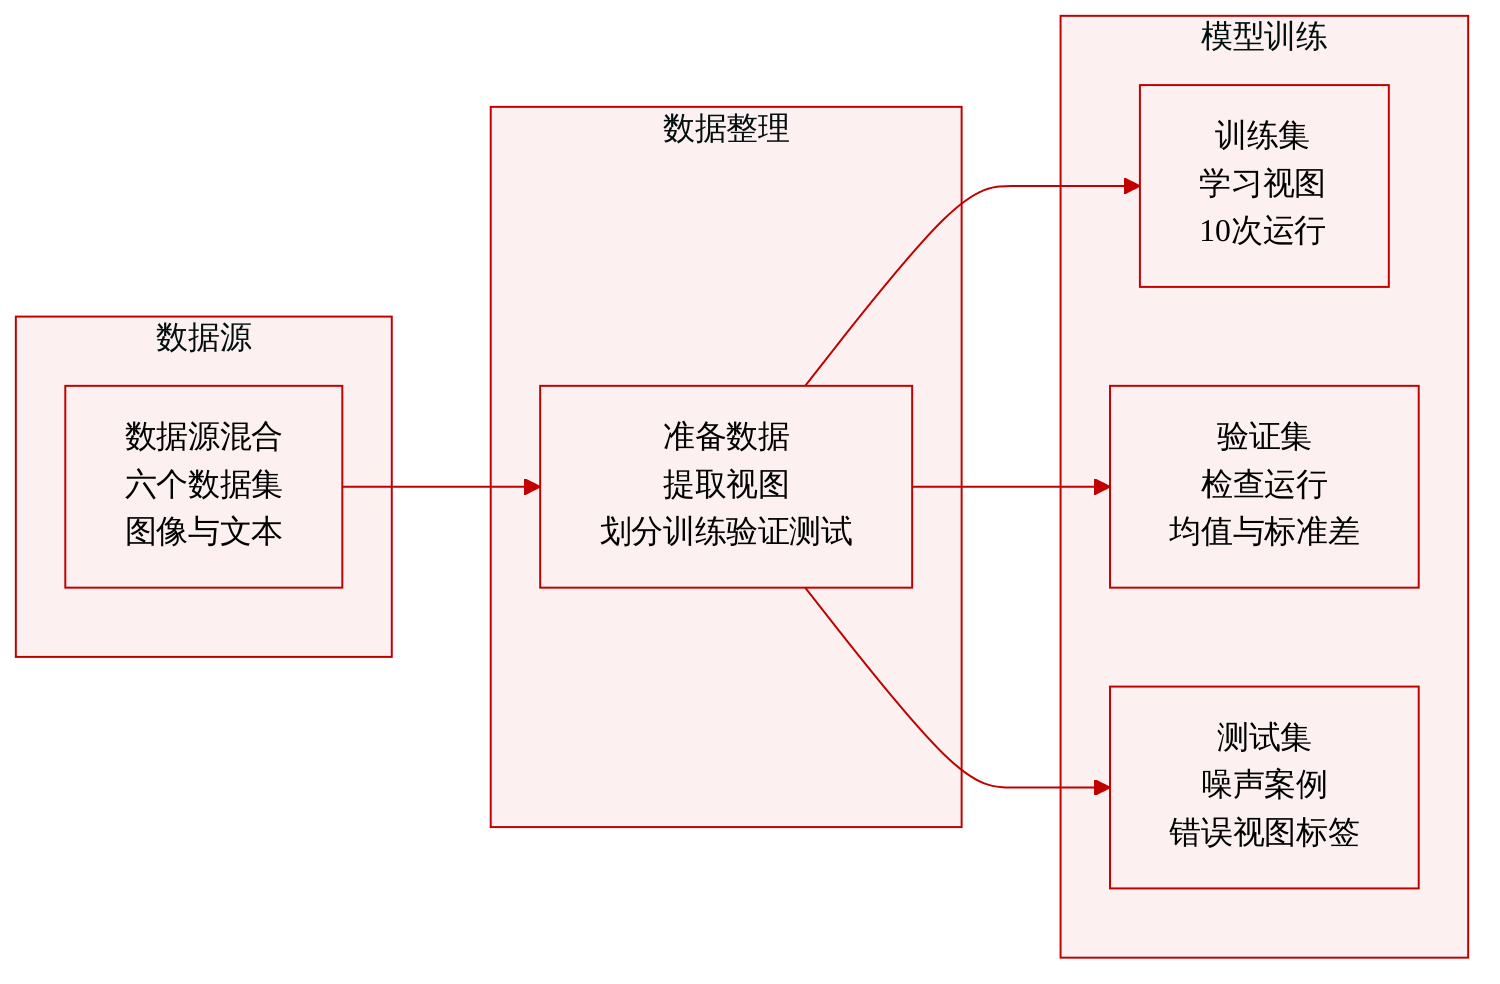
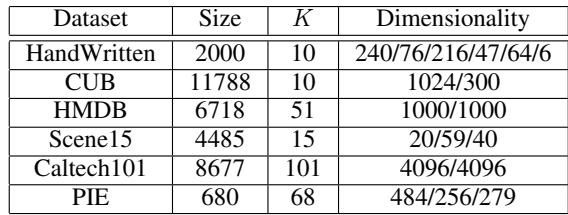
作者使用六个多视图数据集来评估可信多视图特征融合与决策融合。每个数据集由多个特征视图表示,其中一些视图是通过预训练或手工设计的特征提取器从原始图像或文本中提取的。
-
HandWritten 是一个手写数字数据集,包含来自 0 到 9 类的 2000 个实例,每类 200 个模式。本文使用六个特征集表示该数据集。
-
CUB 是一个细粒度鸟类数据集,包含与 200 个鸟类类别相关的 11788 个实例,并带有文本描述。作者将实验限制在前 10 个类别。作者使用 GoogleNet 提取图像特征,使用 doc2vec 提取相应文本特征。
-
HMDB 是一个大规模人体动作识别数据集,包含来自 51 个动作类别的 6718 个实例。对于该数据集,作者使用 HOG 和 MBH 特征作为多个视图。
-
Scene15 包含来自 15 个室内外场景类别的 4485 张图像。作者使用 GIST、PHOG 和 LBP 描述符构建三个特征视图。
-
Caltech101 包含来自 101 个物体类别的 8677 张图像。作者选择前 10 个类别,并使用 DECAF 和 VGG19 提取两个深度特征视图。
-
PIE 包含属于 68 个类别的 680 个实例。作者使用强度、LBP 和 Gabor 特征作为三个视图。
-
这些数据集用于创建多视图表示任务,其中每个数据集提供多个互补视图用于分类。特征提取是数据集准备的一部分,包括 CUB 使用 GoogleNet 和 doc2vec,Caltech101 使用 DECAF 和 VGG19,其他数据集使用 HOG、MBH、GIST、PHOG、LBP、强度和 Gabor 特征。
-
为了构建冲突性测试集,作者对一部分测试实例添加标准差不同的高斯噪声。作者还通过修改选定实例中随机一个视图的信息来创建未对齐视图,使该视图对应的标签与真实实例标签不一致。
-
每个方法在 10 次运行中评估,作者报告均值和标准差,以反映这些冲突性测试设定下的变化。
方法
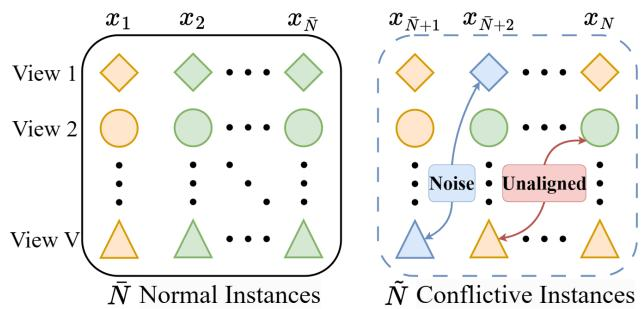
该方法解决可靠冲突性多视图学习问题,其目标是预测测试实例的类别标签,并量化每个预测的可靠性。输入包含 V 个视图,包括正常实例和冲突实例。对于第 n 个实例,第 v 个视图的特征向量表示为 xnv∈RDv,其真实标签由独热向量 yn∈{0,1}K 表示。正常实例具有一致的视图信息,而冲突实例可能包含与主要类别模式不一致的噪声视图或未对齐视图。问题设定如下图所示:
所提出的证据冲突性多视图学习框架有两个主要阶段。第一阶段学习视图特定证据表示。第二阶段通过冲突意见聚合融合视图特定意见,以获得最终多视图决策和不确定性估计。架构如下框架图所示:
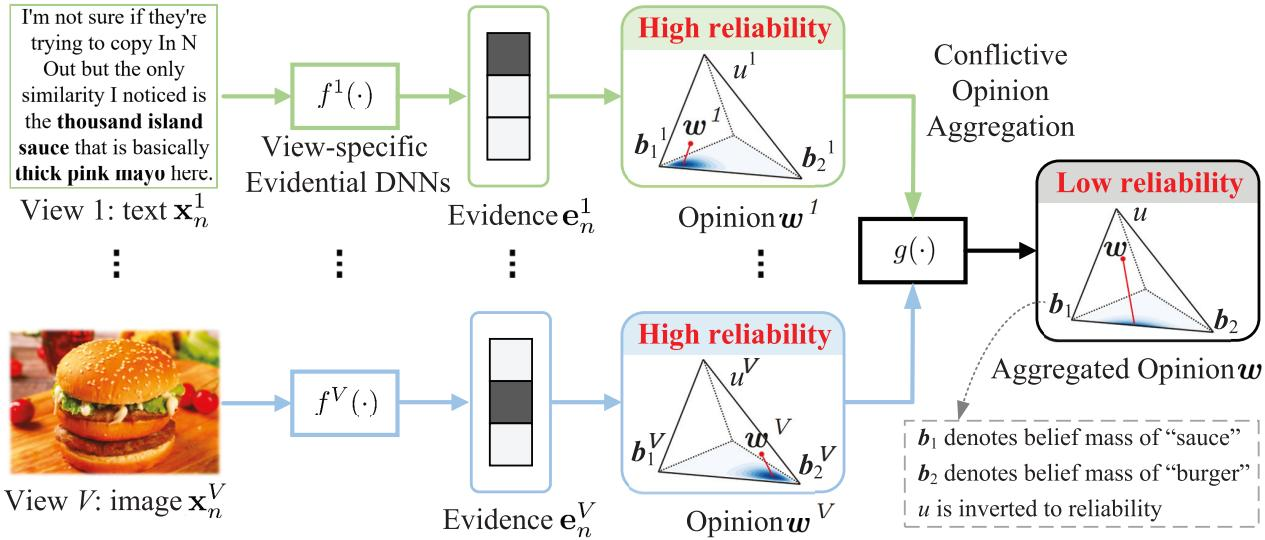
在第一阶段,每个视图由视图特定的证据深度神经网络 fv(⋅) 处理。这些网络输出非负证据向量 env,用于度量每个类别收集到的支持程度。随后,证据被转换为 Dirichlet 分布参数:
αnv=env+1.Dirichlet 强度定义为
Snv=k=1∑Kαnkv.从 Dirichlet 参数中,构建视图特定的多项式意见。类别 k 的信念质量和不确定性质量计算为
bnkv=Snvαnkv−1,unv=SnvK.类别 k 的投影概率为
pnkv=Snvαnkv.因此,每个视图不仅产生类别分布,还产生不确定性质量。较低的证据导致更高的不确定性,更强的证据导致更高的置信度。
为了在训练期间促进视图特定模型之间的一致性,该方法引入两个意见之间的冲突度。对于意见 wp 和 wq,冲突度为
c(wp,wq)=cp(wp,wq)⋅cc(wp,wq),其中
cp(wp,wq)=21k=1∑K∣pkp−pkq∣度量两个视图之间的投影概率距离,
cc(wp,wq)=(1−up)(1−uq)度量合取确定性。当两个视图都非常确信但产生相互冲突的类别概率时,冲突度会变得很大。最小化这一项会迫使视图特定网络学习共享的多视图信息,并减少由不可靠的单视图决策引起的错误冲突。
在融合阶段,该方法使用冲突意见聚合来聚合视图特定意见。对于两个意见 wA 和 wB,聚合后的信念质量为
bkA⋄B=uA+uBbkAuB+bkBuA,聚合后的不确定性为
uA⋄B=uA+uB2uAuB.聚合后的基础概率为
akA⋄B=2akA+akB.该规则比标准融合方法更谨慎地处理冲突意见。如果结合了一个高度不确定的意见,聚合后的不确定性可能增加,而不会自动下降。这一行为对冲突多视图数据很重要,因为可靠视图之间的不一致可能表明决策不可靠。对于多个视图,最终联合意见通过顺序聚合获得:
w=w1⋄w2⋄⋯⋄wV.融合阶段可以通过对视图特定证据进行简单平均池化层来实现,对应于冲突意见聚合规则。
在训练时,传统深度网络的 softmax 层被替换为非负激活层,使网络输出可解释为证据。分类损失针对基于 Dirichlet 的预测进行了适配。对于一个实例,基于证据的交叉熵项为
Lace(αn)=j=1∑Kynj(ψ(Sn)−ψ(αnj)),其中 ψ(⋅) 是 digamma 函数。为惩罚保留在错误类别上的误导性证据,加入 KL 散度项:
LKL(αn)=KL[D(pn∣α~n)∥D(pn∣1)],其中
α~n=yn+(1−yn)⊙αn.KL 权重在训练过程中进行退火:
λt=min(1.0,t/T),从而使 KL 正则化逐渐增加,防止被误分类实例过早收敛到均匀分布。
训练目标包含三个部分:用于融合 Dirichlet 预测的联合证据损失、用于每个单视图预测的视图特定证据损失,以及基于冲突度的一致性损失:
Lcon=V−11p=1∑Vq=p∑Vc(wnp,wnq).总损失为
L=Lacc(αn)+βv=1∑VLacc(αnv)+γLcon,其中
Lacc(αn)=Lace(αn)+λtLKL(αn).通过这一训练过程,模型学会收集视图特定证据,产生校准后的不确定性估计,强制跨视图一致性,并以反映视图之间一致与冲突的方式聚合意见。
实验
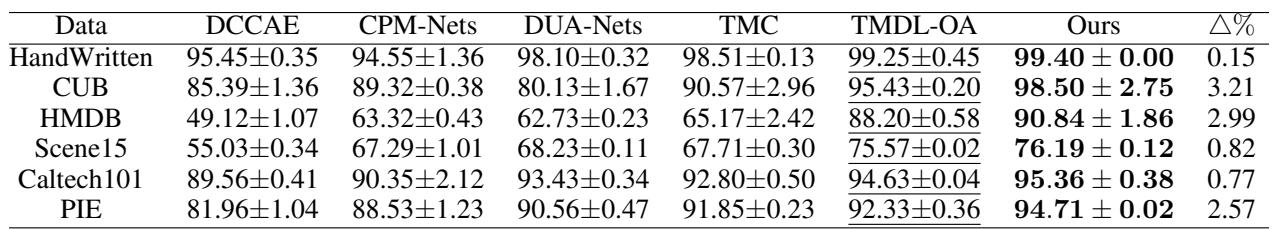
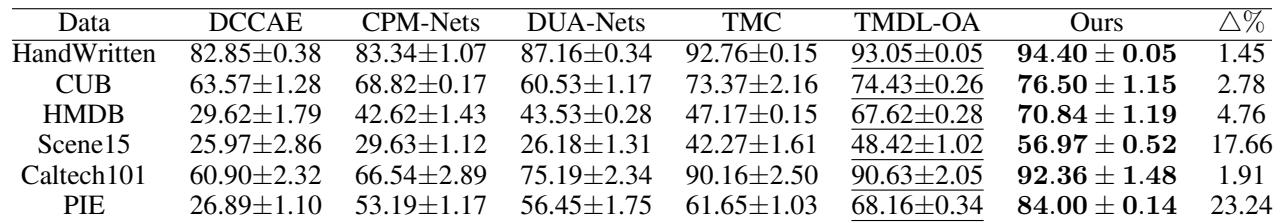
ECML 在六个真实世界多视图数据集上与特征融合和决策融合基线进行评估,并使用包含噪声或未对齐视图的正常和人工冲突性测试集。实验验证了分类性能、冲突度度量和不确定性估计。该方法在正常数据上优于基线,在视图冲突时保持鲁棒,并使更高的不确定性与更大的噪声或冲突相对应,从而支持其在多视图学习中的可靠性与有效性。
表格总结了具有不同规模、类别数量和特征视图的多视图数据集,包括手写数字、鸟类、动作、场景、物体和人脸。某些数据集使用一种或多种互补特征类型,例如 CUB 使用图像和文本特征,HMDB 使用 HOG 和 MBH 特征。实验场景还在正常、噪声和错对齐视图设定下评估这些数据集。数据集特征视图在模态上存在差异,其中 CUB 结合图像和文本特征,Scene15 使用多种局部特征类型。评估包括通过添加高斯噪声和在随机视图中错对齐信息来创建的冲突视图。
在正常多视图分类测试中,与基于决策融合和多视图学习的基线相比,ECML 在每个数据集上都取得了最高准确率。在仍有较大提升空间的数据集上,增益更大,例如 HMDB 和 CUB,而在基线表现已经较好的数据集上,该方法仍然提高了准确率。ECML 在正常测试集上持续优于所有列出的基线。该方法在 HMDB 和 CUB 等具有挑战性的数据集上表现明显优势,相对于最强基线的准确率差距较大。
所提方法在所有评估的冲突性测试集上均取得最高准确率,并相对以往多视图决策融合基线保持优势。相对增益在 PIE 和 Scene15 等数据集上最为明显,而在 HandWritten 和 Caltech101 上优势较小。结果表明,对视图特定冲突进行建模有助于在视图内容存在噪声或错对齐时保持分类性能。准确率在冲突性评估下通常会下降,但所提方法仍强于所有比较基线。该方法在易冲突或更难的数据集,包括 PIE 和 Scene15,上显示出更大的相对提升。冲突意见聚合与对视图特定冲突的感知能力相关联,并带来对噪声或未对齐视图更好的鲁棒性。
实验在具有不同规模、类别、特征视图以及包含噪声或错对齐的正常和冲突设定的多个数据集上评估多视图分类。所提出的 ECML 方法持续优于决策融合和多视图学习基线,并在 HMDB 和 CUB 等更具挑战性的数据集上取得特别明显的提升。在冲突性评估下,它仍然是最准确的方法,尤其是在 PIE 和 Scene15 等对视图冲突敏感的数据集上,这表明对视图特定冲突进行建模能够提升对噪声或未对齐视图的鲁棒性。