Command Palette
Search for a command to run...
GxVAEs:两个联合变分自编码器从基因表达谱生成类苗头分子
GxVAEs:两个联合变分自编码器从基因表达谱生成类苗头分子
Chen Li Yoshihiro Yamanishi
摘要
从头生成具有生物活性和类药性的类苗头分子是计算机辅助药物发现中的一项重要任务。尽管人工智能能够生成具有理想化学性质的分子,但大多数已有研究忽略了疾病相关细胞环境的影响。本研究提出了一种名为 GxVAEs 的新型深度生成模型,通过利用两个联合变分自编码器(VAE),从基因表达谱生成类苗头分子。第一个 VAE——ProfileVAE,从基因表达谱中提取潜在特征。提取的特征作为条件,引导第二个 VAE——MolVAE 生成类苗头分子。GxVAEs 弥合了分子生成与生物系统中细胞环境之间的差距,能够在特定疾病背景下生成具有生物学意义的分子。关于治疗性分子生成的实验和案例研究表明,GxVAEs 优于当前最先进的基线方法,能够生成具有潜在生物活性和类药性质的类苗头分子。我们成功从患者的疾病谱中生成了针对多种疾病具有潜在治疗效果的分子结构。
一句话总结
名古屋大学提出 GxVAEs,这是一种深度生成模型,利用 ProfileVAE 和 MolVAE 两个联合变分自编码器,连接分子生成与细胞环境,直接根据基因表达谱生成具有生物活性和类药性质的类苗头分子,并在治疗性分子生成中超越当前最优基线方法。
核心贡献
-
GxVAEs 是由 ProfileVAE 和 MolVAE 两个联合变分自编码器构成的深度生成模型,旨在根据基因表达谱生成类苗头分子。
-
ProfileVAE 从基因表达谱中提取潜在特征,MolVAE 将这些特征作为条件信号,在疾病特异性细胞背景下生成具有生物学意义的分子。
-
实验和案例研究表明,GxVAEs 优于当前最优基线,生成具有潜在生物活性和类药性质的类苗头分子,并能从患者疾病谱中生成候选治疗分子结构。
引言
Hit 识别旨在从巨大的化学空间中寻找具有所需生物活性的分子,但传统高通量筛选速度慢、成本高且命中率低;而 de novo 生成式 AI 虽可创建分子,却往往优化化学性质而不考虑细胞疾病背景。基因表达组学和其他组学数据能够捕获与疾病相关的细胞响应,但高质量组学数据有限,整合这类数据复杂,且早期类苗头生成方法生成的分子存在有效性低、配体靶标关联弱或仅部分利用表达谱等问题。该研究利用 ProfileVAE 和 MolVAE 两个联合变分自编码器,从基因表达谱中提取特征并将其作为条件,生成类苗头分子,从而将分子生成与疾病特异性生物背景连接起来,并优于先前基线。
数据集
-
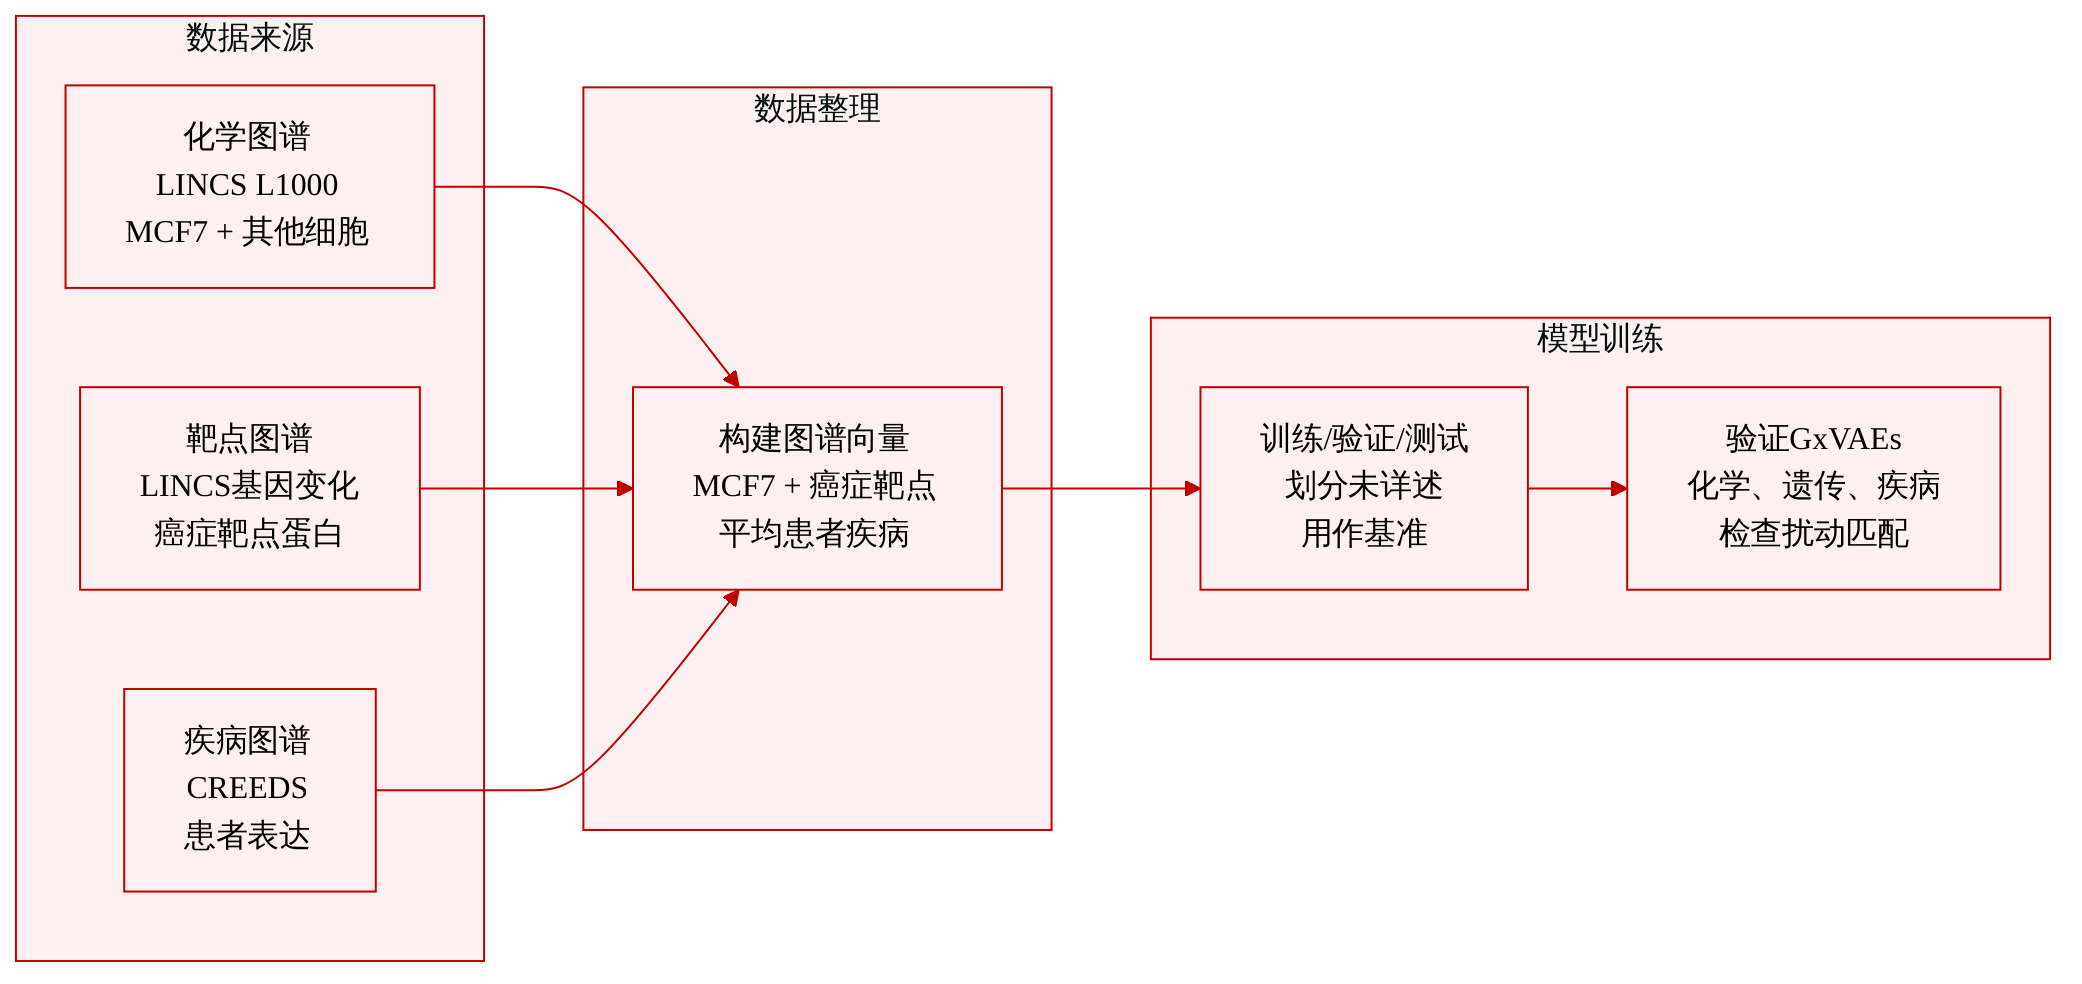
该研究基于三类基因表达谱构建评估数据,用于测试 GxVAEs:
- 化学诱导谱:取自 LINCS L1000 数据库,化学扰动由 77 个人类细胞系的表达谱表示;论文聚焦经 13,755 个分子处理的 MCF7 细胞系。
- 靶点扰动谱:取自 LINCS 数据库,表示相同 77 个人类细胞系中靶蛋白的基因敲低或过表达。
- 疾病特异性谱:取自 CREEDS 数据库,使用包含 14,804 个基因的表达谱表示疾病;示例包括胃癌、特应性皮炎和阿尔茨海默病。
-
关键数据集细节:
- 化学子集规模:13,755 个 MCF7 扰动谱。
- 靶点子集筛选:为便于公平比较,沿用先前研究使用的同一靶蛋白集,包括 AKT1、AKT2、AURKB、CTSK、EGFR、HDAC1、MTOR、PIK3CA、SMAD3 和 TP53。
- 疾病子集构建:将多位患者的基因表达谱取平均,形成每个疾病的单一表达谱。
-
模式与表示:
- 每个样本表示为基因表达谱,本质上是对所测基因构成的向量。
- 化学扰动数据将表达谱与化合物处理相关联,而靶点扰动数据将表达谱与特定治疗蛋白的遗传扰动相关联。
- 疾病谱将患者层面的表达信号聚合为疾病层面的表达谱。
-
该研究如何使用数据:
- 三类表达谱用于在化学、遗传和疾病扰动场景中验证所提出的 GxVAEs。
- 靶点扰动子集按已知癌症相关蛋白进行筛选,以与先前方法对齐。
- 论文未报告详细的训练/验证/测试划分,因此所述数据集主要作为模型评估的基准输入。
方法
该研究采用名为 GxVAEs 的两阶段联合 VAE 架构。该系统连接基因表达表示模块与分子生成模块。ProfileVAE 作为特征提取器,将高维基因表达谱压缩为紧凑潜在向量。随后,MolVAE 将这些潜在向量作为条件来生成分子字符串。参见框架图。
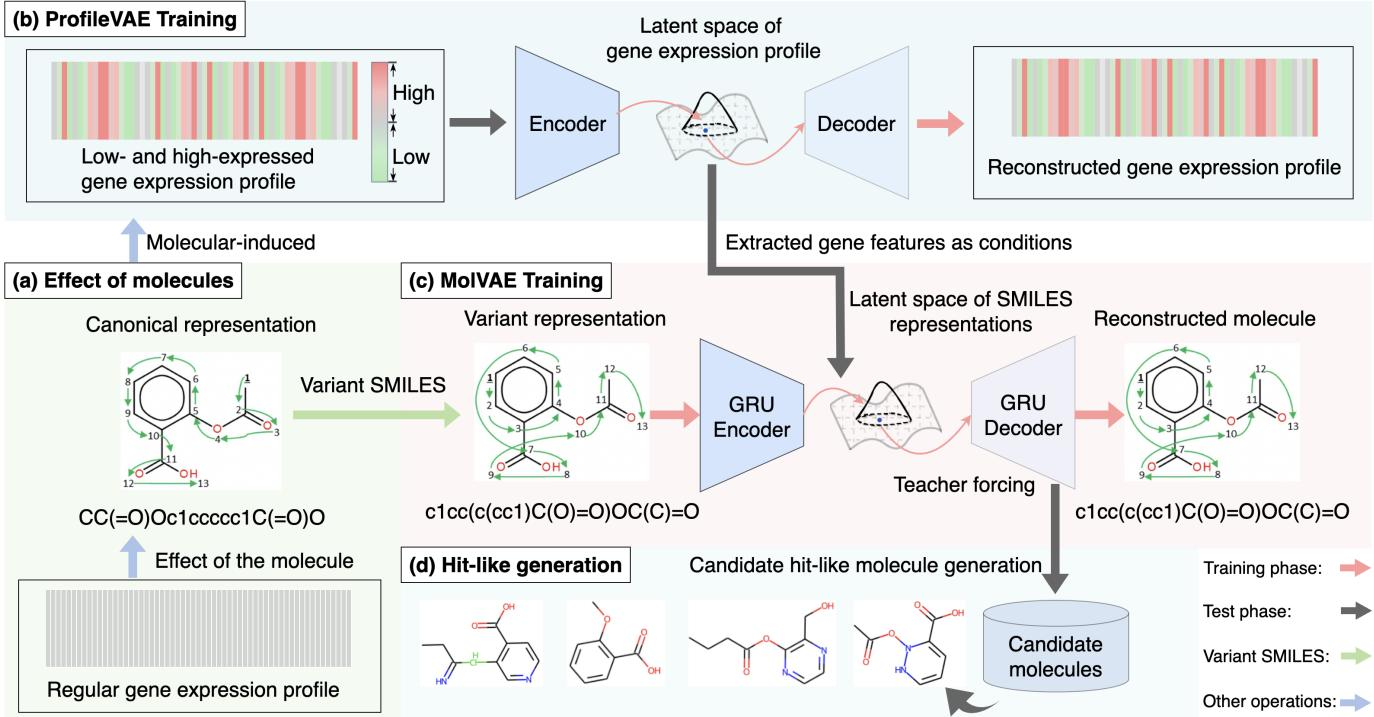
ProfileVAE 在基因表达谱上训练。包含 K 个基因的表达谱表示为 X=[x1,x2,…,xK],其中 xk 表示第 k 个基因的表达值。编码器将 X 映射为潜变量 C,解码器从 C 重建 X。预期目标为最大化该表达谱的边缘似然:
θ,ϕmaxEqθ(C∣X)[logpϕ(X∣C)].相应的变分损失结合重建项与正则化项:
LG(θ,ϕ)=Eqθ(C∣X)[logpϕ(X∣C)]−βDKL(qθ(C∣X)∥pϕ(C)).这里 β 控制 KL 散度项的权重。推理阶段,使用重参数化技巧采样潜在向量:
C=μ+σϵ,ϵ∼N(0,I),其中 μ 和 σ 是潜在高斯分布预测的均值和标准差。
MolVAE 生成以 SMILES 字符串表示的分子。设 S=[s1,s2,…,sT] 表示长度为 T 的 SMILES 序列。解码器将分子建模为以分子潜变量 Z 和基因表达特征 C 为条件的自回归序列:
pφ(S∣Z)=t=1∏Tpφ(st∣s1:t−1,Z,C).MolVAE 优化分子重建的变分下界:
LS(φ,ψ)=Eqψ(Z∣S)[logpφ(S∣Z,C)]−DKL(qψ(Z∣S)∥pφ(Z)).分子序列部分使用双向 GRU 结构。训练期间,该研究采用变体 SMILES,即同一分子图的非规范序列化。由于同一分子可从不同起始原子遍历,多个有效 SMILES 字符串可表示同一结构。这种训练目标多样性有助于鼓励生成多样化分子。
MolVAE 训练采用教师强制。在每个解码步骤,模型接收真实前缀 s1:t−1,而不依赖模型自身先前输出。这会减少误差累积,稳定学习并加速收敛。
完整工作流遵循分阶段流水线。首先训练 ProfileVAE,并仅保留其编码器。编码器从给定表达谱中提取基因表达特征 C。随后,MolVAE 以 C 为条件,并使用对应 SMILES 序列作为目标进行训练。MolVAE 训练完成后,仅保留其解码器。最终生成模型将 ProfileVAE 编码器与 MolVAE 解码器组合。推理时,未知基因表达谱经 ProfileVAE 编码器得到 C,MolVAE 解码器在该特征向量条件下生成分子字符串。
实验
实验使用来自 LINCS 和 CREEDS 的化学诱导、靶点扰动和疾病特异性基因表达谱,以评估 GxVAEs 的分子生成能力。表达谱重建和分子生成测试表明,ProfileVAE 保留了生物表达模式,MolVAE 生成有效且化学上合理的化合物。额外的靶蛋白配体生成和疾病逆转案例研究表明,与基线模型相比,GxVAEs 能够生成具有较强结构相似性和治疗相关性的类苗头治疗候选分子。
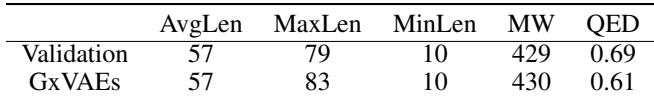
GxVAEs 生成的分子在 SMILES 长度和分子量分布上与验证集高度匹配,平均长度和分子量基本一致,最大长度略高。QED 分数与验证分子保持相当,支持模型在生成有效候选物的同时保留关键化学性质分布的结论。生成的 SMILES 具有与验证集几乎相同的平均长度和最小长度,平均分子量也几乎相同。生成的 SMILES 最大长度略高于验证集。QED 分数略低但分布相似,表明化学质量合理。
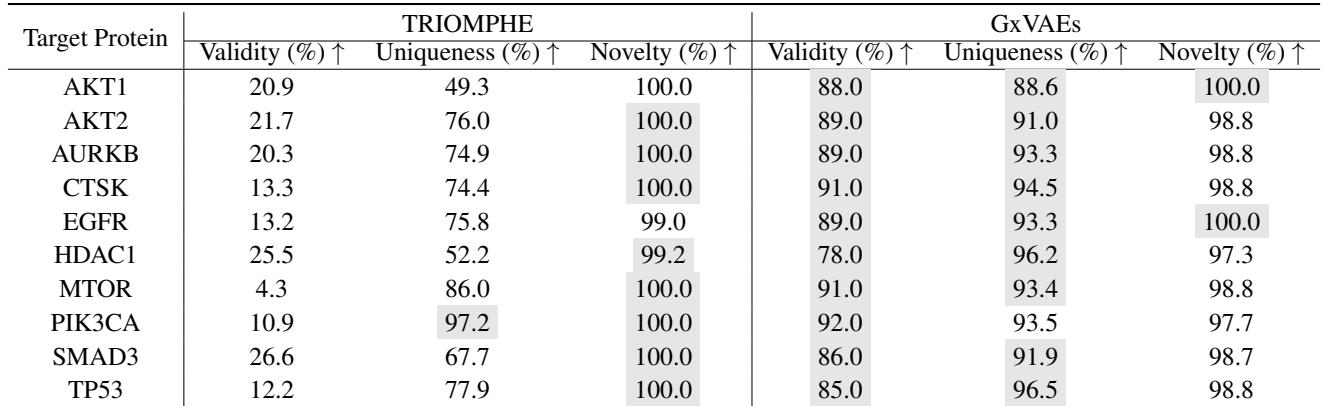
在所报告的靶蛋白上,GxVAEs 生成的有效分子数量显著多于 TRIOMPHE,同时生成的候选物具有更高唯一性。两种方法的新颖性都很高,尽管 GxVAEs 并非在每种情况下都超过基线,但整体仍具竞争力。这些结果说明,GxVAEs 可以利用基因表达谱生成更可用、更多样化的类配体候选物。GxVAEs 在评估靶标上显著高于 TRIOMPHE 的有效性。GxVAEs 在生成分子中提升唯一性,同时保持较强多样性。两种方法的新颖性都保持高位,GxVAEs 在多数情况下与基线持平或接近。
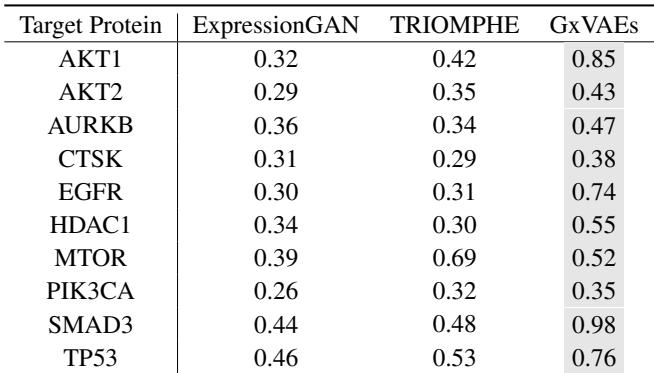
该比较展示了 ExpressionGAN、TRIOMPHE 和 GxVAEs 在多个蛋白靶标上生成的类配体分子的 Tanimoto 系数。GxVAEs 在多数列出的靶标上取得最高分数,在 AKT1 和 EGFR 上提升尤为明显,但其中一个靶标 MTOR 的 GxVAEs 分数较低。这些模式支持如下结论:与基线相比,GxVAEs 常能生成与已知配体具有更强结构相似性的候选分子。与两个基线相比,GxVAEs 在多数列出的蛋白靶标上产生更高的 Tanimoto 系数。所提出模型在 AKT1 和 EGFR 上显示出特别强的提升。性能并非在所有靶标上均匀,MTOR 的 GxVAEs 分数低于 TRIOMPHE。
该比较聚焦于在多个治疗靶标上针对已知配体生成的类苗头分子,具体展示结构相似度最高的情况。在所示靶标示例中,GxVAEs 生成的分子比 ExpressionGAN 和 TRIOMPHE 基线更接近相应已知配体。这表明在比较靶标上,类配体结构特征的保留更一致。图中显示,与两个基线生成的分子相比,GxVAEs 分子在结构上更接近已知配体。比较涵盖多个治疗靶标,包括 AKT1、AKT2、EGFR 和 MTOR。突出展示的是每个对应已知配体的最高相似度分子。
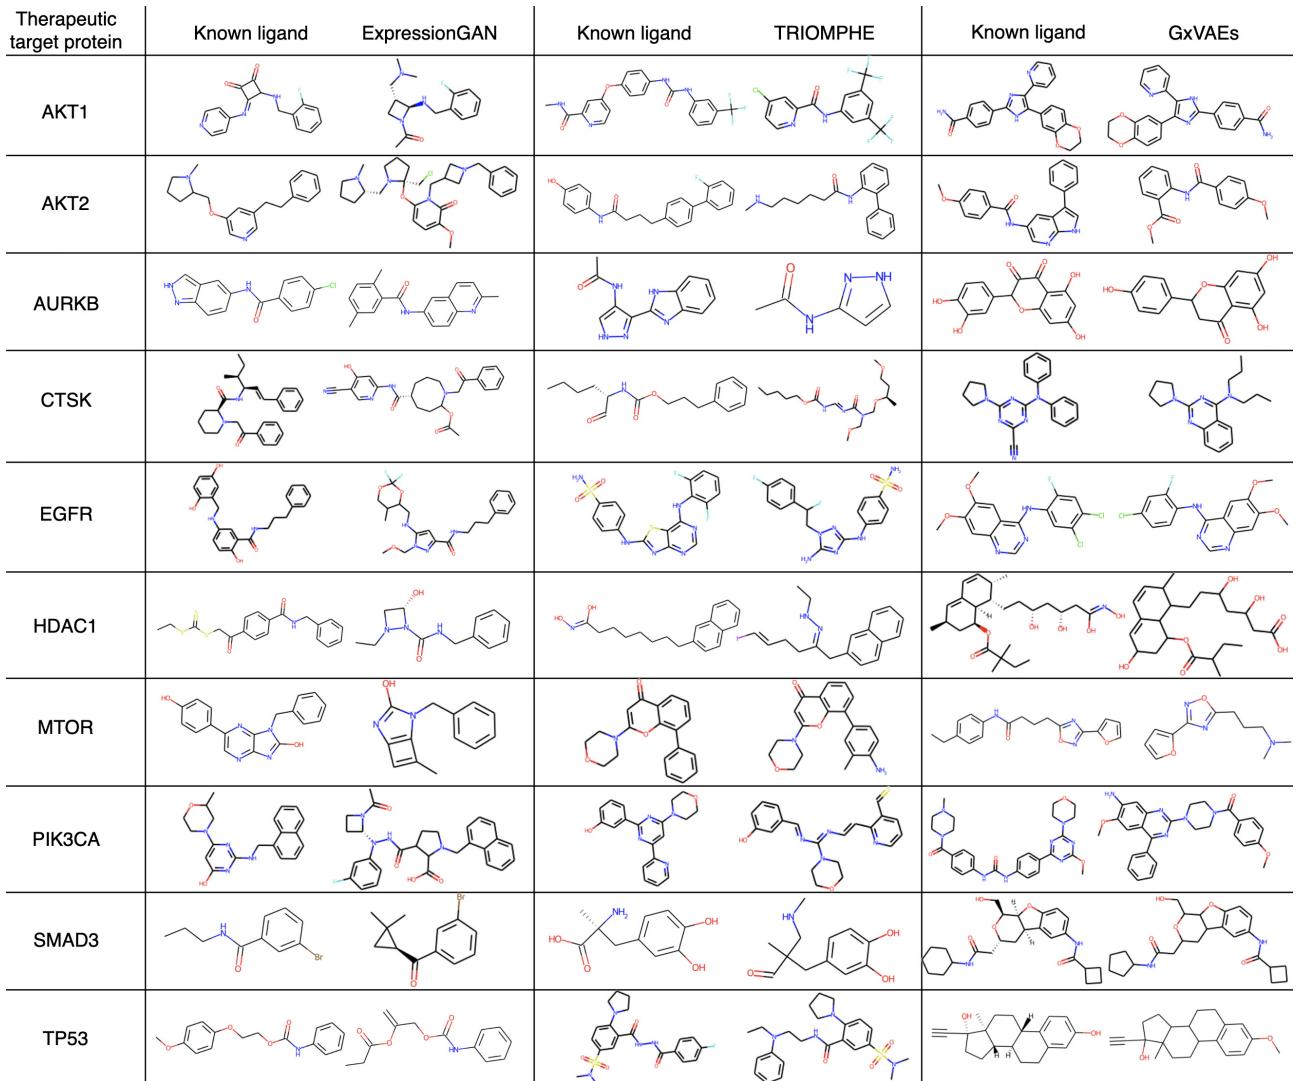
实验将 GxVAE 生成分子与验证集及基线 ExpressionGAN 和 TRIOMPHE 在多个蛋白靶标上进行评估。GxVAE 输出保留了真实的化学分布,包括 SMILES 长度、分子量和 QED 质量,同时产生数量明显更多、唯一性更高且具有高新颖性的分子。比较性 Tanimoto 分析表明,与基线相比,GxVAEs 常生成与已知配体具有更强结构相似性的类配体候选物,尤其在 AKT1 和 EGFR 上,尽管并非在每个靶标上都始终最高。