Command Palette
Search for a command to run...
面向序列决策的偏好比例聚合
面向序列决策的偏好比例聚合
Nikhil Chandak Shashwat Goel Dominik Peters
摘要
我们研究给定选民偏好时公平序列决策的问题。在每一轮中,决策规则需要从一组备选方案中选择一个方案,每位选民报告其认可哪些备选方案。我们不采用每轮选择最热门方案的策略,而是借鉴多胜者投票文献中的公理,追求比例代表制。这些公理要求:若一个占 α% 的选民群体在每一轮都达成一致(即认可同一个备选方案),则这些选民必须认可至少 α% 的决策。该公理的一个更强版本要求:若一个占 α% 的选民群体在 β 比例的轮次中达成一致,则这些选民必须认可 β · α% 的决策。我们证明三种具有吸引力的投票规则满足此类公理。其中一种(顺序 Phragmén)在线做出决策,另外两种满足公理的加强版本,但分别以半在线(均分份额法)或完全离线(比例认可投票)的方式做出决策。我们基于合成数据和美国政治选举给出了这些规则的实证结果。我们还利用 Moral Machine 数据集关于道德困境的进行了实验。我们训练偏好模型对不同国家用户的回答进行建模,并让模型进行投票。我们发现,使用我们的规则聚合这些投票,相比使用单一全局偏好模型做出决策,能在不同人口统计群体之间实现更均等的效用分配。
一句话总结
IIIT Hyderabad、CNRS、LAMSADE 和 Université Paris Dauphine - PSL 证明,Sequential Phragmén、Method of Equal Shares 和 Proportional Approval Voting 满足受多优胜者投票启发、面向序贯决策的比例性公理。在合成数据、美国选举以及基于 moral machine 数据集训练的偏好模型上的实验表明,与单一全局偏好模型相比,这些规则能实现各人口统计群体之间更均衡的效用分布。
核心贡献
-
该工作为序贯审批投票形式化了比例性公理,要求每一轮都达成一致、占总选民 α% 的群体至少批准 α% 的决策,并要求在 β 比例轮次中达成一致的群体批准 β · α% 的决策。
-
分析识别出三条满足此类公理的投票规则:Sequential Phragmén 以在线方式运行,而 Method of Equal Shares 和 Proportional Approval Voting 分别在半在线和离线决策条件下满足这些公理的更强版本。
-
在合成数据、美国政治选举和 moral machine 数据集上的实验表明,使用这些规则聚合国家级偏好模型的投票结果,相比使用单一全局偏好模型,能产生跨人口统计群体更均衡的效用分布。
引言
该论文研究通过审批投票做出的重复性集体决策,其中相同选民在多个轮次中从不断变化的备选方案中进行选择。这一场景与招聘、自动化虚拟民主和联盟政策设计相关。标准多数制或相对多数制决策可能使影响力集中在固定多数群体上,导致较小但立场一致的群体长期代表性不足。此前关于永续投票和多优胜者比例性的工作提出了群体公平性保证,但对于满足最强在线准则和完全正当代表性准则的高效算法仍未有明确结论。作者形式化了 PJR 和 EJR 公理,引入更强的在线变体,并提出基于 Phragmén、Equal Shares 和 PAV 的规则。这些规则在在线、半在线和离线约束下满足这些保证,同时论文还给出了不可能性结果,以及表明虚拟民主设置中公平性得到改善的实验结果。
数据集
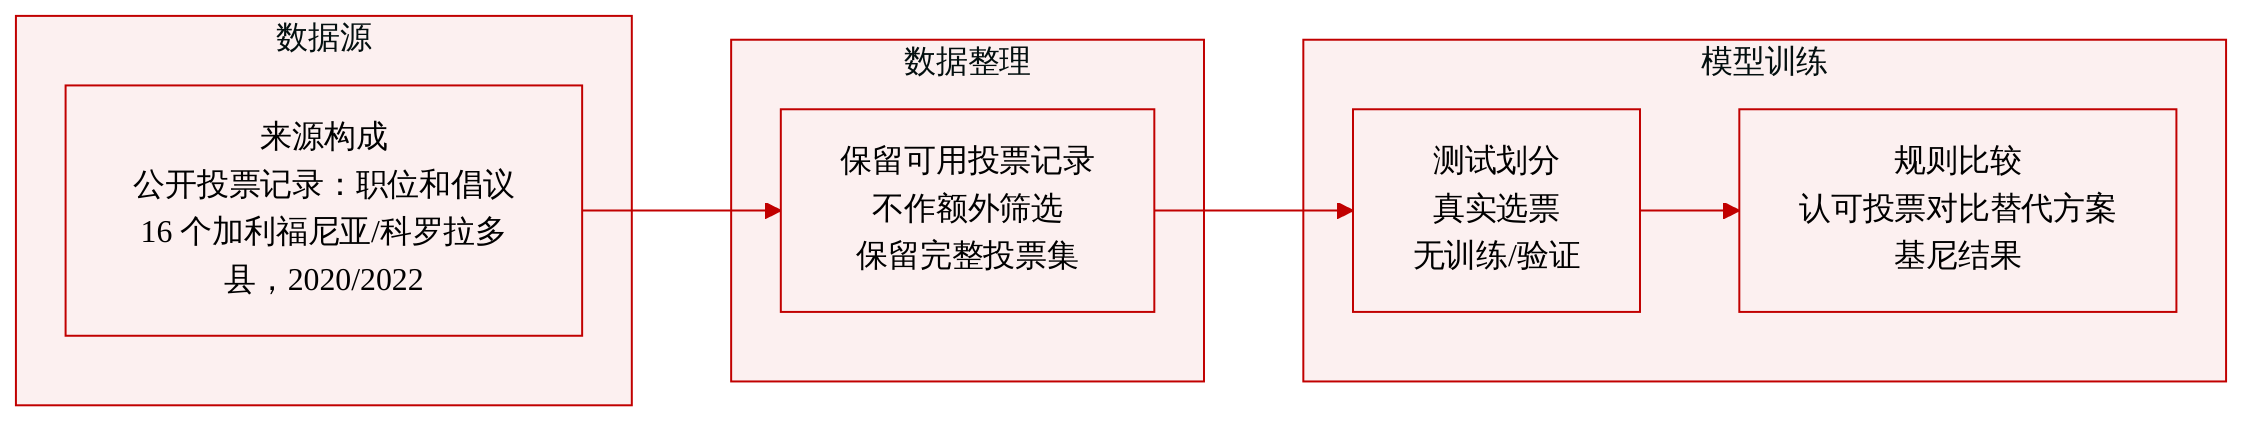
- 作者加入了一个真实的美国政治大选记录数据集,公开地址为 https://osf.io/t6p7s/,用于在合成数据之外评估投票规则。
- 来源:来自联邦、州和地方职位以及是/否公投提案的公开匿名化 Cast Vote Records (CVR)。
- 构成和规模:包含加利福尼亚州和科罗拉多州的 16 个县,涵盖 2020 年和 2022 年中有数据可用的选举。
- 处理与过滤:作者使用存在公开 CVR 数据的县和选举年份;记录已经显示每位选民在所有议题上的同时投票情况,文中未描述额外过滤或选民身份识别。
- 用途:该数据集用作实证评估集,而非用于模型训练。作者将投票规则应用于真实选票,并比较 Gini 系数等结果,包括 Approval Voting 与其他规则相比的表现。
方法
作者利用一个用于永续决策的模块化框架,其中决策序列必须在时间上保持比例代表性。输入包含 n 名选民 N、T 个决策轮次 R={1,…,T}、第 j 轮的一组备选方案 Cj,以及选民 i 在第 j 轮的二元批准集合 Aji⊆Cj。决策序列是一个元组 D=(d1,…,dT),其中 dj∈Cj,而选民 i 的效用是该选民批准所选备选方案的轮次数,记为 UDi。
该框架的一个核心组件是公理层,用于定义比例代表性在如此序列中的含义。如果存在至少一个备选方案被该群体中每名选民批准,即如果 ⋂i∈SAji=∅,则选民群体 S⊆N 在第 j 轮达成一致。随后,公理要求足够大的达成一致群体获得按比例数量的被批准决策。参见下方蕴涵关系图。
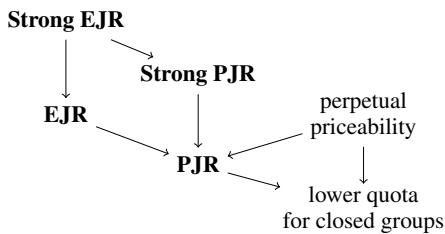
较弱的成对正当代表性性质 PJR 适用于在每一轮都达成一致的群体。如果 S 在全部 T 轮中达成一致,且规模满足 ∣S∣≥ℓn/T,则至少 ℓ 个决策必须由 S 中至少一名成员批准:
{j∈R:dj∈i∈S⋃Aji}≥ℓ.Strong PJR 放宽了群体必须在每一轮达成一致的要求。如果 S 仅在 k 轮中达成一致,则在获得相同保证之前,其规模必须更大,即 ∣S∣≥ℓn/k,仍保证至少 ℓ 个决策被群体中某人批准。因此,达成一致轮次减少会减少被保证的满意轮数,除非联盟规模相应变大。
扩展正当代表性公理 EJR 和 Strong EJR 施加更严格的个体层面保证。对于在全部 T 轮中达成一致且满足 ∣S∣≥ℓn/T 的群体 S,EJR 要求存在选民 i∈S 使得 UDi≥ℓ。Strong EJR 将该要求扩展到仅在 k 轮中达成一致的群体,要求 ∣S∣≥ℓn/k,但仍保证 S 中至少一名选民批准至少 ℓ 个决策。因此,PJR 和 EJR 之间的关键架构差异在于保护单位:PJR 可以通过在成员之间轮换幸福感来满足联盟,而 EJR 确保某一名成员能够积累按比例份额的批准决策。
在公理层之上,作者实例化三种算法决策规则,分别对应不同的运行状态。
第一个模块是 Sequential Phragmén,一种在线负载平衡规则。每名选民 i 维持一个负载 xi,初始化为零。每个被选中的备选方案产生总负载 1,该负载必须分配给批准它的选民。该规则选择能使这一单位负载以最小化任一选民最大最终负载的方式分布的备选方案。对于每个备选方案 c∈Cj,规则计算
sc=S⊆{i∈N:c∈Aji}min∣S∣∑i∈Sxi+1.这里,S 是一个候选联盟,由能够分担该负载的批准选民组成。规则选择具有最小值 sc 的备选方案。如下方图示所示,sc 可以通过注水过程来理解:将一单位负载注入批准该备选方案的选民当前负载上,注水后的水位决定被选中联盟的新负载水平。
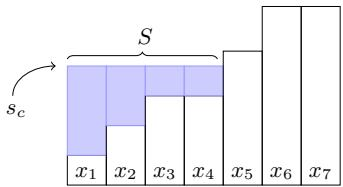
在选择备选方案 dj 后,该规则找出在 sdj 定义中达到最小值的联盟 S,并将该联盟中选民的负载提升到水平 sdj。联盟外的选民保持先前负载,任何选民的负载都不会下降。这种序贯设计使该规则成为在线规则,意味着它无需知晓未来备选方案或未来批准情况即可产出决策。它还满足前缀式保证:如果实际产生的序列满足 Strong PJR,则该保证不仅适用于整个序列,也适用于在线机制处理的每个前缀。
第二个模块是 Method of Equal Shares (MES),一种半在线、基于预算的规则。该规则假设预先知道总轮次数 T,但不需要未来的选民偏好。每个决策具有固定价格
p=Tn,每名选民初始预算为 bi=1。如果批准备选方案 c∈Cj 的选民能够支付价格 p,且没有任何选民贡献超过 ρ,则称该备选方案为 ρ-可负担:
i∈N:c∈Aji∑min(bi,ρ)≥p.在每一轮中,规则选择在最小 ρ 值下可负担的备选方案。如果选民 i 批准被选中的备选方案 dj,其预算更新为
bi←max(0,bi−ρ).因此,已经从较早决策中受益的选民剩余预算更少,支持未来决策的能力也随之降低;而此前满意度较低的选民则能够承担未来成本中更大的份额。如果某一轮中没有备选方案可负担,核心流程会停滞,剩余轮次必须通过辅助补全策略完成。作者使用 epsilon 补全方法,近似最低可负担备选方案,从而保留 MES 的支出逻辑。
第三个模块是 Proportional Approval Voting (PAV),一种离线优化规则。这里,机制预先知道备选方案和批准情况的完整序列,并选择最大化调和目标的决策序列 D:
PAV-score(D)=i∈N∑r=1∑UDir1.内层求和会因每名选民批准的每个决策给予奖励,但边际收益递减:第一个被批准的决策贡献 1,第二个贡献 1/2,第三个贡献 1/3,依此类推。这种边际收益递减结构会惩罚那些将满意度集中在少数选民上而忽略其他选民的决策序列。精确最大化 PAV 分数在计算上很困难,因此作者还分析了一种局部搜索变体,该变体通过迭代交换单个决策来提高目标值。局部搜索规则可以在多项式时间内实现,并保留与完整 PAV 相同的关键比例性保证。
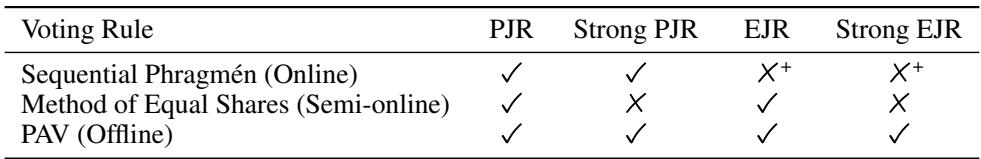
这三个模块通过公理层连接起来。Sequential Phragmén 在线运行并满足 Strong PJR,但不满足 EJR。MES 需要知道 T,满足 EJR,但不满足 Strong PJR 和 Strong EJR,因为贪心预算支出可能在联盟仅于较早轮次达成一致后耗尽可负担性。PAV 和局部搜索 PAV 离线运行,并满足所考虑的最强公理 Strong EJR。作者还考察更强保证的极限:如果将 Strong PJR 中的联盟规模阈值放宽任意正的 ε,所得到的 epsilon-strong PJR 要求即使在离线情况下也可能不可行,并且没有任何半在线规则总能在可行序列存在时返回可行序列。
实验
这些实验在合成选民审批设置、真实美国选举记录以及 moral-machine 偏好学习设置上,将所提出规则与现有比例规则和简单基线进行比较。合成测试显示,Approval Voting 最大化平均满意度,但产生不平等的结果,而比例方法和轮流制通常提供更公平的效用分布。政治数据上以及从 moral machine 学到的偏好上的结果也类似表明,常用聚合方法偏向多数或相对多数意见,而比例规则能更公平地支持选民或群体。
结果表明,比例性多优胜者规则可以在多项式时间内满足强公平性保证,而可实现公理取决于规则预先获得多少信息。在线 Sequential Phragmén 提供 PJR 和 Strong PJR,但是否存在满足 EJR 或 Strong EJR 的在线规则仍是开放问题。半在线的 Method of Equal Shares 满足 PJR 和 EJR,但不满足它们的强版本,而离线 PAV 规则满足全部四条公理。在线 Sequential Phragmén 提供了具有 PJR 和 Strong PJR 的多项式时间规则,但其满足 EJR 的能力仍未解决。更多信息会改善公理满足程度,因为半在线 Equal Shares 满足 PJR 和 EJR,而离线 PAV 满足全部四条公理。
该示例展示了四名选民在连续成对轮次中的批准集合。多数选民随时间保持相同的批准备选方案,而两名选民在最后一轮修改了批准。共享批准和单一备选方案批准说明选民偏好可以保持稳定、重叠或变化。Voter 1 和 Voter 2 在所有轮次中保持相同批准集合。Voter 3 和 Voter 4 在多数轮次中批准备选方案 d,然后在最后一轮转向不同单备选方案。备选方案 a 同时获得 Voter 1 和 Voter 2 的重叠批准,而最后一轮引入了更分歧的批准模式。
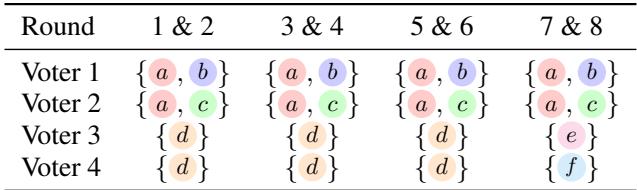
该评估在不同信息设置下检验在线、半在线和离线多优胜者投票规则,并使用成对轮次示例追踪选民批准和偏好变化。它验证了更多预先信息如何改善可实现的公平性保证,其中在线方法支持较弱公理,半在线方法扩大覆盖范围,离线规则提供最强满足程度。批准集合示例显示,选民偏好可以跨轮次保持稳定或重叠,但也可能在后期轮次中急剧变化。这些发现支持更广泛的结论:信息可得性和动态偏好共同塑造集体决策的公平性。