Command Palette
Search for a command to run...
学习知识库的结构化嵌入
学习知识库的结构化嵌入
Antoine Bordes Jason Weston Ronan Collobert Yoshua Bengio
摘要
许多知识库(KB)现已可方便获取,得益于长期资助项目(如 WordNet、OpenCyc)或协作构建过程(如 Freebase、DBpedia),它们包含了海量信息。然而,每一个知识库都基于各自不同的严格符号框架,这使得其数据难以在其他系统中直接使用。令人遗憾的是,如此丰富的结构化知识本可推动人工智能许多其他领域的巨大飞跃,例如自然语言处理(词义消歧、自然语言理解等)、计算机视觉(场景分类、图像语义标注等)以及协同过滤。本文提出一种基于创新神经网络架构的学习方法,旨在将任何此类符号表示嵌入到更灵活的连续向量空间中,在该空间中原始知识得以保留并进一步增强。这些学习到的嵌入使得来自任何知识库的数据能够便捷地应用于最新的机器学习方法,以完成预测和信息检索任务。我们在 WordNet 和 Freebase 上验证了该方法的有效性,并提出了一种将其适配于从原始文本中进行知识抽取的途径。
一句话总结
Bordes 等人提出了一种神经能量模型,将知识库实体和关系嵌入连续向量空间,同时保留结构约束,从而促进词义消歧、场景分类和协同过滤等下游任务。
核心贡献
- 一种神经嵌入框架将异构知识库映射到连续向量空间,将每个实体表示为低维向量,并将每种关系类型表示为低维算子或矩阵。
- 该框架采用紧凑灵活的训练过程,并在嵌入空间中使用核密度估计,以估计关系概率并推断新的合理关系。
- 在 WordNet 和 Freebase 上的实验表明,这些嵌入能够保留来自拥有数十万个实体和数百种关系的大型知识库的知识,并且该方法可扩展到从原始文本中提取知识。
引言
作者利用 WordNet、Freebase、DBpedia 和 OpenCyc 等大规模基于 Web 的知识库,这些知识库以结构化、关系型形式组织大量通用知识和领域特定知识。这些资源很重要,因为它们可以增强许多 AI 系统,包括自然语言处理、计算机视觉、语义搜索和协同过滤。然而,先前研究已经表明,这些知识库难以在统计学习系统中复用,因为其符号框架往往僵化,不能自然映射到特征向量、嵌入或其他数值学习表示。现有基于嵌入的方法也面临局限,包括可能损害泛化的复杂多向量实体表示,或者只面向小型专用知识任务而非广泛知识库复用的方法。
作者通过为任意由实体和关系组成的知识库学习结构化分布式嵌入来解决这一问题。他们的模型为每个实体学习一个低维向量,并为每种关系类型学习一个低维矩阵算子,同时在训练过程中保留原始知识库结构。他们还利用嵌入空间中的核密度估计来评估实体之间可能关系的概率,即使这些关系在原始知识库中并未明确出现。由此得到紧凑、灵活且具有泛化能力的知识表示,能够将大型符号知识库与现代统计和深度学习系统连接起来,并可扩展到从原始文本中提取知识。
数据集
-
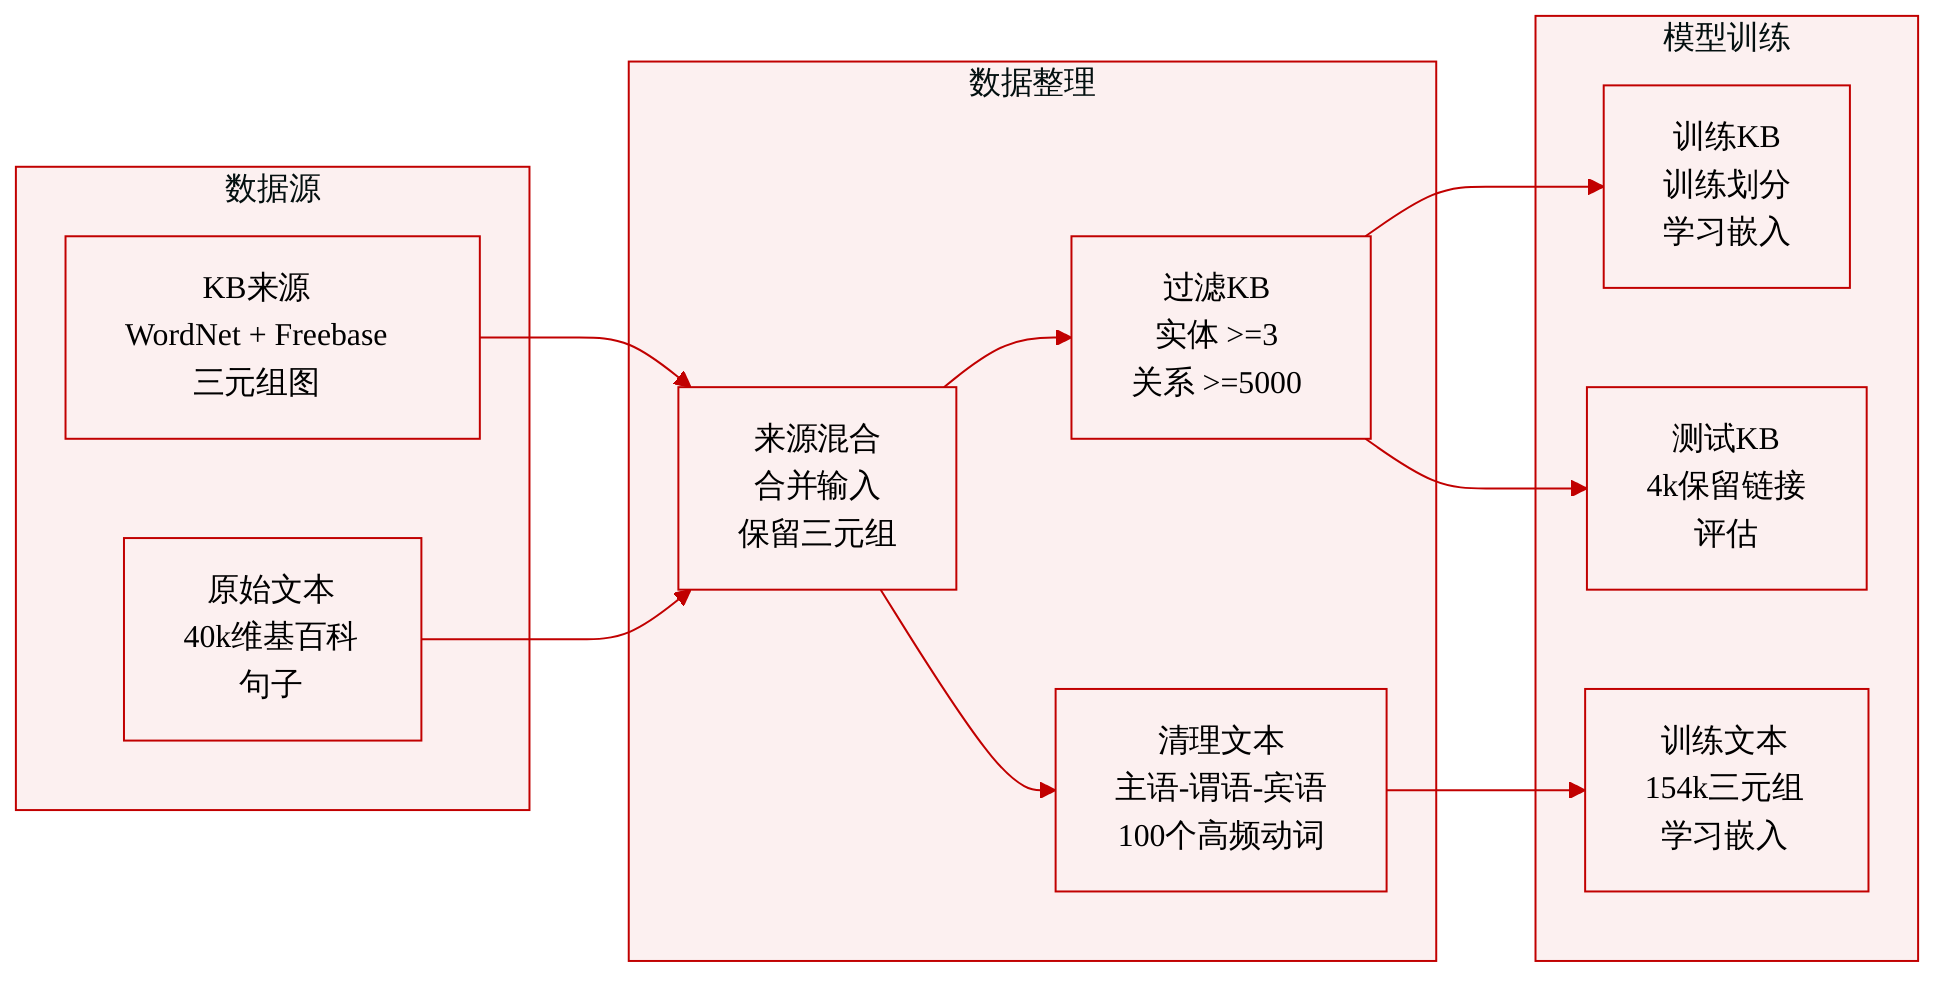
整体数据组成: 作者将知识库表示为由实体-关系三元组构成的图,并额外使用从原始文本提取的数据。他们的知识库数据来自 WordNet 和 Freebase,而原始文本数据来自维基百科文章。
-
WordNet 子集: WordNet 按其原生图形式使用。作者保留由论文中强调的关系类型连接的实体,但移除信息过少的实体。WordNet 实体由词与义项编号组合表示,例如
auto 1,以区分同一词的不同含义。 -
Freebase 子集: Freebase 同样被视为图,但作者并未使用完整知识库。他们将数据限制在“去世人物”类型,并保留所有至少涉及一个该类型实体的关系构成的子图。例子包括三元组
(marylin monroe, profession, actress)。 -
知识库数据过滤规则: 对于 WordNet 和 Freebase,作者仅保留满足实体至少出现在 3 个关系中且关系类型至少出现 5,000 次的三元组。这些过滤旨在去除图中稀疏或表示不足的部分。
-
知识库测试集构造: 作者从每个数据集中随机留出 4,000 个三元组作为测试集。这些留出的三元组仍然涉及训练集中其他位置出现的实体,因此划分基于缺失链接,而不是完全未见的实体。
-
原始文本数据集来源: 作者还从 40,000 篇维基百科文章中构建了一个数据集,使用语义角色标注来提取主语、动词和直接宾语结构。
-
原始文本处理: 作者通过仅保留主语、动词、直接宾语短语来简化提取出的句子,从主语和宾语的名词短语中删除形容词、副词和代词,并对动词进行词干化。然后仅保留使用出现频率最高的 100 个动词形式的三元组。
-
原始文本数据集规模: 这一过程产生 154,438 个三元组、100 种关系类型和 23,936 个实体。随后作者使用这些数据,以与知识库实验相同的一般训练方案学习嵌入。
-
数据使用方式: 论文使用这些数据集评估来自知识库和原始文本的关系三元组能否被嵌入为向量表示。对于知识库数据,作者同时提供训练划分和留出测试划分;对于原始文本数据,处理后的三元组直接作为嵌入输入。
方法
作者利用一个结构化嵌入框架,将知识库表示为由实体和有向关系构成的图。在该形式化中,每个实体对应一个节点,每条事实对应一个三元组 (el,r,er),其中 el 是左实体,r 是关系类型,er 是右实体。模型不要求知识库必须表示为严格本体或层级结构。相反,它将可用事实展平为关系三元组,并学习一种保留不同关系类型行为的向量空间表示。
核心思想是实体位于共享嵌入空间中,而每种关系类型拥有自己的相似性度量。如果嵌入维度为 d,则第 ith 个实体被赋予向量 Ei∈Rd。对于每种关系类型 k,作者学习一对 d×d 变换矩阵,Rklhs 和 Rkrhs,分别对应关系的左侧和右侧。两个实体在关系 k 下的相似性定义为
Sk(Ei,Ej)=RklhsEi−RkrhsEjp.该距离越小,表明两个实体在该关系下越兼容。框架采用 p=1,对应 1-norm,因为它简化了基于梯度的优化。这种设计还允许关系具有非对称性。例如,“part of” 这类关系天然有方向,因此左右两侧变换可以为同一关系类型学习不同角色。
这种结构可以解释为广义孪生网络。标准孪生网络为输入对学习一个相似性函数,而该模型为每种关系类型学习一个相似性函数。因此,学习问题定义在一组三元组上
xi=(eil,ri,eir),模型必须学习一个能量型函数 f(xi),对有效三元组给出较低值,对无效损坏三元组给出较高值。具体地,若真实训练三元组为 (eil,ri,eir),作者希望当左侧或右侧实体被替换为错误实体时,模型赋予较低分数。这给出两个基于间隔的约束:
f(eil,ri,eir)<f(ejl,ri,eir),对于所有无效左侧损坏,以及
f(eil,ri,eir)<f(eil,ri,ejr),对于所有无效右侧损坏。
评分函数本身由实体和关系参数构建。实体嵌入存储于矩阵 E∈Rd×De 中,其中 De 为实体数量。关系参数以张量 Rlhs 和 Rrhs 存储,大小为 d×d×Dr,其中 Dr 为关系类型数量。对于三元组 xi=(eil,ri,eir),能量计算为
f(eil,ri,eir)=RrilhsEv(eil)−RrirhsEv(eir)1.这里,v(n) 将实体索引映射为稀疏指示向量,因此 Ev(eil) 和 Ev(eir) 从 E 中提取对应实体嵌入列。模型随后使用关系专用矩阵变换左侧和右侧实体向量,并度量它们的 1-norm 距离。
一个显著的设计选择是,所有关系类型共享同一实体嵌入矩阵。这形成了一个多任务学习设置:每个实体嵌入必须编码对实体出现的许多不同关系都有用的信息。因此表示是紧凑的,并避免为每个实体-关系对学习单独向量。对于某种关系类型,仅学习两个线性变换,这使模型保持可扩展,同时仍允许关系特定行为。
训练使用随机梯度下降处理铰链式目标。该过程反复采样一个正训练三元组,然后随机损坏左侧或右侧实体以生成负三元组。对于正三元组 xi 及其损坏版本 xneg,当正能量没有明显小于负能量时,模型执行梯度更新。更新方向最小化
max(0,1−f(xneg)+f(xi)).常数 1 作为间隔,鼓励有效三元组与无效三元组之间至少保持一个最小间隔。每次更新后,模型对每个实体嵌入进行归一化,使得
∥Ei∥=1对所有实体成立。该归一化消除了缩放模糊性:若无归一化,实体向量可能缩小而关系矩阵增大,产生相同能量值,但参数可能在优化期间漂移。
尽管结构化嵌入为每个可能三元组定义了连续距离,作者仍解决了原始嵌入空间的一个重要限制:原始知识库中已有的事实具有符号确定性,而任意未见三元组只得到距离分数。为了恢复概率解释,他们在学习嵌入之后估计嵌入空间上的概率密度。这一步使用核密度估计,以评估候选三元组与已知训练三元组的相似程度。
该核函数为高斯核,通过度量关系变换后的左右实体嵌入之间的平方欧氏距离来比较两个三元组 xi 和 xj:
K(xi,xj)=2πσ1exp(−2σ21(RrilhsEv(eil)−RrjlhsEv(ejl)22+RrirhsEv(eir)−RrjrhsEv(ejr)22)).为提高效率,三元组 xi 的密度估计不在整个训练集上计算。相反,作者将邻域限制为共享相同关系类型且具有相同左侧或右侧实体的训练三元组:
S(xi)={(ejl,rj,ejr):rj=ri∧(ejl=eil∨ejr=eir)}.概率密度则为
fkde(xi)=∣S(xi)∣1xj∈S(xi)∑K(xi,xj).这种局部 KDE 过程保留了基于嵌入评分的优势,同时为接近已观测事实的三元组给予更高置信度。一旦估计出密度,即可用于预测。例如,在给定左侧实体和关系类型时,为了推断右侧实体,模型选择密度最高的实体:
e^r=argmaxe∈Defkde((el,r,e)).同一过程也可推断缺失的左侧实体,或根据相关分数对候选答案排序。由于这些分数可在可用符号答案上归一化,系统能够输出概率化排序,而不仅仅是最近邻嵌入。
实验
实验在 WordNet 和 Freebase 上评估结构化嵌入的排序性能,比较有无多任务嵌入共享和核密度估计的变体。排序结果表明,共享的多任务嵌入比分离表示或纯计数表示具有更好的泛化能力,而 KDE 增强了对已知三元组的拟合。进一步分析显示,实体嵌入能够捕捉多层面的语义邻域,包括类比和词义区分,并且同一训练框架可以扩展到从原始文本中提取知识。
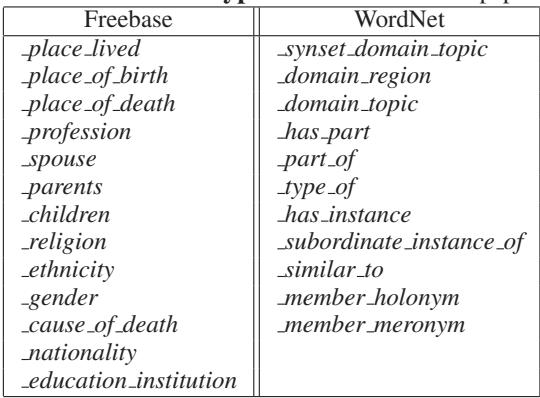
该表报告了过滤实体和关系类型后两个知识库 WordNet 和 Freebase 的数据集统计。在实体和训练样本数量上,Freebase 都大于 WordNet,而两个数据集使用相近数量的关系类型,并留出相同规模的测试集。Freebase 数据来自去世人物子图,而不是完整知识库。Freebase 比 WordNet 包含更多实体和训练样本。两个数据集都包含相同规模的留出测试集。
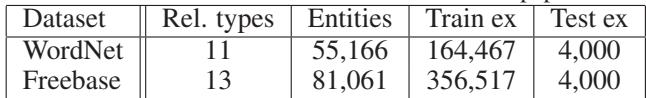
该表列出了两个基于图的知识库 Freebase 和 WordNet 的代表性关系类型。Freebase 包含出生地、职业和父母等人物传记和家庭关系,而 WordNet 包含 “has part”、“type of” 和 “domain topic” 等词汇和语义关系。这些关系定义了实体之间的有向链接,并支持从知识库三元组中学习结构化表示。Freebase 关系类型侧重人物事实,包括出生地、居住地、职业和家庭关系。WordNet 关系类型捕捉 synset 之间的语义和结构链接,例如部分关系、类型关系和领域主题。这些关系在知识库的扁平图表示中被视为实体之间的有向链接。
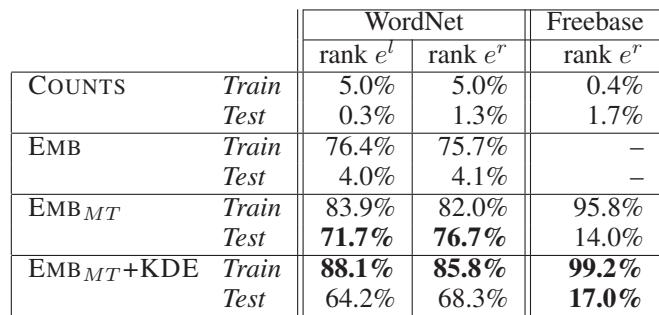
预测排序结果显示,COUNTS 和标准 EMB 能很好匹配训练样本,但在留出样本上表现不佳,说明泛化能力有限。多任务嵌入排序,尤其是 EMB_MT 和 EMB_MT+KDE,显著改善测试排名,在 WordNet 上改进最明显。该表支持以下观点:跨关系共享嵌入信息是泛化排序性能的关键。COUNTS 和 EMB 获得良好的训练排名,但测试排名较弱。多任务嵌入显著提高测试排序准确率。多任务化带来的相对收益在 WordNet 上大于 Freebase。
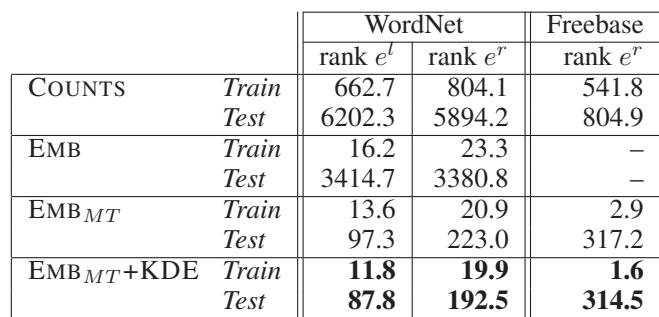
排序结果表明,基于计数的特征主要记录训练三元组,在测试案例上表现不佳。标准嵌入在训练集上取得较高召回率,但在未见事实上仍然较弱,而多任务嵌入提高了两个数据集上的泛化能力。收益在 WordNet 上以及头实体预测中更明显,Freebase 上向右侧实体排序的迁移较小。与非多任务嵌入相比,多任务化显著改善测试时的 top-10 排序。WordNet 受益大于 Freebase,因为实体参与更多关系类型。多任务嵌入在保持较强训练性能的同时,避免单任务嵌入的低测试性能。
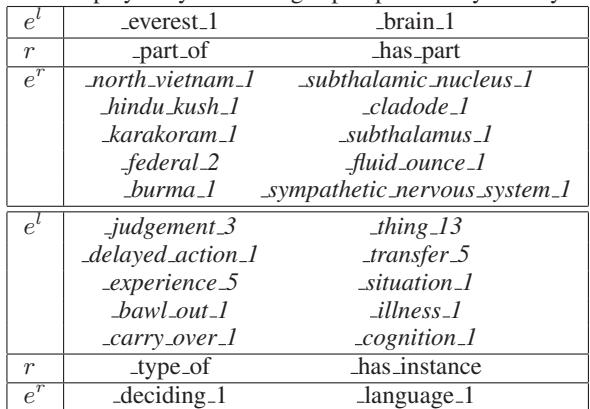
带有密度估计的多任务嵌入模型会预测训练样本中不存在的实体,表明其泛化超出了直接记忆。这些排序输出对于 WordNet 关系构成了语义上有意义的类比,尤其对于 “part of” 和 “has part” 等关系模式。预测并不总是完全正确,但许多候选实体在给定关系下是合理的。列表移除了训练样本,因此所示预测反映的是泛化类比。多任务嵌入使泛化优于主要复现训练关系的模型。针对关系查询的预测实体通常合理,但并非总是完全正确。
实验在过滤后的 WordNet 和 Freebase 知识库上评估排序,比较计数模型、标准嵌入和多任务嵌入变体。结果表明,简单模型能够拟合训练三元组,但对留出事实泛化较差;多任务嵌入通过共享关系级信息改善测试排序。收益在 WordNet 和头实体预测中尤其明显,定性例子表明多任务模型能够生成涉及未见实体的合理类比。