Command Palette
Search for a command to run...
迈向永不停歇的语言学习架构
迈向永不停歇的语言学习架构
Andrew Carlson Justin Betteridge Bryan Kisiel Burr Settles Estevam R. Hruschka Jr Tom M. Mitchell
摘要
本文探讨了构建永不停歇语言学习器的问题,即一个能够永远运行的智能计算机代理,其每天必须完成两项任务:(1)从网络中提取(或阅读)信息,以填充一个不断增长的结构化知识库;(2)学习如何比前一天更好地执行此任务。具体而言,我们提出了一种实现此类代理的方法及一组设计原则,描述了该系统的一个部分实现——该系统在运行 67 天后已学会提取包含超过 242,000 条知识信念的知识库,估计精确率为 74%——并讨论了这一初步构建永不停歇学习代理的尝试中所获得的经验教训。
一句话总结
卡内基梅隆大学和圣卡洛斯联邦大学提出了一种永不终止的语言学习 agent 架构,它持续从网络中抽取信息并注入不断增长的知识库,能够逐日改进;其部分实现经过 67 天运行,积累了超过 242,000 条信念,估计精确率为 74%。
核心贡献
-
论文提出了一种永不终止的语言学习 agent 的架构和设计理念,该 agent 每天读取网络文本,并通过互补子系统之间的半监督自举学习来改进抽取函数。
-
论文描述了一个部分实现,包含四个子系统组件,它们结合了多种抽取方法和受本体约束的多任务学习,使用类型检查、互斥关系和领域约束,覆盖 531 个已学习函数。
-
67 天实现使知识库包含超过 242,000 条事实,估计精确率为 74%,支持了多样化、与学习兼容的抽取器的价值,以及将候选事实与高置信信念共同存储的知识库设计。
引言
作者针对一个长期存在的 AI 目标:构建能够持续阅读网络并随时间提升自身理解的系统。他们的应用是一个永不终止的语言学习 agent,通过从文本、表格和列表中抽取结构化事实来填充不断增长的知识库。这一点很重要,因为网络规模的知识自动获取可以支持许多 AI 系统,从问答到信息抽取。
一个关键挑战是,自举学习可能累积标注错误,这一问题通常被称为语义漂移。早期方法还倾向于把抽取方法、终身学习策略和排序技术分离开来,限制了大规模稳健学习的能力。作者通过受约束的半监督学习、多样化抽取器集成以及灵活的知识库表示来应对这些限制。
他们的主要贡献是一个架构和原型系统 NELL,该系统能够持续学习类别、关系和推理规则。他们还提供了网络规模评估,显示经过 67 天后,系统学习了超过 242,000 条事实,估计精确率为 74%。
数据集
-
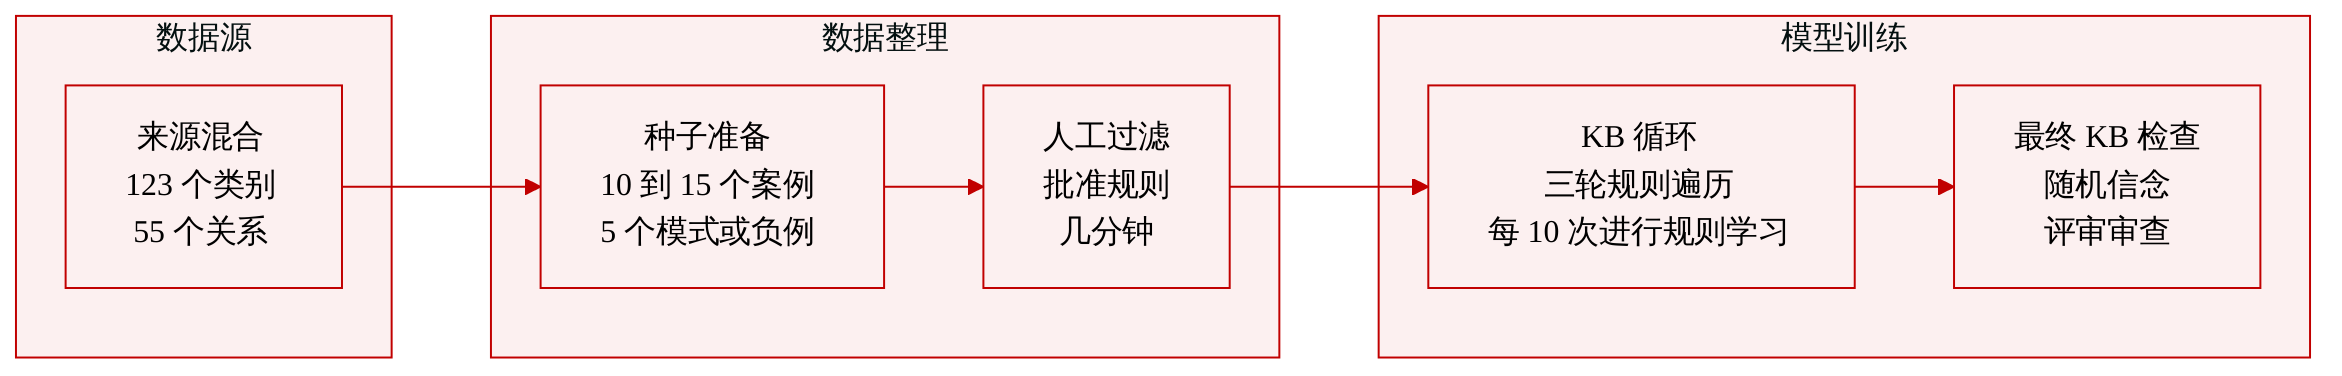
数据集来源和构成:作者为实验构建了输入本体。它包含 123 个类别和 55 个关系。类别覆盖地点、人物、动物、组织及其他组别。关系刻画类别之间的关系,例如 teamPlaysSport、bookWriter 和 companyProducesProduct。
-
类别子集:每个类别包含 10 到 15 个种子实例,以及 5 个用于 CPL 的种子模式。种子模式由 Hearst 模式衍生得到。
-
关系子集:每个关系包含 10 到 15 个种子实例和 5 个负例实例。负例实例通常通过对种子实例的参数进行置换生成。
-
数据用途:该本体被用作知识库填充过程的种子数据。CPL、CSEAL 和 CMC 在每次迭代中运行一次。RL 在每 10 次迭代后运行一次。提议的输出规则由人工过滤,人工批准只需几分钟。
-
评估数据:作者通过从最终知识库中随机采样信念来估计其精确率。人工评审评估样本,并在作出最终决定之前详细讨论分歧。
-
标注和处理规则:曾经为真但当前不为真的事实被视为正确,因为系统不处理时间范围。像 “today’s Chicago Tribune” 这样的虚假形容词被允许出现,但被认为罕见。
-
提供的摘录中未描述额外的裁剪策略、元数据构建或单独的数据集处理细节。
方法
作者提出了一个迭代式知识获取架构,围绕一个共享知识库构建,该知识库通过多个互补的阅读和推理子系统持续扩展。初始知识库包含一个类别和关系本体,以及每个谓词的一小组种子示例。当系统处理外部文本资源和网络资源时,各子系统提出新的类别实例和关系实例。这些提议作为候选事实进入知识库,而支持最强的提议会被提升为信念状态。更新后的信念随后成为下一次迭代的训练数据,使每个子系统能够随时间改进其抽取行为。请参考框架图以了解完整数据流。
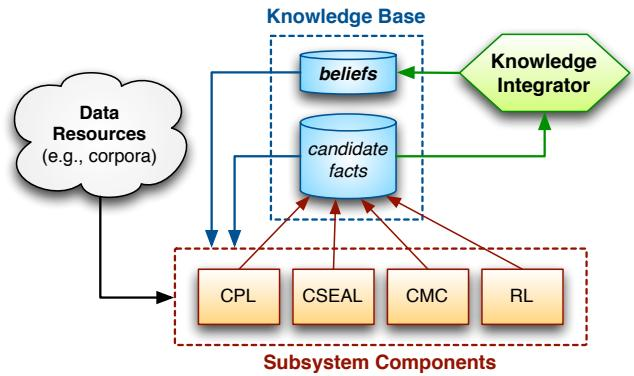
在已实现系统中,共享知识库区分低置信候选事实和高置信信念。每个子系统组件从知识库读取,查询外部资源,并提交提议的候选事实,以及置信度估计和来源证据。Knowledge Integrator 接收这些提议,评估其支持程度,并决定哪些候选成为信念。这形成了一个闭环,其中抽取、评估、提升和再训练反复交互。整体过程可被视为一种耦合半监督学习过程,也可被视为期望最大化算法的近似:知识库估计许多候选事实的可靠性,而各子系统使用当前接受的信念自行重新训练。
该架构使用多个具有不同优势的子系统组件。Coupled Pattern Learner 通过学习方法上下文模式从自由文本中抽取实例,例如名词短语周围或关系提及周围的短语。它依赖词性模式以及名词短语与文本上下文之间的共现统计。对于每个谓词,它学习抽取模式,并将它们应用于大规模文本资源以发现新实例。分类约束用于抑制过于宽泛的模式。候选概率按启发式方式赋值为
1−0.5c其中 c 是产生该候选的被提升抽取模式数量。
Coupled SEAL 组件执行来自网络资源的半结构化抽取。给定某个类别或关系的种子信念,它会发起查询、获取页面,并挖掘可能包含相应谓词额外实例的列表或表格。它使用互斥关系来创建负例,并过滤过宽的包装器。候选按类似启发式方法分配置信度,其中计数反映产生该实例的未被过滤包装器数量。
Coupled Morphological Classifier 从被提升的信念中学习类别分类器。它为每个符合条件的类别训练一个独立的二元逻辑回归模型,并使用词法形式、大小写、词缀和词性信号等形态特征。在每次迭代中,它对其他组件提出的候选名词短语进行分类,同时受置信度阈值和每个谓词容量限制约束,以保持精确率。
Rule Learner 在当前知识库上执行一阶关系推理。它学习概率式 Horn 子句,从已有关系实例推断新的关系实例。该组件允许系统从已经相信的事实中传播知识,而不需要直接从文本中抽取。
Knowledge Integrator 决定哪些候选事实足够强,能够成为信念。来自单一来源的高置信候选可以直接提升,而来自多个独立来源一致支持的低置信候选也可以被提升。该集成器还强制执行结构约束。它尊重类别之间的互斥关系,防止提升与互斥类别冲突的类别实例,并对关系参数进行类型检查,使参数至少是适当类别类型的候选。这一提升策略使错误传播得到控制,同时允许多个互补来源增强弱证据。
实验
实验评估了 NELL 是否能够持续学习大量类别和关系并保持精确率,以及各组件如何贡献于被提升的信念。在一项长时间运行研究中,NELL 稳定积累知识:各个抽取器提升了许多信念,多来源集成带来显著增益,RL 通过少量人工批准增加了不同规则。总体精确率仍然较有前景,许多谓词表现良好,尽管准确率随时间下降,且错误在噪声较大或过于宽泛的类别和关系中更常见。这些发现支持多来源学习设计,但也表明相关错误和语义漂移需要更多监督,例如主动学习。
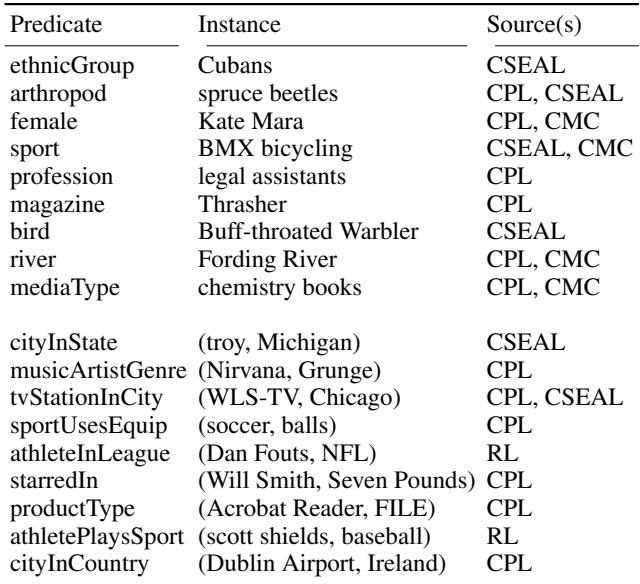
该表展示了 NELL 在多种谓词上提升的示例信念,包括族群、动物、职业、运动、出版物和鸟类。每个示例都关联到一个或多个来源组件,说明被提升的信念可以来自多个抽取子系统。更广泛的背景描述了随时间持续增长的信念数量:在初期增长高峰之后,提升仍稳定持续,尽管精确率逐渐下降。被提升的信念涵盖许多语义谓词中的具体实体。有些示例由多个抽取来源支持。CPL 出现在展示的多个示例中,表明它贡献了多种信念类型。
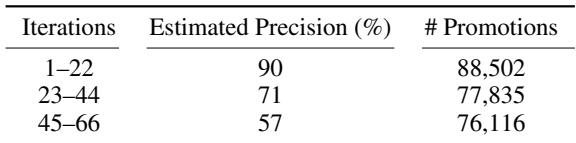
被提升信念的估计精确率在三个执行期间下降,而提升数量大体相当。精确率在最早期间最高,在最后期间最低,这表明持续学习扩展了知识库,却未能维持同样的准确度。早期提升的信念具有最高估计精确率。尽管精确率下降,提升量在各期间仍保持相对稳定。总体估计精确率支持继续学习,但后续提升的准确性较低。
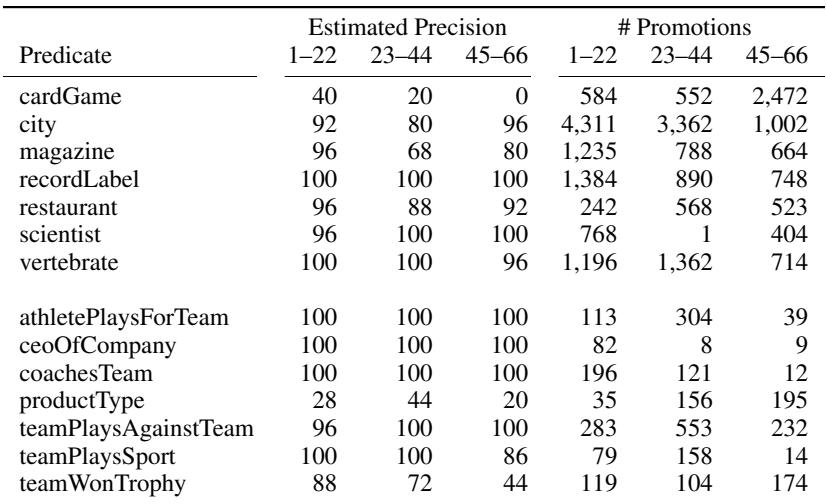
在所选择的谓词中,估计精确率因谓词和迭代周期不同而不同,这表明后续提升并非全部可靠。一些谓词,例如 recordLabel、magazine、restaurant 和 scientist,保持了较高估计精确率,而 cardGame 即使提升数量上升,也出现明显陡峭的下降。这些例子说明了在持续学习活动的同时,某些谓词的精确率逐渐下降。recordLabel 在所有报告期间保持高估计精确率。cardGame 的精确率在后期显著下降,而其提升数量大幅上升。city、magazine、restaurant 和 scientist 尽管提升量发生变化,总体仍保持较高精确率。
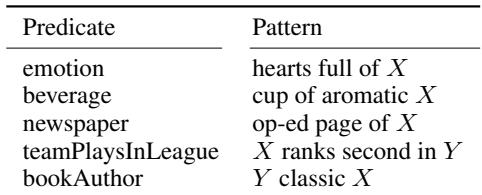
CPL 学习到的示例自由文本模式捕捉了多种谓词,从 emotion 和 beverage 等类别,到 teamPlaysInLeague 和 bookAuthor 等关系。这些模式依赖带有名词短语占位符的紧凑表层上下文,表明简单的词汇模板可以支持广泛的知识抽取。同时,来自表格的证据也符合更广泛的观察结果:CPL 生成的模式可能导致细微错误,包括名词短语切分错误以及精确率逐渐下降。CPL 学习跨类别和关系的可复用文本模式。这些模式使用 X 和 Y 等占位符来泛指名词短语,从而概括表面表达。示例包括用于类别的容器式短语和用于关系的比较式短语。名词短语切分错误可能使 CPL 模式产生不正确信念,例如错误归类某些出版物。学习到的模式展示了广泛抽取如何扩展,也说明了为什么部分后期模式可能需要人工监督以减少语义漂移。
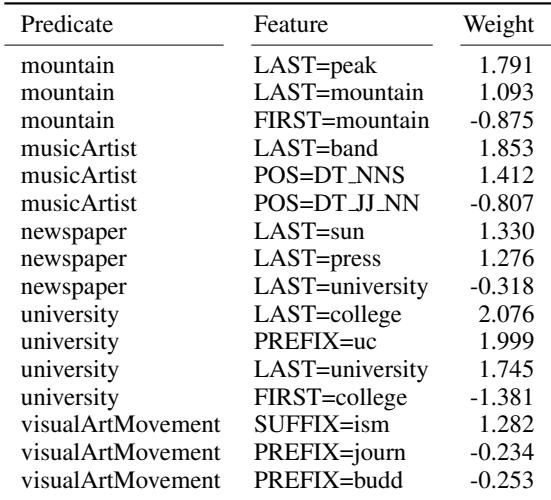
该表说明,学习到的特征可能对类别预测产生正面或负面影响。位置线索非常重要,因为像 mountain 这样的词,当它位于表达式末尾时会增加该表达式属于 mountain 实例的概率,当它位于表达式开头时则会降低该概率。这些示例还显示,词尾和词性模式有助于识别 music artists 和 newspapers 等类别。mountain 作为最后一个词时具有正面影响,作为第一个词时具有负面影响。以 band 结尾,以及由限定词后接复数名词组成的名词短语模式,有助于预测 music artist。限定词加形容词加名词的模式会降低 music artist 的概率,这表明并非所有常见名词短语都指示音乐艺人。以 sun 结尾有助于预测 newspaper。
这些实验考察了多种谓词上的提升信念、学习模式以及特征影响,表明通过组合多个来源和可复用的表层模板,抽取能力可以扩展。提升数量随时间保持大致稳定,但估计精确率逐渐下降,并因谓词而异。这些发现表明,位置、词汇和句法线索支持广泛的类别学习,同时也引入了可能需要监督的错误和语义漂移。