Command Palette
Search for a command to run...
最大熵逆强化学习
最大熵逆强化学习
Brian D. Ziebart Andrew Maas J.Andrew Bagnell Anind K. Dey
摘要
近期研究表明,将模仿学习问题建模为马尔可夫决策问题的求解具有显著优势。该方法将学习过程转化为恢复一个效用函数的问题,使得近最优策略所诱导的行为能够紧密模仿所演示的行为。本文提出了一种基于最大熵原则的概率方法。该方法提供了定义明确且全局归一化的决策序列分布,同时具备与现有方法相同的性能保证。我们在真实世界导航与驾驶行为建模的背景下发展了该技术,其中所采集的数据本质上具有噪声和不完美性。我们的概率方法不仅能够建模路径偏好,还为基于部分轨迹推断目的地和路线提供了一种强大的新途径。
一句话总结
卡内基梅隆大学提出一种最大熵逆强化学习方法,该方法产生定义良好且在决策序列上全局归一化的分布,同时保留现有方法的性能保证,从而能够对带噪声的导航和驾驶行为进行概率建模,推断路线偏好,并从部分轨迹预测目的地。
核心贡献
-
一种将逆强化学习与模仿学习相结合的最大熵概率方法,定义决策序列上的全局归一化分布,并保留早期特征匹配方法的性能保证。
-
该方法通过在全局归一化策略上进行凸优化来对行为预测进行表述,从而解决先前模型中的歧义问题,避免标签偏置,使具有相同期望回报的路径获得相同概率,并使较高回报的路径获得较高概率。
-
该方法在真实世界的导航和驾驶行为上进行评估,包括大规模演示驾驶数据以及较小特征空间中的路线偏好建模,支持从部分轨迹推断路线和目的地。
引言
在模仿学习中,目标是从观察到的行为中推断 agent 的序贯决策策略。该任务对于根据 GPS 轨迹建模驾驶者路线偏好等应用特别有用。早期的逆强化学习方法通过使演示行为看起来最优来恢复未知奖励函数,但它们经常面临歧义问题,因为许多奖励函数或策略都可以解释同一数据,并且演示行为也可能带有噪声或仅为部分最优。结构化间隔方法可以处理这类问题的某些形式,但当没有任何奖励使观察到的行为明显优于替代行为时,可能会遇到困难;而局部归一化的概率模型可能引入标签偏置,并需要更困难的优化。作者利用最大熵概率方法解决这些问题。该方法在轨迹上学习全局归一化分布,以有原则的方式解决歧义,为 MDP 提供高效学习和推断,并可以与隐变量结合,以推断未来路线或目的地。
数据集
-
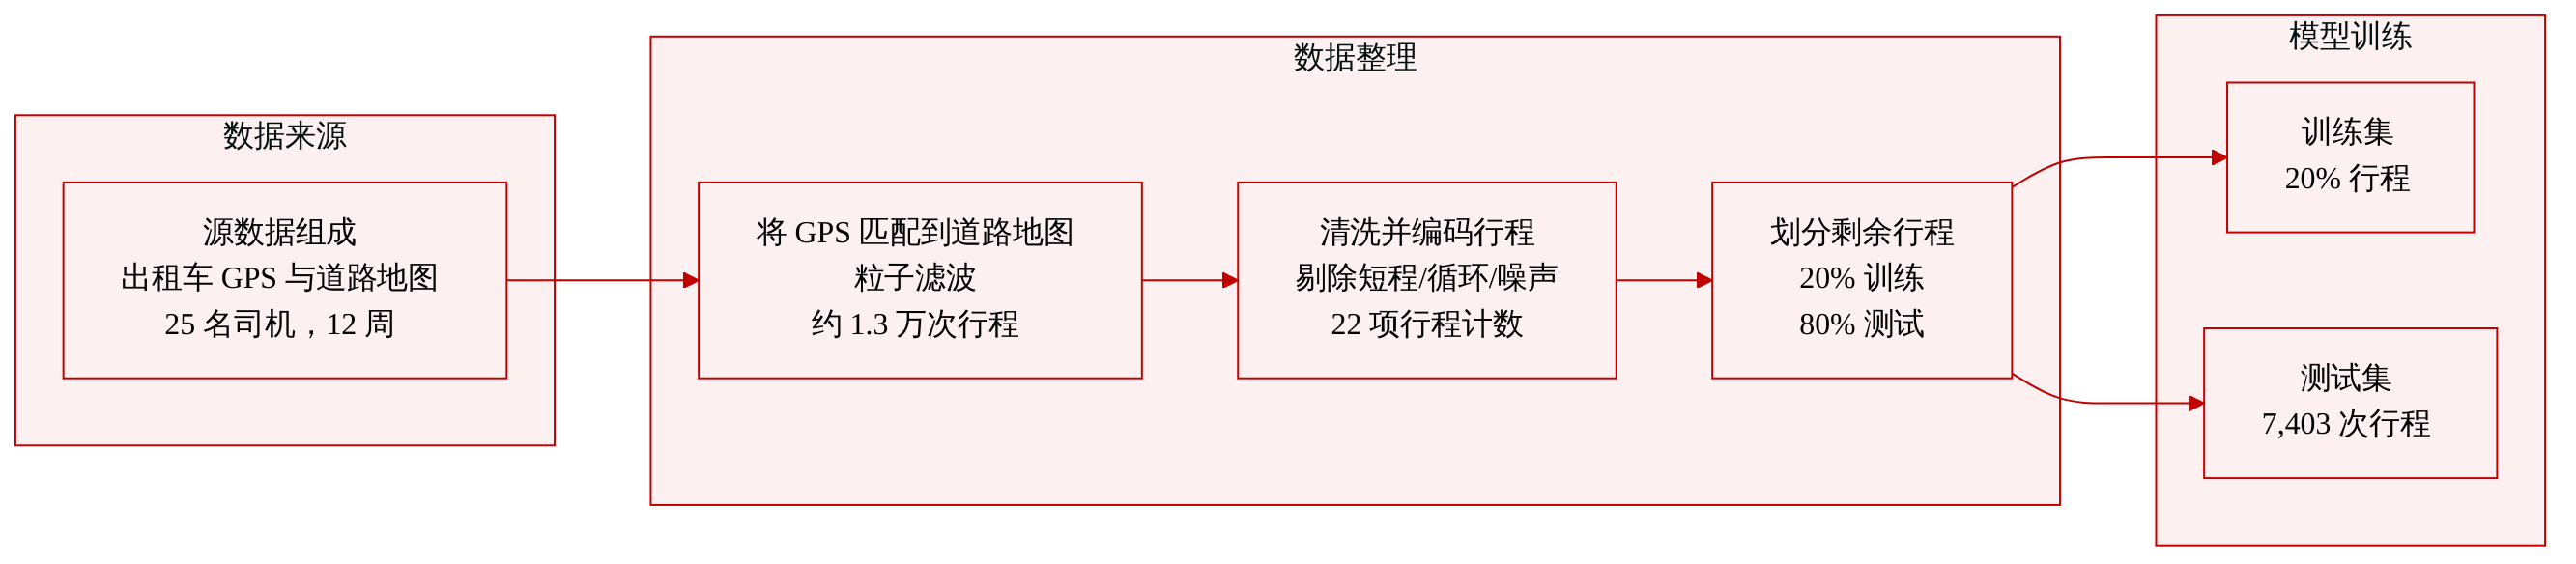
数据来源:作者收集 25 位 Yellow Cab 出租车司机在 12 周期间、覆盖一天中各个时间段、围绕匹兹堡地区的 GPS 轨迹数据。原始轨迹覆盖超过 100,000 英里行驶距离,以及超过 3,000 小时的驾驶时间。
-
行程构建:使用粒子滤波器将稀疏 GPS 轨迹拟合到道路网络。随后,基于时间阈值识别停车位置,并将拟合后的轨迹分割为约 13,000 个不同行程。
-
过滤规则:约 30% 的行程因过短、过度循环或噪声过大而被丢弃。道路段数量少于 10 的行程被视为过短。
-
划分:过滤后,使用剩余行程的 20% 进行训练,使用 80% 进行测试,得到包含 7,403 个样本的测试集。
-
特征模式:每个行程使用四个维度的道路段特征表示:道路类型、速度、车道和转弯。道路类型从州际公路到本地道路,速度从高速到低速,车道从单车道到多车道。转弯被归类为直行、左转、右转、急左转和急右转。
-
元数据构建:每条路径由各分段类别中的英里数以及每种转弯类型数量描述。每个道路段会贡献 22 个不同的特征计数。
方法
作者围绕最大熵逆强化学习构建该方法。利用最大熵原则,当多个奖励函数或策略能够复现演示行为时,解决歧义问题。该方法不选择任意策略或任意奖励函数,而是在完整行为路径上定义概率分布,并选择与演示的经验特征期望相匹配、且不超出观察特征所需而引入额外偏好的分布。
核心模型是由奖励权重 θ 参数化的路径分布。在确定性马尔可夫决策过程中,演示轨迹可以被视为可变长度的状态序列,所得路径概率与指数奖励得分成正比:
P(ζi∣θ)=Z(θ)1eθ⊤fζi=Z(θ)1e∑sj∈ζiθ⊤fsj.这里,fζi 是路径的求和特征向量,Z(θ) 是配分函数。在这种表述下,总奖励相同的路径获得相同概率,而奖励较高的路径以指数方式具有更高概率。对于有限时间范围问题以及具有折扣奖励的无限时间范围问题,配分函数总是收敛。对于具有吸收零奖励状态的无限时间范围问题,配分函数可能无法收敛;但如果演示轨迹在有限步数内被吸收,最大熵奖励权重仍然定义良好。
对于非确定性马尔可夫决策过程,转移结果具有随机性。作者将路径分布以转移分布 T 为条件,并要求实际路径与采样到的转移结果相容。精确表达式为
P(ζ∣θ,T)=o∈T∑PT(o)Z(θ,o)eθ⊤fζIζ∈o.这个针对可能结果分配的求和通常难以计算。因此,作者假设转移随机性对整体行为影响有限,并且配分函数在不同结果样本上近似恒定。由此得到可计算的近似:
P(ζ∣θ,T)≈Z(θ,T)eθ⊤fζ(st,at,st+1)∈ζ∏PT(st+1∣at,st).当该近似配分函数收敛时,路径分布会诱导出一个随机策略。通过在以该动作开始的所有完整路径上聚合,可以得到该动作的概率:
P(a∣θ,T)∝ζ beginning with a∑P(ζ∣θ,T).学习过程最大化在最大熵路径分布下演示路径的似然。最优奖励权重由下式给出
θ∗=argθmaxζ~∑logP(ζ~∣θ,T).对于确定性 MDP,该目标是凸的,因此可以使用基于梯度的优化。梯度衡量演示的经验特征期望与模型期望特征计数之间的差异:
∇L(θ)=f~−ζ∑P(ζ∣θ,T)fζ=f~−si∑Dsifsi.这里,Dsi 是当前路径分布下状态 si 的期望状态访问频率。在最优解处,特征期望相等,这意味着学习到的模型能够复现观察到的行为,而无需恢复演示 agent 原本使用的精确奖励权重。
一个核心计算组件是期望状态频率的计算。直接枚举所有可能路径不可行,因为路径数量随时间范围呈指数增长。该方法采用类似条件随机场中的前向向后计算或强化学习中的值迭代的过程,计算近似的状态占用频率。算法用足够大的固定时间范围替换无限时间范围。它首先从可能的终止状态回传概率质量,在每个动作和状态处计算与配分函数相关的分支值,将这些分支值转换为局部动作概率,然后将这些概率向前传播,以随时间累积状态访问频率。这些频率用于评估模型特征期望并构造梯度。
在路线规划设置中,作者将该流程实例化为道路网络上的最大熵 IRL 模型。道路段被视为状态,交叉口转弯被视为动作。目的地表示为吸收状态,在该状态下不再累积代价。假设驾驶者优化一个潜在代价函数,该函数平衡旅行时间、安全性、燃料消耗和其他旅行成本等因素。由于假设奖励权重与目标无关,可以在仅目的地不同的行程之间学习一个效用模型。
为了提高效率,可以将路径空间限制为一类合理的较优路径,而不是考虑长度不超过最大值的所有路径。这保持优化可计算,减少不必要的环路探索,并保留最大熵表述的优势。
通过比较最大熵路径模型与基于动作的分布模型,可以突出在整条路径上进行推理相比局部动作推理的优势。基于动作的模型根据采取某个动作后的未来最优值来分配概率:
P(a∣si,θ)∝eQ∗(si,a).该模型在每个动作处进行局部归一化,而最大熵模型在完整路径上进行归一化。由此产生的差异通过下面的例子说明。
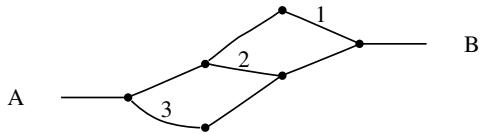
在图中所示情形下,如果从一个点到另一个点的可能路径具有相同的总奖励,最大熵模型会赋予它们相同概率。基于动作的模型则可能赋予不同概率,因为概率质量会在每个状态处被局部划分。因此,即使总奖励相同,具有不同分支结构的路径也可能获得不同概率。这种行为反映了局部归一化偏置,并促使该方法使用路径级别的最大熵分布。
实验
实验使用路径重叠度、路径匹配度和似然标准,在留出驾驶者轨迹上评估已训练的路线模型,并将最大熵模型与基于动作的模型同基于代价和基于速度的最短路径基线进行比较。最大熵模型始终与观察路径产生最佳定性匹配,其学习到的代价能够捕捉有用偏好,例如惩罚由许多短道路组成的路线。额外评估表明,该模型可以通过贝叶斯推断从部分观察到的路线中推断可能的目的地,支持个性化的路线感知应用,并提示诸如时间段等上下文信息可以进一步提高预测效果。
最大熵模型产生与保留驾驶者路径最接近的匹配,并在评估方法中给出最强的报告路线似然。它在路线重叠和高覆盖率匹配指标上优于预期旅行时间、最大间隔和基于动作的预测。最大熵路径预测与演示路线表现出最强一致性。基于旅行时间的路径规划在路线匹配方面落后于基于学习的方法。从基于动作的模型中学习边代价,相比其最可能路径能够改善匹配。最大熵模型也比基于动作的模型给出更有利的平均对数概率。
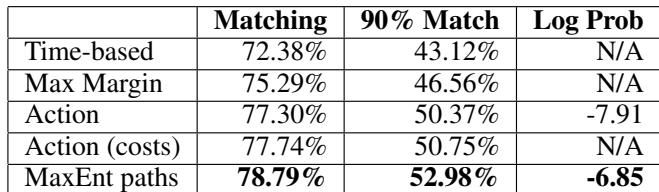
实验比较了基于学习的路径预测方法与旅行时间路径规划,目标是匹配演示的驾驶者路线。最大熵模型始终与保留路线达成最接近的一致,并给出最有利的路线似然,在重叠和基于覆盖率的评估中优于基于动作和旅行时间的方法。这些结果支持最大熵是路线预测中最强的方法,而从基于动作的模型中学习边代价能够改善匹配,优于仅使用该模型最可能路径。