Command Palette
Search for a command to run...
Nemotron 3.5 Transcribe 技术报告
Nemotron 3.5 Transcribe 技术报告
摘要
一段录音不存在唯一正确的转写:何种转写算作正确,取决于谁阅读以及用于何种目的,例如数字采用口语形式还是书面形式、逐字转写还是经过整理的措辞,或语码转换语音的文字脚本。传统语音识别系统在训练阶段即固定一种转写规范;而语音增强型语言模型(SALM)将语音编码器与大语言模型(LLM)相结合,可通过自然语言指令加以引导。我们提出 Nemotron 3.5 Transcribe,一个用于此类智能转写的 SALM。它将一个 Transformer 语音编码器和一个冻结的 Nemotron 3 Diarization 模型与 Nemotron 3.5 Lightning 30B-A3B 相结合,后者是一个融合 Mamba–Transformer 架构的专家混合大语言模型,活跃参数约为 4.3B。单个模型即可完成逐字转写、书面形式转写、上下文相关转写、说话人归属转写和富转写,以及语音翻译和口语语种识别,覆盖 40 种语言;还可按需返回带说话人归属的词级时间戳。它还能理解语音、声音和音乐以支持转写,但它不是通用助手。我们通过单个有监督微调阶段对模型进行训练,随后进行一个简短的强化学习阶段。Nemotron 3.5 Transcribe 在多人重叠语音的说话人归属自动语音识别(ASR)上达到了最先进的准确率;据我们所知,它是首个在该任务上超越专用级联系统的 SALM。它在 English Open ASR Leaderboard 和 Multilingual Open ASR Leaderboard 上的平均词错误率(WER)分别达到 4.71% 和 4.62%,为开放权重模型中的最佳水平;在给定一个预期实体列表的情况下,它将 ContextASR-Bench 上的命名实体错误降低至原来的六分之一。我们在 OpenMDW-1.1 许可证下发布该模型的 BF16、FP8、NVFP4 和 GGUF 版本,并在 NeMo Speech 中提供微调工具包和智能体技能。
一句话总结
NVIDIA 发布了 Nemotron 3.5 Transcribe,这是一种语音增强语言模型,将 Transformer 语音编码器和冻结的 Nemotron 3 Diarization 模型与 Nemotron 3.5 Lightning 30B-A3B 混合 Mamba-Transformer 专家混合 LLM 相结合,在 40 种语言中提供指令引导的转录、翻译和口语语言识别,并且它是首个在说话人归属 ASR 上超越专用级联系统的 SALM,在 Open ASR Leaderboard 上英语 WER 达 4.71%,多语言 WER 达 4.62%。
核心贡献
- 论文介绍了 Nemotron 3.5 Transcribe,这是一个基于 Nemotron 3.5 Lightning 30B-A3B 混合 Mamba-Transformer 专家混合 LLM 的单一语音增强语言模型,活跃参数约 4.3B,支持 40 种语言的逐字、书面形式、上下文、说话人归属和富转录、语音翻译和口语语言识别,并可应请求提供说话人归属词级时间戳。该模型在重叠多说话人语音上取得了最先进的说话人归属 ASR 精度,据报告是首个在该任务上超越专用级联系统的 SALM,在英语 Open ASR Leaderboard 上平均词错误率为 4.71%,在多语言榜单上为 4.62%(开放式权重模型中最佳),并在提供预期实体时将 ContextASR-Bench 上的命名实体错误降低六倍。
- 该架构使用 Parallel Expert Encoder,将冻结的说话人分离模型中的说话人活动注入 ASR 表示,从而在无需改变 LLM 架构的情况下通过序列化输出训练实现说话人归属转录。训练流程使用单个监督微调阶段,随后是短暂的强化学习阶段,按答案 token 总量对来源采样,跨任务指令重用 ASR 示例,并包含用于投机解码的联合多 token 预测训练。
- 模型检查点以 BF16、FP8、NVFP4 和 GGUF 版本发布,许可证为 OpenMDW-1.1,同时发布了训练流程、微调工具包和 NeMo Speech 中的 agent 技能。在单个 GB300 GPU 上演示了对新语言、领域和任务的微调,共 17 个任务,每个任务通常需要 0.5 到 2.3 GPU 小时。
引言
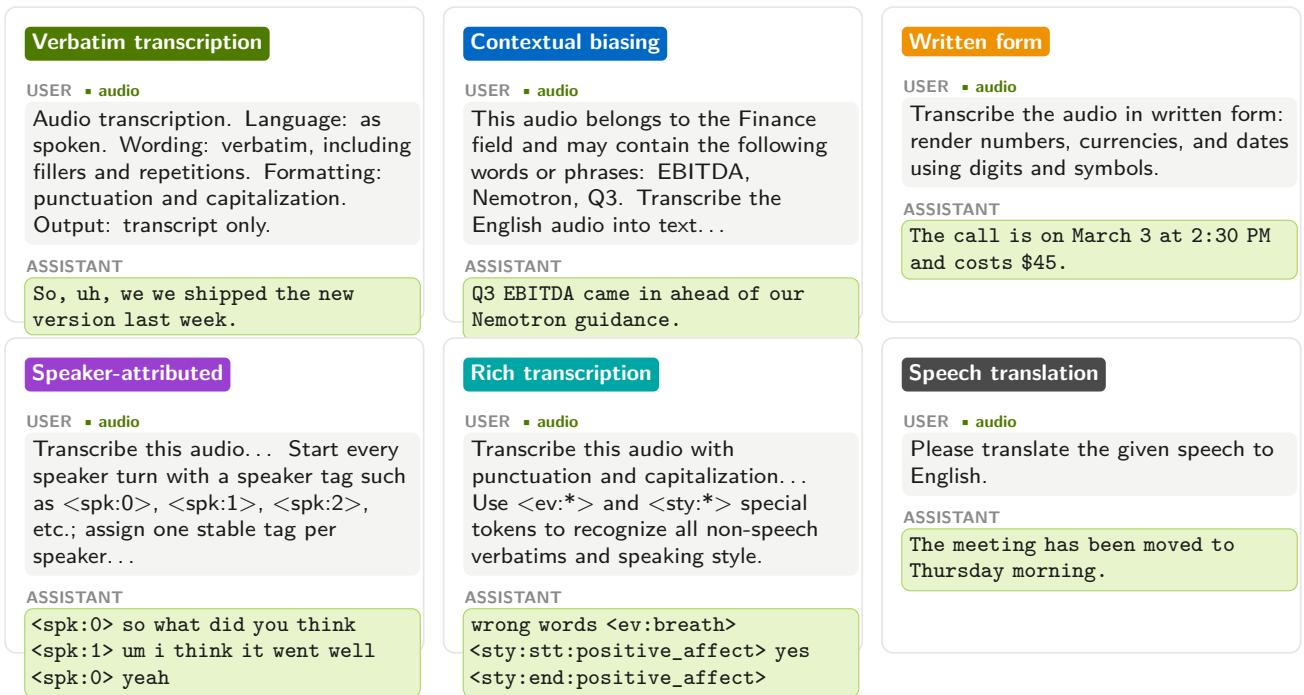
语音增强语言模型最近开始匹配专用 ASR 系统,并提供可提示的转录、翻译和格式控制,但实际上大多数模型只针对单一转录任务训练,或者为了广泛音频理解而牺牲转录质量。现实中的转录还涵盖逐字和书面形式输出、罕见实体识别、说话人归属、长录音、语码转换和非语音音频,这些能力竞争相同的训练预算。作者提出了 Nemotron 3.5 Transcribe,这是一个基于混合 Mamba-Transformer 专家混合模型构建的语音 LLM。它使用 Parallel Expert Encoder 将可训练 ASR 编码器与冻结的说话人分离模型融合,并采用大规模多任务混合训练,随后进行强化学习。该模型面向 40 种语言的智能转录,包括逐字、书面形式、上下文、多说话人和富转录、语音翻译以及带词级说话人归属时间戳的语言识别。
数据集
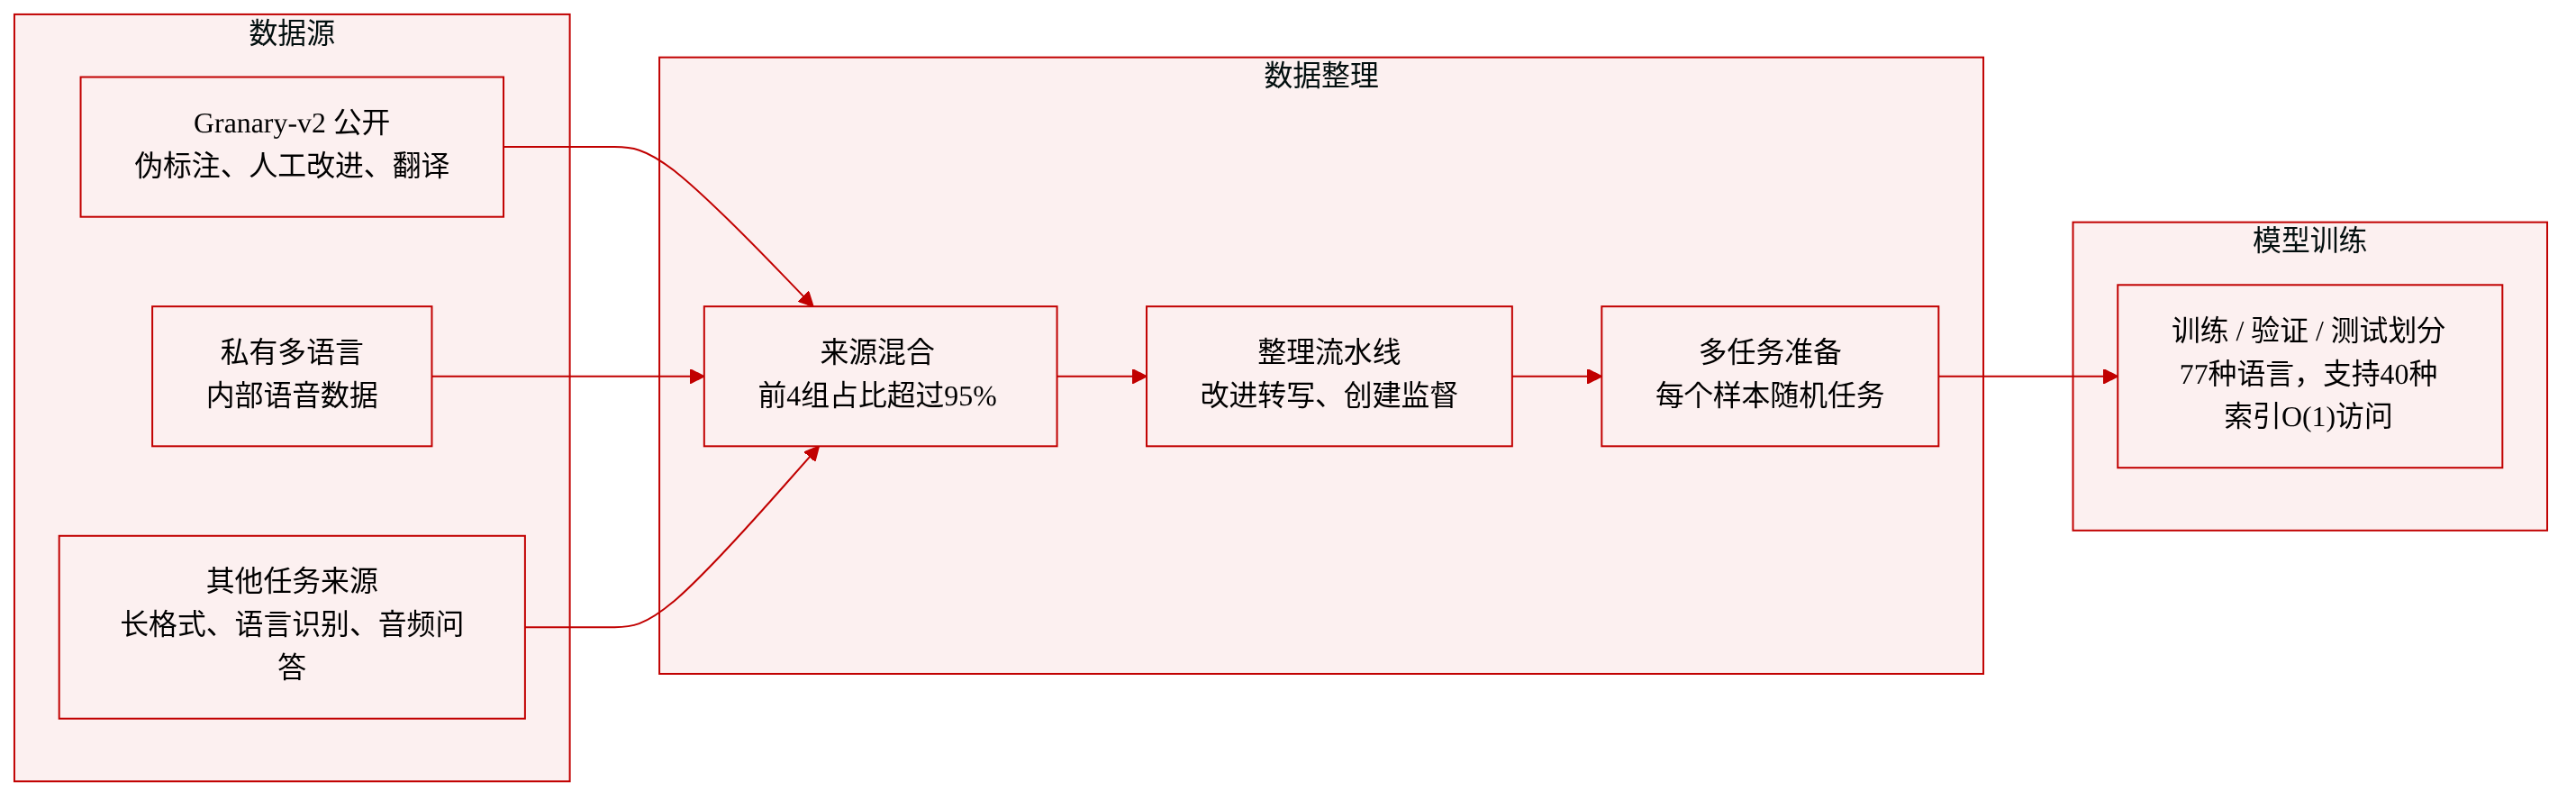
数据集构成与来源
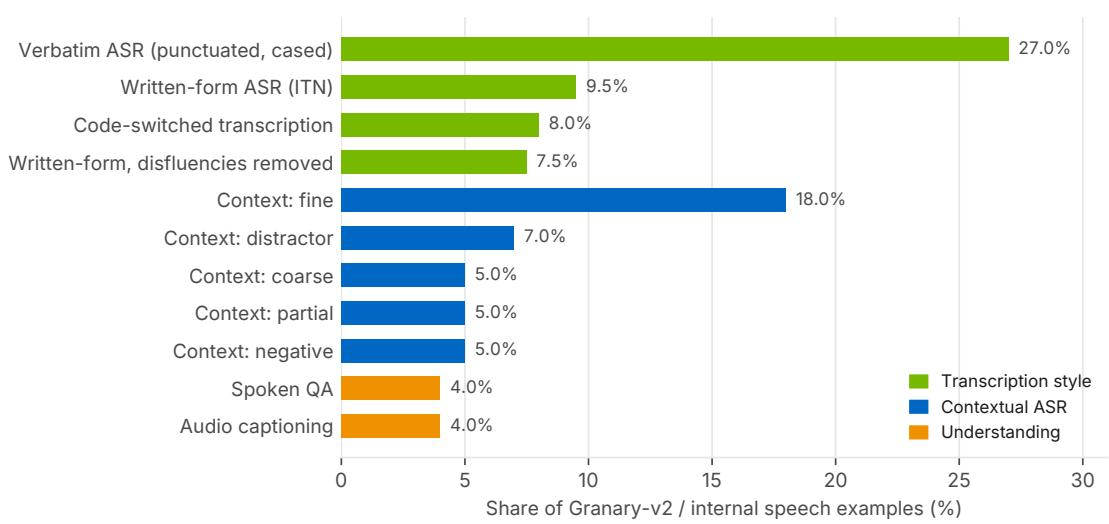
- 作者使用 Granary-v2 多语言语音数据集及其可复用的数据处理与标注流水线。该流水线生成或改进转录文本,并为短式和长式 ASR、文本规范化、非流利控制、上下文 ASR、语码转换转录、语音问答、语音字幕、口语语言识别和语音翻译创建监督。
- 公开发布包含 Granary-v2 数据中可共享的部分。完整训练混合还包括私有多语言语音数据和额外的任务专用来源。
- 根据图 5,四个采样组占训练样本的 95% 以上:Granary-v2 伪标签数据、Granary-v2 人工标签改进数据、Granary-v2 语音翻译和内部多语言语音数据。
- Granary-v2 还提供长式 ASR、印度英语和语言识别样本作为独立的采样组。其他来源的采样概率在 0.01% 到 3% 之间,针对多说话人转录或音频理解等能力。
- Granary-v2 扩展了原始 Granary 语料库。
规模与语言覆盖
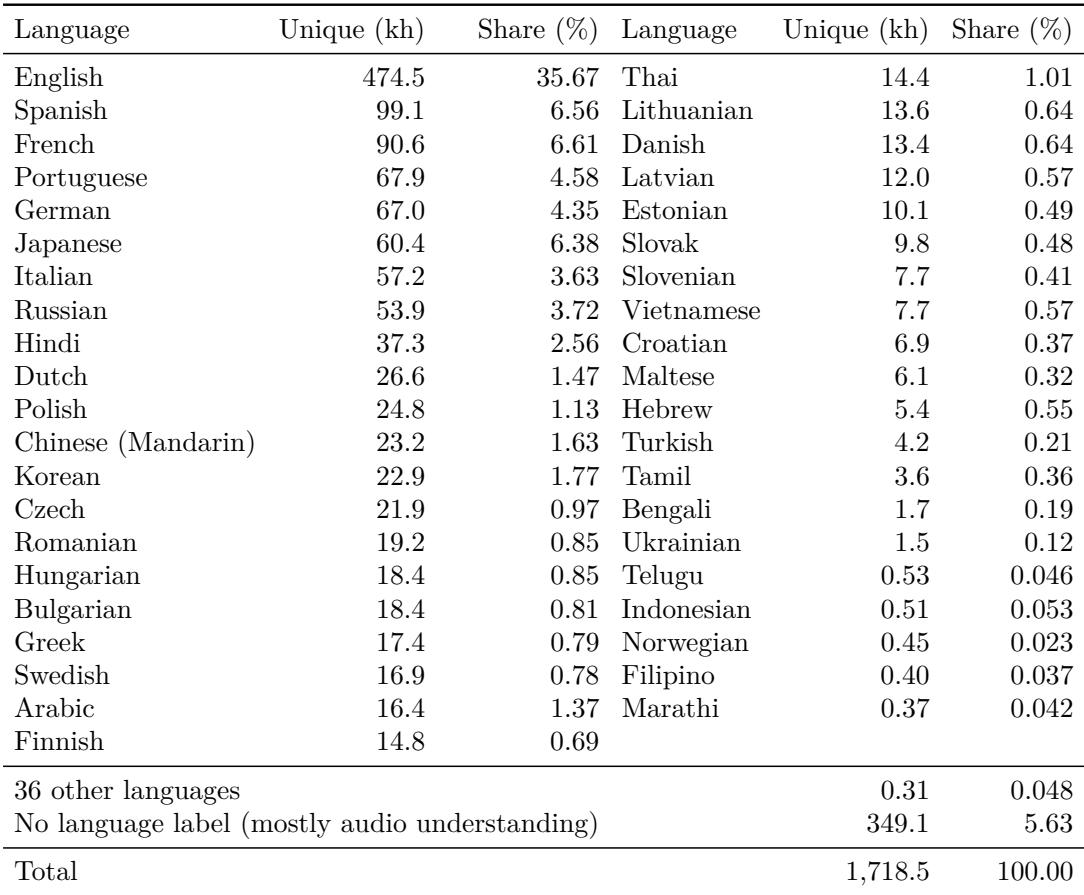
- 语音数据涵盖 77 种语言。其中 41 种语言每种至少有 370 小时不重复音频(表 2),40 种支持转录。
- 挪威语被排除在支持的转录之外,因为其训练数据未提供可用质量。
- 区域变体包括美国、印度和英国英语;美国和西班牙西班牙语;法国和加拿大法语;葡萄牙和巴西葡萄牙语。
- 英语占训练中可见音频的 36%。接下来的八种语言各占 2.5% 到 7%,其余 32 种支持语言各占不到 2.5%。
- 其他 36 种语言总共出现约 300 小时,未被正式支持。
- 混合数据还包括 35 万小时没有语言标签的音频,主要来自音频和语音理解来源。这些无标签音频占训练中可见音频的 5.6%。
任务分布与数据准备
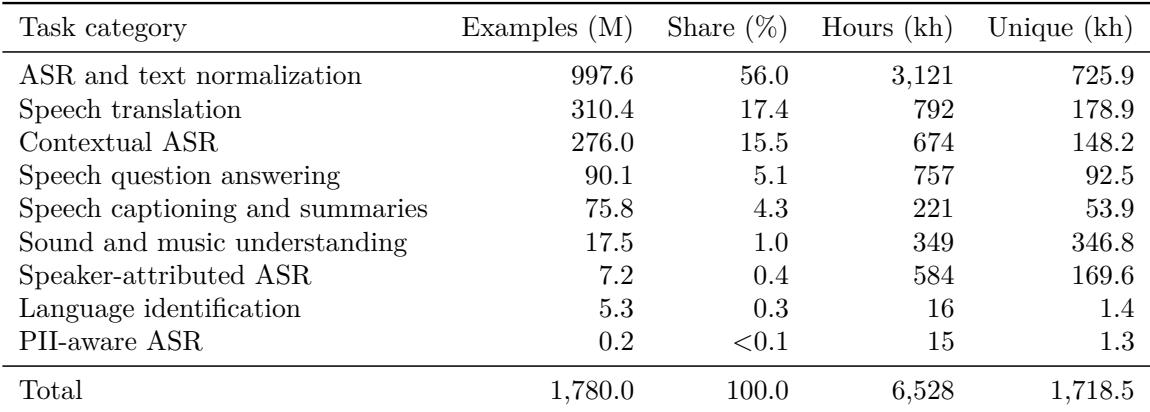
- 表 3 显示任务类别分布:无上下文和有上下文的转录占样本的 70% 以上,语音翻译占 17%。
- 数据被准备为多任务混合,每个样本随机分配一个任务,例如上下文 ASR。
- 使用索引数据实现 O(1) 随机访问。
- 裁剪和元数据构建细节在本节中未单独描述。
方法
作者提出了 Nemotron 3.5 Transcribe,这是一种遵循语音增强语言模型设计的语音转文本模型。其架构采用 Parallel Expert Encoder 将音频转换为嵌入,随后插入仅解码器 LLM 的提示中。LLM 再自回归生成响应。
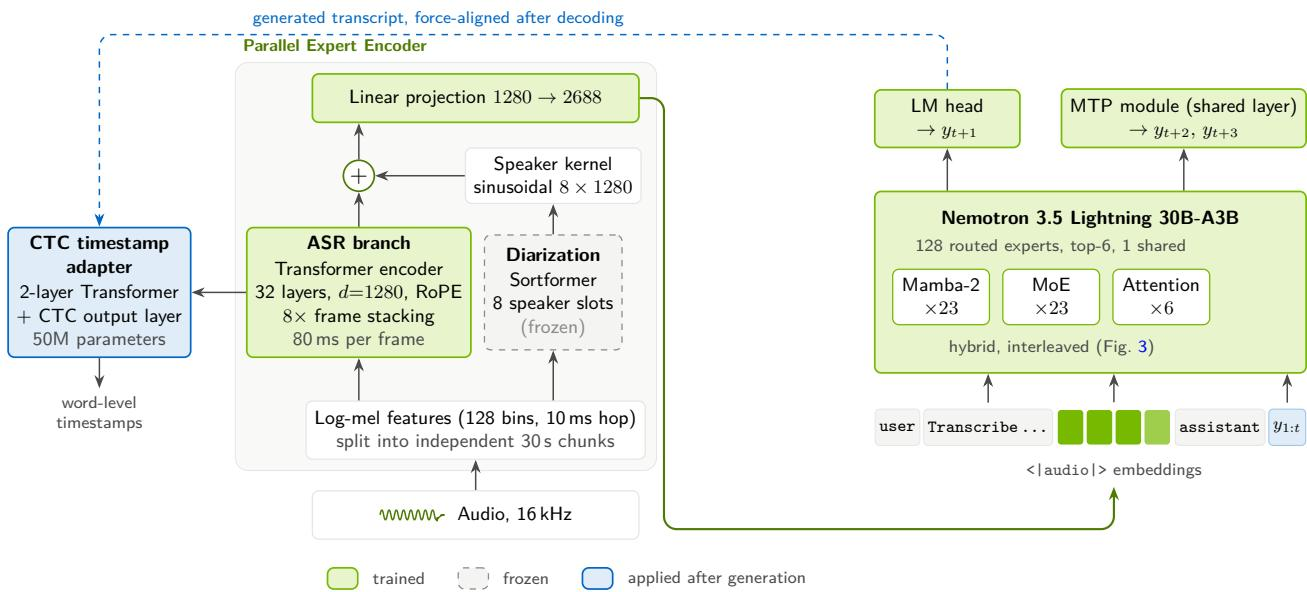
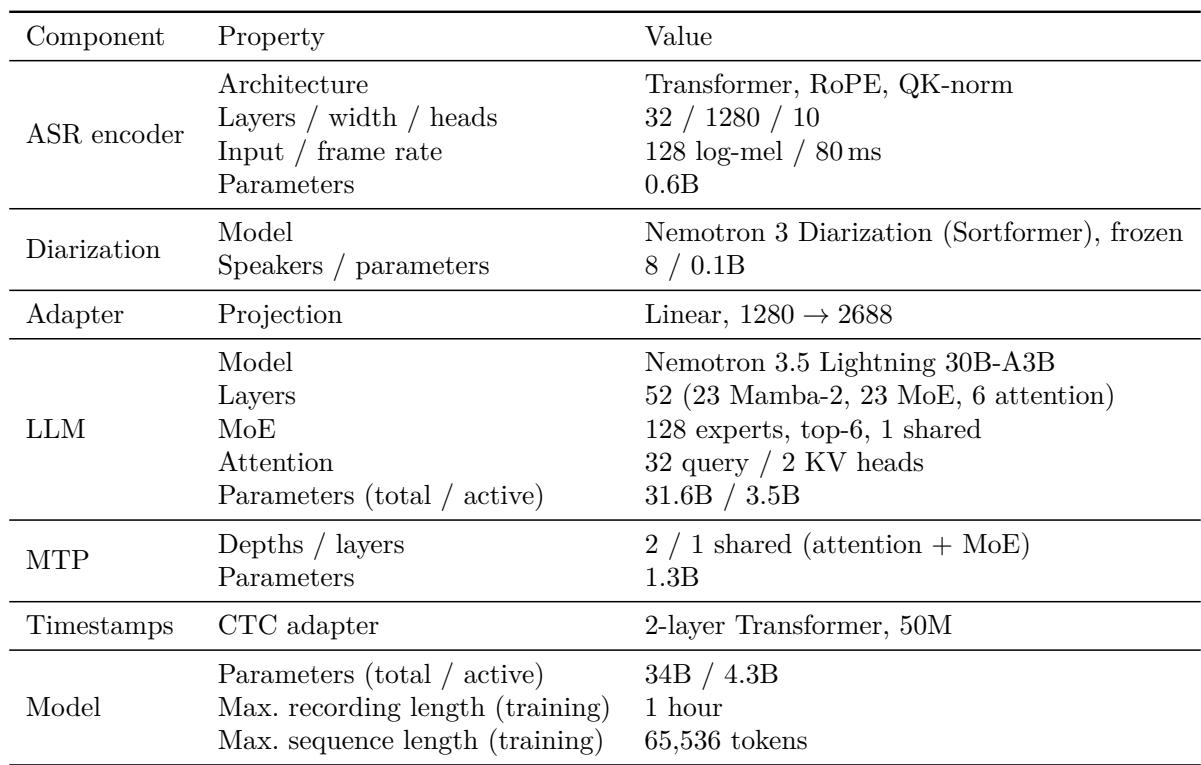
Parallel Expert Encoder 处理被切分为独立 30 秒片段的 16 kHz 音频。它由两个分支组成:一个具有 32 层的可训练 Transformer ASR 编码器和一个冻结的 Sortformer 说话人分离模型。说话人分离模型估计每帧说话人活动,这些活动通过固定正弦核映射后加到 ASR 表示上。该设计为 LLM 提供带有说话人信息的声学表示,而无需修改 LLM 架构。编码器输出通过一个从 1280 维到 2688 维的单一线性投影映射到 LLM 嵌入空间,替换提示中的音频占位 token。
语言模型主干是 Nemotron 3.5 Lightning 30B-A3B,一种混合 Mamba-Transformer 专家混合模型。它包含 52 层,其中 23 个 Mamba-2 层、23 个 MoE 前馈层和仅 6 个分组查询注意力层。
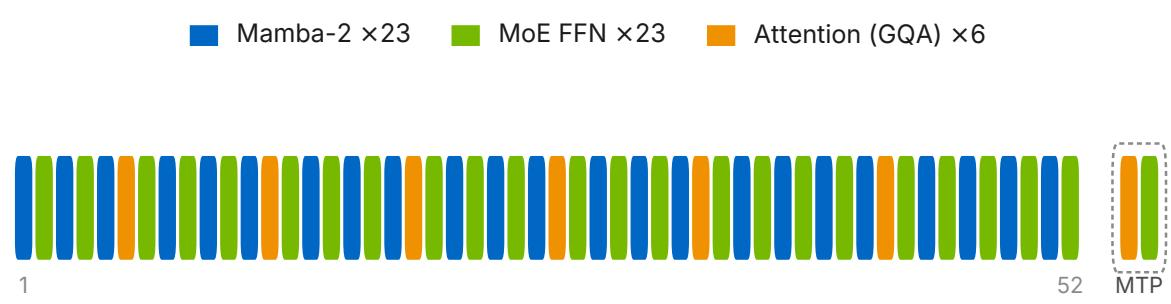
如此少的注意力层最小化了键值缓存大小,这对处理长音频录音至关重要。每个 MoE 层使用 128 个路由专家,采用 top-6 路由和一个共享专家,结果每个 token 约有 35 亿活跃参数。
为了提高推理效率,该模型联合训练了 Multi-Token Prediction 目标。MTP 模块包含一个注意力块和一个 MoE 块,在两个预测深度上复用并共享参数。训练时,它通过将主干隐藏状态与真实 token 嵌入结合,预测位置 t+2 和 t+3 的 token。推理时,该模块充当投机解码的草稿模型。
对于词级时间戳,作者加入了轻量级 Connectionist Temporal Classification 适配器。该适配器复用 ASR 编码器表示,通过转置卷积上采样,并通过两个 Transformer 层处理。文本生成后,CTC 强制对齐将转录文本与音频对齐以生成单词时间戳。
训练过程首先在大型多任务混合数据上进行监督微调,随后进入强化学习阶段以直接优化转录准确率。
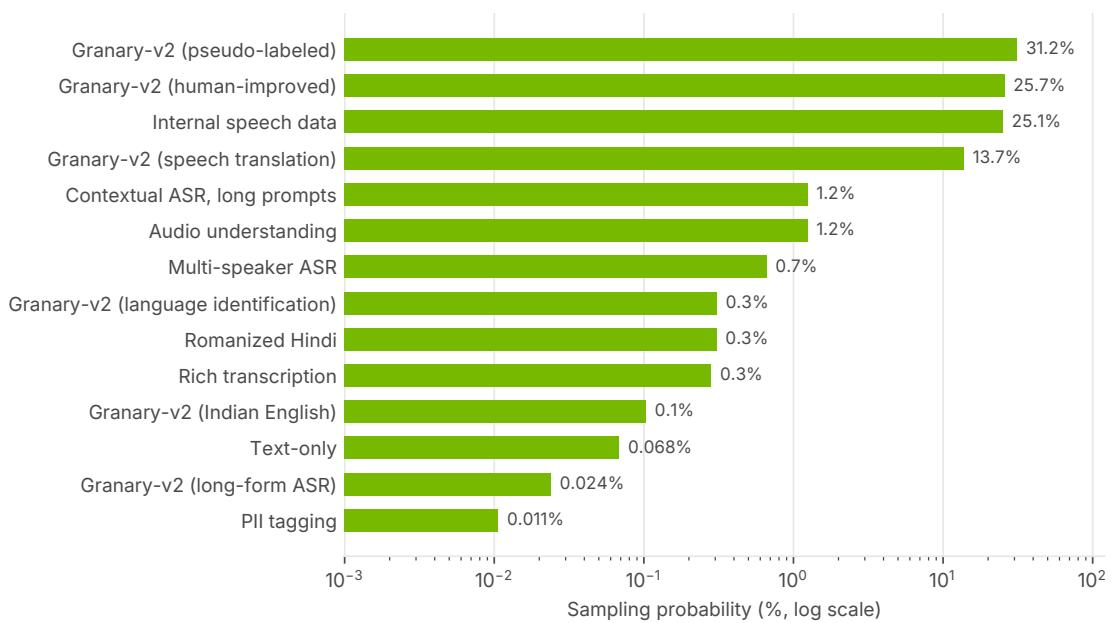
训练数据来自 Granary-v2 和内部多语言语音来源,覆盖 77 种语言。数据混合根据每个来源的答案 token 总量进行平衡,以确保各任务监督稳定。
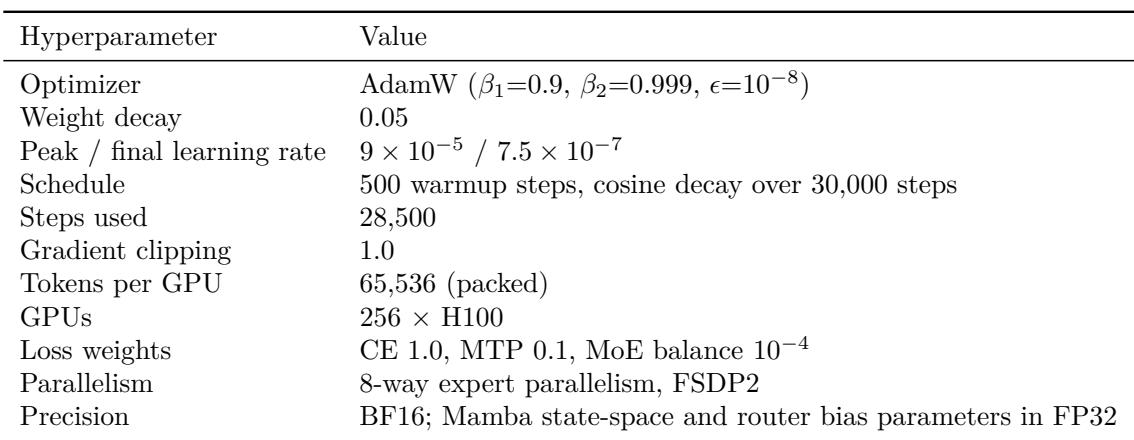
在监督微调期间,模型训练 28,500 步,使用助手轮次的交叉熵损失,并结合 MTP 损失和 MoE 负载均衡损失。除说话人分离模型和特征提取器外,所有参数使用 AdamW 联合训练。训练基础设施使用 32 个节点,每个节点 8 块 NVIDIA H100 GPU,采用专家并行和完全分片数据并行。
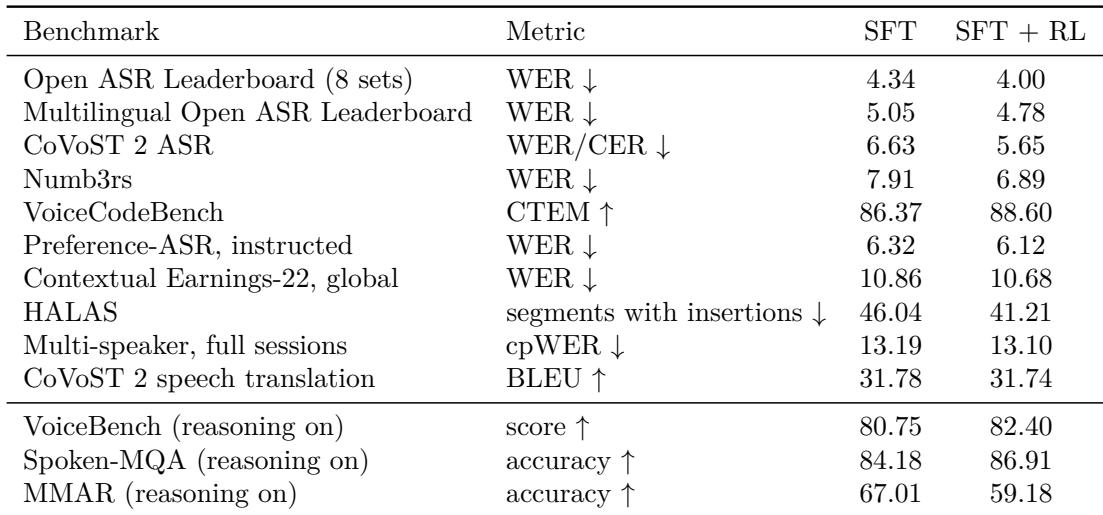
在监督微调之后,作者应用短暂的强化学习阶段,使用 Group Sequence Policy Optimization 进行 400 步。奖励定义为 1−WER,其中 WER 是词错误率,对普通话使用字符错误率。强化学习阶段更新参数子集,包括 LLM 的 Mamba 和注意力块、最后两层 ASR 编码器以及音频到 LLM 的投影,同时冻结 MoE 块和路由器。
最后,CTC 时间戳适配器和用于投机解码的 DFlash2 草稿模型在冻结主干之上分别训练。CTC 适配器使用 CTC 目标优化,而草稿模型被训练为使用局部动态卷积和成对选择器并行预测 token 块。
实验
评估使用发布的后强化学习检查点,在面向部署的 vLLM 设置中进行投机解码,并在公开基准上与开放和商业基线比较,转录、翻译和语言识别使用贪婪解码,音频理解和指令跟随使用推理模式。在这些实验中,该模型在英语、长式、多语言、上下文、实体密集和说话人归属 ASR 上表现出有竞争力的开放权重性能,执行语音翻译和总体准确的语言识别,并从循环护栏和提供的上下文中明显受益,而语码转换语音和普通话远场会议仍是相对弱点。量化研究发现 FP8 能很好地保持准确率,NVFP4 在部分多语言和多说话人场景中提供更高效率但带来更大退化,其他评估则突出精确的多说话人词级时间戳以及有用的音频理解和语音指令跟随,同时将该系统主要定位为转录模型,而非通用全模态或纯文本模型。
Nemotron 3.5 Transcribe 将基于 Transformer 的 ASR 编码器与冻结的说话人分离模型及线性适配器配对。ASR 编码器远大于说话人分离模型,并以低帧率处理 log-mel 输入。适配器将编码器输出映射到 LLM 更宽的隐藏维度。ASR 编码器使用 RoPE 和 QK-norm,具有 32 层、宽度 1280 和 10 个注意力头。冻结的说话人分离模型最多支持 8 个说话人,参数约 0.1B,而 ASR 编码器约 0.6B。线性适配器将 1280 维编码器输出投影到 2688 维。
在覆盖的语言中,41 种语言至少有 370 小时不重复音频,40 种支持转录。训练音频分布严重偏向英语,英语在不重复小时数和总音频占比上均占主导地位。西班牙语、法语、葡萄牙语、德语、日语和意大利语构成第二梯队,其余所列语言贡献小得多。英语占所有音频小时数的三分之一以上,是其他所列语言占比的五倍以上。日语的总音频占比与西班牙语和法语相当,尽管其不重复小时数较少。
训练音频混合以 ASR 和文本规范化为主,其占明显多数的样本和最大的可见音频量。语音翻译和上下文 ASR 是按样本占比划分的下一大类。声音与音乐理解以及说话人归属 ASR 等较小类别相对于其样本数量贡献了大量不重复音频小时数,表明重复较低或录音较长。ASR 和文本规范化占所有训练样本的一半以上以及最多的可见音频小时数。语音翻译和上下文 ASR 合计约占训练样本的三分之一。声音与音乐理解的不重复与可见音频小时数之比接近 1:1,表明重复较低。说话人归属 ASR 的样本占比最小,但贡献了大量不重复音频小时数。
监督微调使用 AdamW,并采用权重衰减和梯度裁剪,先进行短暂热身,随后在数万步上进行长时间余弦学习率衰减。训练使用每个 GPU 总计数万 token 的打包序列。后续强化学习使用的检查点取自计划衰减临近结束时。AdamW 优化器设置包括标准动量系数和较小 epsilon,具有较低峰值学习率和更低最终学习率。余弦衰减在短暂热身后进行,接近计划结束时的检查点用于强化学习。每个 GPU 处理 65,536 个打包 token,权重衰减为 0.05,梯度裁剪为 1.0。
强化学习在所有报告的基准上均优于 SFT 检查点。英语、多语言和上下文 ASR 评估中的词错误率下降,其中 CoVoST 2 ASR 和 Numb3rs 的相对提升最大。VoiceCodeBench CTEM 也提高,表明该指标性能更强。RL 训练模型在所有报告的指标上均优于 SFT 检查点,降低了 ASR 评估中的 WER,并提高了 VoiceCodeBench CTEM。在报告的基准中,CoVoST 2 ASR 和 Numb3rs 的 WER 降幅最大,而 Contextual Earnings-22 的提升较为温和。
Nemotron 3.5 Transcribe 的设置通过线性适配器将大型 Transformer ASR 编码器与冻结的说话人分离模型结合,其训练数据严重偏向英语,多语言支持以 ASR 和文本规范化任务为主。监督微调使用 AdamW、打包序列和长时间余弦衰减计划,之后从较晚的 SFT 检查点开始强化学习。RL 阶段在英语、多语言和上下文 ASR 基准上持续优于 SFT 模型,CoVoST 2 ASR 和 Numb3rs 的词错误率降幅最大,VoiceCodeBench CTEM 也有所提升。