Command Palette
Search for a command to run...
后验匹配蒸馏
后验匹配蒸馏
Hidir Yesiltepe Julius Berner Arash Vahdat Pinar Yanardag
摘要
扩散蒸馏通过将预训练教师的迭代采样过程压缩为少量网络评估,从而加速图像和视频生成。基于分布的方法通过使学生输出分布与教师分布相匹配来实现这一目标。这种匹配通常由反向 KL 目标驱动,其寻模偏差倾向于占主导地位的教师模式,却牺牲了样本间的多样性。我们提出后验匹配蒸馏(PMD),这是基于分布的蒸馏家族中的一个新成员,它结合了覆盖模式的采样与任意步生成。在零总体损失下,PMD 在每个已训练噪声水平上恢复教师对干净图像的完整后验。其随机学生支持在已训练时间步网格内使用任意步采样预算,而无需进一步训练。为学习这些后验,PMD 将以固定噪声状态为条件的学生样本的指数重加权平均值与相应的教师后验均值进行匹配。在高斯损坏下,指数倾斜的后验均值是对移位输入的单次教师评估。我们证明,在一个开邻域上匹配倾斜均值能够唯一地识别完整后验。因此,PMD 通过一族均值约束来监督整个条件分布,而无需任何辅助的学生得分网络。在 SDXL 和 FLUX.2 [klein] 4B 上的实验表明,PMD 在两个模型上均取得了 4 步方法中最佳的 FID,同时在提示对齐和感知质量指标上保持有竞争力或领先的性能。
一句话总结
来自弗吉尼亚理工大学和 NVIDIA 的研究人员提出了后验匹配蒸馏(Posterior Matching Distillation,PMD),一种基于分布的扩散蒸馏方法,匹配指数重加权的学生样本均值与教师后验均值,从而无需辅助学生得分网络即可唯一识别完整后验,在 SDXL 和 FLUX.2 [klein] 4B 上取得最佳 4 步 FID。
核心贡献
- 本文提出后验匹配蒸馏(Posterior Matching Distillation,PMD),一种基于分布的蒸馏方法,结合覆盖模式的后验采样与任意步生成。在零总体损失下,PMD 在每个训练噪声级别恢复教师对干净图像的完整后验,其随机学生无需进一步训练即可在训练时间步网格内支持任意步采样。
- PMD 通过将固定噪声状态下学生样本的指数重加权均值与对应的教师后验均值相匹配,监督完整条件后验。在高斯扰动下,每个指数倾斜后验均值可通过在偏移输入上进行一次冻结教师评估得到;并且已证明,在开邻域内匹配这些倾斜均值可以在没有辅助学生得分网络的情况下唯一识别完整后验。
- 在 SDXL 和 FLUX.2 [klein] 4B 上的实验表明,PMD 在两个模型上的 4 步方法中取得了最佳 FID,同时在提示对齐和感知质量指标上保持有竞争力或领先。
引言
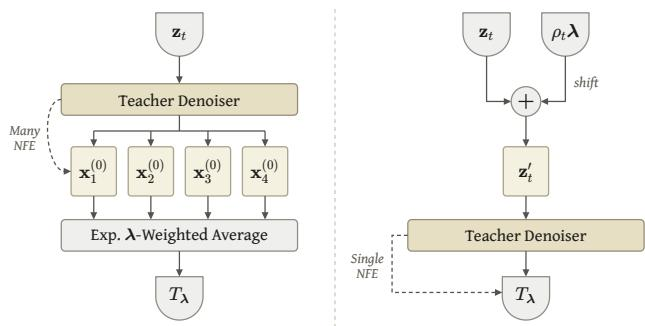
扩散模型和流模型是用于图像、视频和文本的强大生成模型,但其迭代去噪过程通常需要大量神经网络评估。蒸馏通过训练单步或少步学生来降低这一成本,但此前工作在保留内容上存在差异:基于轨迹的方法压缩教师的采样路径,而基于分布的方法(如分布匹配蒸馏和矩匹配)对齐生成边缘分布或条件均值。这些方法仍可能缺失条件结构,例如 DMD 的近似 reverse-KL 目标可能趋于模式寻求并降低多样性,而矩匹配在重加噪后的学生预测处比较均值,而不是在原始噪声输入处比较均值。作者们提出后验匹配蒸馏(Posterior Matching Distillation,PMD),该方法使用指数倾斜均值在每个噪声级别直接匹配教师的条件后验。关键的 Tilt=Shift 恒等关系允许每个目标通过冻结教师在偏移噪声输入上进行一次评估获得,避免了昂贵的教师后验采样,同时提供约束以唯一识别完整的多模态条件后验。
方法
作者们提出后验匹配蒸馏(Posterior Matching Distillation,PMD),通过匹配完整条件去噪后验而非仅后验均值,将扩散教师蒸馏为少步学生。在高斯扰动过程下,噪声观测 zt 对应的干净图像条件分布由 q(x∣zt)∝q0(x)exp(−∥zt−αtx∥2/2σt2) 给出。在高噪声级别下,该后验可能较宽或多模态,因此对少步生成建模条件不确定性至关重要。
为了捕获超出后验均值的信息,作者们考虑使用倾斜向量 λ∈Rd 对教师条件分布进行指数倾斜。倾斜分布定义为 qλ(x∣zt)=Eq(x∣zt)[eλ⊤x]eλ⊤xq(x∣zt)。如下图所示:
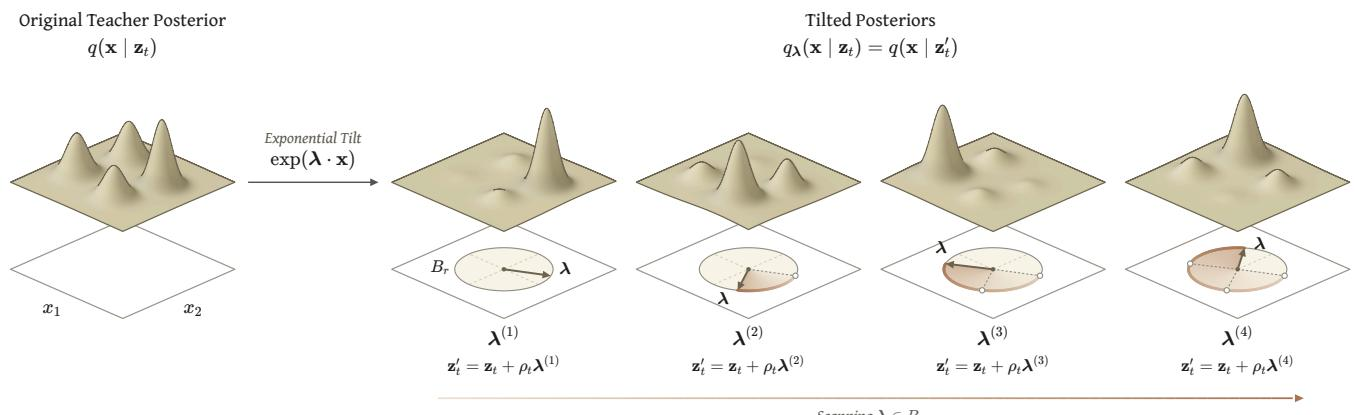
指数重加权因子 eλ⊤x 改变后验各模式的相对突出程度,使与 λ 对齐的样本获得更大权重。不同倾斜强调同一后验的不同模式。计算这些倾斜分布的均值通常需要采样和重加权。然而,作者们建立了 Tilt=Shift 恒等关系,该关系表明:在固定噪声级别下,对后验做指数倾斜完全等价于将噪声输入平移给去噪器:qλ(x∣zt)=q(x∣zt+ρtλ),其中 ρt=σt2/αt。因此,倾斜后验的均值可以直接由冻结教师去噪器获得,即 Eqλ(x∣zt)[x]=Dt(zt+ρtλ)。
作者们证明,在 λ=0 的开邻域内匹配这些倾斜均值足以识别整个条件分布。设 Gθ 表示一个随机学生,其在随机输入 u∼N(0,I) 下预测干净图像 x^=Gθ(zt,u,t)。PMD 要求学生的指数加权均值与教师的倾斜均值匹配:
Eu[eλ⊤x^]Eu[x^eλ⊤x^]=Dt(zt+ρtλ)如果这对邻域内的每个倾斜都成立,则学生恢复教师的完整条件后验 pGθ(⋅∣zt)=q(⋅∣zt)。
为将其转化为可操作目标,作者们将后验匹配残差 r(zt,λ) 定义为学生与教师倾斜均值之差。后验匹配损失在噪声级别、噪声输入和倾斜上最小化期望平方残差:
LPMD(θ)=Et,zt,λ[∥r(zt,λ)∥22]该目标匹配学生条件分布的某种性质,而不是强制单个预测等于教师均值。
训练期间,PMD 在学生自身采样过程中遇到的噪声状态上进行训练。每次迭代中,选择一个训练噪声级别 t,并通过从高斯噪声 zT 进行反向模拟得到 zt,前序步骤从梯度图中分离。给定 zt 后,采样一个倾斜向量 λ,冻结教师在偏移输入 zt+ρtλ 上被评估,以得到教师的倾斜后验均值。学生生成 M 个独立预测 x^(m)=Gθ(zt,u(m),t)。学生的倾斜均值使用加权蒙特卡洛样本估计,其中权重由点积 λ⊤x^(m) 上的 softmax 导出。最终学生目标在 PMD 损失之外加上一个辅助的非饱和 logistic GAN 损失:
Lstudent=LPMD+γGANLGAN其中判别器作用于冻结教师提取的以文本描述为条件的特征。
最后,作者们设计 PMD 以支持任意步采样,而无需为不同步数训练单独的学生。由于 PMD 学习的是每个噪声级别下干净图像的条件后验,而不是噪声级别之间的显式转移,学生可以从当前噪声状态预测干净图像。如果需要更多步,则使用高斯扰动调度将该预测重新加噪到下一个选定级别,并再次评估学生。
实验
实验在 SDXL 和 FLUX.2 4B 文生图模型上评估后验匹配蒸馏,主要采用四个采样步,并与若干少步基线和未蒸馏参考模型进行比较。定性比较显示,PMD 在主体外观、场景构图和背景方面生成更多变化,同时保持提示语义,并且支持在不同推理步数下进行多样采样。结果还表明,PMD 实现了较强的分布质量和提示遵循度,提示内多样性实验在特征空间、感知和 Vendi 指标上一致有利于 PMD。消融实验进一步表明,粗倾斜采样提高多样性,随机学生采样预算在训练期间影响多样性指标。
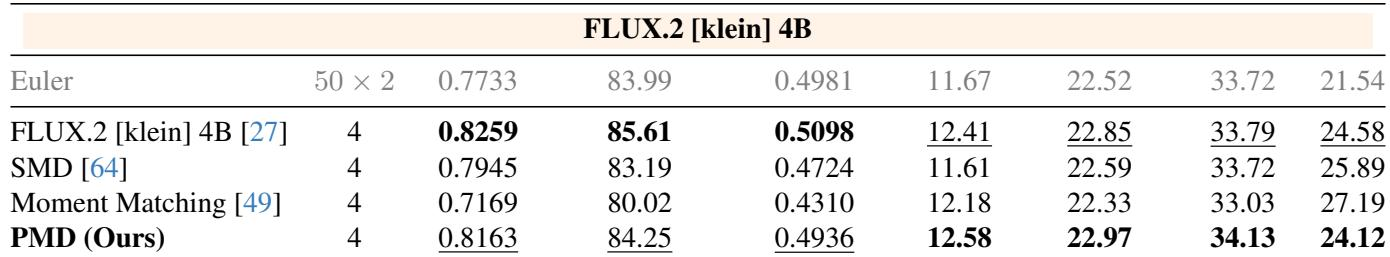
在 FLUX.2 [klein] 4B 上,PMD 在四步方法中取得最佳 FID,并在 HPSv3、PickScore 和 CLIP-S 上领先。FLUX.2 参考模型在 GenEval、DPG-Bench 和 OneIG-EN 上高于 PMD,表明提示对齐指标上存在权衡。矩匹配在大多数报告的质量和保真度指标上落后于其他四步方法。在所示四步 FLUX.2 方法中,PMD 具有最佳 FID 以及最高的 HPSv3、PickScore 和 CLIP-S。FLUX.2 参考模型在 GenEval、DPG-Bench 和 OneIG-EN 上优于 PMD,而 PMD 相对该参考模型改善了 FID。
在比较方法中,PMD 在 PartiPrompts 上取得最强的多样性结果,在 Vendi、LPIPS、DINOv2 和 DreamSim 上得分最高。DINOv2、DreamSim 和 Vendi 多样性的增益最明显,而 LPIPS 改善较温和。报告在 SDXL 和 FLUX.2 上的比较表明,在固定提示和噪声下,提示内多样性具有一致优势。对于 SDXL,PMD 在所有四个指标上记录最高多样性值,超过 LCM-LoRA、SDXL-Turbo、SDXL-Lightning、Flash、PCM 和 DMD2。相对最强基线的提升在 DINOv2 和 DreamSim 上最大,而 LPIPS 增益较小。FLUX.2 上报告了类似的多样性优势,PMD 在所有指标上都优于基线。
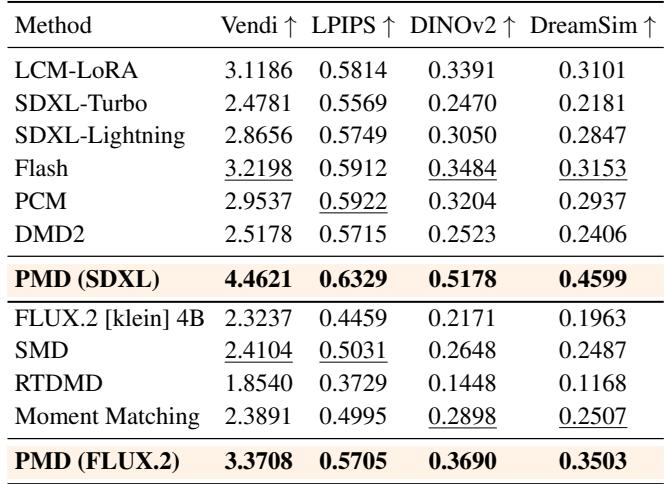
实验使用质量、提示对齐和多样性基准在 FLUX.2 和 SDXL 上评估四步文生图方法。PMD 在四步 FLUX.2 方法中取得最佳 FID 和最高的 HPSv3、PickScore、CLIP-S,而 FLUX.2 参考模型在 GenEval、DPG-Bench 和 OneIG-EN 上得分更高,这表明提示对齐指标上存在权衡;矩匹配总体上落后。在 PartiPrompts 上,PMD 对 SDXL 和 FLUX.2 均在 Vendi、LPIPS、DINOv2 和 DreamSim 上一致产生最高的提示内多样性,DINOv2、DreamSim 和 Vendi 增益最大,LPIPS 改进较温和。