Command Palette
Search for a command to run...
探究“意识”心智:视觉-语言模型中的选择性访问与全局工作空间
探究“意识”心智:视觉-语言模型中的选择性访问与全局工作空间
Jiahao Huang Jun Wang
摘要
视觉-语言模型(VLM)整合视觉与文本信息以执行多种多模态任务,但其输出并不能揭示模型内部的概念表征。在脑科学中,全局工作空间理论(GWT)提出,信息从多个并行的脑过程中被选择出来,在一个共享工作空间中整合,并可供不同的专门化过程使用。本研究围绕这些全局工作空间功能,考察 VLM 中的多模态概念加工。我们提出了多模态概念透镜(MC-Lens),这是一种将视觉编码器透镜与语言解码器透镜相结合的多模态雅可比透镜。两种透镜都将中间状态映射到由解码器输出词表定义的共享语义空间中,使我们能够比较概念在视觉加工和语言加工中的可访问性。MC-Lens 还支持内部概念干预,以考察被访问概念在下游计算中的作用。我们的实验涉及四个相关方面。(i)可访问性与选择性访问。多模态概念信息在中间状态中可被读出,并能根据任务需求被选择性访问。我们将“读出载体”从单一名称 token 扩展为一组 token,以更好地捕捉和表达概念信息,并支持后续的反事实实验。(ii)下游计算中的概念。反事实实验表明,我们所访问的概念信息不仅可被读出,而且参与下游计算与推理。(iii)跨模态对齐与选择性访问的发展。我们提出了两个基于 J 空间的指标来追踪跨模态概念对齐。在受控的 VLM 训练中,这些指标比隐藏状态余弦相似度更清晰地反映了其发展过程。实验还表明,可靠的选择性访问在训练中出现的时间晚于概念可访问性。(iv)跨模型的共享功能。在不同 VLM 家族和规模之间,尽管内部组织存在差异,我们发现了概念可访问性、查询相关选择性以及跨任务干预效应的共享模式。综上,这些发现为在多模态人工系统中研究 GWT 提供了实验基础,并为探索 GWT 如何指导跨模态对齐的改进开辟了途径。
一句话总结
伦敦帝国理工学院和伦敦大学学院的研究者提出了多模态概念透镜(MC-Lens),这是一种多模态 Jacobian 透镜,结合视觉编码器透镜和语言解码器透镜,将中间状态映射到共享语义空间。实验表明,在不同 VLM 系列和规模中,存在选择性概念访问、概念在下游推理中的因果作用以及共享的全局工作空间模式。
核心贡献
- 提出多模态概念透镜(MC-Lens),这是一种多模态 Jacobian 透镜,结合视觉编码器透镜和语言解码器透镜,将中间视觉和语言状态映射到由解码器输出词表定义的共享语义空间。
- 将概念读出从单个名称 token 扩展到一组 tokens,并使用反事实干预表明,所访问的概念信息不仅可读,而且参与下游计算和推理。
- 开发两个基于 J-space 的度量,用于追踪跨模态概念对齐;在受控 VLM 训练中,这些度量比隐状态余弦相似度更清晰地反映跨模态对齐的发展。实验还表明,可靠的选择性访问晚于概念可访问性出现,并且概念可访问性、查询依赖性选择性以及跨任务干预效果的共享模式在不同 VLM 家族和规模中均成立。
引言
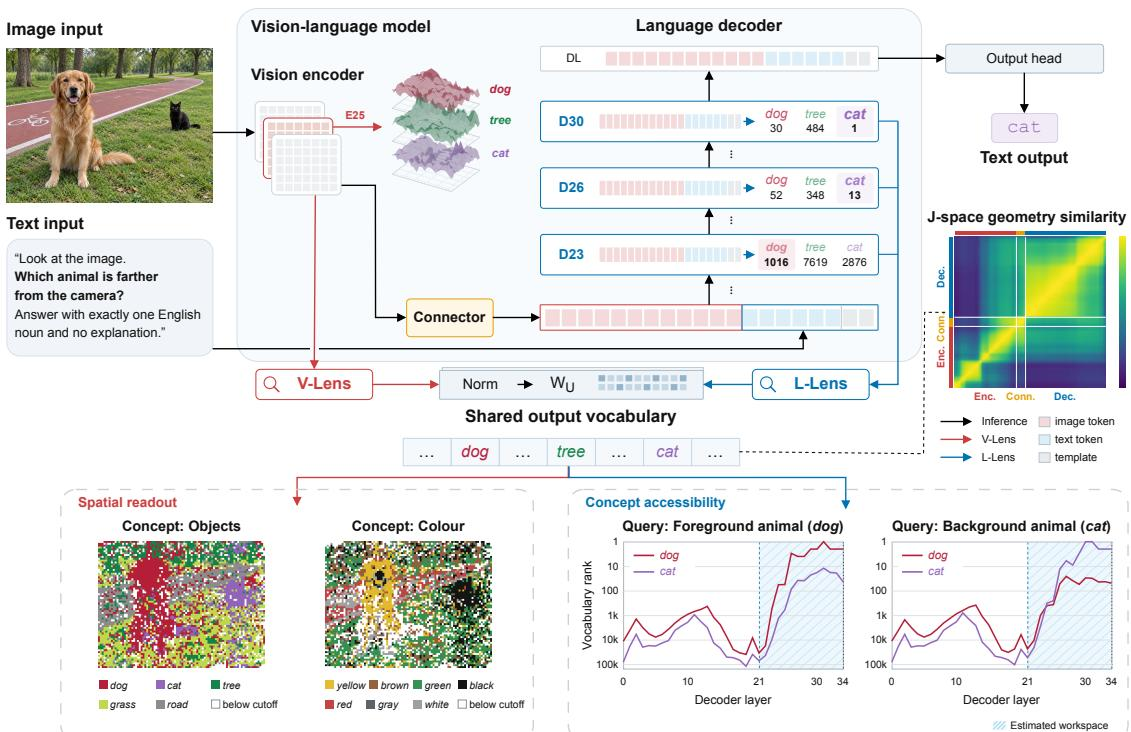
视觉语言模型(VLM)在视觉问答等任务中整合视觉和文本信息,但其输出并不暴露内部概念表示,即使所需视觉信息在中间状态中仍可读,模型也可能出错。现有基于 Jacobian 的方法如 J-Lens 提供中间语言模型状态的词表读出,并已用于研究大语言模型中的全局工作空间行为,但它们只关注纯语言状态,且通常用单个名称 token 表示概念,限制了多模态分析。作者提出多模态概念透镜(MC-Lens),它结合视觉编码器透镜和语言解码器透镜,将中间视觉和语言状态映射到由解码器输出词表定义的共享语义空间。该方法支持概念读出、反事实干预、更丰富的多 token 概念方向集合,以及对 VLM 中选择性访问和跨模态对齐的研究。
方法
作者开发了 MC-Lens,这是一种基于 Jacobian 的方法,旨在从视觉语言模型(VLM)的中间状态中获取概念信息,并研究这些概念在下游计算中的作用。由于 VLM 的最终输出只提供其内部处理的有限视角,MC-Lens 结合 V-Lens 和 L-Lens,衡量中间隐状态对最后一层解码器隐状态的影响。
对于多模态输入 x,令 hℓ,pm(x) 表示第 ℓ 层、位置 p 处的中间状态,其中 m∈{E,D,C} 分别标记视觉编码器、语言解码器和连接器。最终解码器状态 hL,qD(x) 对中间状态的偏导数构成 Jacobian 矩阵 Jℓ,p→qm(x),它给出了中间状态的微小变化如何影响最终输出的一阶 Taylor 近似。
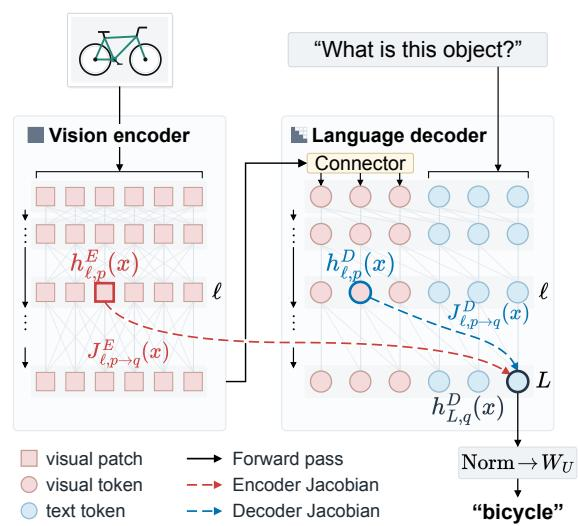
为了分离中间状态在不同上下文中的一般效应,作者对 Jacobian 矩阵进行平均。然而,与纯语言模型不同,VLM 中的图像 token 数量远多于文本 token 数量。统一的平均策略会不成比例地加权图像位置。为解决该问题,MC-Lens 将中间位置分组为不同类别(例如,对 L-Lens 分组为图像、文本和模板 token;对 V-Lens 分组为所有 patch),先在每个类别内平均,再在类别之间平均。这确保每个类别无论 token 数量多少都获得相等的总权重。最后一层位置被限制在解码器的文本位置上,以关注模型的文本输出。
为了确定特定概念出现在模型内部状态中的位置,作者采用基于词表的概念读出。中间状态 h 通过估计透镜 Jℓ 被映射到最后一层解码器状态空间。所得向量经过解码器的最终归一化和解嵌入矩阵 WU 处理,为词表中的每个词生成 logits,并按 token 与状态的接近程度排序。
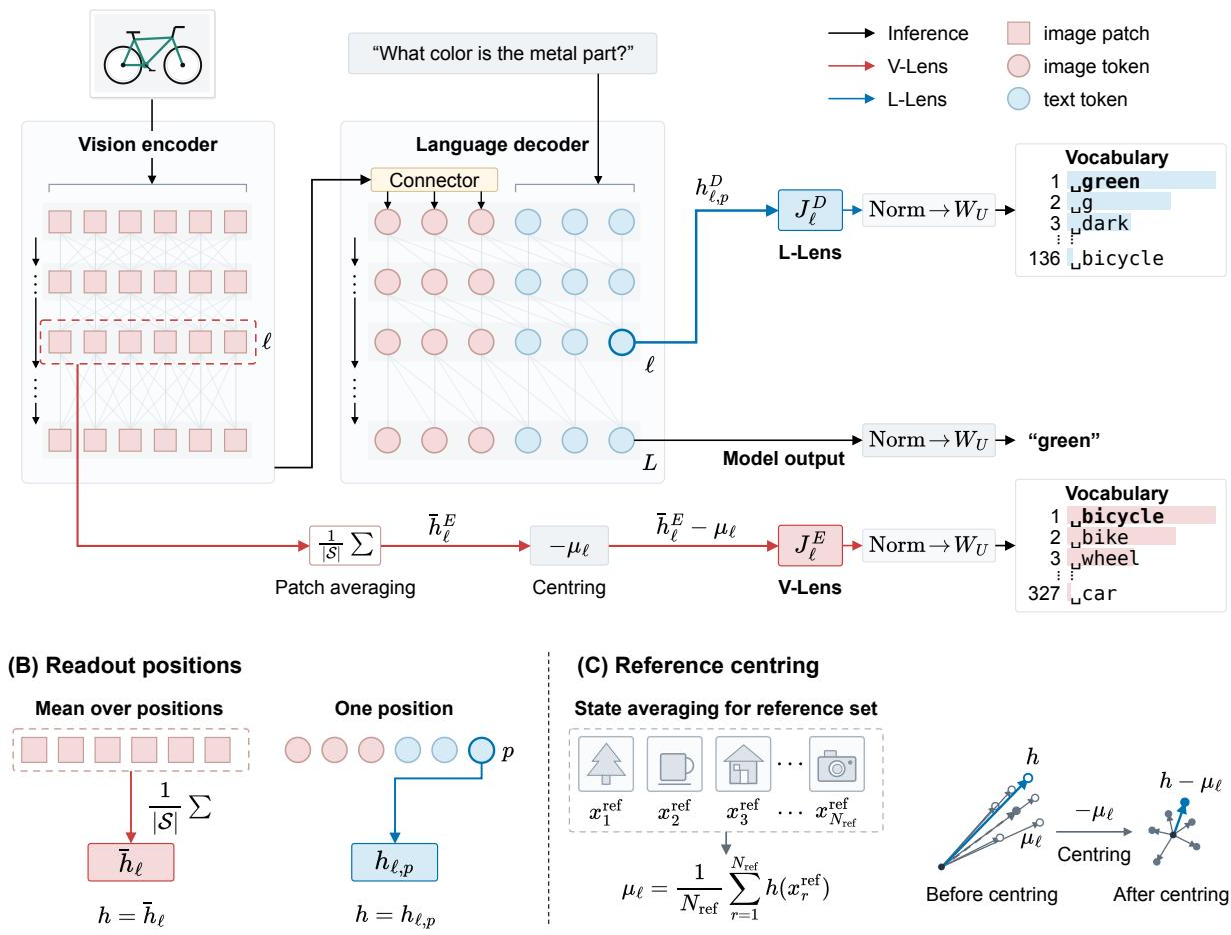
视觉状态通常包含一个在不同图像之间共有的大分量,这可能会将特定目标名称淹没在无信息 token 之下。为解决该问题,作者引入参考中心化。参考状态 μℓ 通过对一组自然参考图像的读出状态取平均来计算。从目标状态 h 中减去 μℓ 会去除该共有分量,使读出能够基于特定图像状态与平均图像之间的差异来排序 token。
由于隐状态通常携带的概念信息超过单个名称 token 所能表达的范围,作者使用一组 tokens 而非单个 token 来描述概念。他们通过两种方法构造概念方向集合:词形选择和贪心选择。
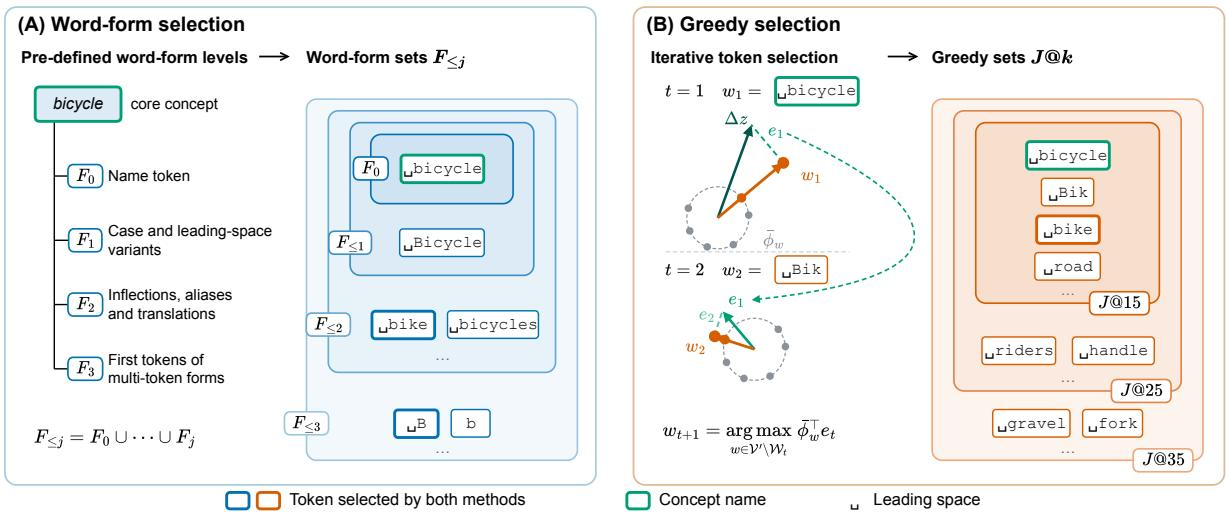
词形选择收集预先定义的用于命名该概念的 token,包括大小写形式、屈折变化、别名、翻译以及多 token 形式的首 token。另一方面,贪心选择通过正交匹配追踪从整个词表中选取词表方向,重建隐状态中概念特定的部分。
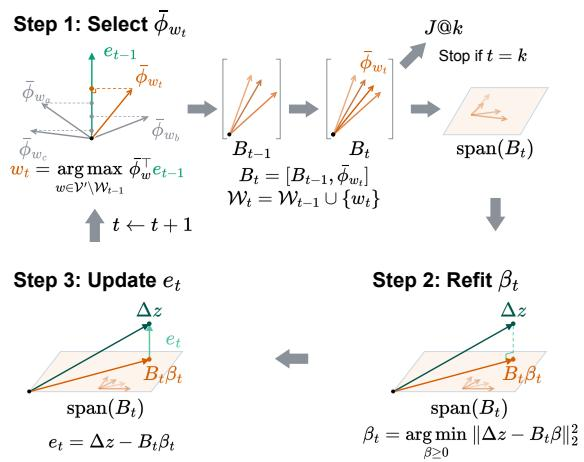
在贪心选择过程中,算法迭代选择词表方向与剩余状态差异内积最大的 token。随后,它使用非负最小二乘法重新拟合所有已选方向的系数,并更新剩余差异。该过程重复进行,直到达到指定的 token 预算,从而不仅捕获直接名称形式,还捕获对表示有贡献的相关概念。
为了研究所访问的概念是在下游推理中被积极使用,还是仅仅存在于状态中,作者进行了反事实干预。他们定义一个源概念和一个目标概念,分别在两者的输入上运行模型以获得各自的隐状态。然后在前向传播过程中的选定层应用干预。
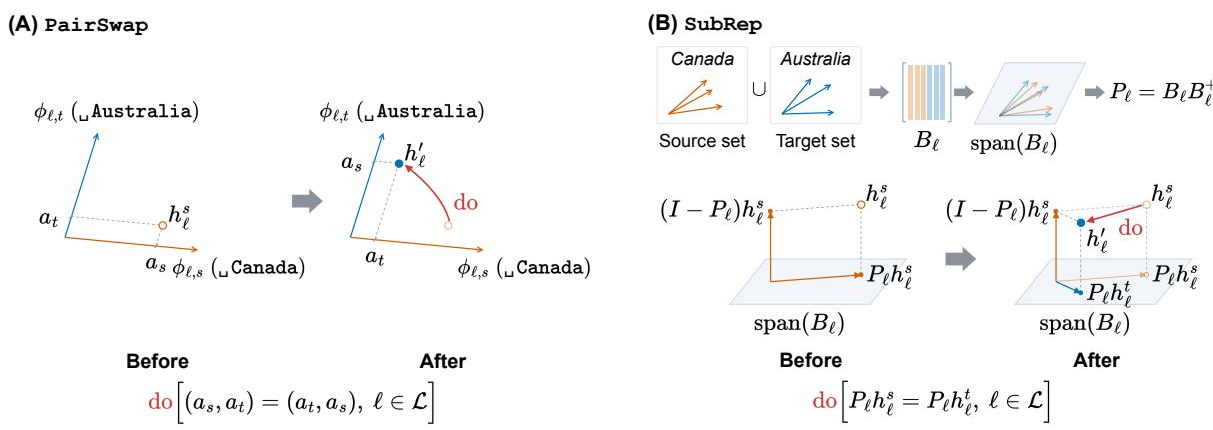
对于单 token 概念,作者使用 PairSwap,它沿各自的词表方向交换源状态和目标状态的坐标。对于概念方向集合,他们提出子空间替换(SubRep)。SubRep 将源状态和目标状态都投影到由两个集合概念方向组合所张成的子空间上。然后,它将源状态在该子空间内的分量替换为目标状态的分量,同时保留源状态的正交分量。通过比较干预前后模型的回答,作者可以验证改变概念表示是否直接影响模型的计算输出。
实验
本文在 VQA、目标识别、空间读出、自回归生成和反事实干预设置中评估了多模态概念透镜 MC-Lens。这些实验验证了图像和文本证据能提高概念可读性,扩展和贪心 token 集合能捕获更广泛的概念相关信息,并且查询依赖性选择性访问主要出现在估计的工作空间内。因果干预表明,所访问的概念方向会影响直接、一跳和多跳推理;同时,跨 Qwen、DeepSeek 和 Gemma 模型以及训练检查点的比较表明,存在共享的工作空间类功能,以及跨模态对齐和选择性访问的逐步发展。
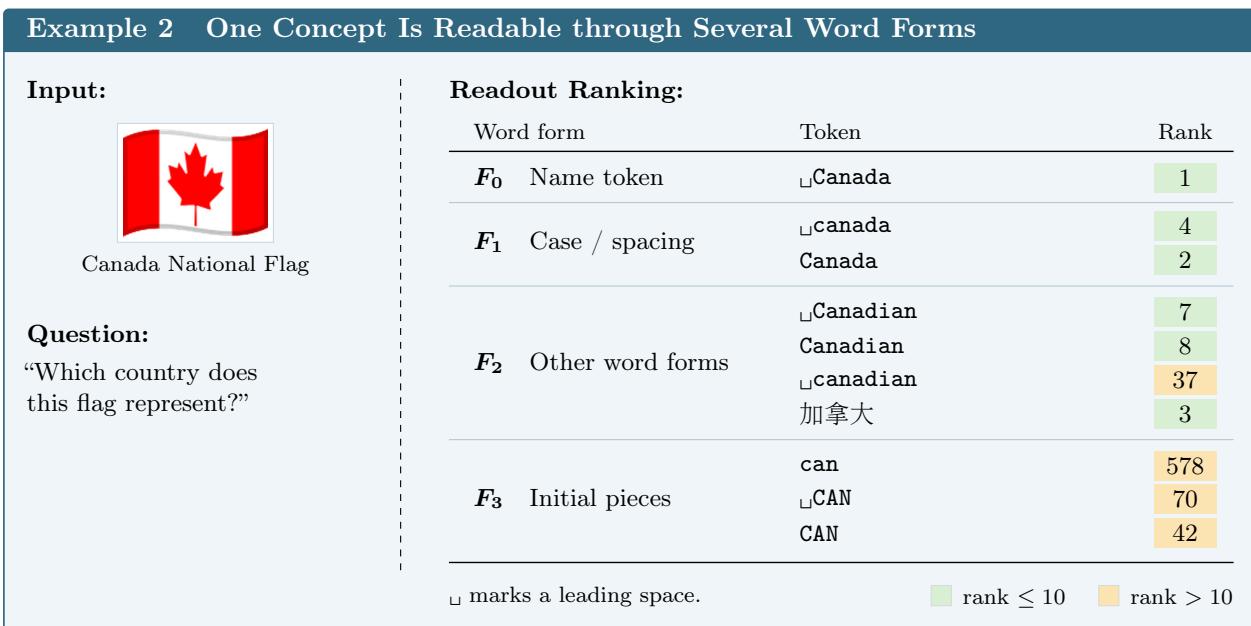
同一概念可以通过多个词形被访问,这些词形的可读性不同。规范名称形式的可读性最高,而大小写或空格变体及相关词形排名较低。规范名称 token 是该概念最易访问的词形。大小写或空格变体及其他相关词形的可读性逐级降低。
基于重构权重的贪心选择可以识别预定义词形集合之外的概念相关 token。在加拿大国旗示例中,集合外 token(如 'maple'、'.C' 和 'bc')在读出的排名远低于词形 token,但仍表现出相对较大的重构权重。重构权重最高的 token 既包括词形 token('Canada'、'Canadian'),也包括该集合之外的 token('maple'、'.C'、'bc')。较低的读出排名并不妨碍集合外 token 具有相对较大的重构权重。集合内 token 具有最高的读出排名,而集合外 token 仍出现在最大的重构权重中。
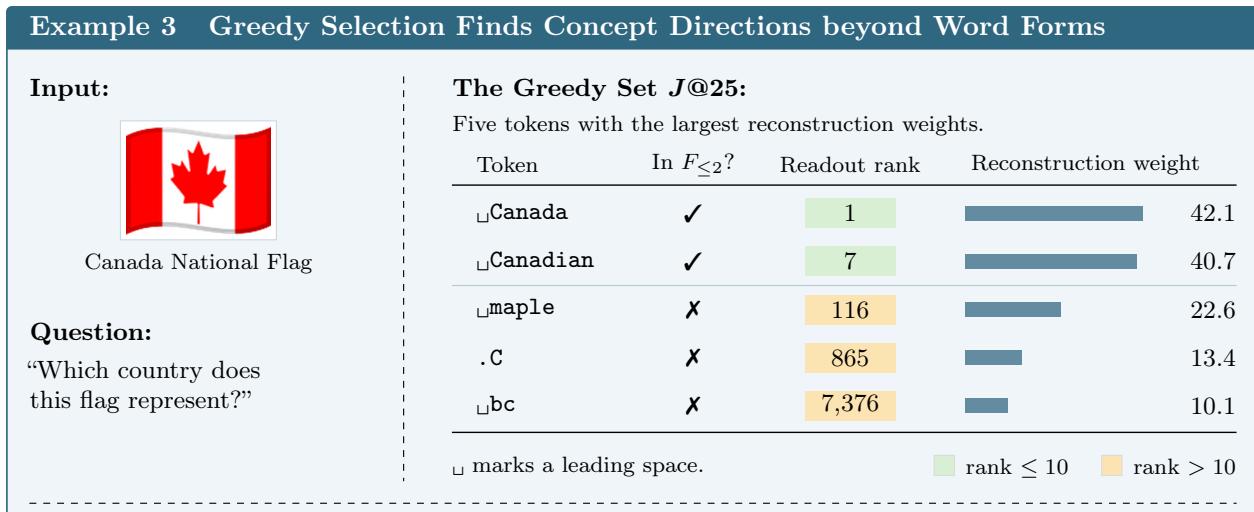
这些实验评估了多个词形如何影响概念访问,以及重构权重如何揭示概念相关 token。规范名称形式的可读性和可访问性最高,而大小写或空格变体及相关词形的可访问性逐级降低。基于重构权重的贪心选择可以识别预定义集合之外的概念相关 token,加拿大国旗示例表明,诸如 “maple”、“.C” 和 “bc” 等集合外 token 虽然读出排名较低,但仍表现出相对较大的重构权重。因此,即使在读出排名未优先考虑它们时,重构权重也能显现概念相关 token。