Command Palette
Search for a command to run...
Mind2Act World:面向机器人操作中具身心智、物理动作与心智-动作组合的诊断基准
Mind2Act World:面向机器人操作中具身心智、物理动作与心智-动作组合的诊断基准
摘要
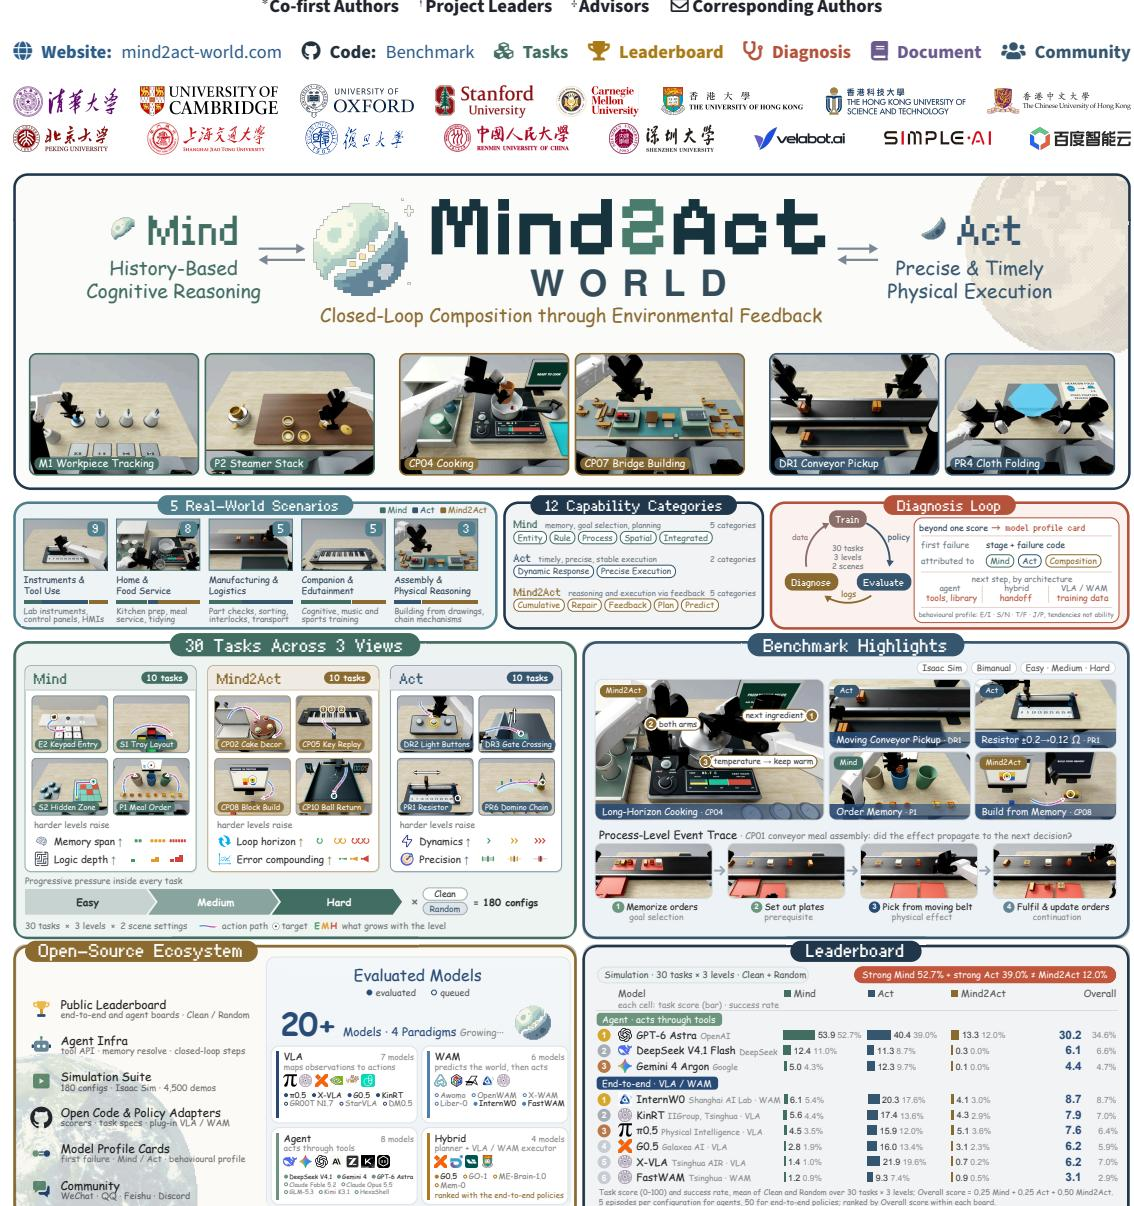
Mind2Act World 是一个用于机器人操作中具身心智、物理动作及其组合的诊断基准。心智任务测试基于历史的推理。动作任务测试精确且及时的物理执行,Mind2Act 任务测试它们的闭环组合,其中动作结果指导后续决策。30 个任务来自 5 个真实世界应用领域,覆盖 12 个能力类别。每个任务在 Clean 和 Random 场景中以 3 个难度级别运行(共 180 种配置),并提供 4,500 条专家演示用于训练端到端策略。智能体和端到端策略共享相同的任务、信息契约和评估器,并在各自的排行榜上排名。诊断循环随后将系统的失败回合归因于心智、动作或其组合,并将其总结为模型画像卡,指明下一步改进方向。顶部:Mind2Act World 的三个视图。中部:应用领域、能力类别、任务和诊断循环。底部:开源生态系统、被评估的模型以及持续更新的排行榜。
一句话总结
清华大学及合作机构的研究者引入 Mind2Act World,这是一个用于机器人操作的诊断基准,在来自 5 个真实应用领域和 12 个能力类别的 30 个任务中,于清洁和随机场景(共 180 个配置)下评估具身心智、物理动作及其闭环组合,配有 4,500 条专家演示,并为 agent 和端到端策略提供相同的任务、信息契约、评估器、独立排行榜和诊断循环,该循环将失败回合归因于心智、动作或二者的组合,并在模型画像卡中汇总。
核心贡献
- Mind2Act World 被引入作为机器人操作的诊断基准,包含 30 个任务,按心智、动作和 Mind2Act 视图组织,覆盖 5 个应用领域、12 个能力类别、3 个难度等级,以及清洁/随机场景,共产生 180 个配置和 4,500 条专家演示。
- 该基准提供共享评估协议和诊断循环,其中 agent 和端到端策略使用相同的任务、信息契约和评估器,失败回合被归因于心智、动作或二者的组合,以生成模型画像卡,用于指导改进。
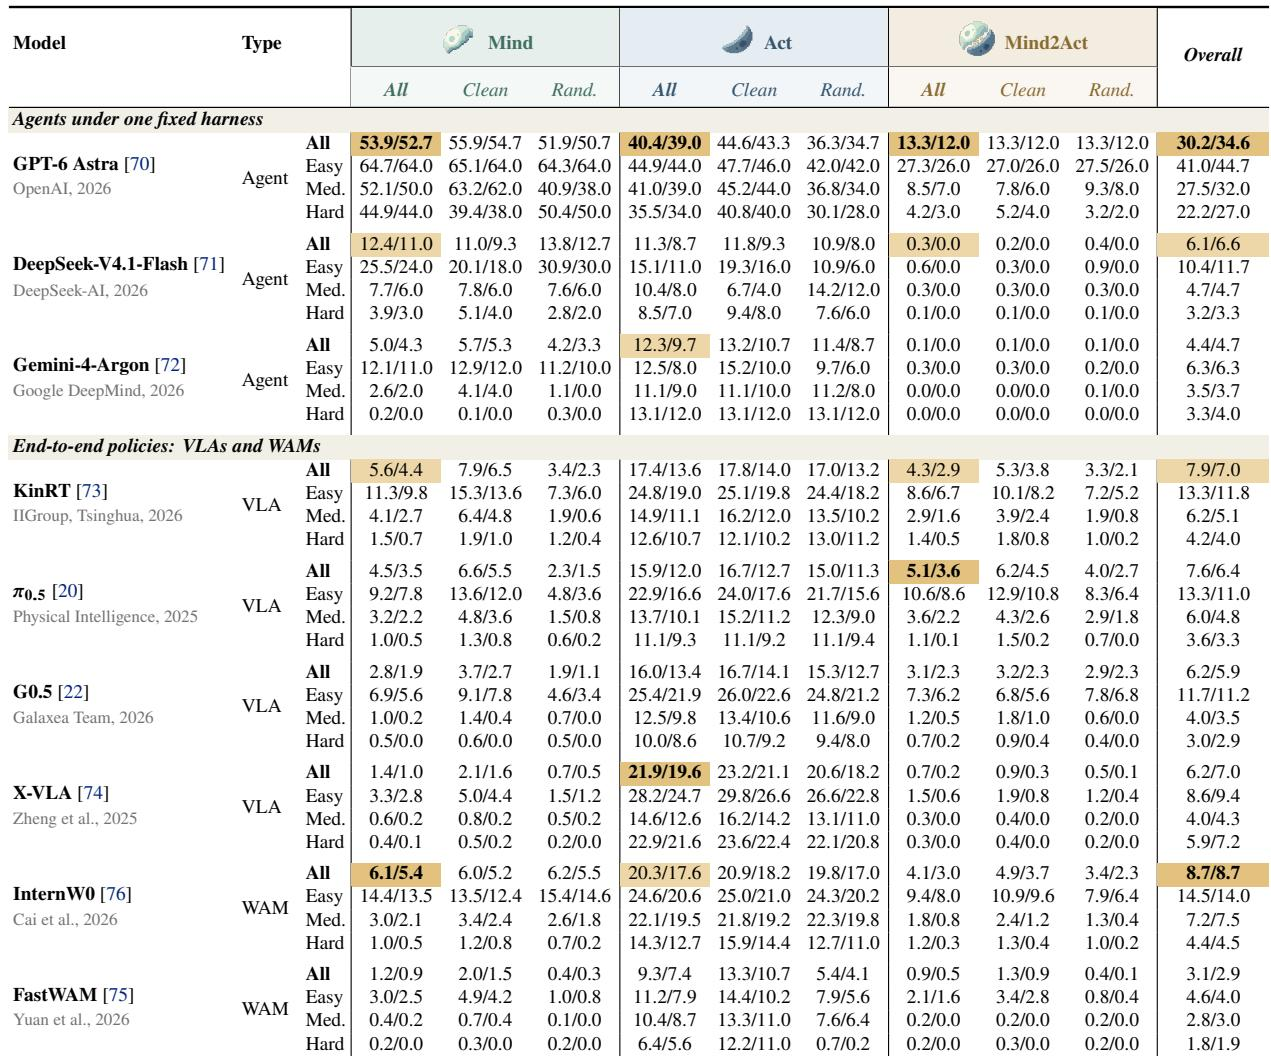
- 对三个 agent、四个视觉-语言-动作模型和两个 WAM 在 56,700 个回合上的大规模评估显示,从单一视图到 Mind2Act 任务的迁移有限:最佳系统从心智任务的 52.7% 和动作任务的 39.0% 降至 Mind2Act 的 12.0%,所有端到端策略均未超过 3.6%,且有 8 个任务没有任何系统完成。
引言
具身智能要求机器人对任务历史进行推理、精确执行物理动作,并通过环境反馈将两种能力组合起来。现有基准通常在相同任务内评估推理和执行,或分别评估二者,而没有测试物理结果是否有效指导后续决策,因此失败难以归因于记忆、执行或闭环组合。作者引入 Mind2Act World,这是一个诊断基准,包含跨越 5 个真实领域的 30 个操作任务,按心智、动作和 Mind2Act 视图组织,每个视图具有难度等级和成对场景设置。作者还提供诊断工具,对失败回合进行归因,并通过模型画像卡汇总系统表现。
数据集
数据集概览
- Mind2Act World 是一个仿真基准,包含 ARX X5 平台上的 30 个双臂操作任务。
- 任务按三个视图组织:
- 心智:依赖历史的推理。
- 动作:受约束的物理执行。
- Mind2Act:推理与执行的组合。
- 每个任务有简单、中等和困难等级。
- 每个等级在清洁和随机场景设置下评估,共产生 180 个配置。
构成与来源
- 任务基于五个应用领域的真实需求构建:
- 家庭与餐饮服务。
- 制造与物流。
- 仪器操作与灵巧工具使用。
- 装配与物理推理。
- 陪伴与寓教娱乐。
- 作者采用桌面化抽象来体现实际需求,例如记住订单、保持仪器读数、拦截传送带物体以及响应电器反馈。
子集详情
- 心智任务:包含 10 个任务,覆盖五个记忆类别,每类两个任务。
- 实体记忆、反馈规则学习、过程记忆、空间记忆和综合记忆。
- 这些任务仅需要常规物理执行,并隔离出长时依赖上的推理。
- 动作任务:评估动态响应、动态稳定性和精确物理执行。
- 示例包括携带散球的托盘、循环门定时、仪器读数、印章方向、织物折叠和多米诺骨牌间距。
- Mind2Act 任务:评估跨依赖操作的组合。
- 机制包括累积进度、状态依赖前置条件和修复、反馈驱动调整、序列和计划执行,以及时间压力下的预测决策。
- 难度等级保持目标不变,同时增加记忆负载、精度、定时、工作流依赖或操作数量。
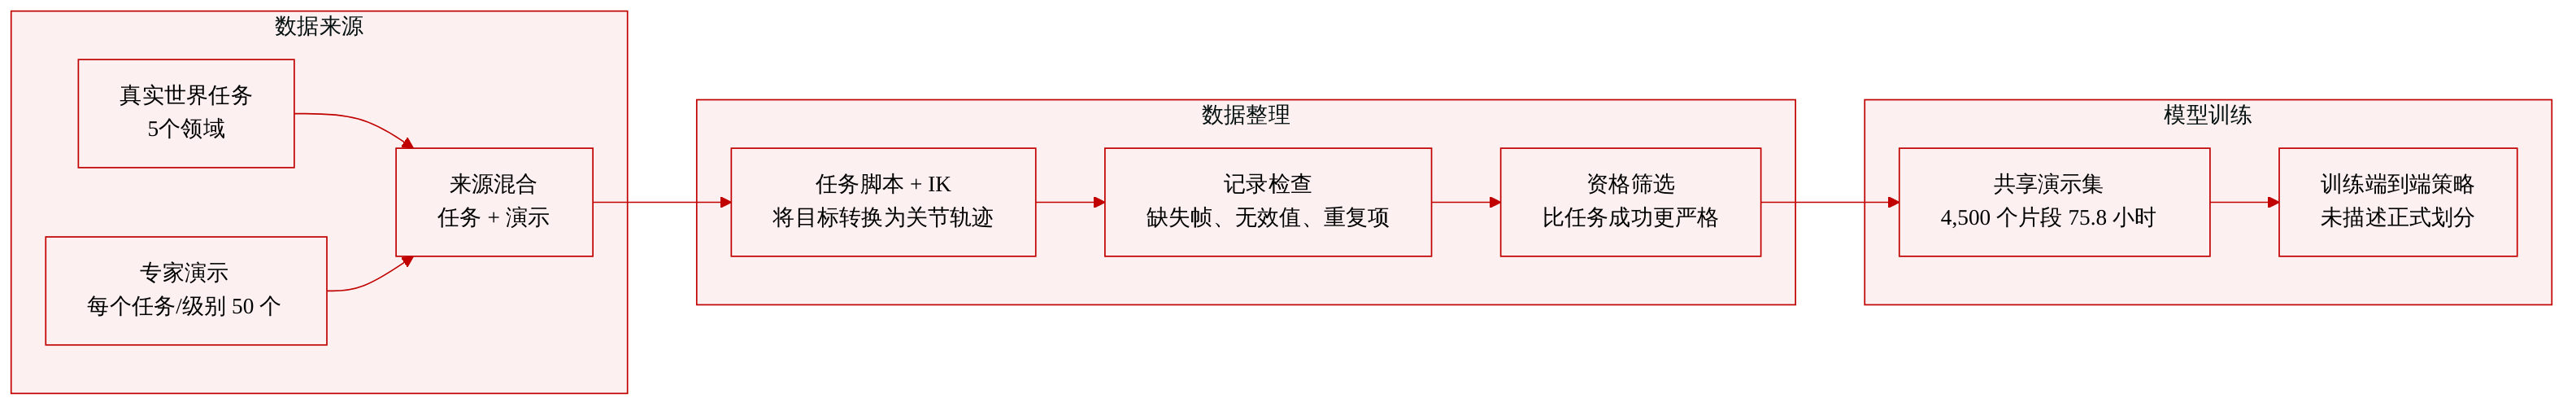
数据收集与过滤
- 作者为每个任务和难度等级提供在同一协议下收集的专家演示。
- 任务脚本定义操作序列和末端执行器目标。
- 逆运动学和运动规划将目标转换为关节轨迹。
- 质量控制根据模拟器状态和事件检查物理完成情况。
- 记录检查涵盖:
- 缺失或损坏的帧。
- 无效的状态或动作值。
- 时间戳对齐。
- 重复项。
- 演示必须满足比任务成功要求更严格的任务特定合格条件。
- 每条保留的演示通过测试时使用的评估器。
- 演示和评估的随机种子不重叠。
数据模式与规模
- 每个回合记录:
- 任务指令。
- 来自一个头部摄像头和两个腕部摄像头的 640 x 480 RGB 图像。
- 关节状态和关节目标。
- 物理以 120 Hz 运行,记录数据以 30 Hz 采样。
- 数据集包含:
- 每个任务每个难度等级 50 个回合。
- 总计 4,500 个回合。
- 每个摄像头 819 万帧。
- 75.8 小时的记录。
- 平均回合时长:
- 动作:23.9 秒。
- 心智:58.5 秒。
- Mind2Act:99.6 秒。
- 困难 Mind2Act:127.6 秒。
在模型中的使用
- 演示用于在共享协议下训练端到端策略。
- 基准支持架构无关的评估,使用共享任务、实例和评分规则。
- 清洁和随机设置使用相同的任务实例,因此比较中将视觉和场景扰动与任务难度隔离。
- 所提供节选未描述正式的训练/验证/测试划分或混合比例。
- 除记录的指令、RGB 图像、关节状态和关节目标之外,本节未描述图像裁剪策略或额外元数据构建。
方法
作者引入 Mind2Act World 基准,用于评估操作任务中的失败是来自错误推理、不精确执行,还是二者的不佳组合。该基准包含双臂 ARX X5 平台上的 30 个仿真任务,按三个视图组织,对系统提出不同要求。
如框架图所示:
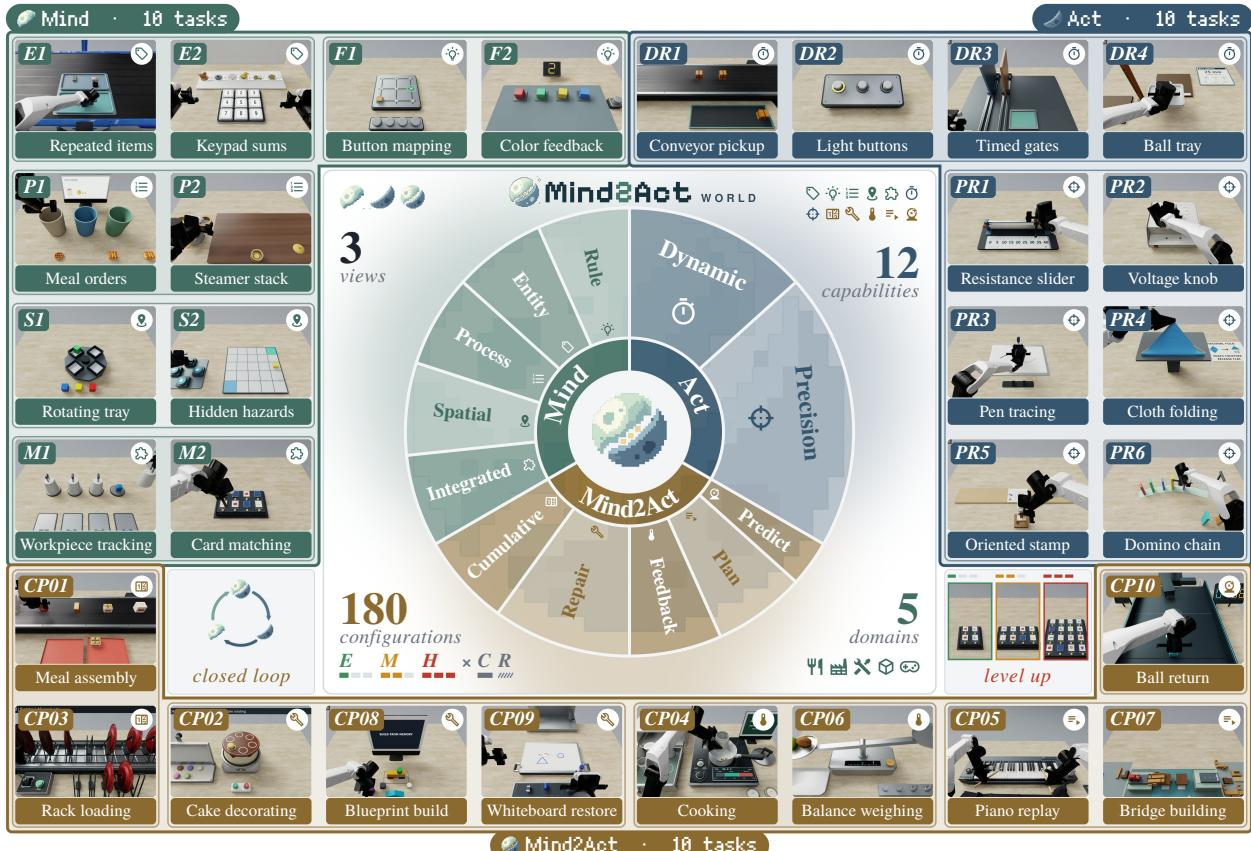
基准围绕三个不同的任务视图构建。心智任务聚焦于依赖历史的推理,要求系统在相关线索消失时保留证据并更新任务状态。动作任务强调受约束的物理执行,评估指定操作是否在空间和时间约束内产生所需的物理效果。Mind2Act 任务测试这两种能力的组合,聚焦于结果条件化的延续,其中保留的信息决定下一操作,物理结果更新任务状态。
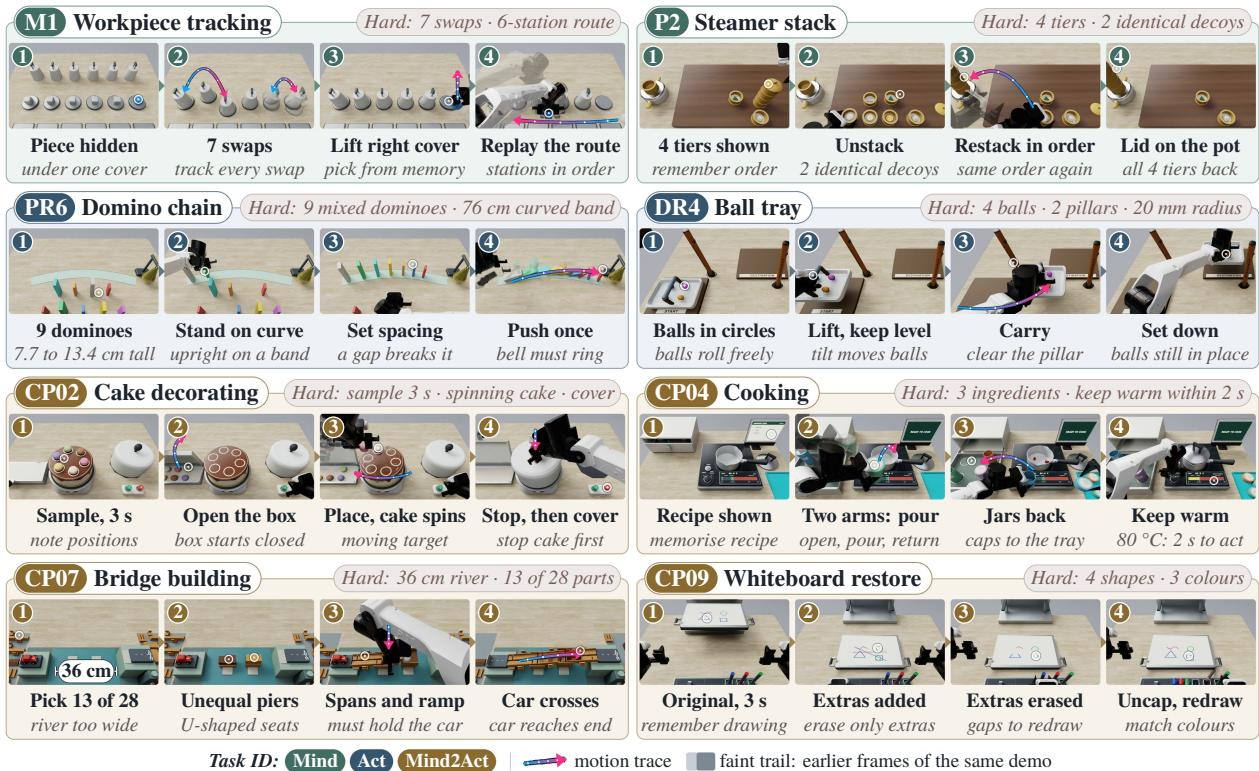
为诊断具体失败模式,作者设计了不同难度等级的任务。每个任务有简单、中等和困难等级,目标保持不变,但记忆负载、推理要求、精度、定时或工作流依赖增加。
不同任务的难度递进如下图所示:
此外,作者分析困难等级任务中的困难步骤,以了解失败通常发生在哪里。这些中间操作经常阻碍后续阶段,凸显了在最终成功之外跟踪阶段进度的重要性。
困难等级任务的中间步骤和具体要求在以下图中展示:
数据收集流程确保高质量演示。每个回合的设置在三个层面定义:任务、难度等级和回合参数。任务脚本定义操作序列和末端执行器目标,使用逆运动学和运动规划将其转换为关节轨迹。质量控制根据模拟器状态和事件检查物理完成情况,演示必须满足任务特定合格条件,为学习提供清晰示例。
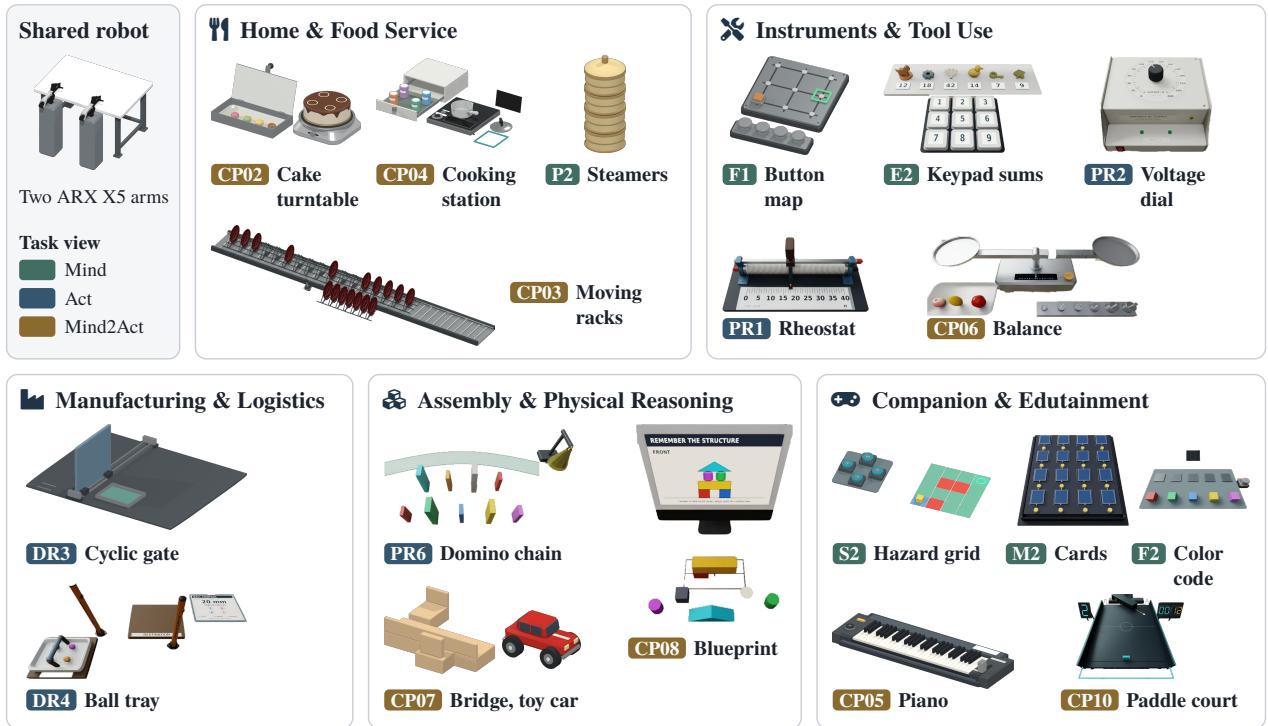
在技术实现上,基准构建于 Isaac Sim。任务场景将共享机器人和工作区资源与任务特定物体和机制结合。
不同应用领域的任务设置在以下图中展示:
评估协议支持两种动作接口,以确保架构无关的比较。端到端策略预测关节或末端执行器动作,并转换为关节目标。agent 作为多模态语言模型,发出结构化工具调用,如 move_eef、wait_steps 和 memory_resolve。仿真以 120 Hz 推进,而手臂和夹爪目标以 30 Hz 更新。仿真在模型推理期间暂停,任务截止时间使用仿真时间测量响应,独立于推理延迟。回合在完成、策略终止或预算耗尽时结束,用部分进度分数和事件记录区分错误决策和失败执行。
实验
Mind2Act World 基准评估九个系统,包括多模态 agent 和微调的端到端策略,在 30 个双臂 ARX X5 仿真任务上进行,任务按心智、动作和 Mind2Act 视图组织,包含三个难度等级和清洁与随机场景。该设置将推理、物理执行及其组合分开,以识别失败是来自记忆、控制还是整合。总体而言,GPT-6 Astra 等 agent 更好地保留任务状态和推理,而端到端策略更擅长熟练执行和定时,但没有系统能在依赖工作流中可靠组合这些能力。失败集中在物理执行,尤其是抓取和持续接触,Mind2Act 任务通常在单一步骤早期失败,而不是在组合处失败,较高难度和外观变化暴露出弱记忆和有限的闭环纠正。
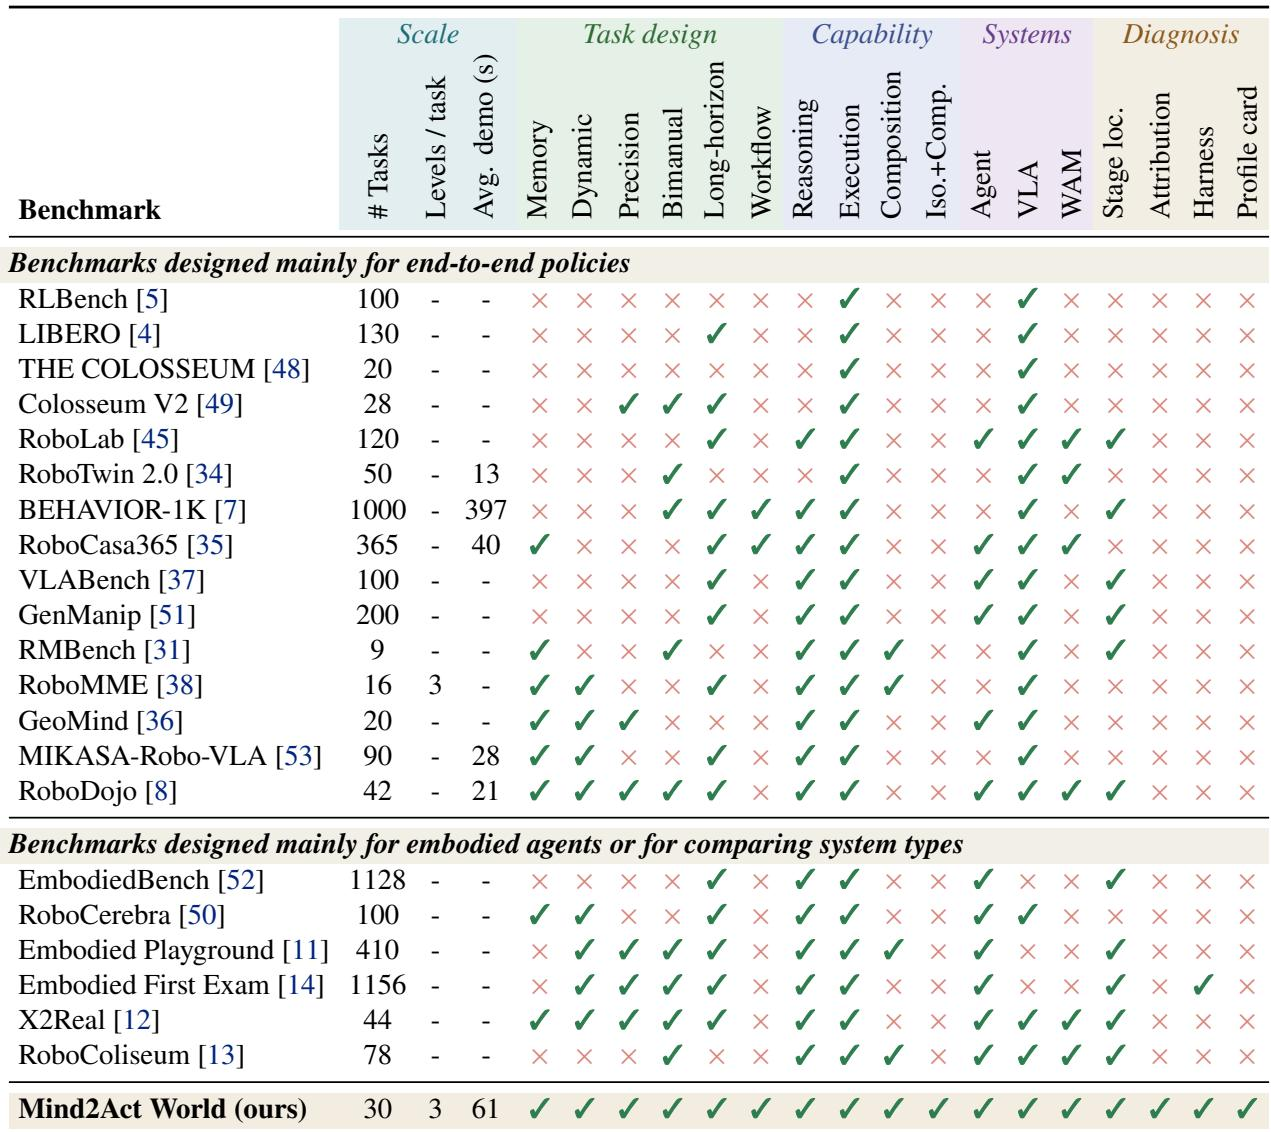
Mind2Act World 是唯一一个同时评估相同任务需求在孤立和组合情况下表现的对比基准,同时将失败归因于推理、执行或其组合,并提供每个模型的画像卡。大多数现有基准将推理和执行纠缠在单一任务中或分别测量,限制了失败归因。其任务演示也相对较长,尤其在 Mind2Act 视图中。对比基准通常缺乏组合测试和失败归因,而 Mind2Act World 同时处理孤立和组合任务需求。Mind2Act World 的训练演示平均长度超过若干近期机器人学习基准,Mind2Act 视图中的演示最长。Mind2Act World 在成功和分数之外增加了诊断功能,通过阶段定位、失败归因、专用工具和画像卡实现,这是大多数对比基准未报告的。
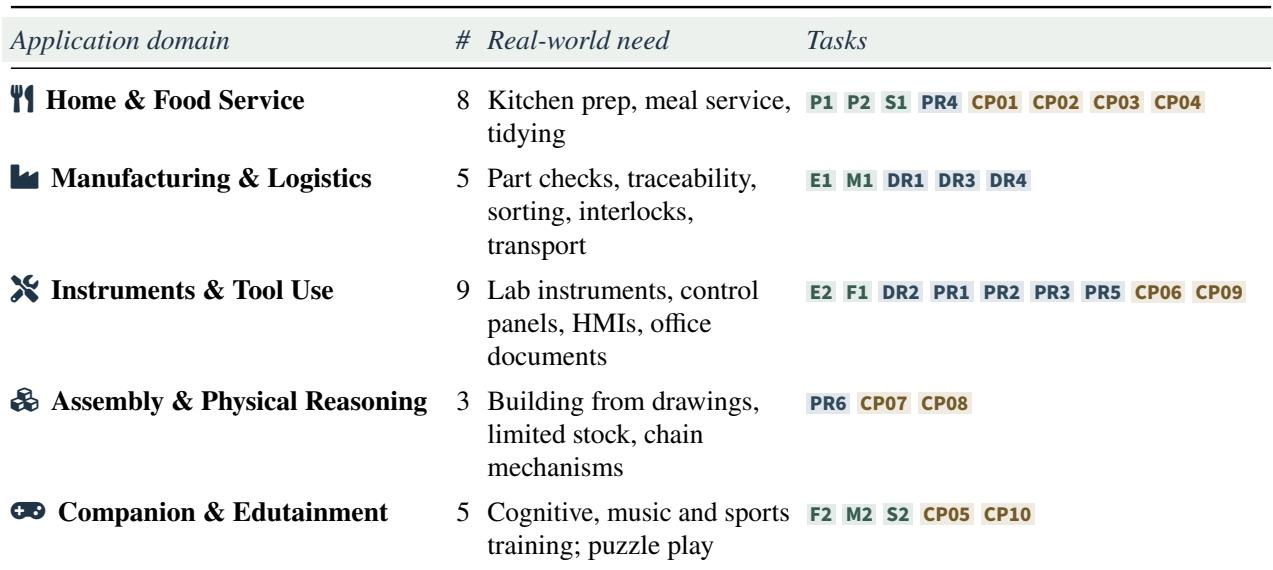
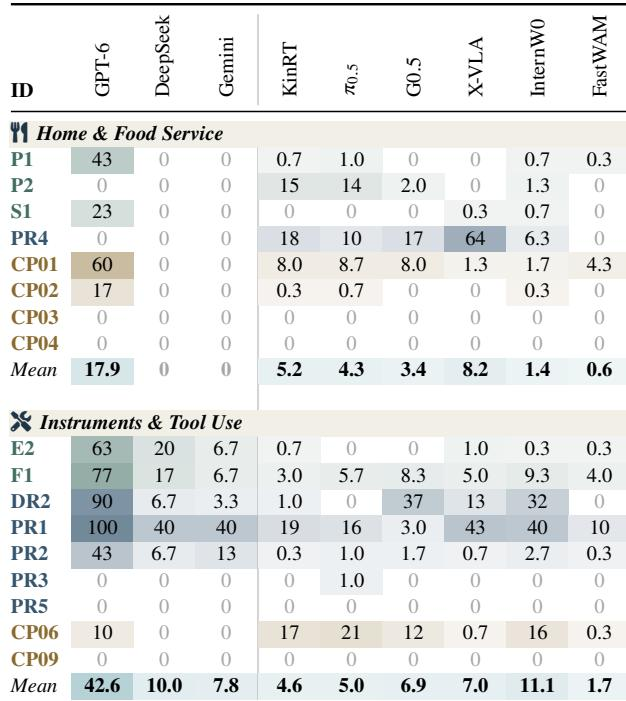
Mind2Act World 涵盖映射到真实需求的五个应用领域,包括家庭与餐饮服务、制造与物流、仪器与工具使用、装配与物理推理,以及陪伴与寓教娱乐。最大的任务组在仪器与工具使用以及家庭与餐饮服务中,装配的任务组最小。领域层面的结果差距很大,没有一个领域接近可靠部署。agent 性能在陪伴与寓教娱乐中相对较好,在制造和仪器任务中表现中等,在家庭与餐饮服务和装配中表现低得多。端到端策略在制造与物流中表现最好,因为这些任务重复练习过的动作,如传送带拾取和通过门。五个领域中有四个包含特别困难的任务对,没有评估系统能完成,包括烹饪与厨房装载、工件跟踪与托盘携带、定向盖章与白板恢复,以及多米诺骨牌链与搭桥。
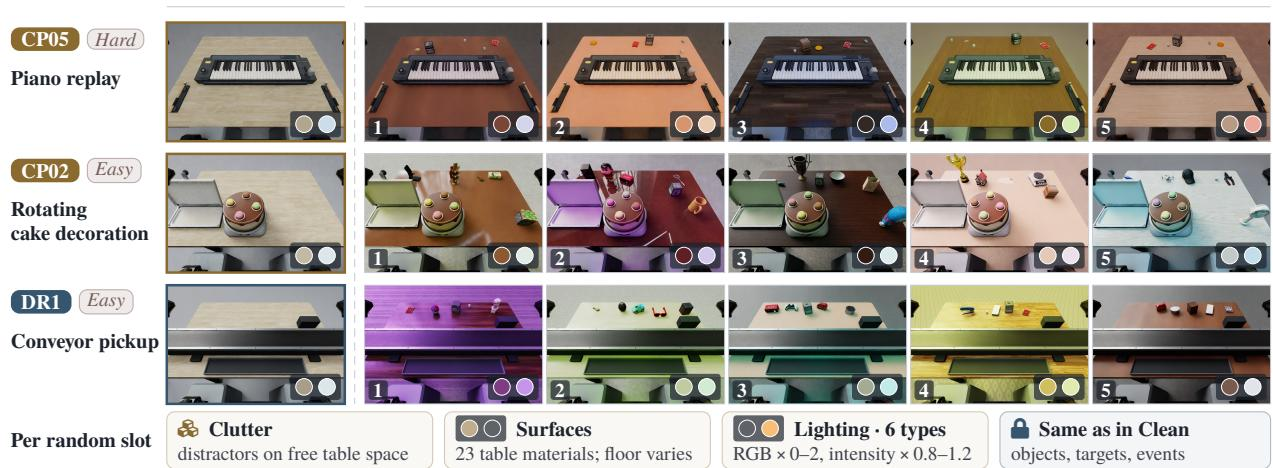
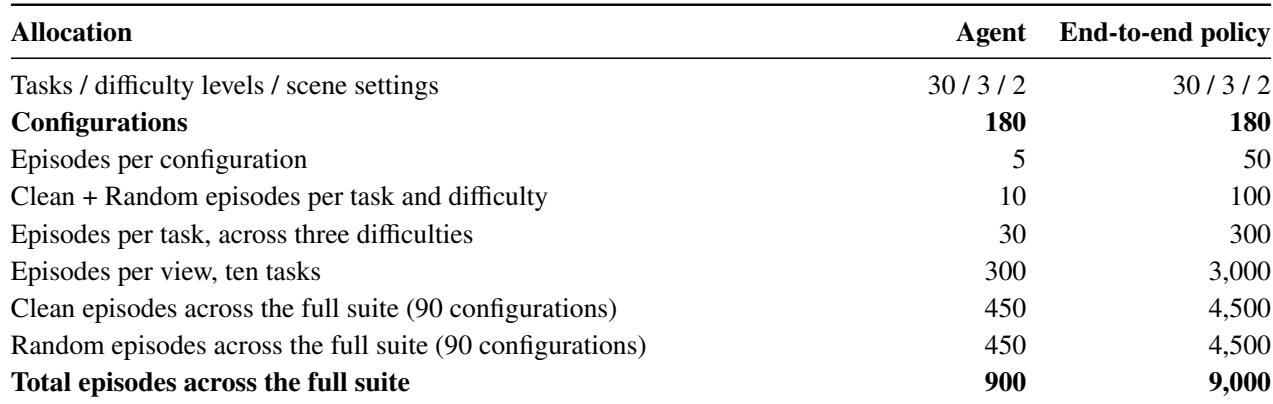
评估设计覆盖每个系统的同样 180 个任务配置,但端到端策略在每个配置上的评分回合数是 agent 的十倍。agent 在清洁和随机场景的共享子集上运行,而端到端策略在所有清洁和随机实例上运行。主要结果在任务和难度等级上对清洁和随机配置等权平均。端到端策略每个配置运行 50 个回合,而 agent 为 5 个,因此每个任务和难度的评估样本大得多。每个任务和难度等级包含清洁和随机场景,随机设置添加桌面杂物、不同桌面材质和不同光照作为外观压力测试。主要结果对清洁和随机配置等权合并,在九个评估系统上产生 56,700 个评分回合。
agent 和端到端策略分别排名,每个类别中的最佳模型仅在少数回合中成功,而其他大多数系统远落后。成功集中在单一能力的心智或动作任务中,组合的 Mind2Act 工作流对所有系统仍然弱得多。由于脚本控制器完成每个任务,差距似乎来自模型限制而非任务或工具。领先的 agent 和端到端策略总体仅在少数回合中成功,大多数其他系统远低于任一领先者。具有模拟器状态的脚本控制器完成每个任务,表明低成功率反映模型限制而非不可能的任务。成功范围狭窄:单一技能的心智和动作任务占成功的绝大多数,若干任务在所有回合中没有系统完成。在心智视图中,最强的 agent 以大幅优势领先,能够处理固定记忆信息,但没有系统能够解决需要在物体移动后更新记忆位置和顺序的任务。在动作视图中,端到端策略表现最好,但仍落后于最强的 agent;精度和持续接触任务仍然困难,若干此类任务未解决。在 Mind2Act 视图中,所有系统表现比动作视图更差,最强的 agent 急剧下降,而端到端策略降至已经很低的心智水平附近。
在合并评估设置中,没有评估系统接近可靠。agent 在寓教娱乐、制造和仪器使用中表现中等,但在家庭与餐饮服务和装配中急剧下降,而端到端策略对领域的排名不同,并且在几乎所有地方保持弱。大多数领域中若干任务从未被任何系统完成。最强的 agent 在寓教娱乐中成功约一半回合,制造和仪器使用中略低,随后在家庭与餐饮服务中降至五分之一以下,在装配中降至个位数。端到端策略在制造与物流中最强,重复动作有帮助,但在其他每个领域保持 12% 以下。五个应用领域中有四个各包含多个任务,没有评估系统完成,包括厨房、跟踪、盖章和装配相关任务。在家庭与餐饮服务中,GPT-6 在任务间结果不均,X-VLA 取得最佳单任务成功率,但二者都未显示广泛可靠性。
Mind2Act World 在五个应用领域的 180 个任务配置上评估 agent 和端到端策略,独特地结合孤立和组合的推理与执行需求,并通过阶段定位和画像卡进行失败归因。评估设计对清洁和随机场景等权,agent 每个配置的评分回合数少于端到端策略。结果显示所有系统仍远未可靠,成功集中在单一能力任务中,而组合工作流和若干领域特定任务仍未解决,脚本控制器完成每个任务,表明是模型限制而非不可能的任务。各领域表现不同,但没有设置接近可靠部署。