Command Palette
Search for a command to run...
WeMM-Video:推动开源全模态视频理解的前沿发展
WeMM-Video:推动开源全模态视频理解的前沿发展
摘要
视频理解,尤其是伴随音频的视频理解,仍然是多模态智能领域的核心挑战。在本报告中,我们介绍了 WeMM-Video,一个涵盖 2B、4B、9B 和 35B-A3B 变体的中英双语全模态基础模型系列。WeMM-Video 以音视频联合感知与推理为核心,在混合思维范式下统一了文本、图像、音频和视频处理,无缝支持用于快速直接响应的非思考指令模式以及用于显式逐步推理的思考模式。这些模型通过渐进式预训练和多阶段后训练流水线,在约 1.2 万亿 token 的大规模多模态语料上进行训练,后训练流程融合了多教师 OPD、抗重复 MrDPO 和专家 RL。在 120 多个基准上的评估表明,WeMM-Video 在全模态视频理解与推理方面展现出卓越性能,同时在通用音频、无声视频、图像和文本任务上保持了极具竞争力的能力。具体而言,在全模态视频评估中,我们的旗舰模型 WeMM-Video-35B-A3B 创下了新的开源最优水平,大幅超越了 Qwen3.5-Omni-Flash 和 Seed2.0-Mini-0428 等专有模型,同时缩小了与强大的 Gemini-3.0-Flash 之间的差距;我们的紧凑型模型 WeMM-Video-9B 则超越了规模更大的开源模型 Qwen3-Omni-30B-A3B-Instruct。我们公开发布 WeMM-Video 系列及其评估和复现流水线,以促进开源社区的进一步研究与发展。
一句话总结
来自微信视觉、腾讯公司和清华大学的研究人员推出了 WeMM-Video,这是一个中英双语全模态基础模型系列,覆盖 2B、4B、9B 和 35B-A3B 版本,通过混合思考范式统一文本、图像、音频和视频处理;在使用约 1.2 万亿 token 训练,并采用多教师 OPD、抗重复 MrDPO 和专家 RL 后,在 120 多个基准上实现了开源最先进的全模态视频理解与推理,同时在通用音频、静音视频、图像和文本任务上保持竞争力。
核心贡献
- WeMM-Video 是一个中英双语全模态模型系列,覆盖 2B、4B、9B 和 35B-A3B 版本,统一处理文本、图像、音频和视频,并支持非思考指令模式和用于显式逐步推理的思考模式。
- 这些模型通过渐进式预训练和多阶段后训练流程,在约 1.2 万亿 token 的多模态语料上进行训练,后训练流程结合了多教师在线策略蒸馏、抗重复多轮直接偏好优化和专家强化学习。
- 在 120 多个基准上评估后,旗舰模型 WeMM-Video-35B-A3B 在全模态视频理解方面树立了新的开源最先进水平,优于 Qwen3.5-Omni-Flash 和 Seed2.0-Mini-0428,同时缩小了与 Gemini-3.0-Flash 的差距;紧凑的 9B 模型超过了更大的开源模型 Qwen3-Omni-30B-A3B-Instruct。模型权重以及评估和复现流程均已公开发布。
引言
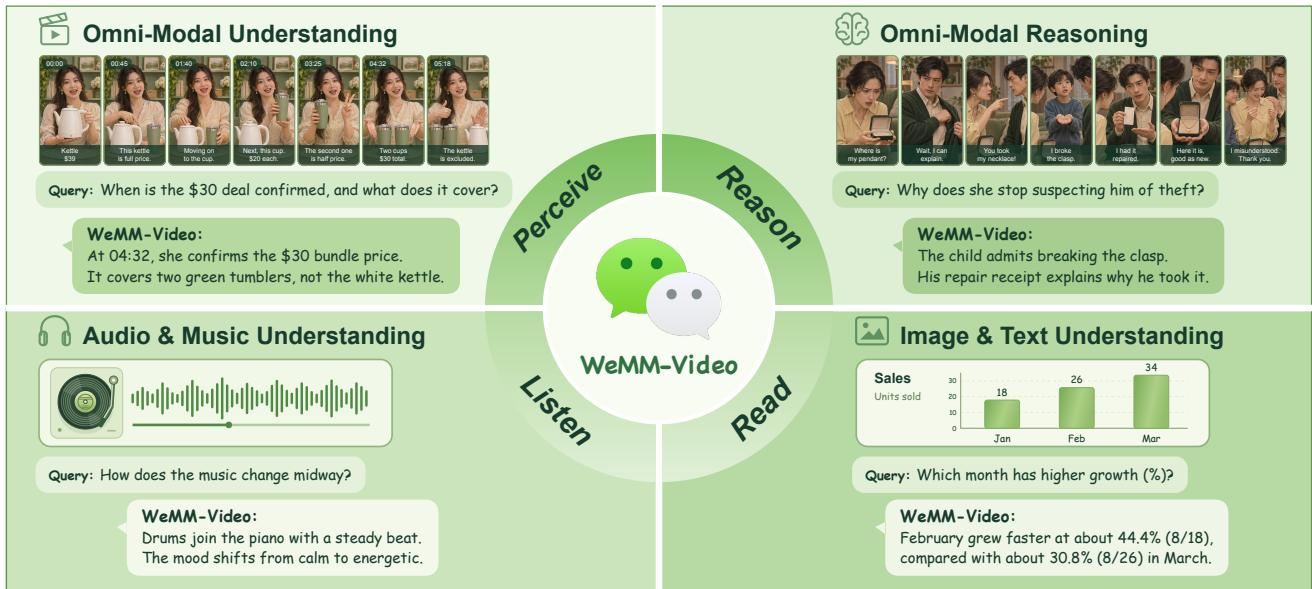
现代视频理解越来越需要联合理解连续的视觉和声学信号,应用领域包括短视频和具身智能。在大语言模型的基础上,视觉语言和音频模型已经取得进展,但现有开源系统在复杂真实场景中仍然脆弱,常常遗漏音视频细节、将声音与视觉事件错误对齐,并产生跨模态幻觉内容。作者介绍了 WeMM-Video,这是一个开源的中英双语全模态基础模型系列,覆盖从 2B 到 35B-A3B 的规模,统一处理文本、图像、音频和视频。它结合了低延迟指令模式和一种推理模式,该模式生成有依据的纯视觉和音视频轨迹以减少幻觉;模型使用约 1.2 万亿 token 进行训练,并经历多阶段后训练;旗舰模型取得了开源最先进结果,可与领先闭源模型竞争。
数据集
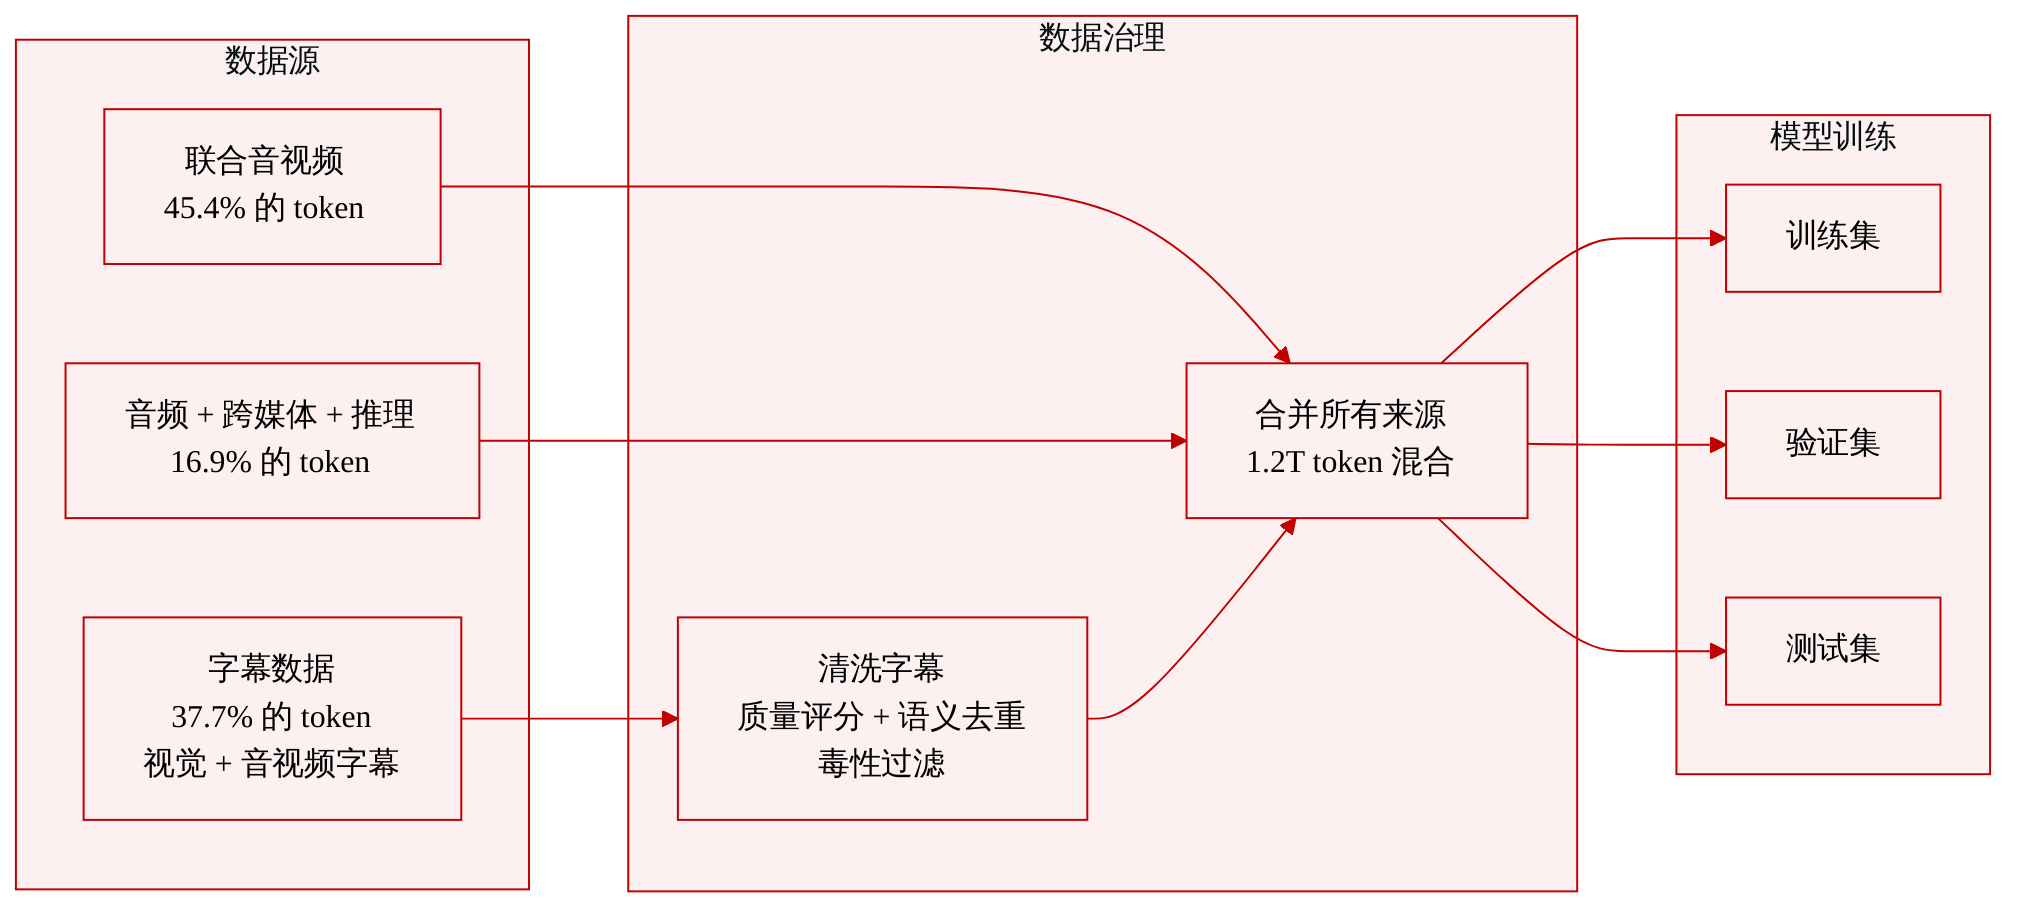
作者为 WeMM-Video 使用了约 1.2T token 的综合训练语料。数据集构成和处理方式如下:
-
联合音视频数据 这是最大的一部分,占整个语料的 45.4%,为多模态动态提供密集的时间监督。
-
描述生成数据 描述生成是最大的任务类别,占 token 的 37.7%。它分为两种互补类型:
- 细粒度视觉描述 来源于竞技体育、电子竞技、游戏、编舞和户外活动中动作和事件密集的视频。这些描述捕捉快速的物理动态和细微的时间状态变化。
- 联合音视频描述 来源于电影、短剧、访谈、综艺节目和直播电商。这些描述沿着连续时间线联合描述视觉动作、口语对话和环境声信号。
- 所有描述候选都会经过自动质量评分、语义去重和毒性过滤。
-
专用音频语料 该子集覆盖大规模自动语音识别、音乐理解和通用音频理解。之所以引入该子集,是因为基础模型本身缺乏声学感知,因此这些数据有助于构建和对齐声学表示空间。
-
跨媒体理解子集 为多源任务构建,例如成对视频比较、视频配乐兼容性分析以及电商产品与广告一致性验证。它面向异构输入、流式信息流和多视频上下文。
-
知识与推理问答集合 通过双重策略创建:
- 大规模视觉语言 STEM 和知识推理数据集,并补充高质量思考轨迹。
- 精选的原生音视频推理任务。 该集合将深度推理能力迁移到全模态场景,同时保留骨干模型的问题解决能力。
作者使用这些子集来训练 WeMM-Video,token 分布反映了任务混合比例。联合音视频数据和描述生成在语料中占主导地位,而音频、跨媒体和推量子集分别解决声学对齐、多源泛化和高级推理问题。除描述过滤流程外,提供的文本未描述显式裁剪、元数据模式构建或其他详细预处理。
方法
作者设计了 WeMM-Video 架构,用于处理由文本、图像、音频和视频组成的多模态输入,并最终自回归生成文本输出。该框架构建在多个 Qwen 骨干模型上,参数规模从 2B 到 35B 不等,音频编码器初始化自 Qwen2.5-Omni。
如下图所示:
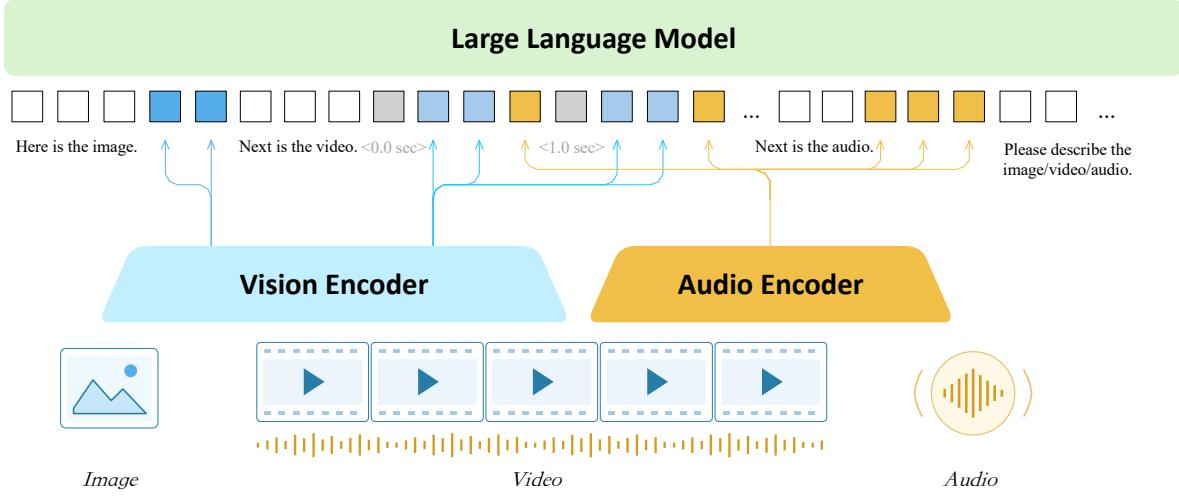
在视觉处理方面,作者保留各骨干网络原生的视觉编码器和投影机制,以保持预训练的图像和视频理解能力。为了处理连续声学信号,模型加入了专门的音频模块,该模块由基于 Whisper 的音频编码器和窗口级 Q-Former 组成。Whisper 编码器从以 16,000 Hz 采样并切分为 30 秒块的音频输入中提取声学特征。窗口级 Q-Former 随后在 0.1 秒的局部时间窗口内压缩这些特征,将每个窗口映射为大语言模型输入空间中的单个音频 token。这样得到每秒 10 个音频 token。对于带音频的视频输入,视觉 token 和音频 token 按时间顺序交错排列,并补充显式文本时间戳,以促进细粒度跨模态时间对齐。
训练方法遵循统一流程,包括渐进式多模态预训练和多阶段后训练。预训练阶段采用三阶段课程,旨在系统性地扩展上下文窗口,同时丰富跨模态表示。
在第一阶段,即声学模态对齐阶段,作者专注于在紧凑上下文窗口下建立声学表示空间与预训练骨干网络之间的连接。仅优化音频对齐器,骨干网络和模态编码器保持冻结。在基础音频-文本对上训练,使模型具备核心听觉感知能力。
在第二阶段,即全模态知识注入阶段,扩展上下文窗口以进行大规模知识注入。除视觉编码器外,所有模型参数均解冻。通过在文本、视觉、听觉和联合音视频数据的多样混合上训练,该阶段建立了统一的跨模态表示空间。
最后一个预训练阶段专注于长上下文能力扩展。在保持相同可训练参数配置的情况下,作者进一步增大上下文窗口,以适应长视频和长时间音频记录等超长多模态序列,增强捕获长程时间依赖的能力。
预训练之后,作者实施了渐进式三阶段后训练流程,以应对通用能力、生成稳定性和专门任务方面的挑战。
首先,采用 Multi-Teacher OPD 增强通用语言和视觉语言能力。更强的外部教师为文本和视觉语言任务提供监督,来自同一模型家族的教师保留已有的音频能力。进一步利用跨模态蒸馏将知识从文本任务迁移到音频任务。
其次,为抑制重复解码趋势,作者采用 Anti-Repetition MrDPO。该方法使用离线挖掘的表现出重复解码的困难负样本迭代优化模型。为在多个优化轮次中保持稳定,每轮只更新 LoRA 适配器,并在随后将其合并和重新初始化。
最后,Specialist RL 阶段使用强化学习增强具有挑战性的下游能力。作者收集多样的训练实例,并过滤掉可被可靠解决的样本。根据任务是否可验证,将适用于确定性任务的基于规则的奖励与适用于开放式任务的基于评分标准和教师一致性的奖励相结合。动态奖励路由器分配任务特定奖励,并通过随机采样联合优化指令模式和思考模式。该阶段进一步扩展到长上下文训练,以在扩展多模态输入上保持生成稳定性。
实验
评测覆盖 2B、4B、9B 和 35B-A3B 规模的 WeMM-Video 系列,在视频、音频、图像和文本基准上与领先闭源和开源基线进行对比。全模态视频结果表明,WeMM-Video-35B-A3B 树立了新的开源最先进水平,思考模式带来了明显的推理提升,同时较小版本仍具有竞争力。静音视频评测确认其在添加音频后没有性能下降,并保持较强视觉理解能力,音频、图像和文本评测则验证了全面的音频能力以及保留下来的语言和视觉推理能力。
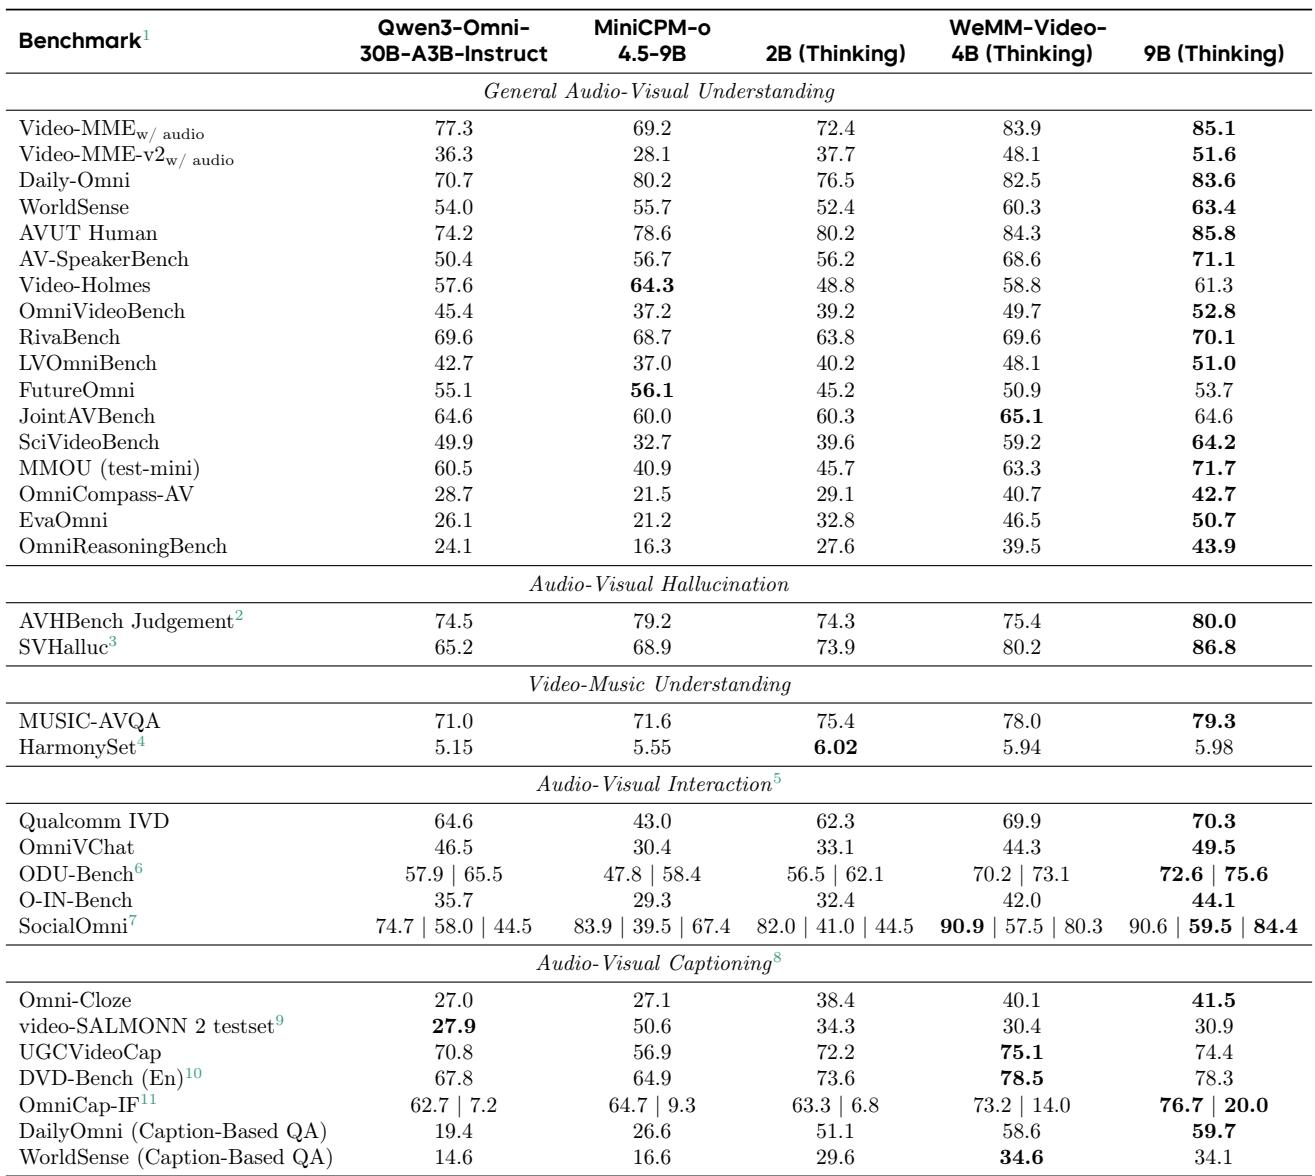
WeMM-Video-35B-A3B 是一个开源全模态视频模型,在大多数通用音视频理解基准上优于 Seed2.0-Mini-0428 和 Qwen3.5-Omni-Flash,同时接近 Gemini-3.0-Flash。其思考模式在所有列出基准上始终优于指令配置。较小的 WeMM-Video 版本相比更大的开源基线仍具竞争力。在 17 个通用音视频理解基准中的 16 个上,思考模式超过 Seed2.0-Mini-0428 和 Qwen3.5-Omni-Flash。在带音频的 Video-MME 上,WeMM-Video-35B-A3B(Thinking)得分为 86.4,以小幅差距落后于 Gemini-3.0-Flash,并领先其他对比闭源模型。在所有列出的通用音视频基准上,思考配置均比指令配置有所提升。
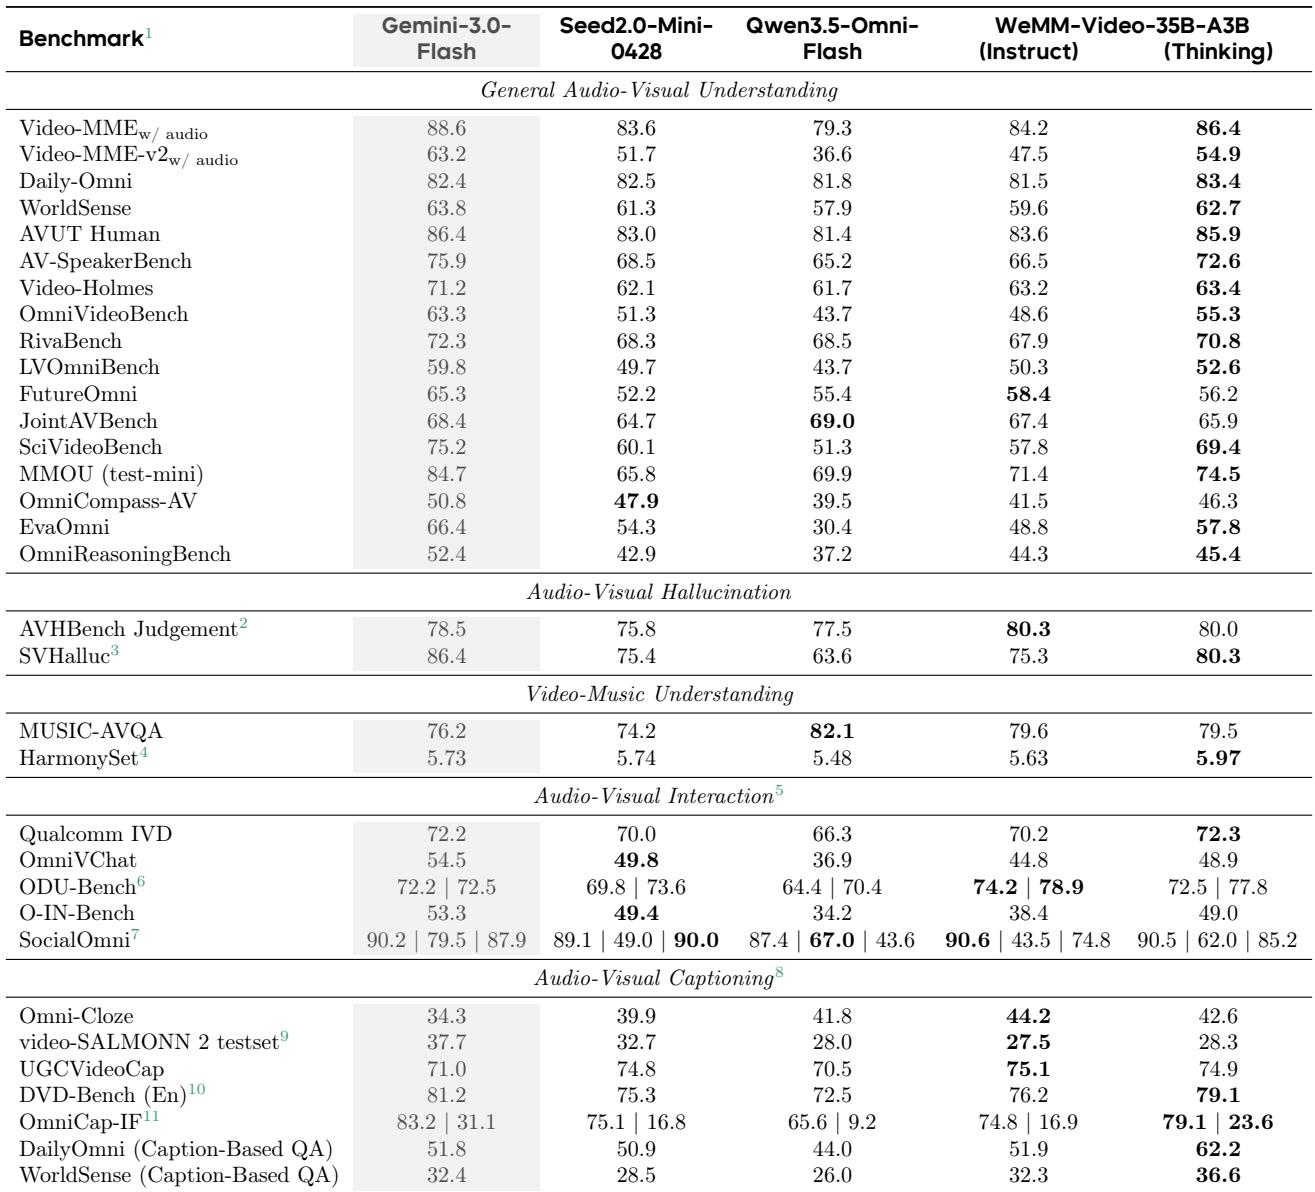
WeMM-Video 系列在通用音视频视频基准上相比开源全模态基线有显著提升。9B 和 4B 思考版本在所有列出任务上持续领先,而紧凑的 2B 版本仍具竞争力,在部分基准上甚至超过大得多的 Qwen 基线。WeMM-Video-9B 在所有列出的通用音视频理解基准上均取得最佳结果,WeMM-Video-4B 是第二强模型。4B 版本在 Video-MME-v2 和 AV-SpeakerBench 上相对两个开源基线的提升尤其显著。2B 版本在 Video-MME-v2 和 AVUT Human 上优于大得多的 Qwen3-Omni-30B-A3B-Instruct 基线,并在其他基准上保持竞争力。
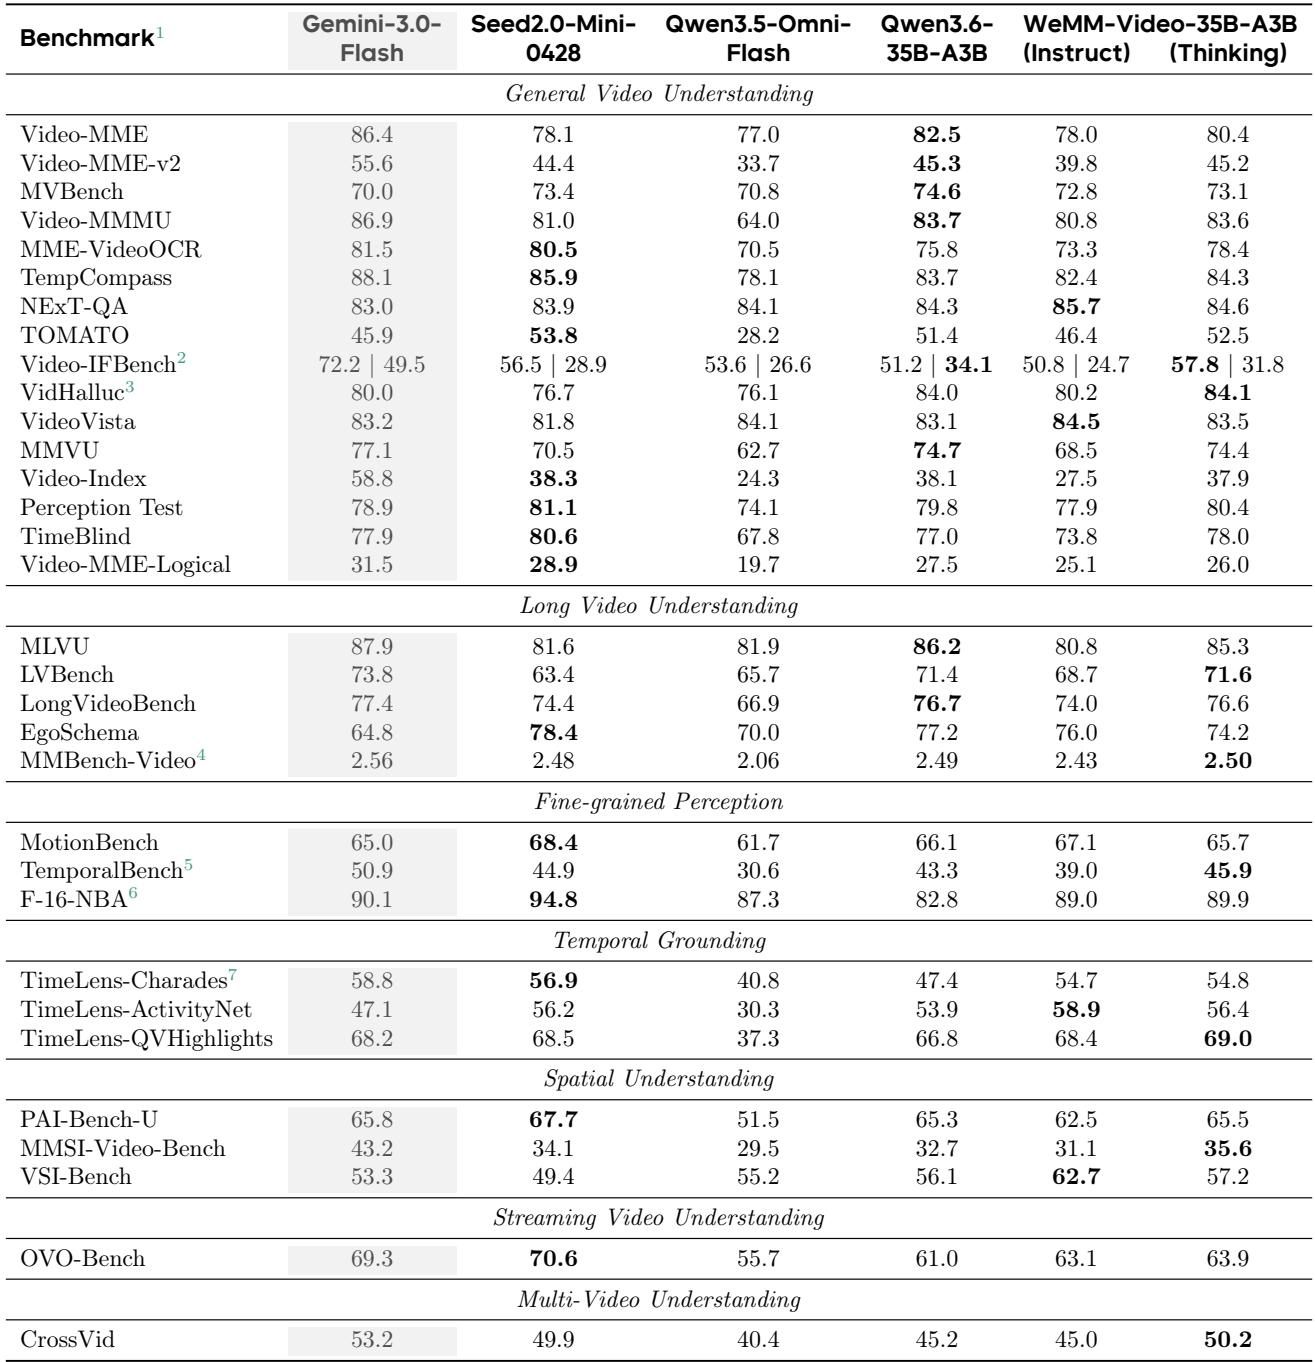
在报告的六个静音视频基准上,WeMM-Video-35B-A3B 在 Instruct 和 Thinking 两种配置下均一致优于 Qwen3.5-Omni-Flash。Thinking 配置与 Qwen3.6-35B-A3B 视觉语言主干网络以及闭源模型 Seed2.0-Mini-0428 具有竞争力,尤其是在 Video-MME、Video-MME-v2、Video-MMMU 和 TempCompass 上。两种 WeMM-Video-35B-A3B 配置在每个报告基准上的得分都高于 Qwen3.5-Omni-Flash,其中 Video-MMMU 和 Video-MME-v2 的差距尤其大。Thinking 配置在大多数基准上几乎匹敌 Qwen3.6-35B-A3B 主干网络,并在 MME-VideoOCR 和 TempCompass 上超过它。
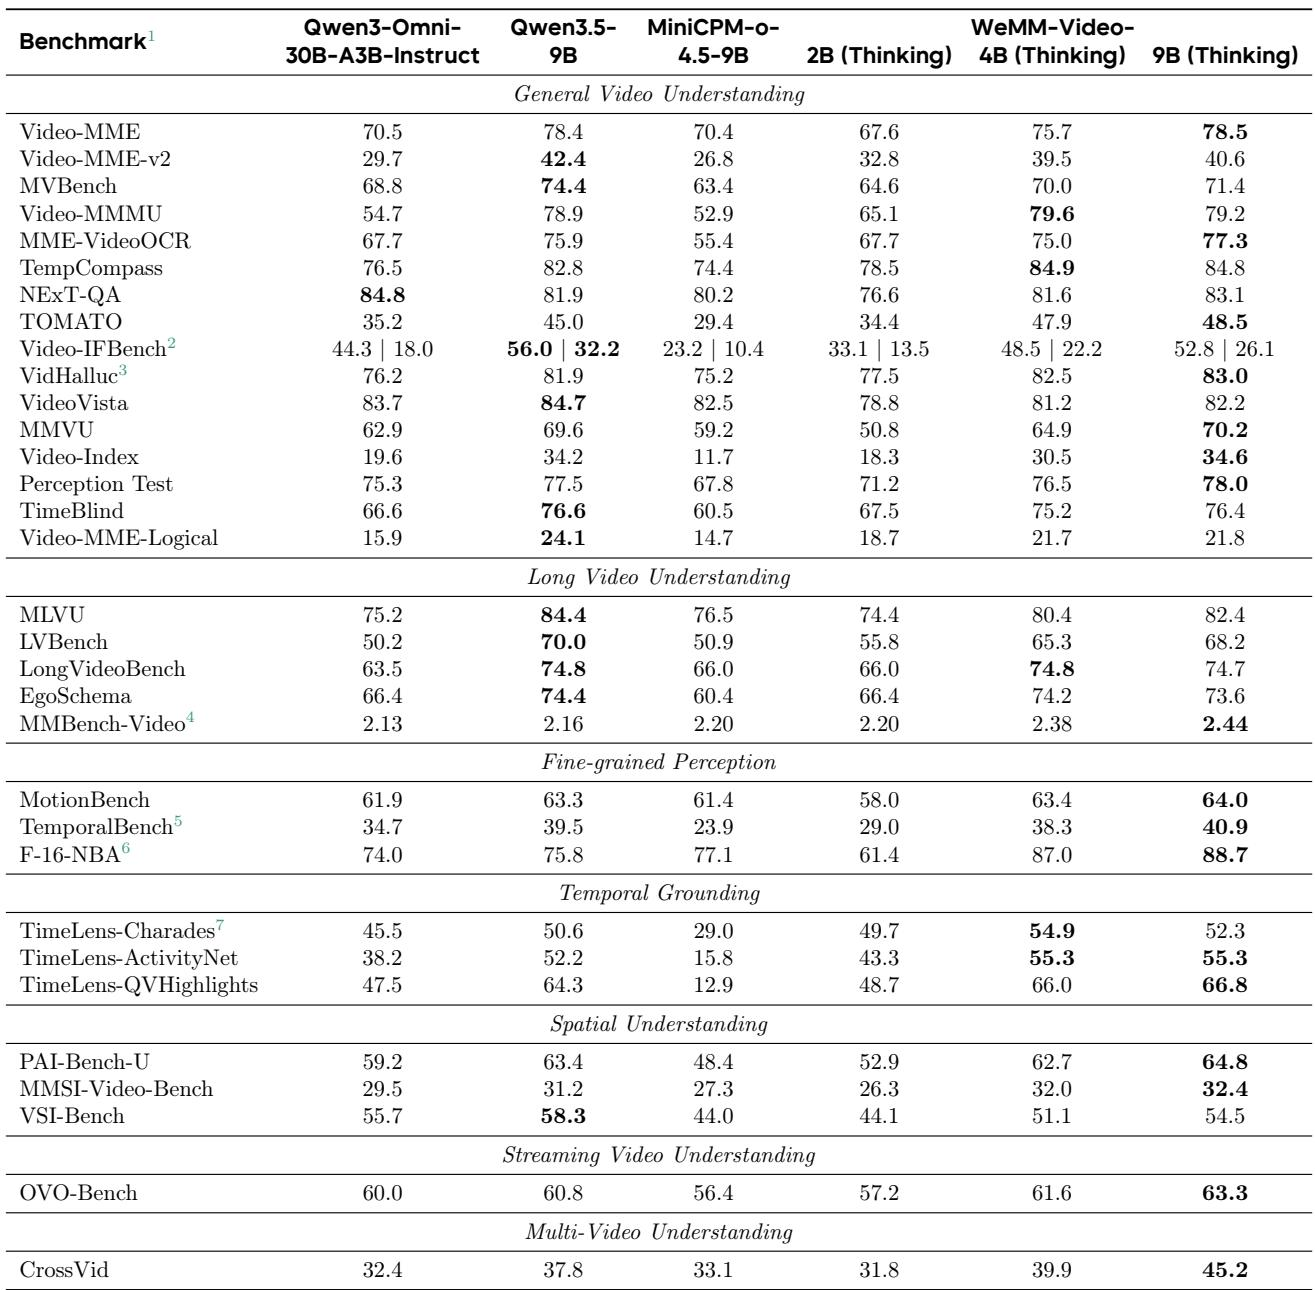
在报告的静音视频基准上,WeMM-Video-9B 和 WeMM-Video-4B 一致优于开源全模态基线 Qwen3-Omni-30B-A3B-Instruct 和 MiniCPM-o-4.5-9B。9B 模型在大多数任务上也匹敌或超过其 Qwen3.5-9B 视觉语言主干网络。紧凑的 2B 模型保持竞争力,在若干基准上常常优于更大的基线。WeMM-Video-9B 在大多数报告任务上匹敌或超过 Qwen3.5-9B,包括 Video-MME、Video-MMMU、MME-VideoOCR 和 TempCompass。WeMM-Video-4B 在所有报告基准上均超过两个开源全模态基线,其中 Video-MMMU 和 TempCompass 的提升尤其大。
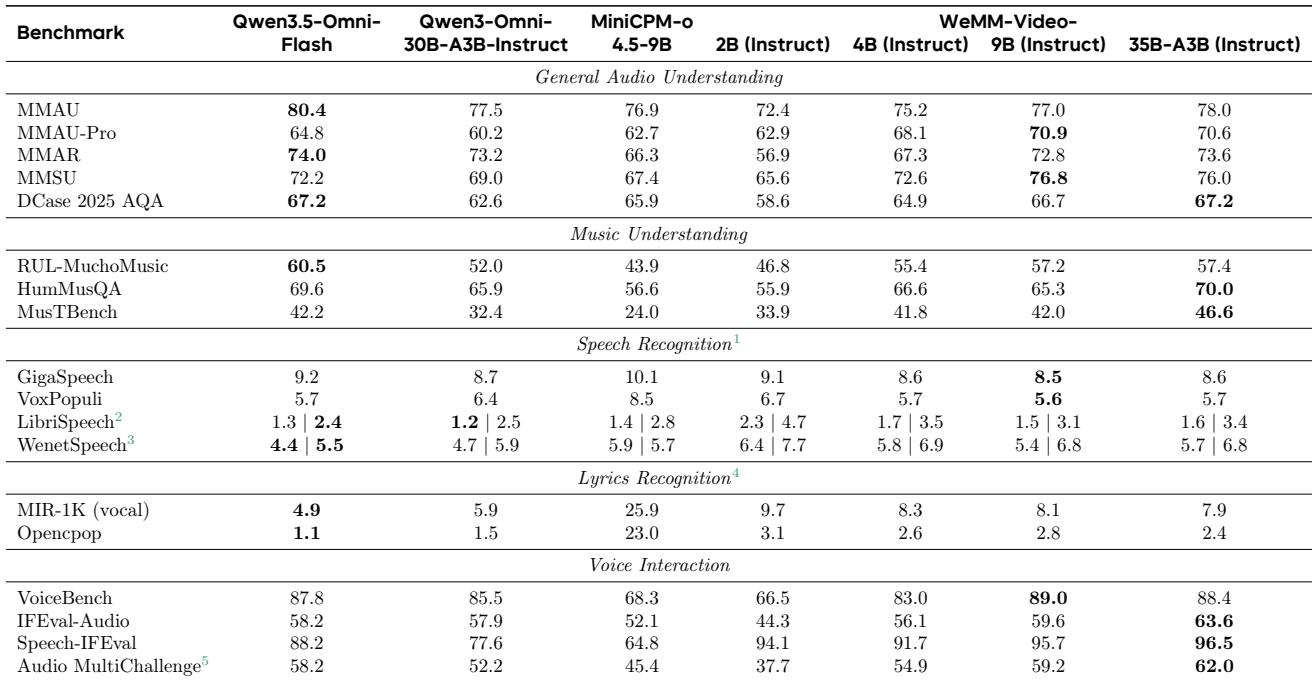
WeMM-Video 系列虽然以视频为中心,但展现出强大而全面的音频性能。在通用音频理解方面,35B-A3B 版本在报告基准上超过开源全模态基线,并在若干任务上与闭源模型 Qwen3.5-Omni-Flash 表现相当,而 9B 模型在 MMAU-Pro 和 MMSU 上领先。模型在语音交互、口语指令遵循、音乐理解、语音识别和歌词识别方面也表现出竞争力或领先水平。WeMM-Video-35B-A3B 在报告的通用音频理解基准上均优于 Qwen3-Omni-30B-A3B-Instruct 和 MiniCPM-o4.5-9B。WeMM-Video-9B 在 MMAU-Pro 和 MMSU 上取得最高分,超过所有列出的基线。WeMM-Video-35B-A3B 在 DCase 2025 AQA 上与闭源模型 Qwen3.5-Omni-Flash 打平,并在 MMAR 和 MMAU 上接近它。报告显示 WeMM-Video 系列在语音交互和口语指令遵循上领先,同时在音乐、语音和歌词识别方面保持竞争力。
实验在通用音视频、静音视频和音频理解基准上评估了 WeMM-Video 模型,并在 instruct 和 thinking 配置下与开源全模态基线和闭源模型进行对比。35B-A3B 版本在许多音视频和静音视频任务上接近或超过闭源基线,其思考模式始终优于 instruct 模式。较小的 9B 和 4B 版本在大多数基准上领先开源基线,而紧凑的 2B 仍具有竞争力,偶尔超过大得多的模型。音频结果表明,尽管设计以视频为中心,模型仍具有强大而全面的音频性能,在语音交互、口语指令遵循、音乐、语音和歌词识别方面取得领先或具有竞争力的成绩。