Command Palette
Search for a command to run...
HINT-WAM:面向世界动作模型的基于事后信息的训练方法
HINT-WAM:面向世界动作模型的基于事后信息的训练方法
Phuong Tuan Dat Qi Li Xinchao Wang
摘要
世界动作模型(WAM)通过将动作生成与未来视觉动态预测相结合,在机器人操作中展现出良好的泛化能力和数据效率。然而,将上述能力转化为可靠的任务执行,对现有的后训练方法而言仍是一项挑战。离线监督微调在专家轨迹上提供密集监督,但其流匹配动作专家仅在加噪的示范动作上训练,从未在其自身采样器产生的中间状态上训练;针对特定任务的适配也可能损害预训练能力。在线策略强化学习基于策略自身的行为进行训练,但稀疏的任务奖励使探索和信用分配变得困难,而密集的奖励塑形仍然只提供标量评估而非直接的动作目标。我们提出 HINT-WAM,这是首个在线策略自蒸馏框架,利用事后信息——即示范的未来视频——作为 WAM 自身可获得的特权信息,在动作专家自身的采样轨迹上对其进行监督。对于每个示范观测,学生通过自身的去噪轨迹生成动作,而在该轨迹上的各个状态处,同一模型作为教师额外以事后信息为条件,提供条件动作分布作为密集训练目标;学生仅看到部署时的输入,无需环境奖励或模拟器交互。为了将这种监督迁移到流匹配动作专家,HINT-WAM 利用能量分数将教师蒸馏到学生中,这是一种分布层面的目标,从学生自身的样本出发匹配教师的动作分布,而非回归其速度场。项目网页可通过此链接访问。
一句话总结
新加坡国立大学的研究者提出了 HINT-WAM,这是首个用于世界动作模型的同策略自蒸馏框架。该框架利用后见信息作为特权信息,在 flow-matching 动作专家自身采样轨迹上对其进行监督,并通过能量分数将教师蒸馏到学生,使学生从自身样本中匹配教师的动作分布,而不是回归其速度场,从而实现可靠的操控。
核心贡献
- 提出了 HINT-WAM,作为首个用于世界动作模型的同策略自蒸馏框架,其后见教师与学生共享骨干网络,在动作专家自身采样轨迹的状态上提供稠密动作目标。
- 该框架将未来演示视频作为特权后见信息,并通过能量分数对 flow-matching 动作专家进行蒸馏,使学生从自身样本中匹配教师的动作分布,而不是回归速度场,且无需外部教师、奖励或模拟器交互。
- 实验表明,在 LIBERO-90 和 RoboTwin 2.0 上,HINT-WAM 相较于监督微调和匹配基线提升了后训练性能,同时减少了预训练技能的灾难性遗忘,并可与经验回放组合。
引言
世界动作模型通过将动作生成与未来视觉预测耦合来改善机器人操控,最近的 flow-matching 动作专家会生成连续动作块。可靠适配仍然具有挑战性,因为监督微调存在暴露偏差,它只在演示动作上训练,而不是在模型自身采样的状态上训练,且无法解决歧义的动作延续。同策略强化学习可以处理状态不匹配问题,但通常难以应对稀疏奖励;现有的同策略蒸馏方法要么假设离散 tokens,要么需要单独的教师,要么回归一个会跨模态取平均的速度场。作者提出的 HINT-WAM 是一种同策略自蒸馏框架,其中策略利用后见未来帧充当自身教师,在自身采样器状态上监督 flow-matching 动作专家,并使用能量分数目标在无需似然评估的情况下匹配教师的动作分布。该方法无需外部教师、奖励或模拟器交互,并在 LIBERO-90 和 RoboTwin 2.0 上提升了后训练性能,同时减少了灾难性遗忘。
方法
作者提出了 HINT-WAM,一个后训练框架,使预训练的世界动作模型(WAM)能够利用后见信息充当自身教师。整体流程分为三个不同阶段:监督微调、后见教师训练和同策略自蒸馏。
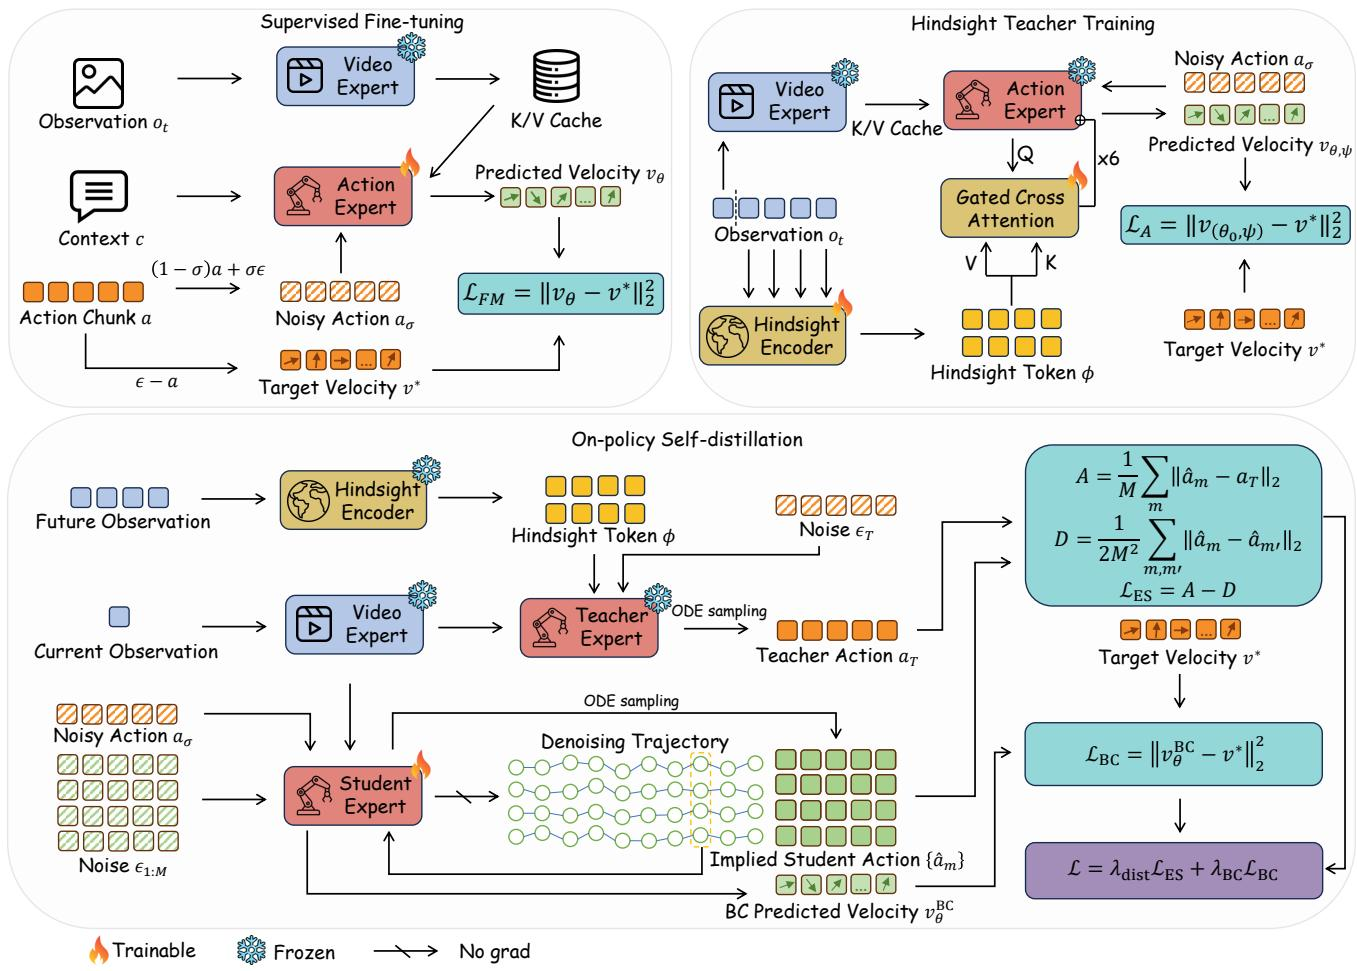
在第一阶段,作者执行监督微调(SFT)来初始化学生模型。基础架构是 Fast-WAM,它采用 Mixture-of-Transformers 骨干网络,每个层中两个专家共享一次注意力操作。视频专家处理当前相机帧,轻量动作专家在观测 o=(I,ℓ,s) 的条件下生成动作块 a∈RH×D。动作专家以 flow-matching 模型运行,为含噪动作块 aσ=(1−σ)a+σϵ 预测速度 vθ(aσ,σ,o)。模型通过最小化 flow-matching 损失来训练:
LFM(θ)=E(o,a),σ,ϵvθ(aσ,σ,o)−(ϵ−a)22.该阶段得到学生初始化 θ0。
接下来,作者在阶段 A 构建后见教师。为了解决目标歧义而不改变基础权重,他们冻结 SFT 模型 θ0,并引入两个可训练模块:后见编码器和门控交叉注意力适配器。后见编码器处理演示中的未来视频隐变量。它丢弃第一个隐帧以防止信息泄漏,对其余帧在空间上做平均池化,并对序列进行投影。一组可学习查询随后通过多头注意力对该序列进行汇聚,生成后见 tokens ϕψ(z)。这些 tokens 通过连接在部分层之后的门控交叉注意力适配器注入动作专家。适配器计算:
h′=h+tanh(αl)WupWoutAttn(q,k,v),其中 q 来自 action-token 隐藏状态,k,v 来自后见 tokens。整个骨干网络保持冻结,仅使用加入后见信息的 flow-matching 损失训练编码器和适配器参数 ψ。
最后,阶段 B 专注于同策略自蒸馏以解决暴露偏差。学生 θ 从 θ0 初始化,并被训练为在自身采样轨迹上匹配冻结教师 T=(θ0,ψ)。学生无需梯度地对其自身的 probability-flow ODE 进行积分,以记录推理期间访问的去噪状态。为高效监督这些状态,作者选择局部欧拉步误差最高的 top-K 个点,并将其权重重归一化为 wˉk。
为使学生与教师对齐,作者采用两个蒸馏目标。第一个是速度匹配,最小化学生与教师在所选状态上的速度差:
Lvel(θ)=k=1∑KwˉkEvθk−sg[vTk]22.由于从学生角度看教师行为是多模态的,匹配条件均值可能不是最优。因此,作者还使用能量分数进行分布匹配。学生采样 M 条独立轨迹以获得隐含动作 a^m,k,而教师使用其 ODE 采样单个动作 aT。能量分数损失定义为:
LES(θ)=k=1∑Kwˉk[M1m=1∑M∥a^m,k−aT∥2−2M21m,m′=1∑M∥a^m,k−a^m′,k∥2].该目标将学生样本拉向教师样本,同时将其彼此推开以防止模式崩溃。为防止学生盲目跟随教师错误,添加了行为克隆锚项 LBC(θ)=LFM(θ)。最终阶段 B 目标在蒸馏项和行为克隆项之间进行平衡:
LB(θ)=λdistLdist(θ)+λBCLBC(θ),其中 Ldist∈{Lvel,LES}。部署时仅使用学生模型,确保策略在不需要未来观测的情况下运行。
实验
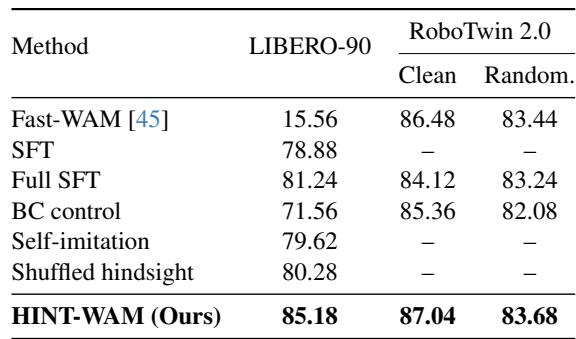
实验在 LIBERO-90 和 RoboTwin 2.0 上评估 HINT-WAM,从共享的 Fast-WAM 检查点开始,并与 SFT、完整 SFT、BC 对照、自我模仿和打乱后见基线进行比较。在未见过的 LIBERO-90 任务上,后见蒸馏优于 SFT 和完整 SFT,同时计算开销低于完整 SFT;在 RoboTwin 上,它避免了持续模仿带来的性能退化。持续学习结果表明,HINT-WAM 比 SFT 遗忘更少,并且能与经验回放良好组合。消融实验表明,能量分数分布匹配、行为克隆锚项、多个学生样本和同策略状态各自都有贡献,其中锚项与后见校正共同带来了主要改进。
微调动作专家使 LIBERO-90 成功率相比已发布的 Fast-WAM 检查点大幅提升,而 RoboTwin 结果在各方法间普遍保持较高水平。消融显示,最强的 LIBERO-90 结果来自将行为克隆锚项与能量分数分布匹配、同策略状态和多个学生样本相结合。单独的消融设置,包括移除锚项或使用演示状态,性能回落到 SFT 附近或低于 SFT。Fast-WAM 在 LIBERO-90 上相比微调基线存在较大差距,但 RoboTwin 成功率在各评估方法间保持接近。在匹配的消融条件下,能量分数分布匹配优于速度匹配、MMD 和动作空间 MSE。将行为克隆锚项与蒸馏结合产生强正向交互,而单独使用任一组件都会降低成功率。使用学生自身的同策略状态优于使用像 SFT 中那样加噪的演示状态,并且更多学生样本会单调提高成功率。
在没有经验回放的情况下于 LIBERO-90 上进行后训练,会对所有方法的四个原始任务套件造成严重遗忘,平均成功率从 96.55% 降至 45% 以下。HINT-WAM 在无回放时保留了最多的原始套件性能,而完整 SFT 遗忘最多。加入经验回放后,差距基本消除,HINT-WAM 受益更多,在新任务和原始任务上均超过 SFT,并几乎匹配已发布的检查点。无回放时,所有方法在 LIBERO-90 训练后原始套件的平均成功率都低于 45%。HINT-WAM 在无回放时保留最多预训练技能,而完整 SFT 损失最多。经验回放在很大程度上恢复了原始套件性能,HINT-WAM 加回放在新任务和原始任务上均超过 SFT。HINT-WAM 最大的回放增益出现在长时程套件上。
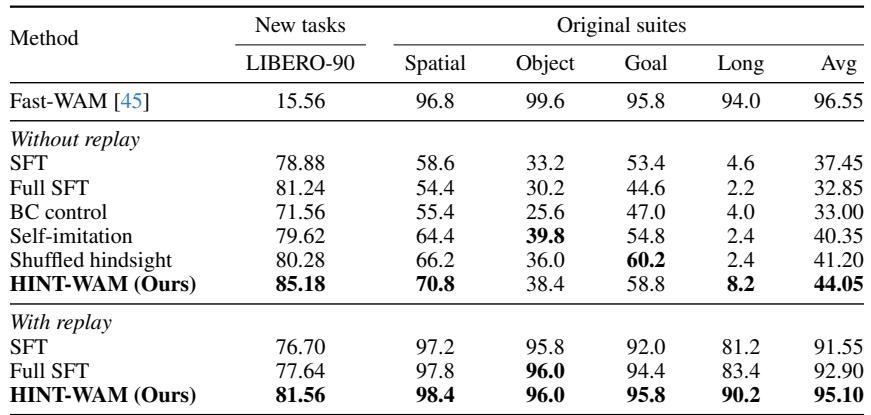
评估涵盖在 LIBERO-90 和 RoboTwin 上的微调、蒸馏组件的消融,以及在四个原始套件上的后训练保持情况。微调动作专家使 LIBERO-90 相比已发布的 Fast-WAM 检查点大幅提升,最佳设置将行为克隆锚项与能量分数分布匹配、同策略状态和多个学生样本相结合,而 RoboTwin 成功率在各方法间普遍保持较高水平。在没有经验回放时,LIBERO-90 后训练会在所有方法的原始套件上造成严重遗忘;回放在很大程度上恢复性能,HINT-WAM 保留最多预训练技能,并在新任务和原始任务上超过 SFT。