Command Palette
Search for a command to run...
Jeveration:系统一模型现在可以生成了
Jeveration:系统一模型现在可以生成了
Yuhe Liu Qi Li Shihua Zhang Xinchao Wang
摘要
系统一模型(如 Jev)通过快速、并行的预测返回决策。本文提出 Jeveration,证明同样的决策范式也能在单次前向传播中生成高质量图像。Jeveration 建立在一个冻结的视觉-语言模型之上,复用其视觉-语义知识进行整体图像生成。关键挑战在于保持全局一致性。单个提示对应许多有效图像,但并行预测必须收敛为一个连贯的整体。因此,我们让所有位置都条件于一个共享的随机状态,以协调并行预测,使每次采样得到不同但连贯的图像。由于在直接图像监督下模型倾向于忽略该状态,我们首先学习离散图像编码上的分布,以指导单次生成。除文本到图像生成外,我们进一步在同一架构中统一了图像到图像生成和密集预测,使得一个检查点即可支持全部三项任务,且每项任务均只需一次前向传播。实验表明,Jeveration 在 78 ms 内生成一幅 512×512 图像,比现有统一模型快达 122 倍,同时保持有竞争力的图像质量和密集预测性能。
一句话总结
新加坡国立大学的研究人员提出 Jeveration,这是一种 System One 模型,它重新利用一个冻结的视觉语言模型,通过共享随机状态和学到的离散图像码分布,在单次前向传播中生成连贯图像,统一了文本到图像生成、图像到图像生成和密集预测,同时生成 512×512 图像仅需 78 ms,比现有统一模型快至 122×。
核心贡献
- Jeveration 被提出为一种并行决策模型,通过重新利用冻结视觉语言模型的视觉语义知识,在单次前向传播中生成 512×512 图像。
- 为保持全局一致性,该方法让所有图像码位置都以一个共享随机状态为条件,并通过与掩码模型进行 token 级条件匹配来学习离散图像码上的分布,避免了在直接图像监督下忽略该状态的倾向。
- 单个 checkpoint 通过共享适配器和任务特定输出头,统一了文本到图像生成、图像到图像生成和密集预测;实验报告生成时间为 78 ms,比现有统一模型快至 122×,并具有有竞争力的图像质量和密集预测性能。
引言
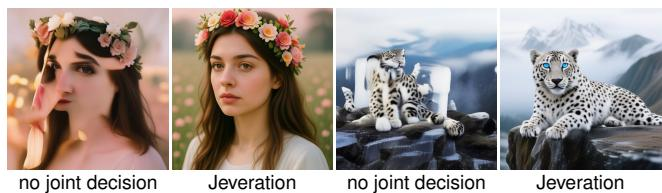
图像生成目前由自回归模型和扩散模型主导,但两者都依赖大量顺序模型求值,这会增加推理延迟。先前的 System One 模型能够并行返回类型化视觉决策,但它们主要应用于理解和评分任务,而非合成任务;朴素的并行图像预测往往产生空间上不连贯的区域。作者引入 Jeveration,它通过 LoRA 适配器和输出头适配冻结的视觉语言模型,在单次前向传播中把整张图像作为一个联合决策返回。为了实现连贯性,所有码位置都以一个共享随机状态为条件,并且一个经过掩码训练、学习图像分布的模型提供用于指导并行决策的目标条件分布。最终得到的单个 checkpoint 覆盖文本到图像生成、图像到图像生成和密集预测任务。
方法
Jeveration 使视觉语言模型(VLM)能够在单次前向传播中通过并行类型化决策生成图像,同时在同一个框架内支持密集预测任务。对于图像合成,模型在每个码位置选择一个码本条目;对于密集预测,模型产生任务特定的类别或分数。共享随机状态为所有码位置提供共同的随机条件,确保每次采样都得到不同但全局连贯的图像。
给定条件输入 y,例如文本提示或源图像,Jeveration 将输出形式化为类型化决策。图像被表示为来自图像 tokenizer 的离散码 c=(c1,…,cN) 的联合选择。直接预测每个码位置的分类分布并独立并行采样码的方法无法捕捉码之间的依赖关系。这种独立因子分解只匹配边缘分布,通常会导致码无法组合成连贯图像。
为了克服这一点,Jeveration 为每张图像采样一个随机状态序列 ξ,并让每个码位置都以该共享状态为条件:
qθ(c∣y)=Eξ∼p0[i=1∏Nqθ,i(ci∣y,ξ)]虽然码在给定 (y,ξ) 时是独立采样的,但它们对 ξ 的共同依赖使得生成的图像分布能够捕捉位置之间的依赖关系。这使模型能够在单次前向传播中决定所有位置的同时协调其码选择。
作者通过向 VLM 的输入追加 decision tokens 来实现这些视觉决策。文本 token 编码提示和任务指令,冻结的视觉塔将任何输入图像编码为 visual tokens。decision tokens 从采样得到的随机状态初始化,用于图像生成;在密集预测中则作为空间查询。带有共享 LoRA 适配器的冻结骨干网络在单次前向传播中处理输入和 decision tokens。在其全注意力层中,decision tokens 双向地相互关注,输入前缀保持因果。最后,任务特定头将 decision tokens 的最终隐藏状态映射到图像码或密集预测。
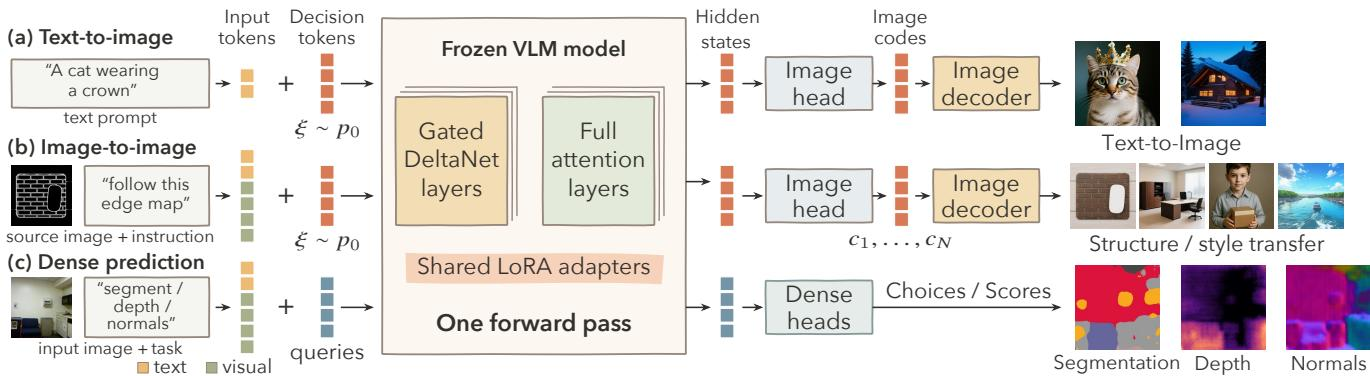
对于图像生成,图像 tokenizer 是冻结的 TA-TiTok,每张图像有 N=128 个码。decision tokens 的初始嵌入编码随机状态 ξ∼p0,该状态以概率 ρ 掩码每个位置,用均匀随机码填充其余位置,并向所有嵌入添加尺度为 σ 的高斯噪声。一个 Transformer 头读取这些 token 的最终隐藏状态以及 ξ,为每个位置输出特征 ui。每个码通过两个分支从 ui 预测。码本分支 fcb 将 ui 投影到码空间,并应用一个由 tokenizer 码本初始化的分类器。宽分支 fwide 初始化为零,直接将 ui 映射到码 logits。码分布对两者求和:
qθ,i(⋅∣y,ξ)=softmax(fcb(ui)+fwide(ui))在推理时,所有码作为一个联合决策并行采样,并由 tokenizer 的解码器渲染。对于密集预测,decision tokens 作为与输入图像的 visual tokens 对齐的空间查询,任务特定头将每个查询的最终隐藏状态解码为分割、深度或表面法线预测。
训练过程教会模型使用 ξ 来做出连贯的图像决策。对目标码的直接监督不会促使模型使用 ξ,因为随机状态是独立于目标图像采样的。因此,作者首先通过掩码预测学习图像分布模型,然后用它来指导从随机状态生成图像决策。
在第一阶段,该架构以 VLM 冻结的方式作为掩码模型训练。对于目标码 c,随机掩码一个集合 M,并从可见码 cMˉ 和条件 y 预测被隐藏的码:
Lmask(ϕ)=E[∣M∣1i∈M∑−logpϕ,i(ci∣cMˉ,y)]可见码提供图像特定的上下文,使模型能够学习位置之间的依赖关系。
在第二阶段,决策模型 θ 从第一阶段的模型开始,学习把随机状态转化为完整图像。给定 (y,ξ),θ 预测 logits,并在单次传递中采样码序列 c^。随机重新掩码 c^ 的子集 M,两个掩码模型从相同的可见码预测隐藏码。冻结的第一阶段模型 ϕ 表示图像分布,而辅助模型 ψ 跟踪 θ 的当前分布。辅助模型开始时是 ϕ 的副本,并继续在 θ 的样本上训练。当 θ 匹配图像分布时,两个预测一致。作者使用它们的差异来更新 θ,最小化:
LDM(θ)=E[∣M∣1i∈M∑sg(pψ,i−pϕ,i)⊤ℓθ,i]其中 sg 阻止梯度回传。这促使 θ 通过共享状态 ξ 协调其码。
在第二阶段的最后部分,置信度引导的校正为生成样本添加直接监督。对每个批次中的部分样本,置信度最低的一半位置被重新掩码,冻结模型在若干轮中将其补全为 cref。然后训练模型 θ 从相同的 (y,ξ) 预测这些校正后的码:
Lgen=LDM+λLcorr,Lcorr=Eselected[∣R∣1∑i∈R−logqθ,i(ciref∣y,ξ)].密集任务使用真实标签进行监督,分割使用交叉熵,深度使用 ℓ1 深度误差,表面法线使用 1−cos。冻结模型、辅助模型和校正仅在训练中使用,确保推理仍然只是 θ 的单次前向传播。
实验
实验评估单个 Jeveration checkpoint,在冻结 VLM 上训练了 rank-256 LoRA 适配器,覆盖文本到图像生成、图像到图像任务和密集预测,并使用 GenEval、DPG-Bench 和 HPSv2.1 等生成基准,以及结构保真度、NYUv2 和延迟指标。文本到图像结果显示,该模型在单次前向传播中生成连贯图像,比统一基线和仅生成基线更快,同时保持有竞争力的质量。图像到图像和密集预测实验表明,同一个 checkpoint 能够处理可控生成、分割和深度估计,结构保真度高,额外延迟很小。消融实验确认,共享随机状态、校正目标、双图像头分支、源条件化和联合训练各自对图像质量、可控性或任务灵活性有贡献。
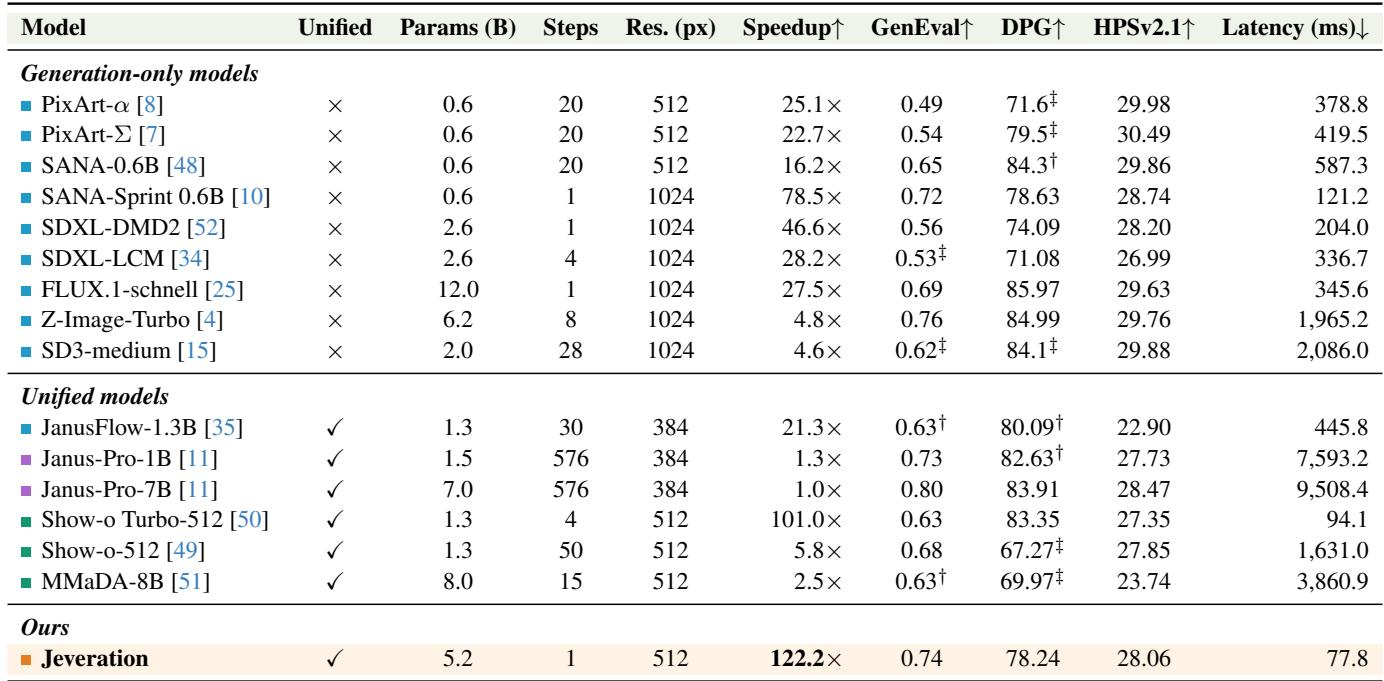
Jeveration 在单次前向传播中生成 512x512 图像,在比较中端到端延迟最低,GenEval 高于所列统一基线和同分辨率仅生成基线。它比自回归 Janus-Pro 基线快约两个数量级,并且尽管这些单步生成专用模型输出分辨率更高,Jeveration 在 GenEval 上仍优于其中若干模型。结果表明,冻结的视觉语言骨干网络无需迭代采样即可提供有竞争力的文本到图像质量。在 512 像素分辨率下,它取得比多步生成专用模型更高的 GenEval,同时端到端速度快数倍。在相同硬件的 batch 1 下,它比自回归 Janus-Pro 基线快约两个数量级。
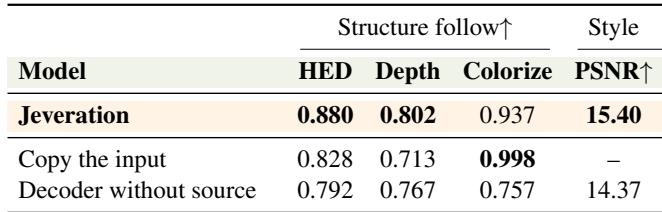
在留出的图像到图像样本上,Jeveration 在边缘、深度和着色任务中取得了较强的结构保真度。相比没有源条件化的解码器,它尤其在着色和边缘保真度上有所提升,并获得更高的风格 PSNR。Jeveration 在比较的各条件中获得最佳边缘和深度保真度。源图像条件化相比无源解码大幅提升着色保真度,并将边缘保真度提升到高于直接输入复制。Jeveration 获得比无源解码器更好的风格 PSNR,表明其与成对风格目标的对齐更紧密。
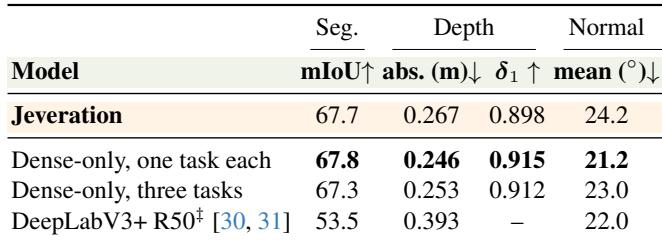
在 NYUv2 密集预测上,统一模型与同一骨干网络的仅密集分割精度相当,并远超 DeepLabV3+。深度精度接近仅密集基线,而表面法线误差略高。每个预测都在单次前向传播中产生,支持一个 checkpoint 同时用于图像生成和密集预测。统一模型与同一骨干网络的仅密集分割分数相当,同时大幅超过 DeepLabV3+。深度误差接近仅密集基线,并远低于 DeepLabV3+,但表面法线精度落后于仅密集模型。
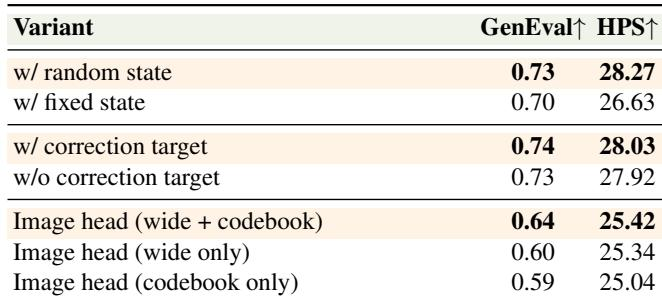
消融实验表明,共享随机状态相比固定状态同时改善构图和图像质量。校正目标在不改变构图的情况下带来少量质量提升,宽分支和码本图像头分支的组合优于任一单独分支。结果支持所选配置能够实现连贯、高质量的生成。共享随机状态相比固定状态获得更高的 GenEval 和 HPS,表明连贯性和图像质量更好。使用校正目标提高 HPS,而 GenEval 保持相近,说明它细化细节而非构图。移除校正目标会略微降低图像质量,而构图没有显著变化。宽分支加码本图像头组合优于仅宽分支和仅码本变体。
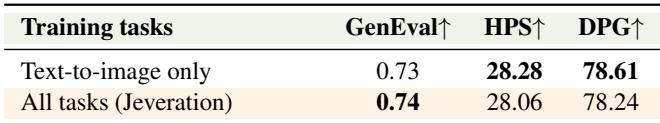
跨文本到图像、图像到图像和密集预测任务的联合训练几乎完全保持文本到图像质量。全任务模型在 GenEval、HPS 和 DPG 指标上与仅文本到图像基线不相上下。新增任务引入的干扰很小,同时实现了密集预测和图像到图像生成。全任务训练匹配仅文本到图像质量,在 GenEval、HPS 和 DPG 上只有微小差异。添加图像到图像和密集任务对文本到图像性能几乎没有成本。对于密集预测,联合训练匹配仅密集分割精度,深度和法线精度只有适度下降。
Jeveration 作为统一视觉语言模型,在文本到图像、图像到图像和密集预测任务上进行了评估。它在单次前向传播中生成 512x512 图像,延迟低于若干仅生成基线,GenEval 更高;图像到图像实验显示边缘、深度和着色保真度较高,并随着源条件化而提升。对于密集预测,统一模型与同一骨干网络的分割质量相当,并优于 DeepLabV3+,深度接近仅密集基线;消融实验确认共享随机状态、校正目标和组合图像头分支提高了质量,联合训练在几乎不产生干扰的情况下保持了文本到图像性能。