Command Palette
Search for a command to run...
CurvDelta:面向外科手术式学习与遗忘的低曲率 Delta 建模
CurvDelta:面向外科手术式学习与遗忘的低曲率 Delta 建模
Zeguan Xiao Zhuocheng Liang Yun Chen Yong Wang Guanhua Chen Pinyan Lu
摘要
在适配大语言模型(LLM)时,一个核心挑战是能力保持:适配过程可能在实现目标的同时损害通用能力。我们提出 CurvDelta,一个将保持约束纳入模型更新参数化的可扩展框架。通过分析保持约束在适配前模型附近的局部几何,CurvDelta 构造了一个低曲率空间,使参数更新在该空间中几乎不改变保持损失。我们借助 Kronecker 分解近似曲率(K-FAC)和因子化投影,使其构造对 LLM 具有实际可行性。我们还提出 CurvLoRA,即在同一保持几何下的低秩变体,旨在实现更高效的适配。两种方法均适用于能力学习和选择性遗忘等受保持约束的适配任务。我们在数学推理、代码生成和知识遗忘上评估了所提方法。在数学推理和代码生成方面,我们的方法在取得有竞争力的下游性能的同时,能更好地保持通用能力,相对于基线提供了更有利的获取—保留权衡。在知识遗忘方面,我们在 TOFU 和 MUSE 上的主要结果表明,与基线相比,我们的方法在定向遗忘与知识保留之间取得了更好的平衡,其保留性能接近从头重训参考。
一句话总结
来自上海财经大学、阿里巴巴集团和南方科技大学的研究者提出 CurvDelta,一个可扩展框架,利用 Kronecker 因子分解近似曲率和因子化投影构造低曲率参数空间,以在适配过程中保留通用能力,并给出其低秩变体 CurvLoRA,在数学推理、代码生成和知识遗忘中改善获取与保留之间的权衡。
核心贡献
- 论文提出 CurvDelta,一种可扩展框架,通过围绕预适配模型构造低曲率空间,将保留约束纳入 LLM 更新参数化,使更新几乎不改变保留损失。
- 该框架使用块对角 Kronecker 因子分解近似曲率和逐因子谱截断以实现可扩展构造,在同一保留几何下支持低秩 CurvLoRA 变体,并推导出由保留曲率和更新幅度控制的局部保留界。
- 在数学推理、代码生成、TOFU 和 MUSE 上的评估表明,CurvDelta 与 CurvLoRA 取得了有竞争力的目标任务性能,同时更好地保留通用能力,遗忘场景下的保留接近重训参考。
引言
大型语言模型在预训练后需要针对新任务或选择性遗忘进行适配,但这些更新需要保留无关知识和能力。已有方法,如重放、正则化或将更新约束到正交或零子空间,要么不能保证预期的保留约束,要么施加间接约束,损害适配与保留之间的权衡。作者提出 CurvDelta,一个利用块对角 K-FAC 和逐因子谱截断从局部保留几何构造固定低曲率 delta 空间的框架,同时支持稠密适配和具有明确保留界的低秩 CurvLoRA 变体。
方法
CurvDelta 将适配形式化为在冻结基座模型 θ0 周围学习模型更新 Δθ,并服从显式保留约束。给定任务集 Dtask 和保留集 Dpres,保留损失定义为
Lpres(θ)=Ex∼Dpres[d(zθ(x),zθ0(x))],适配问题为
θminLtask(θ)s.t.Lpres(θ)≤ε.该公式同时覆盖能力学习和选择性遗忘,两种设置仅任务目标不同。
CurvDelta 并未优化拉格朗日惩罚项,而是将保留约束直接纳入 delta 参数化。其核心思想是将实际更新 Δθ 限制在保留损失在 θ0 处具有低曲率的方向上。这使得保留成为更新几何的性质,而非事后正则化项。保留几何与任务无关,可在不同任务集、任务目标和 delta 参数化之间复用。
为证明该限制合理,方法对 Lpres 在 θ0 处使用二阶展开。在差异度量 d 的温和条件下,保留 Hessian 退化为广义 Gauss-Newton 矩阵
Gpres=Ex∼Dpres[J0(x)⊤Hz(x)J0(x)],其中 J0(x) 是输出的参数 Jacobian,Hz(x) 是 d 的输出空间 Hessian。局部保留代价随后近似为
Lpres(θ0+Δθ)≈21Δθ⊤GpresΔθ.因此保留约束变为
Δθ⊤GpresΔθ≤2ε.在固定更新范数下,当 Δθ 与 Gpres 的尾特征向量对齐时,保留损失更小,这些尾特征向量对应保留损失的低曲率方向。
由于精确特征分解在大语言模型规模上不可行,CurvDelta 使用块对角 Kronecker 因子分解近似曲率来近似 Gpres。对每个被适配的线性权重 Wl∈Rdout×din,对应块为
Gpres(l)≈Klin⊗Klout,其中
Klin=E[al−1al−1⊤],Klout=E[glgl⊤],且 al−1 和 gl 分别是输入激活和层输出梯度。这些因子在 θ0 上使用 Monte Carlo Fisher 估计器在 Dpres 上估计一次。
为构建可扩展的低曲率 delta 空间,方法采用逐因子谱截断。对于谱阈值 γ,保留两个因子的主导特征向量,形成基 Uhout 和 Uhin。投影到互补低曲率方向的投影算子为
Pout=I−Uhout(Uhout)⊤,Pin=I−Uhin(Uhin)⊤.随后将可训练预投影 delta δ(ϕ) 映射为实际应用的 delta
ΔW:=Poutδ(ϕ)Pin.这产生可分离的双侧投影,将更新约束到两个 K-FAC 因子的尾特征空间。保留曲率受下式约束
κ=λrout+1outλrin+1in,其中 rout 和 rin 是谱截断选择的秩。因此,逐层二次保留代价满足
vec(ΔW)⊤(Kin⊗Kout)vec(ΔW)≤κ∥ΔW∥F2.增大 γ 会同时降低 κ 和允许更新空间的维度。
同一投影支持两种 delta 参数化。在稠密变体中,CurvDelta 将每个 δl 参数化为初始为零的完整矩阵,覆盖整个保留的低曲率空间。在低秩变体中,CurvLoRA 使用 LoRA 分解
δl=BlAl,ΔWl=(PloutBl)(AlPlin),其中 Bl∈Rdout×r 初始为零,Al∈Rr×din。这将实际更新限制在同一低曲率空间内秩至多 r,同时避免显式构造稠密权重矩阵。
优化期间,基座参数和估计的投影算子保持固定。通过令梯度穿过投影来最小化 delta 参数上的任务损失。由于投影已内置到参数化中,实际更新在整个训练过程中始终处于指定的低曲率空间,无论使用何种优化器。这不同于事后梯度投影,后者可能被自适应优化器的重新缩放所改变。
在块对角 K-FAC 模型下,保留损失按被适配层分解,并服从界
Lpres(θ0+Δθ)≤21l∈T∑κl∥ΔWl∥F2.因此,只要满足
l∈T∑κl∥ΔWl∥F2≤2ε.更新相对于局部二次保留约束就是可行的。曲率系数 κl 由预计算的保留几何固定,而各层 delta 范数由优化轨迹和学习率调度决定。
实验
实验在数学和代码基准上评估能力学习,并在 TOFU 和 MUSE 上评估选择性遗忘,将 CurvDelta 和 CurvLoRA 与全微调、重放、LoRA 变体以及基于投影的基线在多个模型主干上进行比较。在这些设置中,CurvDelta 和 CurvLoRA 改善了任务适配或遗忘与保留知识之间的权衡,CurvDelta 通常带来最强的联合结果,CurvLoRA 在可训练参数更少的情况下仍具竞争力。消融实验确认低曲率方向、delta 参数化和谱阈值支持这种平衡,同时该方法对保留数据规模具有鲁棒性,且相比以往基于曲率的方法降低了运行时间和内存。
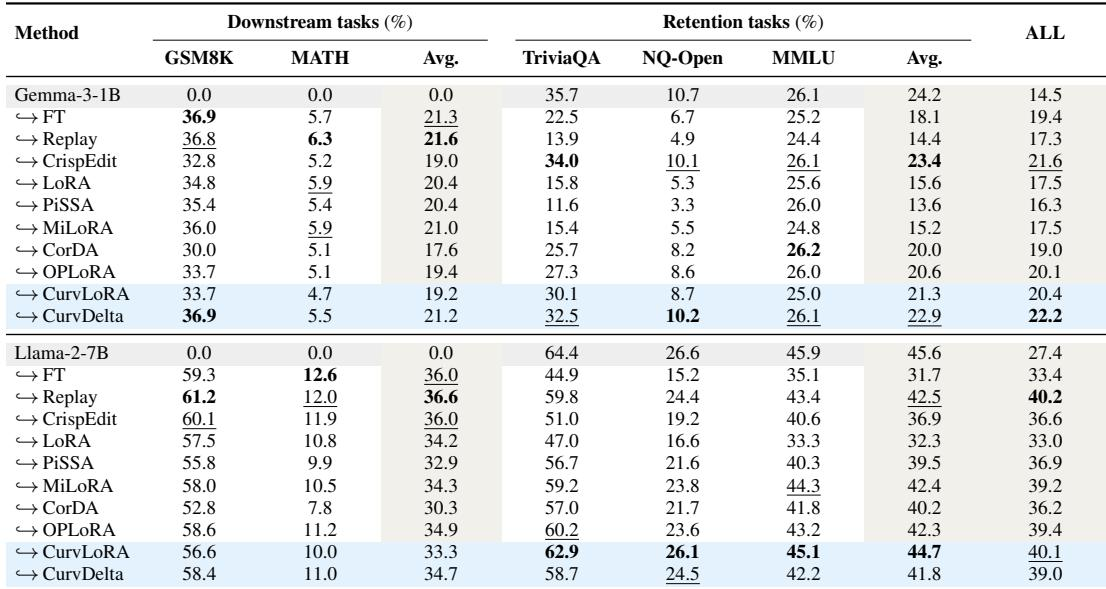
全微调提供了很强的数学推理获取,但一致降低通用知识保留。CurvDelta 使下游数学性能接近全微调,同时明显缩小保留差距,CurvLoRA 在 Llama 上倾向于保留更多通用知识,但下游数学性能有所下降。全微调实现很强的下游数学提升,但保留性能一致低于基座模型。CurvDelta 在数学推理上与全微调保持竞争力,同时显著改善保留。CurvLoRA 在 Llama 上的适配方法中保留率最高,尽管下游数学性能较低。
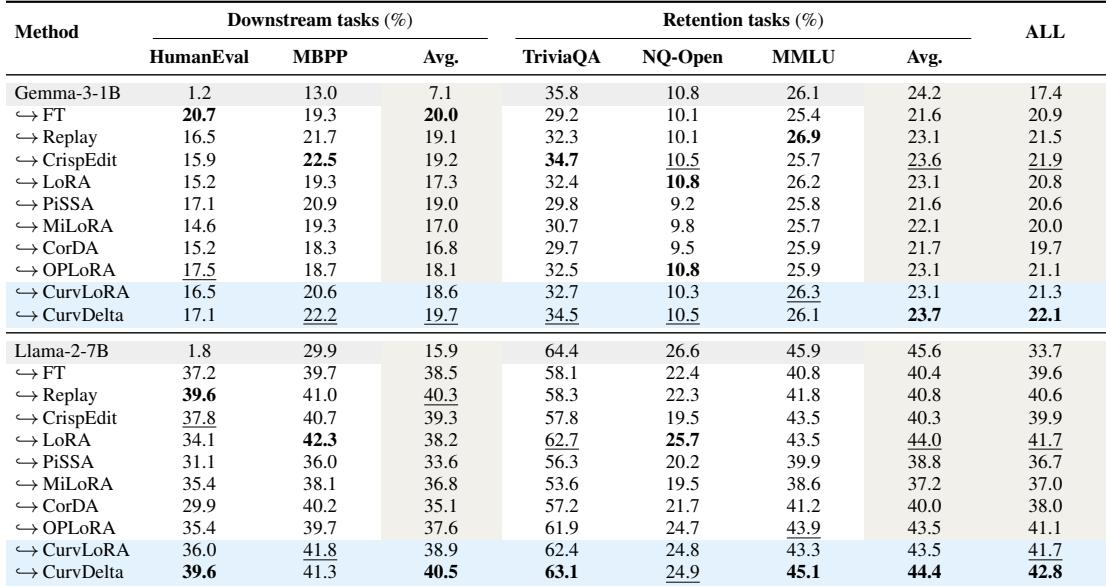
在 Gemma-3-1B 的代码生成基准上,全微调带来最大的下游提升,但相对于基座模型降低了保留。Replay 和 CrispEdit 恢复了一定保留,但在下游准确率上落后于全微调。所报告的 CurvDelta 方法在多个主干上产生最强的下游与保留联合权衡,下游性能接近或高于全微调,并在适配方法中具有最高的平均保留。Gemma-3-1B 上的全微调在所列方法中取得最高下游平均,但其保留平均低于基座模型。Replay 和 CrispEdit 相对于全微调改善了保留,但牺牲了一些下游代码生成准确率。LoRA 和 PiSSA 的低秩适配在下游代码生成上低于全微调,PiSSA 保留的通用知识少于 LoRA。报告显示 CurvDelta 在两个主干上获得最佳联合平均,下游任务接近或高于全微调,同时在适配方法中保留最多的通用知识。
在 SimNPO 下,与全微调、CrispEdit 和 LoRA 相比,CurvDelta 在 TOFU 和 MUSE 上改善了遗忘与保留平衡。在 TOFU 上,它在两个遗忘划分中取得最强的 Forget Quality,同时保持效用接近重训;在 MUSE 上,它最大程度减少逐字记忆。其低秩变体在 10% TOFU 划分中进一步降低遗忘答案概率,但在 Forget Quality 上落后于稠密变体,同时在 MUSE 上保留更多知识。CurvDelta 在两个 TOFU 遗忘划分上取得最强的 Forget Quality,并保持模型效用接近重训。CurvLoRA 在 10% TOFU 划分中进一步降低遗忘答案概率,但其 Forget Quality 低于稠密 CurvDelta。在 MUSE 上,CurvDelta 实现最低的逐字记忆,而 CurvLoRA 保留更多知识。
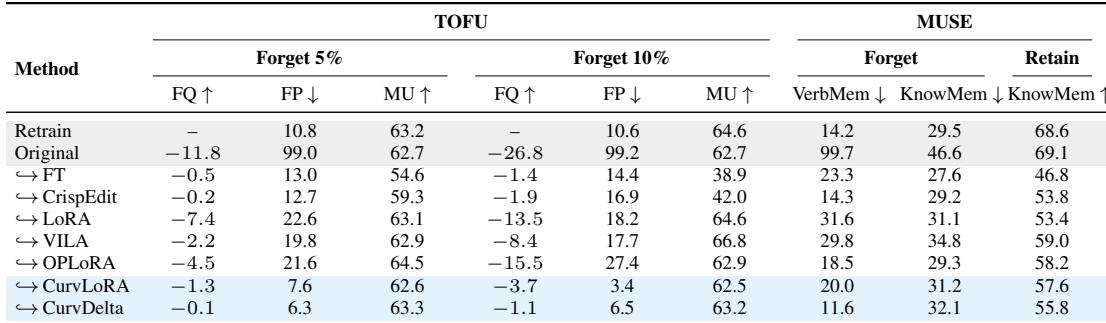
实验在数学推理和代码生成上比较全微调、参数高效适配器以及重放或 CrispEdit 方法,然后在 TOFU 和 MUSE 上评估 SimNPO 遗忘。全微调一致取得很强的下游提升,但降低通用知识保留,而 CurvDelta 通过在下游任务上接近或高于全微调并在多个主干上保留最多知识,提供最佳整体权衡。CurvLoRA 倾向于保留更多通用知识,尤其在 Llama 和 MUSE 上,但通常下游或 Forget Quality 性能较弱。在 SimNPO 下,CurvDelta 通过实现较强 Forget Quality 和接近重训的效用改善遗忘与保留平衡,其低秩变体在一个 TOFU 划分中降低遗忘答案概率,但牺牲一定 Forget Quality。