Command Palette
Search for a command to run...
Game2Player:通过环境–玩家协同开发扩展视觉智能体的游戏体验
Game2Player:通过环境–玩家协同开发扩展视觉智能体的游戏体验
摘要
游戏是视觉智能体的丰富测试平台,要求感知、长程规划与精确控制。然而,收集人类游戏过程成本高昂,而从游戏视频中学习需要推断缺失的动作。现有数据集覆盖的游戏范围也有限,往往缺乏明确任务或可验证的结果。为弥补这些不足,我们提出了 Game2Player,一个协同开发游戏环境与玩家、以大规模收集多样且可验证游戏体验的框架。在 Game2Player 循环中,Builder 智能体改编现有网页游戏,暴露其内部状态,并定义带有基于状态的进度度量和成功判定的任务。随后,Coding Player 和 VLM Player 尝试完成任务,并将问题反馈给 Builder 进行修复,从而使游戏过程同时充当环境验证和训练数据收集。借助 Game2Player,我们构建了 568 个经过验证的网页游戏,包含 3,436 个任务,收集了 15.7K 条轨迹(307 小时游戏过程),并留出 50 个游戏作为基准 PlayerBench。为评估所收集经验作为训练数据的价值,我们使用进度加权 SFT 训练 VLM 智能体,对推进任务进度的步骤赋予更大权重。Game2Player-9B 在 PlayerBench 上将进度从 14.3% 提升至 31.2%,在外部 GameWorld 基准上从 30.0% 提升至 53.1%。更广泛地看,我们的工作为视觉智能体通过构建、验证并从现有游戏世界中学习来扩展其游戏体验指明了一条路径。
一句话总结
伊利诺伊大学厄巴纳-香槟分校(UIUC)的研究者与合作者提出了 Game2Player,该框架通过一个 Builder agent、一个 Coding Player 和一个 VLM Player 共同开发游戏环境和玩家,收集了 568 个经验证的网页游戏、3,436 个任务和 15.7K 条轨迹,随后使用进度加权 SFT 训练 Game2Player-9B,将 PlayerBench 上的进度从 14.3% 提高到 31.2%,将 GameWorld 上的进度从 30.0% 提高到 53.1%。
核心贡献
- 提出了 Game2Player,作为一个共同开发游戏环境与玩家的框架:Builder agent 适配现有网页游戏、暴露内部状态,并定义带基于状态的进度度量和成功检查的任务,而 Coding Player 和 VLM Player 尝试任务并报告问题以供修复。
- 该框架用于构建 568 个经验证的网页游戏,包含 3,436 个任务,收集 15.7K 条轨迹,总计 307 小时游戏过程,并留出 50 个游戏作为 PlayerBench 基准。
- 进度加权监督微调为推进任务进度的步骤赋予更大权重;由此得到的 Game2Player-9B agent 在 PlayerBench 上的进度从 14.3% 提高到 31.2%,在外部 GameWorld 基准上的进度从 30.0% 提高到 53.1%。
引言
由视觉语言模型驱动的视觉 agents 在计算机使用和具身任务上取得了进展,但视频游戏带来了更困难的挑战,因为每个游戏都有其自身的视觉效果、规则和操作方式,agent 必须在精确时机下行动并推断这些内容。大规模收集游戏经验一直受限于昂贵的人类录制、缺少动作且需要逆动力学或潜在动作恢复的在线视频,以及针对特定游戏的交互式环境工程。Coding agents 可以帮助构建环境,但即使任务无法完成、进度度量失效或成功检查过早触发,它们也可能通过自己的测试。作者提出了 Game2Player,一个框架,其中 Builder agent 与两个玩家,即 VLM Player 和 Coding Player,通过游戏过程反馈从自然网页游戏共同开发可验证环境,然后利用互补演示进行进度加权监督微调,并构建 PlayerBench 用于评估。
数据集
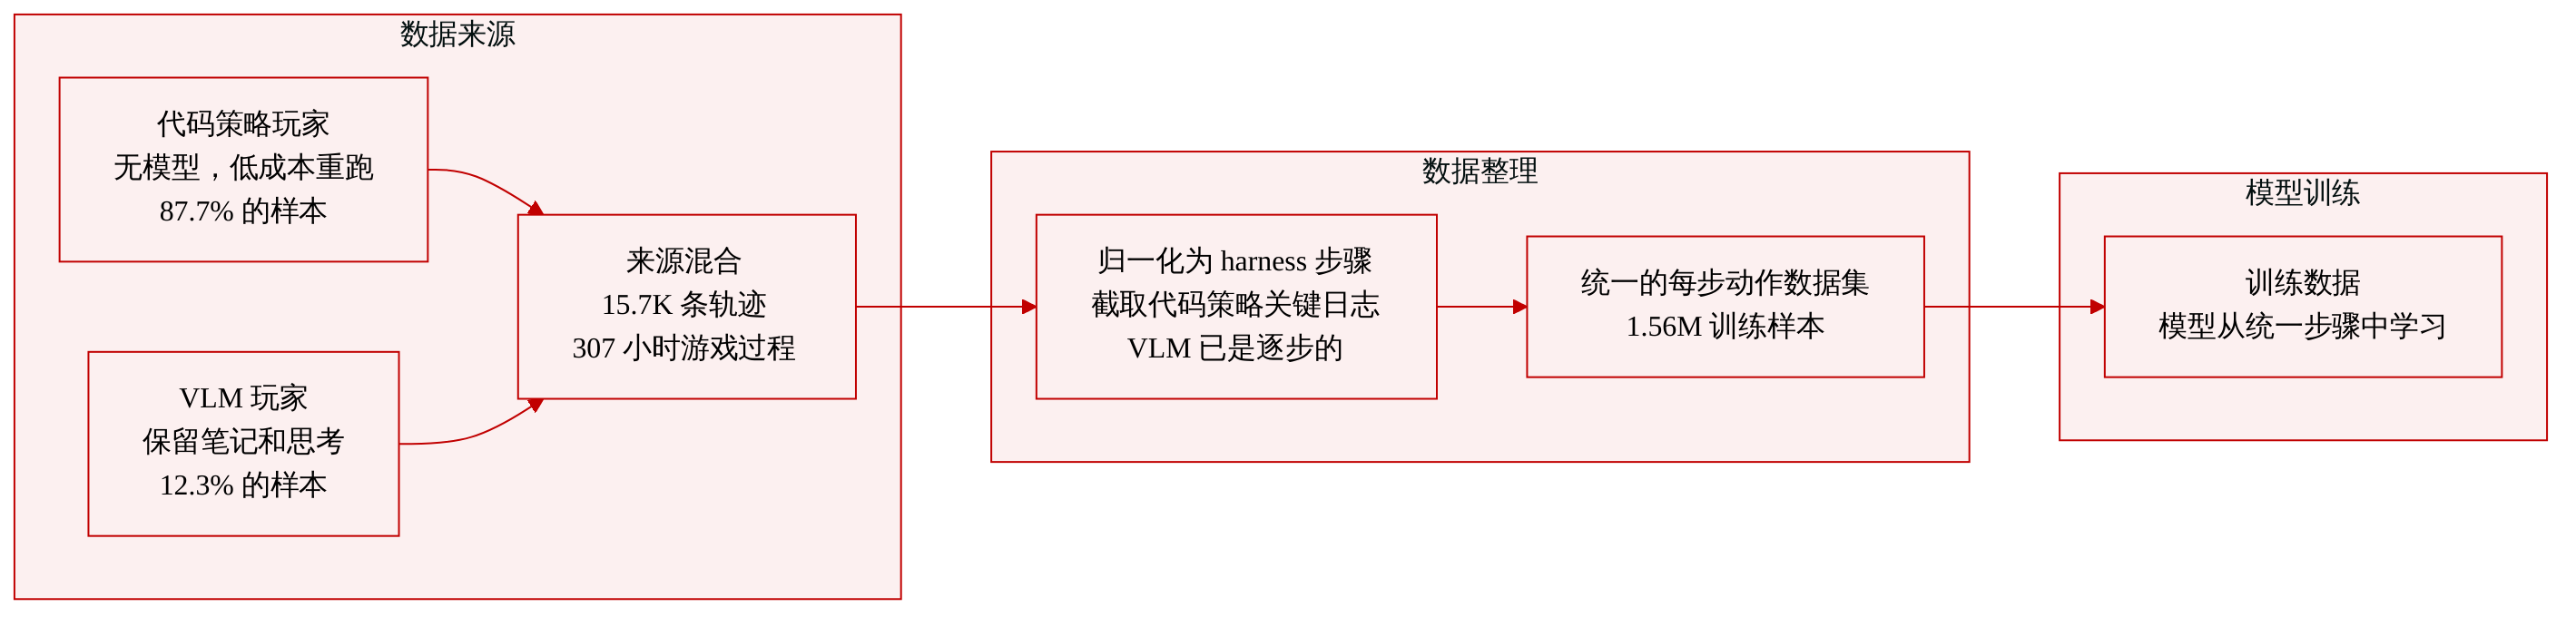
作者在已接受的环境中从两个互补玩家收集训练游戏过程,并将数据合并为一种格式。
来源:
- Code policy player:不调用模型进行游戏,因此可以从新种子以低成本重跑。它提供了大多数示例。
- VLM Player:保留模型笔记和思考,并覆盖 code policy 未完成的任务。
规模与组成:
- 总记录数据:15.7K 条轨迹和 307 小时游戏过程。
- 最终训练示例:1.56M。
- Code policy 数据贡献 87.7% 的训练示例。
- VLM Player 数据贡献 12.3% 的训练示例。
处理:
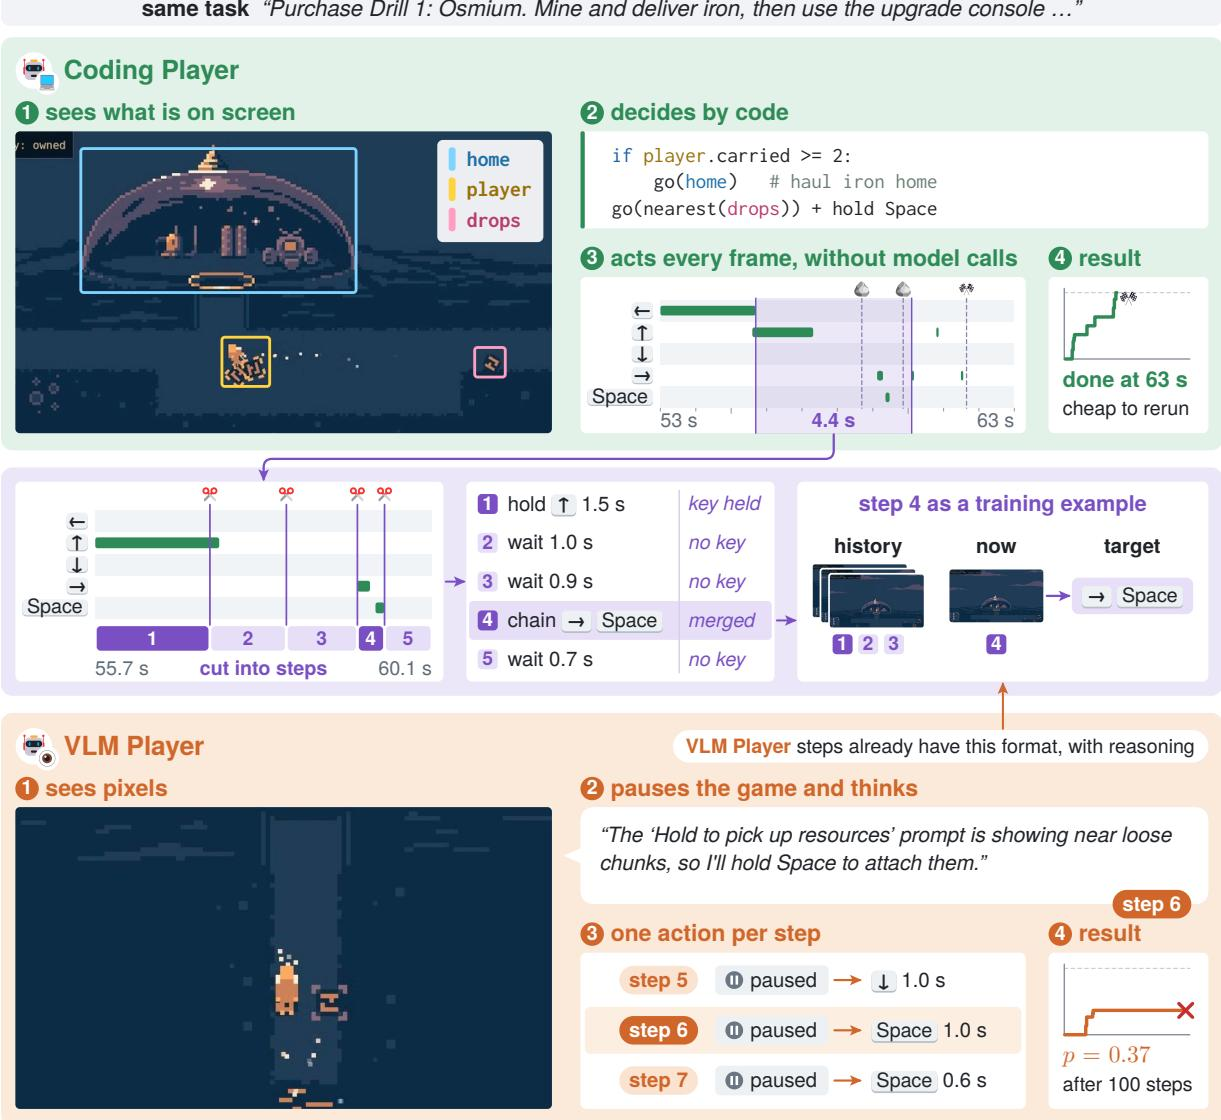
- VLM Player 片段已经遵循 harness 格式,每一步一个动作。
- Code policy 动作是连续的,因此作者将其记录切分为 harness 步骤。
- 记录器记录每次按键按下和释放及其时间戳,并将该日志转换为 harness 动作。
使用方式:
- 统一的每步一个动作数据集被用作模型的训练数据。
方法
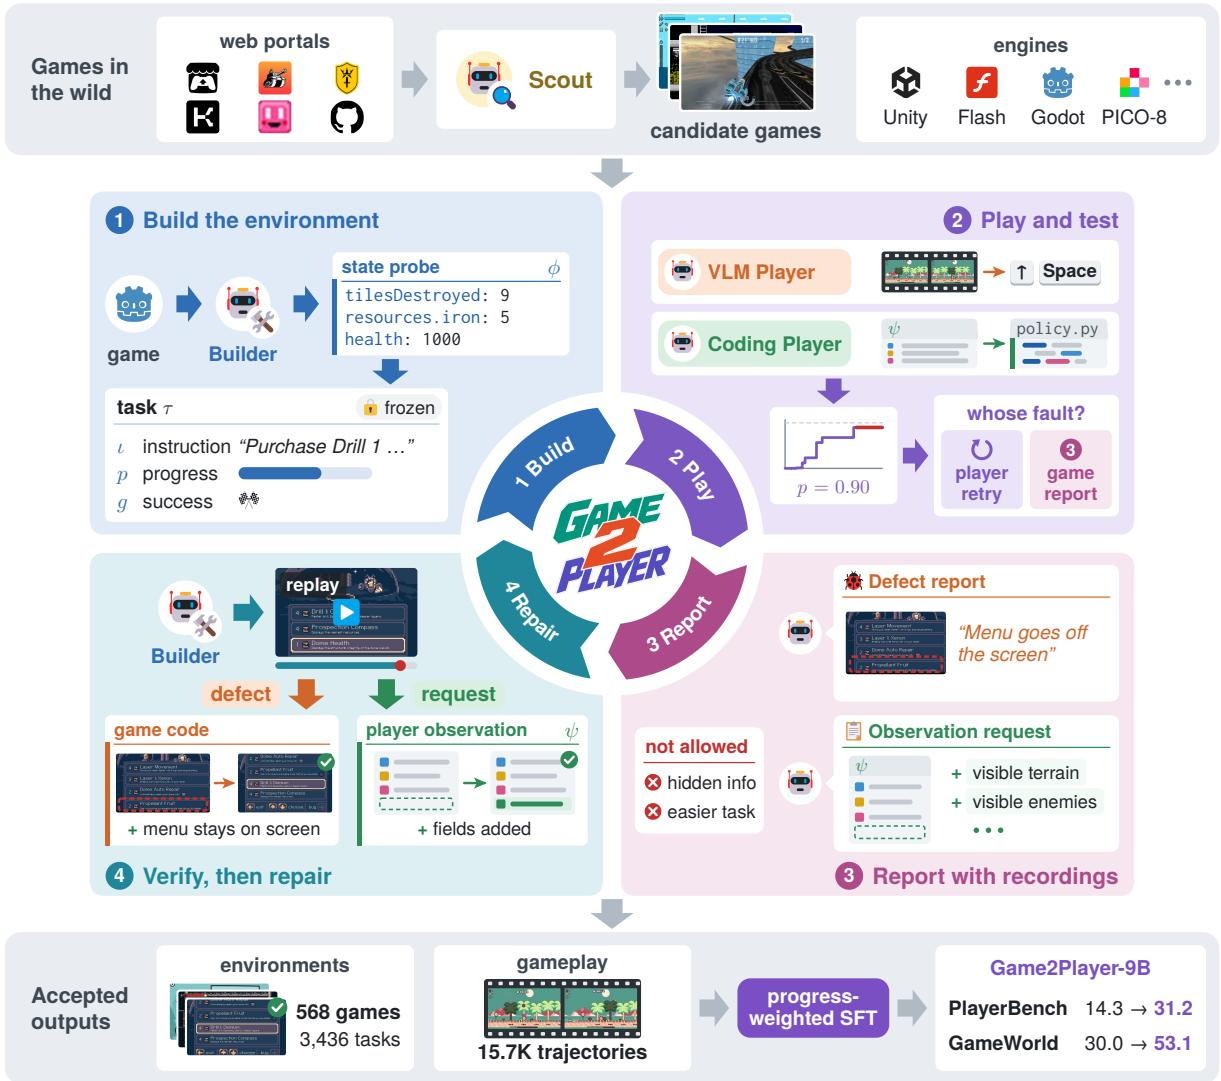
作者提出了 Game2Player,一个将开源网页游戏转换为可验证环境以训练视觉 agents 的框架。该流程从 Scout 模块开始,该模块识别可在浏览器中离线游玩的游戏。随后 Builder agent 将每个游戏转换为环境,而 VLM Player 和 Coding Player 测试并游玩其中的每个任务。
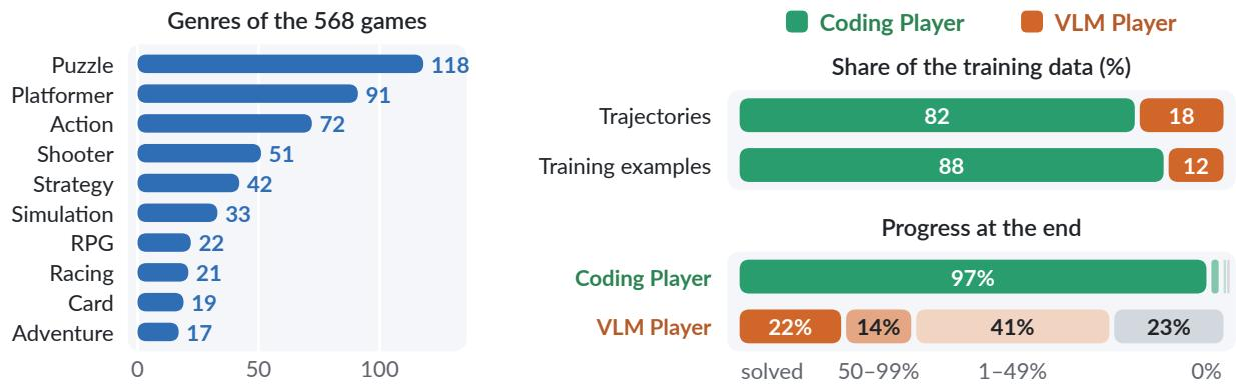
为了确保环境稳健,作者采用环境与玩家共同开发循环。Builder 首先提出任务计划,并将游戏打包用于离线游玩,定义状态探针、控制指南以及任务特定的启动例程、进度函数和成功谓词。VLM Player 仅使用截图和控制指南与游戏交互,并暂停游戏以推理动作。Coding Player 编写读取玩家可见状态并实时执行动作的 Python 策略。两个玩家测试环境并报告故障。如果玩家将故障追溯到环境,则提交缺陷报告或观察请求。Builder 随后通过重放记录的片段验证该主张。如果主张有效,Builder 修复游戏代码、状态探针或玩家观察。该循环重复直到环境被接受。所得集合涵盖多种类型和引擎,由于 Coding Player 成功率高,它提供了大多数训练示例。
一旦环境被接受,两个玩家记录游戏轨迹用于训练。VLM Player 片段自然遵循逐步 harness 格式,记录截图、动作和推理笔记。然而 Coding Player 是连续动作。为统一数据,作者将 Coding Player 的连续按键按下和释放日志切分为离散 harness 步骤,以匹配 VLM Player 的格式。
最后,作者使用进度加权监督微调(SFT)训练视觉 agent。由于轨迹包含许多被动动作,作者使用记录的进度 pt 对训练示例进行加权。每个示例将 harness 上下文 xt 与目标 yt 配对。每个示例的权重 wt 计算如下:
wt∝ρt⋅max(1,ct)其中 credit ct 增加紧接在进度提升或成功之前的动作的权重,penalty ρt 降低重复动作或失败片段末尾动作的权重。为防止长游戏主导,对于具有大量示例的游戏,权重会被缩小。作者没有直接对损失进行加权,而是将每个权重随机舍入为整数重数 mt,使得 E[mt]=wt,并重新采样示例以最小化:
L(θ)=−t∑mtlogπθ(yt∣xt)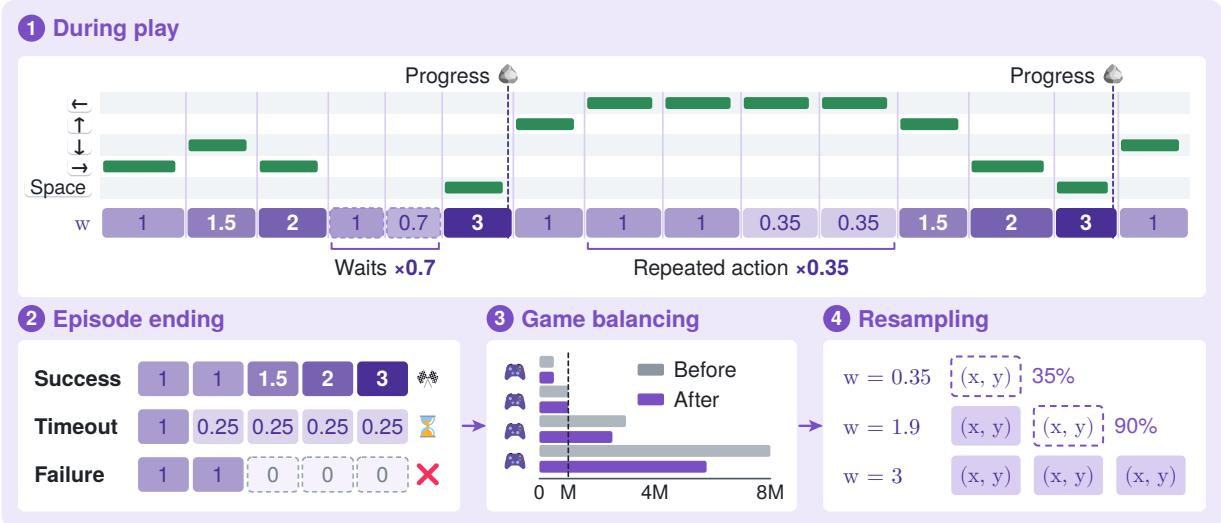
实验
评估使用 PlayerBench(从 Game2Player 集合中留出的 50 个游戏和 287 个任务)以及 GameWorld(独立构建的 34 个浏览器游戏和 170 个任务的基准)。模型被给予一次 100 步尝试,并根据进度和成功进行评分。受控的共同开发研究表明,玩家向 builder 提交报告与通用 coding agent 相比可以减少错误环境并增加已解决任务,而 code-policy 录制远比 VLM 游玩便宜。主要结果发现 PlayerBench 比 GameWorld 更具挑战性,训练大约使 PlayerBench 进度翻倍并迁移到 GameWorld,并且思考在微调后变得更有用;消融实验将收益归因于进度加权、更大的数据量以及 VLM 与 code-policy 数据之间的互补性,案例研究显示在留出任务上学到了精确的时机控制。
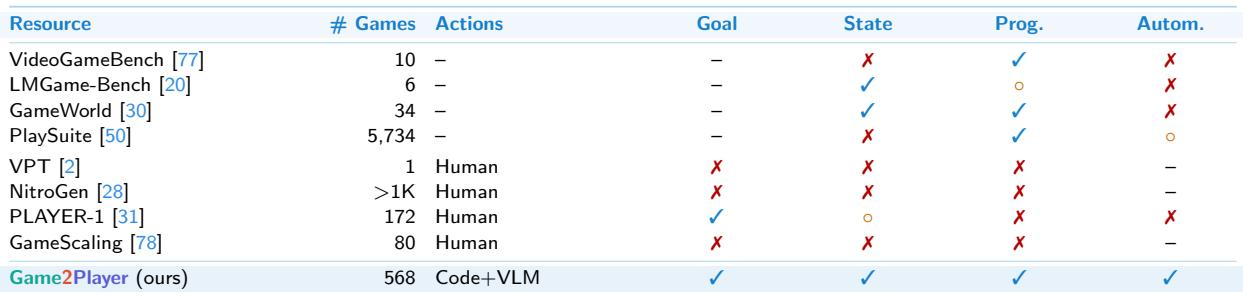
现有资源分为没有列出动作来源的基准和带有明确动作但评分有限的人类游戏数据集。基准通常跟踪中间进度,有时读取内部状态,而人类数据集通常缺乏进度信号,只有 PLAYER-1 完全携带任务指令。自动化大多缺失或仅部分存在,而 Game2Player 被描述为自动创建经过状态验证的环境,并收集携带指令且带进度评分的轨迹。游戏基准和人类游戏数据集区分清晰:基准不列出动作来源,而人类数据集提供明确的人类动作。中间进度评分在基准中很常见,但在比较中的三个人类游戏数据集中均不存在。GameWorld 是唯一同时具有内部状态评分和中间进度评分的基准。自动化在这些资源中很少见,只有 PlaySuite 部分自动化,而 Game2Player 被描述为自动构建经过状态验证的环境。
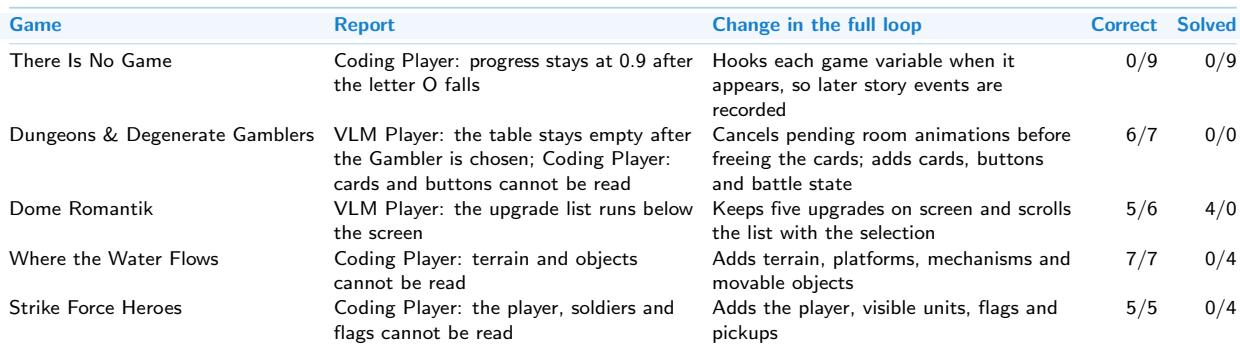
完整的报告与修复循环相比无报告基线改进了环境,既修复了错误任务,也使先前受阻的任务变得可解决。报告通常来自无法读取游戏状态的 Coding Player,或看到缺失或屏幕外 UI 元素的 VLM Player,修复会添加所需的状态或界面访问。收益范围从多出一个正确环境,到先前卡住的游戏中所有任务都变得正确且已解决。在 There Is No Game 中,进度停滞报告带来了变量 hooks,此后所有九个任务都正确且已解决,而无报告设置下它们全部错误。在 Where the Water Flows 和 Strike Force Heroes 中,关于不可读地形、物体、玩家和旗帜的报告带来了可见游戏状态的添加,并将已解决任务从零提高到四。在 Dungeons & Degenerate Gamblers 中,关于空桌面以及不可读卡牌和按钮的报告导致取消待处理动画并暴露卡牌、按钮和战斗状态,提高了正确环境数量。
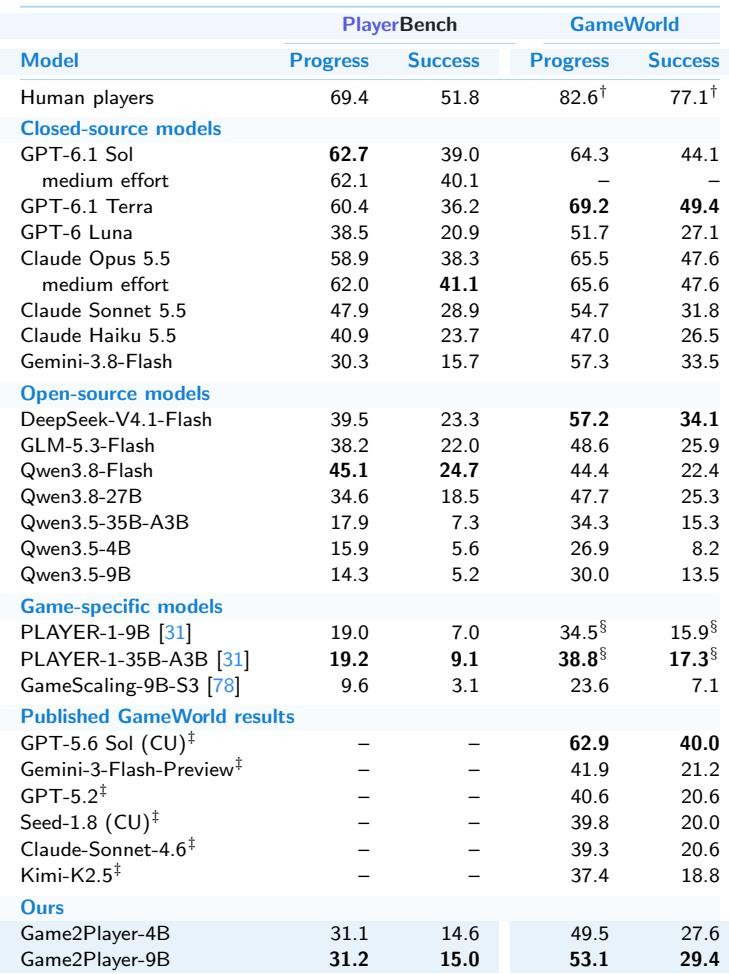
PlayerBench 始终比 GameWorld 更具挑战性,人类玩家和大多数被评估模型在其中获得的进度和成功更低。人类玩家在两个基准上都取得最高分,超过被评估的闭源模型。在闭源模型中,GPT-6.1 Sol 在 PlayerBench 上往往领先,而 GPT-6.1 Terra 在 GameWorld 上领先,GPT-6 Luna 明显落后。人类玩家在 PlayerBench 和 GameWorld 上都超过所有被评估的闭源模型。对人类和所列模型而言,GameWorld 分数通常高于 PlayerBench 分数。GPT-6.1 Sol 在闭源模型中拥有最强的 PlayerBench 进度,而 GPT-6.1 Terra 拥有最强的 GameWorld 进度。GPT-6 Luna 在所示闭源模型中在两个基准上的进度和成功均为最低。
数据来源和采样策略对两个基准的影响不同。VLM player 数据对 PlayerBench 的样本效率更高,而仅用 code policy 数据可带来最强的 GameWorld 性能,并且结合两种来源对较大模型在 PlayerBench 上有帮助。进度加权训练在两个模型规模和两个基准上都优于均匀采样,更多数据持续改善 PlayerBench,而 GameWorld 进度在早期训练步骤后进入平台期。VLM player 数据提升 PlayerBench 性能的效率远高于更大的 code policy 数据集。仅用 code policy 数据为 4B 和 9B 模型带来最佳的 GameWorld 进度。结合两种数据来源为 9B 模型带来最强的 PlayerBench 结果,而 4B 模型的组合结果介于单来源结果之间。进度加权监督微调在两个基准和两个模型规模上均优于均匀采样。更多训练数据持续改善 PlayerBench,而 GameWorld 进度在早期训练步骤后进入平台期。
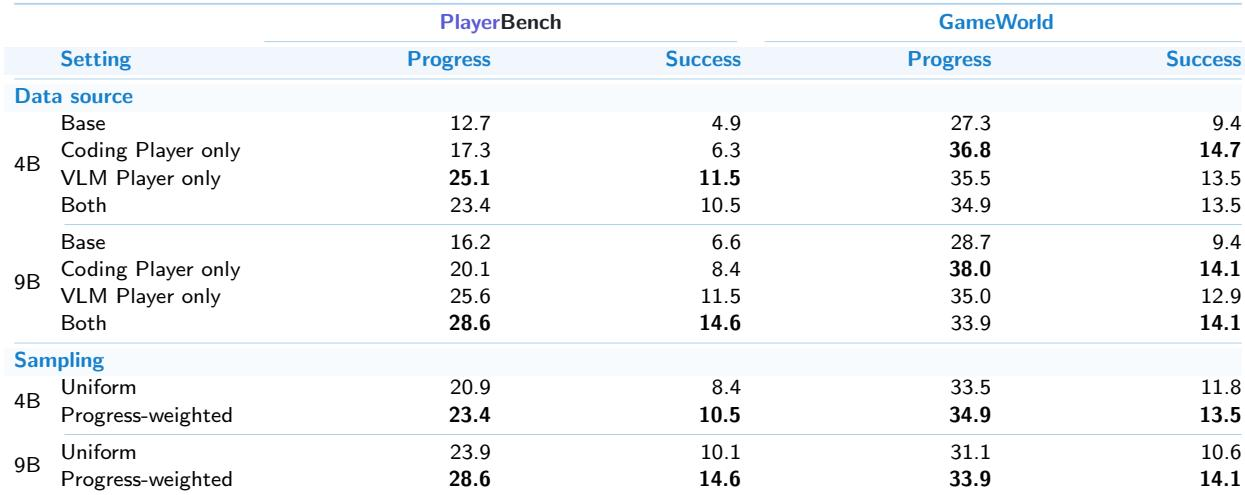
论文首先将 Game2Player 置于现有资源之中,指出基准通常缺乏明确动作来源,而人类数据集缺乏进度评分,且自动化在先前工作中很少见。随后表明报告与修复循环相比无报告基线改进了环境,通过修复错误任务并使先前受阻的游戏变得可解决,通常通过暴露缺失的游戏状态或界面访问。评估表明 PlayerBench 始终比 GameWorld 更具挑战性,人类玩家超过所有闭源模型,而数据来源和采样研究表明 VLM 数据对 PlayerBench 的样本效率更高,仅用 code policy 数据对 GameWorld 最佳,结合来源仅对较大模型在 PlayerBench 上有帮助,并且在 GameWorld 进度早期进入平台期的情况下,进度加权训练优于均匀采样。