Command Palette
Search for a command to run...
从 TeleChat 到 Xing 4:在国产芯片与框架上推进前沿智能体模型
从 TeleChat 到 Xing 4:在国产芯片与框架上推进前沿智能体模型
摘要
我们提出 Xing 4 系列大语言模型,通过在 Ascend 上的模型架构与训练基础设施协同进步,延续 TeleChat 谱系。尽管大多数开源模型在 GPU 上训练,但在国产芯片与框架上扩展规模带来了显著的系统性挑战。本报告阐述了该系列背后的设计原则与系统工程,涵盖架构选择、大规模预训练以及推理与智能体后训练。我们研究了稀疏激活、注意力设计、模型深度与宽度以及投机解码如何在模型容量与计算、内存访问和执行开销之间取得平衡。代表性配置将 MLA 与 DSA 及跨层 IndexShare 相结合以支持长上下文服务,引入优化的 MHC 算子以增强稳定性与计算效率,采用更宽更浅的混合专家(MoE)拓扑,并将分块草稿模型与轻量级校正头配对用于投机解码。我们已开源一个 29B MoE 成员,该模型完全在 Ascend NPU 上使用 MindSpore 训练,每个 token 仅激活 4B 参数,同时原生支持 256K token 上下文。我们的预训练基础设施基于 MindSpore HyperParallel,结合了拓扑感知的混合分片、高效的分布式优化器执行,以及长序列工作负载与激活内存的协同管理。CPU 亲和性与核心隔离进一步降低了宿主调度干扰。这些机制共同支撑了一个 285B 参数模型在来自大规模生产集群的 8192 张 Ascend 910C 卡上的预训练,为架构与系统研究提供了具体环境。测量结果显示,相比仅使用 MLA 的基线,预填充吞吐量提升高达 4.68 倍,投机解码带来 2.67 倍至 3.77 倍的解码吞吐量提升,消除流水线并行后吞吐量提升 16.1%。在后训练方面,我们引入了 TeleGym,一个统一的智能体执行平台,将执行、评估和轨迹构建与策略优化相连接。解耦的异步执行、有界过采样和部分 rollout 适应了异构任务时长,同时在策略更新之间保持轨迹连续性。这些进展共同为 Xing 4 在模型规模以及日益严苛的推理与智能体工作负载上的持续发展奠定了面向 Ascend 的训练基础。开源的 29B 成员以及正在进行的万亿参数训练进一步在 Ascend 与 MindSpore 生态中拓展了该系列。
一句话总结
来自星辰 AGI 实验室、中国电信、华为和哈尔滨工业大学(深圳)的研究人员介绍了 Xing 4,这是一个由 TeleChat 衍生的 agentic 模型系列,在昇腾 NPU 和 MindSpore 上训练,结合了 MLA、DSA、跨层 IndexShare、优化的 MHC 算子、更宽更浅的混合专家拓扑,以及带轻量校正头的逐块推测解码;开源的 29B MoE 成员每个 token 仅激活 4B 参数,原生支持 256K token 上下文,预填充吞吐最高提升 4.68 倍,推测解码带来 2.67 倍至 3.77 倍的解码吞吐提升,消除流水线并行使吞吐提升 16.1%;TeleGym 通过分离式异步执行、有界过采样和部分 rollout 支持 Agent 后训练。
核心贡献
- 该论文贡献了 Xing 4 模型系列的协调架构与解码设计,将 MLA 与 DSA、跨层 IndexShare 结合用于长上下文服务,并包含优化的 MHC 算子、更宽更浅的 MoE 拓扑,以及用于推测解码的逐块草稿模型与轻量校正头。完全在昇腾 NPU 上训练的开源 29B MoE 成员每个 token 激活 4B 参数,原生支持 256K token 上下文;测量结果显示,相比仅 MLA 基线,预填充吞吐最高提升 4.68 倍,推测解码带来 2.67 倍至 3.77 倍的解码吞吐提升,消除流水线并行使吞吐提升 16.1%。
- 该工作贡献了一个面向昇腾的大规模预训练系统,构建于 MindSpore HyperParallel 之上,集成了拓扑感知混合分片、基于 owner 的 Muon 执行、长序列负载均衡、KV 压缩、激活内存管理以及 CPU 亲和性与核心隔离。该系统通过在 8192 张昇腾 910C 卡上预训练 285B 参数 MoE 模型得到验证。
- 该工作提出了 TeleGym,一个统一的 Agent 执行平台,将执行、评估和轨迹构建连接到策略优化,利用分离式异步执行、有界过采样和部分 rollout 来适应异构任务时长,同时在策略更新之间保持轨迹连续性。
引言
Xing 4 系列扩展了 TeleChat 大语言模型家族,基于此前的预训练、指令微调、推理和混合专家工作,面向昇腾和 MindSpore 生态中的长上下文推理、代码生成及 agentic 应用。扩展此类模型会引入实际瓶颈:更大的模型容量必须与每个 token 的计算量以及存储、通信和更新完整模型的成本相平衡;长上下文注意力会增加索引、KV 访问和激活内存成本;打包文档还可能造成计算负载不均;主机调度或任务时长差异可能使训练和强化学习停滞。作者通过面向昇腾的架构设计来应对这些挑战,该设计联合考虑稀疏激活、压缩 KV 注意力、深度-宽度权衡和推测解码;还构建了具备拓扑感知分片、基于 owner 的 Muon 优化、长序列负载均衡和 CPU 调度控制的预训练系统;以及 TeleGym,一个用于推理、代码和多轮 Agent 任务的统一异步强化学习平台。
数据集
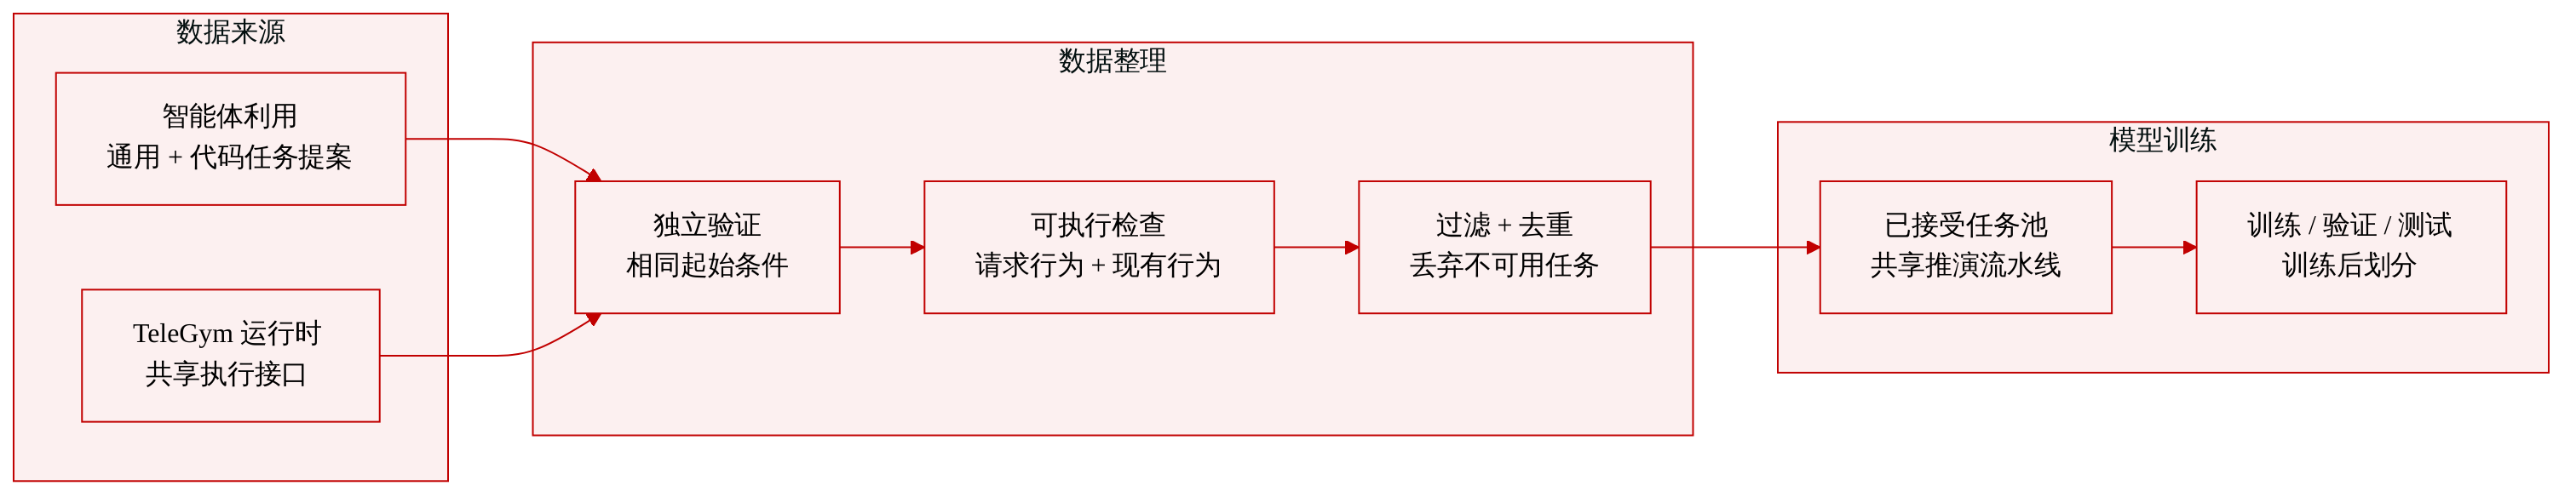
作者描述了一个用于通用 Agent 和代码 Agent 后训练的合成任务数据集。该数据集并非来自静态语料库,而是由多个 agent harness 提出、细化、验证和去重任务,执行由 TeleGym 运行时处理。
-
数据集组成与来源
- 通用 Agent 任务围绕信息检索、文档处理和工具使用构建。
- 代码 Agent 任务围绕软件项目和编程需求构建,包括实现和缺陷修复。
- 多个 harness 参与任务设计、指令细化、测试审查和验证。
-
通用 Agent 子集
- 指令与相关文件和工具接口配对。
- 涵盖单轮和多轮场景,具有不同的约束和交互步骤。
- 来自多个 harness 的反馈用于细化指令、工具需求和评估标准。
- 验证使用程序化检查或基于模型的评估,并依据共享标准进行。
-
代码 Agent 子集
- 任务从初始代码工作区和依赖配置开始。
- 共享的可执行测试验证所请求的更改以及现有功能的保留。
- 独立尝试在筛选前暴露环境问题以及任务描述与测试之间的不匹配。
-
处理与过滤
- 每个任务组合了指令、初始环境和评估标准。
- 候选任务在等效任务条件下由多个 harness 独立验证。
- 验证和去重移除了不可用或重复的示例。
- 被接受的任务通过 TeleGym 的执行接口进入共享 rollout 流水线。
-
在模型中的使用
- 被接受的任务在共享 rollout 流水线中用作通用 Agent 和代码 Agent 的可执行后训练任务。
- 文中未指定数据集大小、训练划分比例或混合比例。
- 除指令、初始环境和评估标准的任务结构外,未描述裁剪策略或明确的元数据模式。
方法
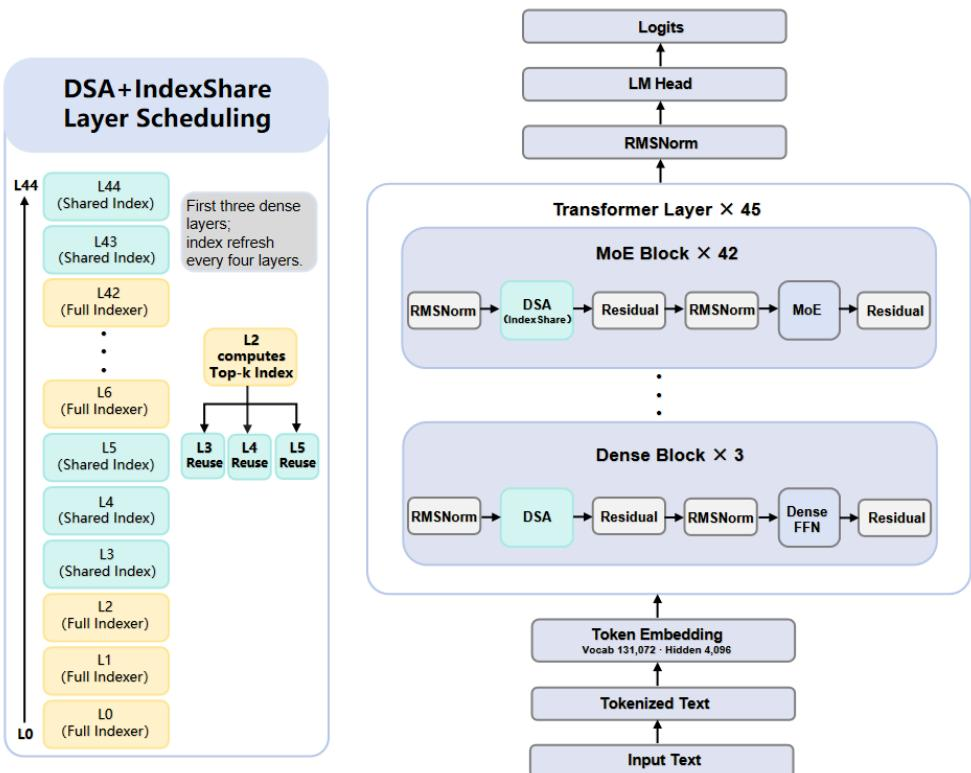
作者设计 Xing 4 架构,以在昇腾 910C 集群上平衡模型容量、长上下文执行和硬件效率。作为具体实现,285B 代表模型采用仅解码器混合专家(MoE)骨干。结构布局参见框架图。该模型由 45 个 transformer 层组成,前三层使用稠密前馈网络(FFN),其余 42 层使用 MoE FFN,通过稀疏激活扩展容量。为解决长上下文推理瓶颈,注意力机制将多头潜在注意力(MLA)与 DeepSeek 稀疏注意力(DSA)和 IndexShare 结合。MLA 压缩 KV 表示以降低缓存内存,DSA 使用 lightning indexer 选择 Top-K 历史 KV 状态。IndexShare 进一步跨层复用稀疏索引,以减少重复的索引器计算。为提升推理时效率,该架构集成 DSpark,这是一种推测解码组件,使用逐块草稿模型、轻量 Markov 头和接受置信度头,以增加每次验证器调用提交的 token 数量。
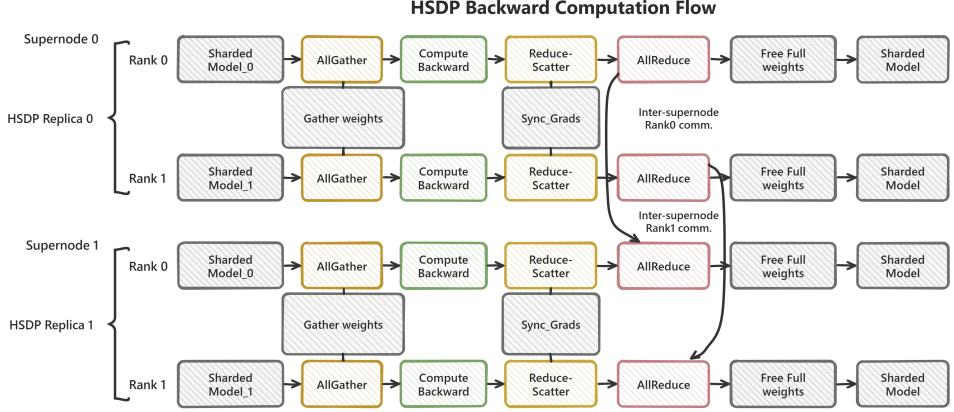
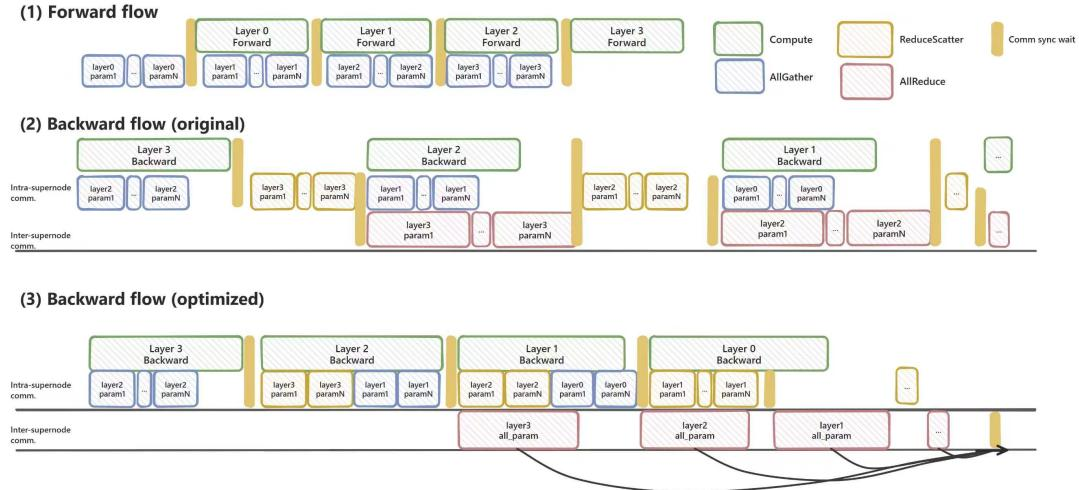
为了在不引入流水线并行固有结构气泡的情况下支持大规模预训练,作者实现了 HyperParallel-FSDP,这是一种针对昇腾 SuperPoD 架构定制的混合分片数据并行方案。模型参数在每个 SuperPoD 内进行 FSDP 分片,并在 SuperPoD 之间复制,将频繁的权重收集和分片梯度同步限制在高带宽的 SuperPoD 内部链路上。反向传播工作流见下图。
为了优化通信,HyperParallel-FSDP 消除了标准 FSDP 中使用的扁平化中间缓冲区及相关的 copy-in 和 copy-out 操作,而是直接对各个参数张量执行 AllGather 和 ReduceScatter,实现零拷贝通信,如下方对比所示。
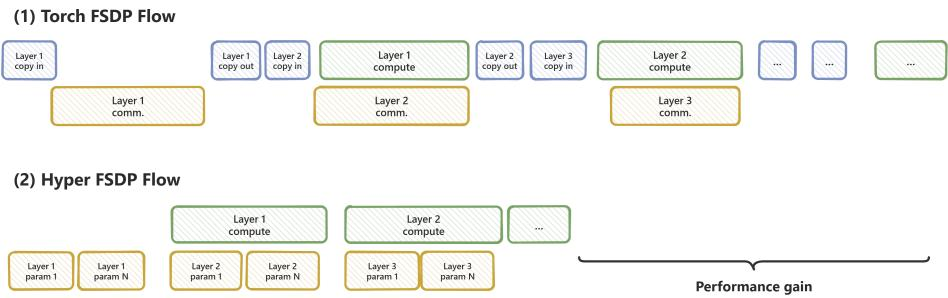
此外,系统在反向传播过程中实现了三方通信重叠策略。SuperPoD 内部的 AllGather 和 ReduceScatter 操作被异步调度并与反向计算重叠,而 SuperPoD 之间的梯度规约被延迟并融合。执行时间线展示了该优化调度如何将通信延迟隐藏在层计算之后。
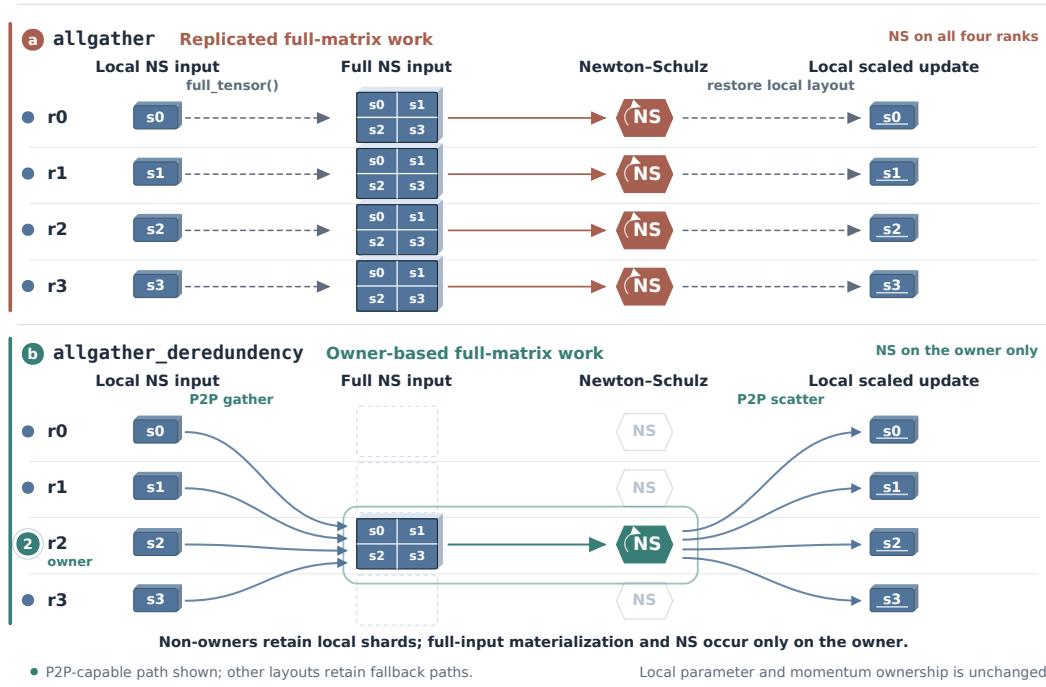
对于需要完整权重矩阵进行 Newton-Schulz 迭代的分布式 Muon 优化器,作者引入了基于 owner 的执行策略,以消除各 rank 上冗余的完整矩阵计算。在基线方法中,每个 rank 都重建完整矩阵并独立运行迭代。优化方法在每个分片组内指定单个 owner rank 执行完整矩阵计算。非 owner rank 通过点对点传输将输入分片发送给 owner。owner 汇总输入,运行 Newton-Schulz 迭代,并将缩放后的更新分片分发回去。完整矩阵工作的重新分配如下图所示。
实验
实验涵盖推测解码、分布式训练、梯度调度和主机资源管理。DSpark 在数学推理和代码生成任务上与基础配置及 MTP3 进行基准对比,结果显示通过并行逐块起草和轻量 Markov 校正提高了解码吞吐。HyperParallel-FSDP 在具有 1024 个 NPU 的集群上对 285B 参数 MoE 模型进行评估,并与流水线并行调度比较,结果表明混合分片消除了流水线气泡并改善了步时间。逐层索引器反向优化与 HSDP 加 Muon 基线进行测试,通过避免较晚的辅助图反向传播获得最大的单特性收益;CPU 绑定和核心隔离在 512 个和 8192 个加速器集群上进行评估,结果表明减少主机调度争用可提高训练吞吐,且规模越大收益越大。
同时启用 CPU 绑定和核心隔离后,在两种被测集群规模下训练吞吐均相对于基线提高。该提升在 8192 个加速器集群上大于在 512 个加速器集群上。结果将更大的收益归因于调度延迟的减少和关键路径同步等待的缩短。组合使用 CPU 绑定和核心隔离在两种集群规模下均提高了吞吐。较大集群显示出更大的相对收益,归因于调度延迟和同步等待的减少。
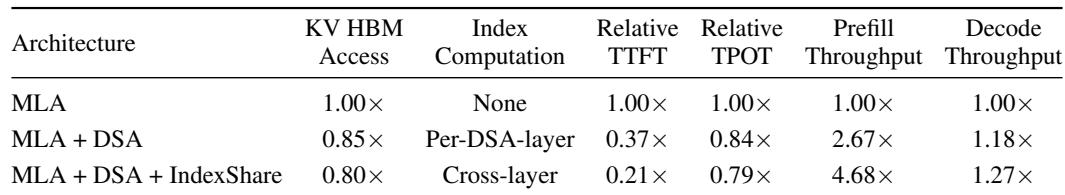
在 285B 模拟中,相对于 MLA 基线,在 MLA 中加入 DSA 可改善延迟和吞吐,同时减少 KV HBM 访问。将 DSA 与跨层索引共享相结合可获得最大收益,在变体中具有最低的首 token 时间和最高的预填充及解码吞吐。所有指标均按 MLA 基线归一化。MLA + DSA 将首 token 时间降至 MLA 基线约三分之一,并将预填充吞吐提高一倍以上。通过跨层索引共享,该变体实现最低的 KV HBM 访问和首 token 时间,同时提供最高的预填充和解码吞吐。
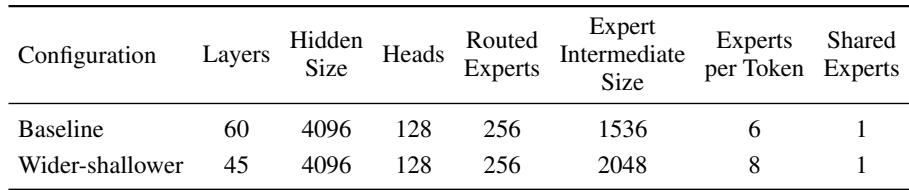
深度-宽度研究将基线配置与更宽更浅的变体进行比较。更宽更浅的模型减少了层数,但增加了每个 token 使用的专家中间层大小和专家数量。两种配置的隐藏大小、注意力头数、路由专家数和共享专家数保持不变。更宽更浅配置降低了深度,同时增加每个 token 的专家容量和专家中间层大小。两种配置的隐藏大小、注意力头数、路由专家数和共享专家数保持一致。
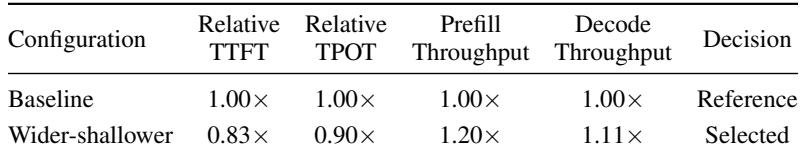
在 285B 深度-宽度对比中,所选更宽更浅配置相对于基线提高了归一化推理效率。它降低了延迟并提高了吞吐,这支持其优先于参考设计被选择。与基线相比,更宽更浅配置降低了相对首 token 时间和每个输出 token 延迟。它实现了比参考配置更高的预填充吞吐和解码吞吐。
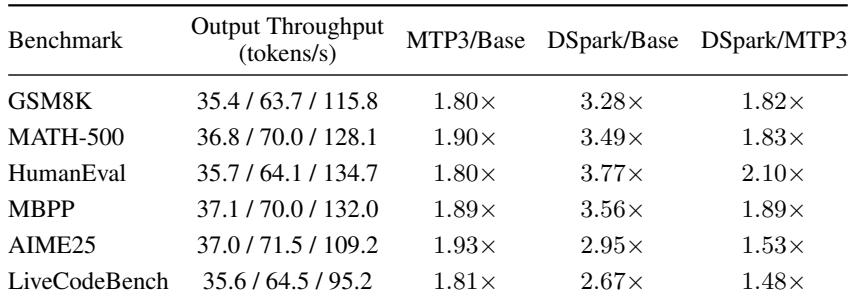
在六个数学推理和代码生成基准上,DSpark 在 285B 模型上始终取得比基础配置和 MTP3 更高的解码吞吐。MTP3 将输出吞吐相对于基础配置提升约 1.8 倍到 1.9 倍,而 DSpark 相对于基础配置达到约 2.7 倍到 3.8 倍,相对于 MTP3 达到约 1.5 倍到 2.1 倍。DSpark 的最大优势出现在 HumanEval 上,最小优势出现在 LiveCodeBench 上。DSpark 在每个基准上都提供最高的输出吞吐,相对于基础配置的加速比约为 2.7 倍到 3.8 倍。相对于 MTP3,DSpark 在 HumanEval 上获得最大的吞吐增益,在 LiveCodeBench 上获得最小的增益。
综合各项实验,该工作验证了系统和模型优化:CPU 绑定与核心隔离相结合可提高两种集群规模下的训练吞吐,较大收益归因于调度和同步延迟的减少;将 DSA 加入 MLA 并与跨层索引共享相结合,可降低 KV HBM 访问并提高预填充和解码吞吐。更宽更浅的 285B 配置相对于更深基线也降低了延迟并提高了吞吐,支持所选深度-宽度设计。在数学推理和代码生成基准上,DSpark 始终取得最高解码吞吐,优于基础配置和 MTP3。