Command Palette
Search for a command to run...
权重空间编程无需 Transformer
权重空间编程无需 Transformer
Hyunjong Ok Jaeho Lee
摘要
标准神经架构(如 Transformer)之所以被选用,是因为它们在使用梯度下降时训练效果良好,并且能在 GPU 上快速运行。在权重空间编程中,大型语言模型(LLM)手工编写目标权重,不依赖基于梯度的训练,因此上述理由不再成立。我们是否还应保留 Transformer?在仅提供少量指导、十个标注样本和一个沙盒环境、且任务主要为多项选择题的条件下,我们让三个前沿 LLM 要么生成固定架构的权重,要么自行设计架构。当可以自由设计时,三个模型都将纯文本事实编译成一个由固定程序查询的稀疏表,测试准确率最高达到 54.4%。与同一 LLM 编写的最准确的已发布 Transformer 相比,LLM 设计的模型取得了更高的测试准确率,同时使用的参数少约 1800 个。在没有梯度的情况下,它们选择了表结构;在这种结构中,LLM 可以说明每个权重的含义,并能找到并改写错误的权重。每个错误答案都指向一行,删除一行大约只会改变另一个答案。基于此,我们提出了一种基于联想记忆的模型,在 GPU 上比同等规模的 Transformer 快至 17 倍。我们还测试了预训练权重、其他基准以及模型生成答案的任务。预训练 LLM 仍然更准确;本文的主张涉及在编写权重时应构建何种结构。
一句话总结
浦项科技大学(POSTECH)的研究人员表明,在没有梯度的权重空间编程中,前沿 LLM 更倾向于稀疏联想记忆表而非 Transformer;由 LLM 设计的模型测试准确率最高达 54.4%,并且比它写出的最准确的已发布 Transformer 少用约 1800 个参数,而一种提出的联想记忆模型在 GPU 上的运行速度比同尺寸 Transformer 快最多 17 倍。
核心贡献
- 允许前沿 LLM 在没有梯度训练的情况下设计模型时,它们会收敛到由固定过程查询的稀疏表,测试准确率最高达 54.4%;由 LLM 设计的表比同一个 LLM 写出的最准确的已发布 Transformer 更准确,同时少用约 1800 个参数。
- 观察到的表结构催生了一种基于联想记忆的模型,该模型在 GPU 上的运行速度比同尺寸 Transformer 快最多 17 倍,并具有逐行可解释性:每个错误答案都指向一行,删除一行只会改变大约一个其他答案。
- 对预训练权重、其他基准、答案生成任务和低标签热启动的额外评估表明,用 100 篇带标签 AG News 文章初始化所写的网络,最高准确率达 84.7%,而随机初始化为 63.6%,不过预训练 LLM 总体上仍更准确。
引言
作者研究了权重空间编程(WSP),即大语言模型直接写出另一个模型的权重,而不进行基于梯度的训练或数据拟合。这一点很重要,因为 Transformer 在 GPU 上对梯度优化非常有效,但当权重需要被显式写出时,这一优势可能无法延续。此前关于编写或编译权重的工作通常固定目标架构,并询问能向其中写入什么,这仍未回答 Transformer 是否是 WSP 的正确结构。作者让前沿 LLM 要么为已发布架构写权重,要么从零设计目标架构。他们发现,LLM 一致地避免使用 Transformer,而是构建稀疏表查询模型:这些模型将事实存储为行,并通过固定检索来给答案打分。作者分析了为什么这种设计在没有梯度时更容易写出,并提出了一种基于联想记忆的变体,每个问题只读取固定数量的行,在保持准确率的同时提高 GPU 推理速度。
方法
作者研究了权重空间编程(WSP),这是一种由大语言模型(LLM)直接写出模型权重而不使用梯度下降的范式。在这种设定中,LLM 在一个循环中运行:它生成练习题,运行模型,检查失败,并添加规则或事实行。这个过程需要可追溯的答案和局部编辑,这些特性天然由稀疏结构而非稠密神经网络满足。
当被允许从零设计架构时,LLM 会收敛到一种特定设计:由固定过程查询的稀疏事实表。该模型将词映射为概念,并将问题和每个候选项与稀疏事实表进行匹配。它为每个选项保留最匹配的行,使用来自匹配度最高的事实的概念扩展后进行第二轮处理,并应用否定和词序规则。
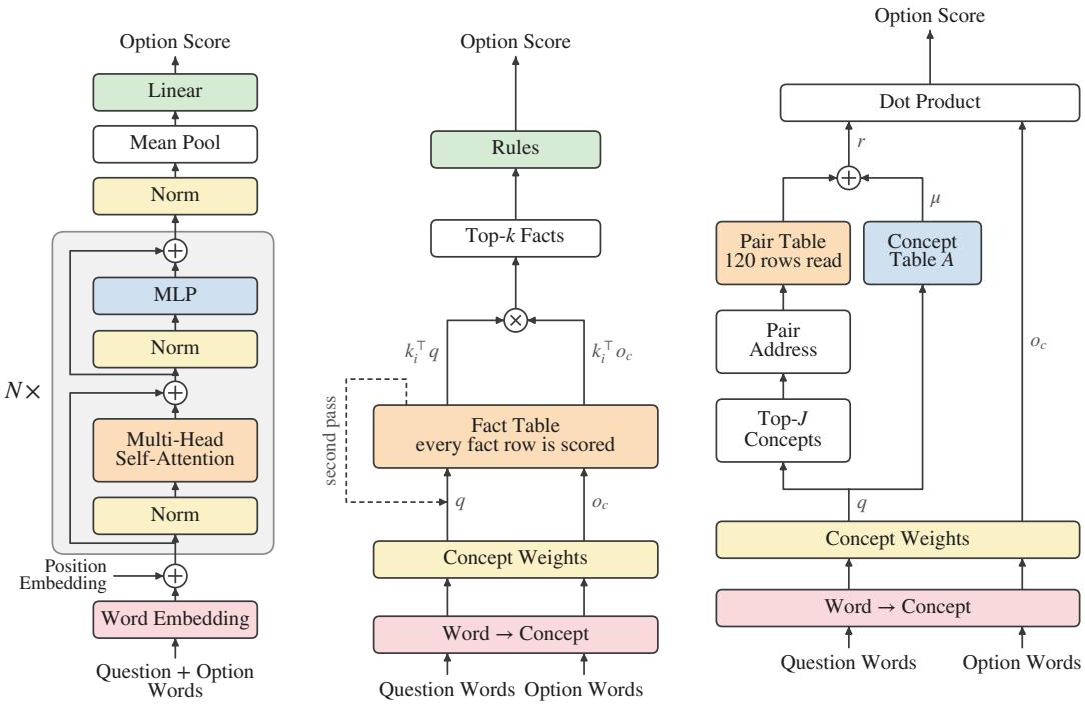
如上图所示,作者比较了标准两层 Transformer、LLM 设计的模型以及他们提出的基于联想记忆的模型。Transformer 依赖其注意力和 MLP 堆叠中的稠密矩阵,而 LLM 设计的模型使用稀疏概念向量。作者通过联想记忆的视角来阐述这一点。Transformer 回忆键 ki 与查询 x 相似的值 vi,公式为:
f(x)=i=1∑Mviσ(ki⊤x)其中 σ 是类似 softmax 的选择函数。相比之下,LLM 设计的模型用更稀疏的选择来实例化这种记忆。每个记忆 i 都是一条写出的事实,其稀疏概念向量 ki 同时作为键和值。选项 c 的分数通过将选项概念 oc 与支持度最高的事实进行匹配来计算:
sc=imax(ki⊤q)(ki⊤oc)其中 q 是问题的概念向量。
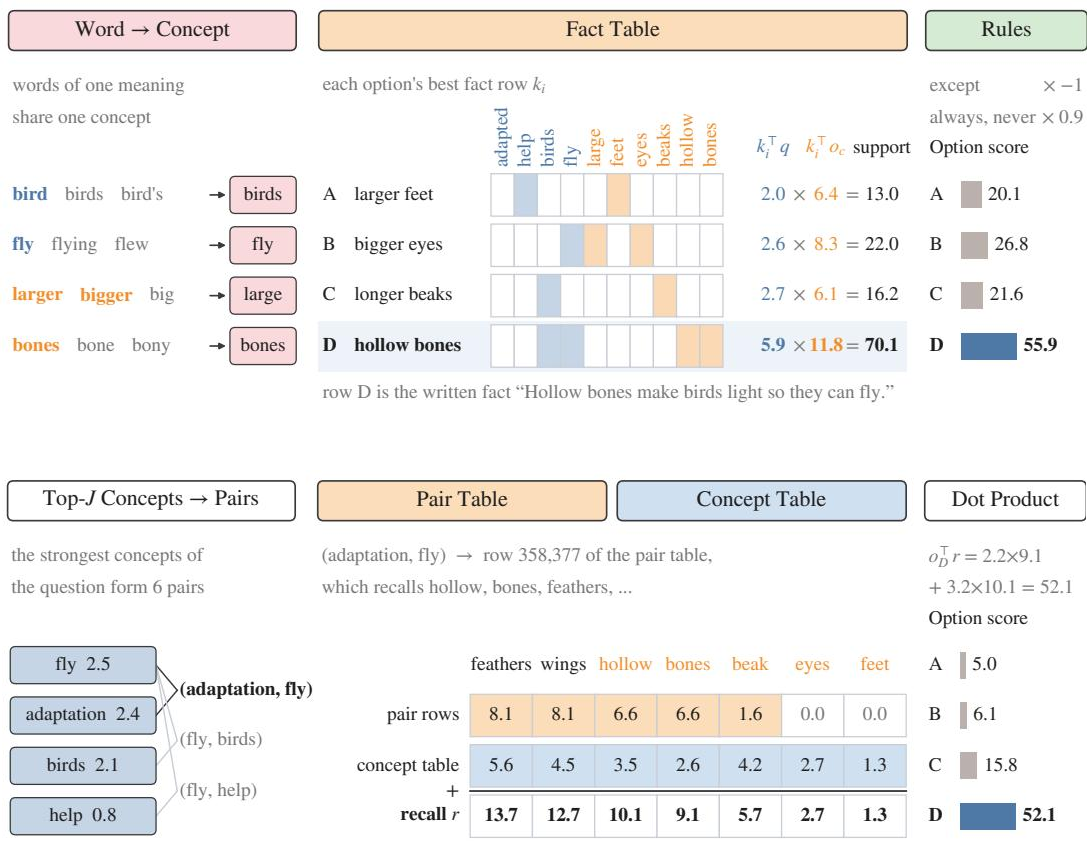
上图通过一个示例问题说明了该过程。在 LLM 设计的模型中,答案可直接追溯到特定的写出事实,例如“中空骨骼使鸟类变轻,从而能够飞行”,这会产生较高的支持分数。然而,这种设计会对每个问题都计算所有已存储事实的分数,导致推理时间随事实数量增长,并启动大量 GPU 内核。
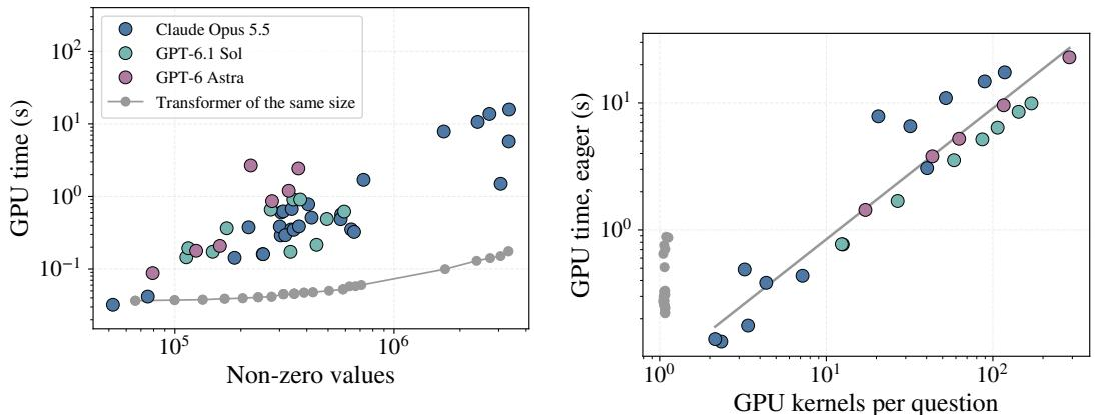
如上图所示,大多数 LLM 设计的模型在 GPU 上的运行速度比同尺寸 Transformer 慢,因为每个问题启动的内核数量很大。为了解决这个问题,作者提出一种基于联想记忆的模型,该模型保留逐行编写的方式,同时将前向过程固定为每个问题只读取固定数量的行。
该模型将编写的行编译为两个表:概念表 A(一阶记忆)和配对表(二阶记忆)。配对表存储由概念对 (a,b) 回忆的概念,并直接映射到行地址 h(a,b)=(ap+b)(modH),其中 p 为固定素数,H 为表高度。根据问题的概念向量 q,J=16 个最强概念形成一组 120 个概念对。回忆向量 r 和选项分数 sc 的计算如下:
r=(a,b)∈P(q)∑qaqbth(a,b)+μA⊤q,sc=oc⊤r其中 th 是配对表的行,μ 是混合权重。这种设计使每个问题的成本与事实数量无关,从而使模型在保持高准确率的同时,回答速度显著快于同尺寸 Transformer。
实验
实验在 3,530 道 ARC 科学选择题上评估权重空间编程,三个前沿 LLM 在固定架构或 LLM 设计的结构下编写模型,部分运行还包含谱系细化。在全部三个 LLM 中,LLM 设计的模型均优于固定架构和从随机初始化开始的梯度下降,并且它们依赖可解释的键值查找或联想记忆表,其预测主要追溯到单一事实,编辑也保持局部。进一步测试表明,这些编写出的模型可迁移到类似的科学问题、文本生成、分类和多任务设定,同时联想记忆设计提高了 GPU 效率,预训练检查点通常只被轻微编辑,或仅在接近随机水平时被覆盖。预训练微调仍然准确得多,而 LLM 设计的模型通常比同尺寸 Transformer 慢。
梯度下降在 GPU 上用优化器联合设置权重,需要可微模型、适合梯度流动的架构和大型训练集;而权重空间编程在 CPU 上用 LLM 逐行编写权重,不需要这些要求。写出的权重可追溯到可读文本,所报告的 LLM 编写的 ARC 准确率在不同代际和设计中约为 50% 到 54%。其他任务上的结果显示,在 SciQ 上表现类似中游,在原始像素 CIFAR-10 上接近随机,当有意义的语义 token 特征可用时表现更强。权重空间编程消除了对可微性、梯度流动架构和大型训练集的需求,并使权重可追溯到人类可读文本。LLM 编写的模型在 ARC 上准确率约为 50% 到 54%,在原始像素 CIFAR-10 上接近随机,但在使用语义 token 特征时显著提高。
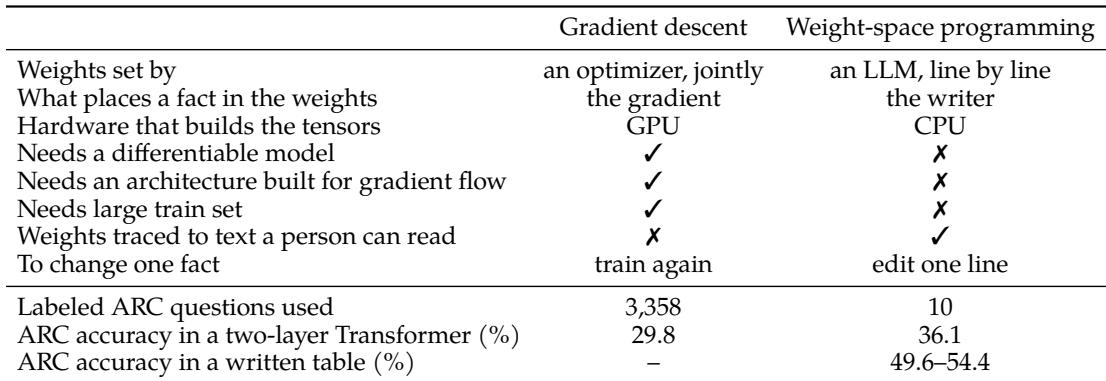
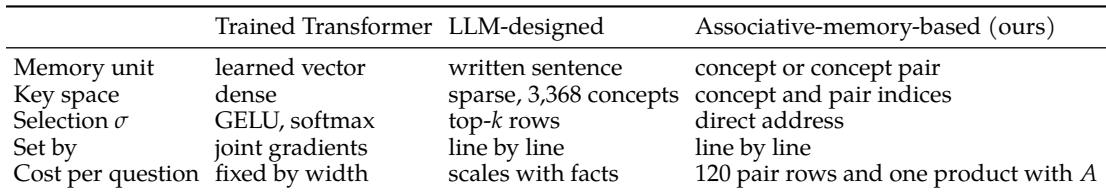
该比较将经过训练的 Transformer、LLM 设计的模型和基于联想记忆的模型视为同一个联想记忆方程的不同实例化。它们主要在记忆单元、键空间、选择机制、记忆设置方式以及每问题成本上有所不同。与经过训练的 Transformer 的稠密学习向量相比,编写的模型使用更稀疏且更可解释的记忆单元。经过训练的 Transformer 使用稠密学习向量和平滑选择,每问题成本由模型宽度固定。LLM 设计的模型使用写出的句子作为稀疏记忆,并进行 top-k 行选择;而基于联想记忆的模型使用概念和配对索引,并采用直接寻址。
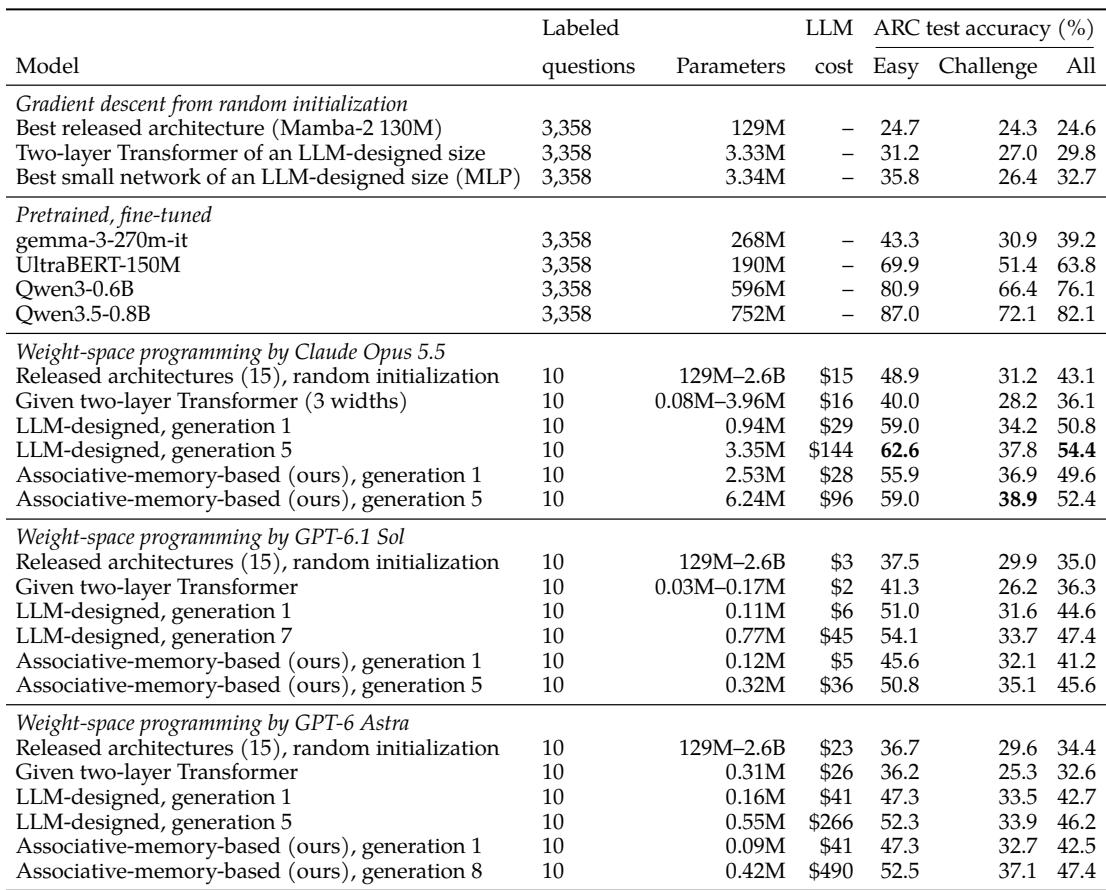
在 ARC 上,让 LLM 在权重空间中设计模型,比编写固定 Transformer 或已发布架构获得更高的准确率,同时使用的参数少得多。基于联想记忆的模型也优于固定架构,迭代细化进一步提高了准确率。预训练微调模型仍然准确得多,这为权重空间编程留下了很大差距。尽管参数少得多,LLM 设计的模型在 ARC 上的准确率仍高于从随机初始化编写的固定架构。从随机初始化开始的梯度下降使已发布架构接近随机猜测,而预训练微调模型仍遥遥领先。
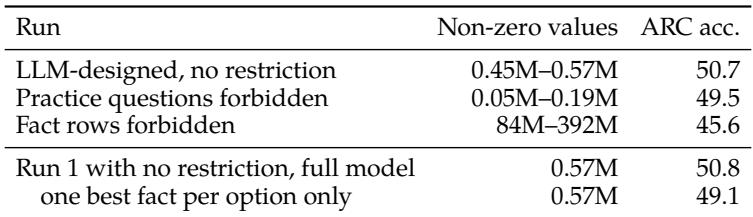
禁止练习题只使 ARC 准确率损失约一个点,因此模型并不严重依赖自行编写的类测试题。禁止事实行会使准确率损失约五个点,并使非零值增加超过 100 倍,这表明行表结构更为重要。仅根据每个选项的最佳匹配事实来打分几乎可以复现完整准确率,说明答案主要追溯到一个已存储事实。禁止练习题:准确率仅下降约一个点。禁止事实行:准确率下降约五个点,同时非零值增加超过 100 倍。仅使用每个选项的最佳匹配事实几乎与完整模型相当。
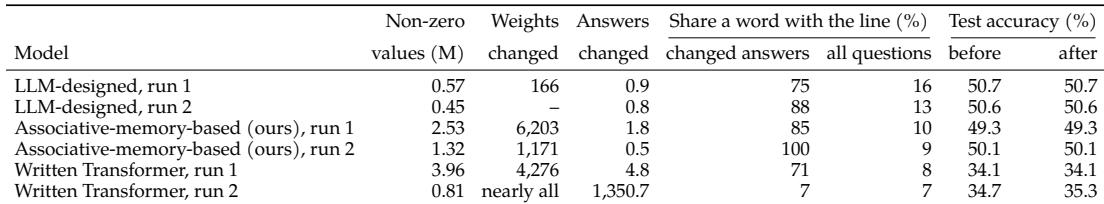
在表式模型中,删除一条编写行只会引起较小的局部答案变化,在 LLM 设计和基于联想记忆的运行中,平均大约有 0.5 到 1.8 个答案发生变化。编写出的 Transformer 运行更敏感,其中一次运行的答案变化数多出数倍,另一次运行几乎改变了所有权重和大部分答案,因为其向量编码来自同一个随机流。删除行后测试准确率基本保持稳定,表式模型中发生变化的答案往往与删除的行共享措辞。删除一条行后,LLM 设计和基于联想记忆的表模型仍然相对稳定,平均只有约 0.5 到 1.8 个答案发生变化。编写出的 Transformer 运行表现出大得多的扰动,其中一次运行中删除一条行会改变几乎全部权重和很大一部分答案。在表式模型中,大多数变化答案与删除的行共享一个词,而编写出的 Transformer 中变化答案的共享措辞不太一致。在大多数运行中,删除行前后的整体测试准确率基本保持不变。
论文评估了权重空间编程(由 LLM 直接写出模型权重),并在 ARC 和辅助任务上与梯度训练模型和固定架构进行比较。LLM 编写和联想记忆表模型达到中等 ARC 准确率,参数少得多,并具有可解释的稀疏记忆;而原始像素 CIFAR-10 除非有语义 token 特征可用,否则仍接近随机。消融实验表明,性能主要取决于已存储的事实行,而不是练习题或多事实打分;删除单个行对表模型只造成较小的局部答案变化,而编写出的 Transformer 则更脆弱。预训练微调模型仍然明显领先,为权重空间编程留下了很大差距。