Command Palette
Search for a command to run...
WeVisForensics:面向全模态 AI 生成视频检测的自进化智能体
WeVisForensics:面向全模态 AI 生成视频检测的自进化智能体
Yipeng Du Yuxi Li Ying Zhang Chong Sun Chen Li Jing Lyu Ying Tai
摘要
视频生成技术的最新进展要求基于明确取证证据的可靠检测。然而,现有方法主要依赖单次链式思维推理,容易忽略短暂或局部伪影;或依赖预定义的多智能体工作流,在选取相关检查方面灵活性有限。即使采用自适应调查,仅优化调查策略也无法直接提升固定专家的取证能力。我们提出 WeVisForensics,一个智能体框架,其中主调查智能体协调一个覆盖视觉与音频线索的自进化取证检查子智能体库。调查智能体学习检查何种伪影类型、在何种时间窗口内检查以及何时得出结论,这些交互为两个层级的智能体提供共享反馈。我们的双时间尺度策略优化策略 DTPO 通过调查智能体的快速强化学习和检查智能体的较慢细化来闭合这一回路,并以标注的伪影区间为指导,使其报告曾经忽略的细微伪影。此外,我们构建了 ForenCue-30K,结合角色特定的取证标注和交互轨迹,以监督个体检查及其协调,并配有相应的强化学习池。实验表明,WeVisForensics 在域内、域外和智能体基准上平均达到 95.2% 的检测准确率,比此前最强的检测器高出 9.0%,同时将其判断建立在局部证据之上。
一句话总结
南京大学、微信视觉和腾讯公司的研究者提出了 WeVisForensics,这是一个面向全场景 AI 生成视频检测的自进化 agentic 框架。在该框架中,主 investigator agent 协调视觉和音频线索上的取证 inspector sub-agents,并基于 ForenCue-30K 通过双时间尺度策略优化(DTPO)进行优化,以定位细微伪影并将判断建立在局部证据之上,在域内、域外和 agentic 基准上达到 95.2% 检测准确率,比此前最强检测器高 9.0%。
核心贡献
- DTPO 是一种双时间尺度策略优化算法,其中 investigator agent 通过快速强化学习进行优化,而 inspector sub-agents 则根据 investigator 发出的调用以更慢的速度更新,从而将其 rollout 轨迹转化为它们的课程。
- WeVisForensics 是一个 agentic 视频取证框架,其中主 investigator agent 在自进化的视觉和音频取证 inspector 库中自适应地调度检查。它在域内、域外和 agentic 基准上平均达到 95.2% 的检测准确率,比此前最强检测器高 9.0%。
- ForenCue-30K 是一个角色结构化数据集,具有逐角色的取证标注、已执行的 agentic 轨迹和一个强化学习池;AgenticCue 被提出作为一个基准,同时评估检测结论以及是否调用了相关 sub-agents。
引言
视频生成的进展使合成内容变得越来越逼真,因此可靠的 AI 生成视频检测现在成为一项关键的媒体取证任务,依赖细微的视觉、文本和音频伪影。此前多模态大语言模型检测器要么在单次整体判断中评估整段视频,可能漏掉短暂或空间上很小的伪影,并产生无法验证的推理依据;要么协调固定的 expert agents,但这些 agents 不会从其参与的交互中改进。作者提出了 WeVisForensics,一个 agentic 框架,其中主 investigator 自适应调度可训练的取证 inspector sub-agents,并通过双时间尺度策略优化(DTPO)与它们共同进化。作者还构建了 ForenCue-30K,一个具有已执行 agent 轨迹的角色结构化取证数据集,以及 AgenticCue,一个同时评估检测准确率和检查精度的基准。
数据集
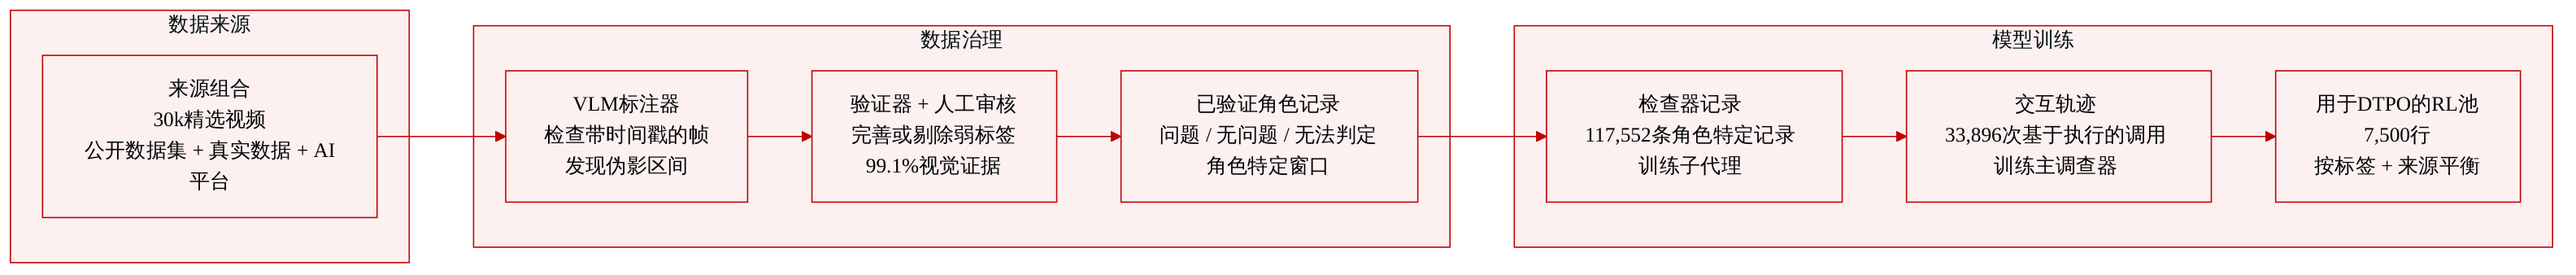
作者基于 30,000 个经过筛选的视频构建了 ForenCue-30K。其构建遵循三个原则:生成器覆盖广泛、角色对齐的取证分类体系,以及具有时间定位的证据标注。该数据集提供多级监督:117,552 条用于 sub-agent inspectors 的角色专属记录、33,896 条用于主 agent investigator 的交互轨迹,以及一个用于 DTPO 的 7,500 行 RL 池。ForenCue-30K 这一名称指核心视频监督集,扩展的标注记录、轨迹和 RL 池单独计数。
来源与组成
- 生成视频主要来自公开数据集:GenBuster-200K、RewardData、VBench-2.0 和 AIGVDBench。
- 此外还补充了来自 AI 视频生成平台和专门伪造领域的视频,包括数字人和说话人不匹配的音频伪造。
- 训练生成器包括 CogVideoX、HunyuanVideo、LTX-Video、EasyAnimate、Wan 2.1/2.2、Gen-2/3、Pika 1.5、Kling 1.0/1.5、MiniMax-Video-01、Veo 3 和 Vidu Q1。
- 真实视频来自 OpenVid-1M 和 Koala-36M,以及素材平台 Pexels 和 Pixabay。
角色标注监督记录
- 分类体系对应六种取证角色:视觉外观、物理一致性、常识、OCR 一致性、ASR 分析和音频画像。
- 报告的记录数包括:视觉外观 26,378 条,物理一致性 32,348 条,常识 40,246 条,OCR 一致性 18,580 条。
- 每条记录独立覆盖一个视角,并存储有问题、无问题或不确定的结论,以及置信度、解释和伪影的时间区间。
- 真实视频按相同格式贡献记录,因此每个角色都能看到正例和负例结果。
处理与过滤
- 一个受评分标准约束的 VLM 标注器在角色专属指南下检查带时间戳的帧,并在时间区间内定位可观察的伪影。
- 解释必须严格基于可观察的视觉证据。对于某个角色没有可见异常的生成视频,该角色记录为无问题。
- 一个跨家族的 VLM 验证器检查并细化或拒绝候选标注,以过滤幻觉解释、过度概括的常识性判断以及不精确的时间区间。
- 人工审核员检查抽样的标注,并在带声音观看片段时直接标注音频不一致。
- 在 340 条视频-角色标注的审计中,99.1% 有视觉证据支持。
Inspector 与轨迹数据
- Inspector 记录使用与 sub-agent 在推理时相同的输入:对于基于窗口的角色,为请求窗口内以 2 FPS 采样的帧;对于 OCR,为请求时间戳处的帧。
- 目标是结构化报告,包含结论、置信度和引用窗口内时间戳的解释。
- 交互轨迹通过执行驱动的合成方式构建。一个 VLM 规划器选择角色和时间范围,调用相应 inspectors,并根据实际返回的报告撰写推理。
- 面向学生的消息中会剥离仅用于训练的元数据。轨迹在四次调用预算下平均约两次调用。
- 在 100 条轨迹的人工审计中,96.0% 显示了合适的工具选择。
RL 池与质量控制
- RL 池包含来自 15 个集合和 56 个来源子集的 7,500 行数据,其中 3,750 个唯一真实片段和 3,180 个唯一生成片段按来源相关权重重复出现。
- 每个生成片段包含用于选择 inspector 调用的角色专属伪影区间,以及用于工具覆盖率奖励的已核实相关角色集合。
- 没有明确报告全局训练混合比例;RL 池通过来源相关权重平衡标签和来源。
- 导出检查会验证记录结构、角色专属字段、视频时长和采样帧可用性。
- 轨迹检查将调用标识与存储的响应匹配,执行动作预算和协议规则,并筛查仅用于训练的元数据泄漏。
- 每条轨迹保留视频和来源标识、采样帧时间戳、有序消息和目标结论。
AgenticCue 基准
- AgenticCue 与 ForenCue-30K 分离,且不与后者共享任何视频。
- 它面向更新的商业生成器,包括 Veo 3.1、Kling 2.5/3.0、Seedance 1.5/2.0、Hailuo 2.3/H3、Wan 2.6、Sora 2、Jimeng 和 HappyHorse 1.0,以及留出的数字人、换脸和声音不匹配音频伪造。
- 它包含五个取证类别:视觉、物理、OCR、常识和音频。每个类别有 500 个经验证表现出该类伪影的生成视频,并共享相同的 500 个真实视频,因此每个类别形成 1,000 个均衡视频。
- 一些片段属于多个类别:170 个片段如此,共产生 2,330 个唯一生成视频。
数据如何被使用
- 117,552 条角色专属记录用于训练 sub-agent inspectors。
- 33,896 条交互轨迹通过执行驱动的工具使用训练主 agent investigator。
- RL 池用于 DTPO,其中伪影区间为 inspector 调用选择提供依据,相关角色定义工具覆盖率奖励。
- AgenticCue 用于留出评估,报告二分类检测准确率和调用精度,而不仅仅是最终结论表现。
方法
作者利用 agentic 框架 WeVisForensics,将 AI 生成视频检测视为一种结构化调查,而不是单次感知行为。系统包括一个充当 investigator 的主 agent,以及一个由专门 inspectors 组成的 Forensic Sub-agent Library。这种设计强制将规划与感知严格分离,确保 investigator 决定检查什么和在哪里检查,而每个 inspector 在请求范围内评估特定伪影是否存在。
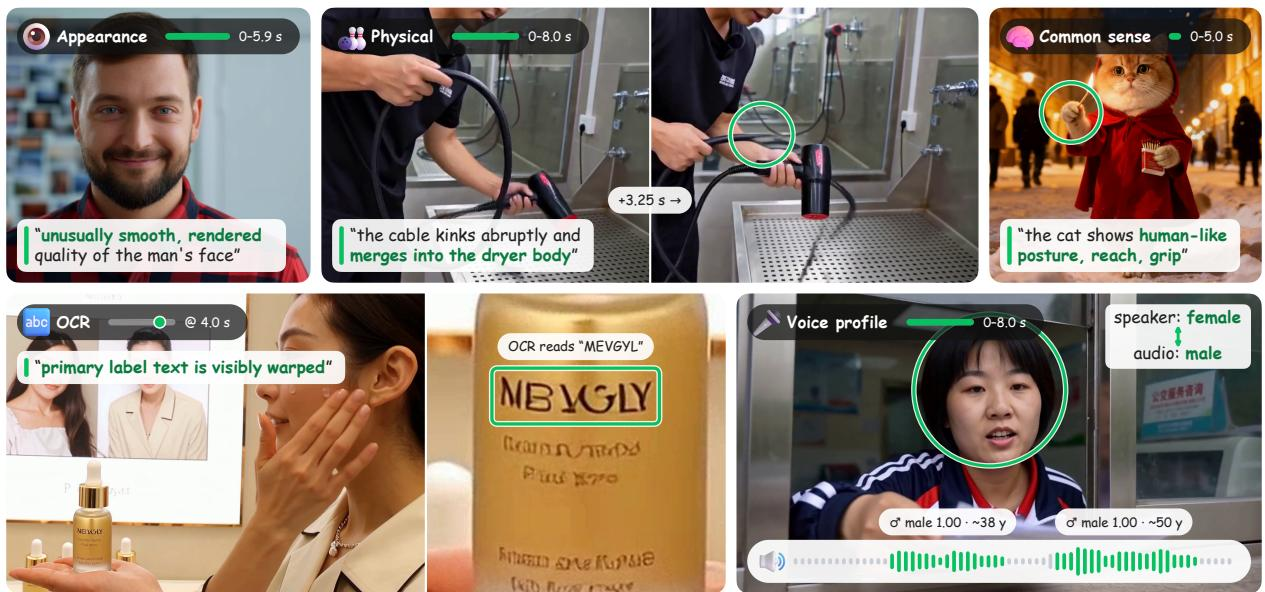
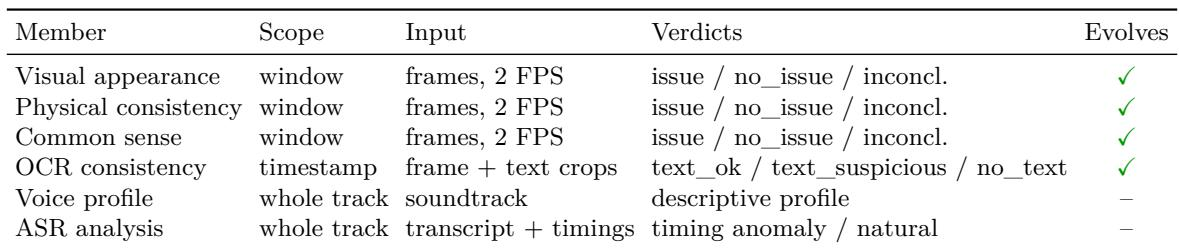
一次调查从视频的全局概览开始,总结采样帧、时长和音频存在情况。在每一轮,investigator 发出包含推理字段和动作的结构化消息。动作要么以时间或空间范围调用特定 sub-agent,要么以最终结论终止流程。协议将 investigator 限制为最多四次工具调用,以鼓励高效收集证据。sub-agent 库覆盖六种取证视角,包括四个视觉 inspectors,分别负责外观、物理一致性、常识和屏幕文字,以及两个固定音频工具,用于声音画像和 ASR 分析。每个视觉 inspector 返回结构化报告,包括结论、校准置信度和有依据的解释。OCR inspector 以三阶段流水线运行,先定位文本,再判断是否存在真实文本,最后执行裁剪级字形检查,以识别因生成而退化的字符。
为了训练这个 multi-agent 系统,作者构建了一个角色标注驱动的监督流水线,与 agent 架构相对应。筛选后的视频按每个取证角色分别标注,这些标注被转换为 inspectors 的训练记录,并执行 inspector 调用来为 investigator 组装交互轨迹。
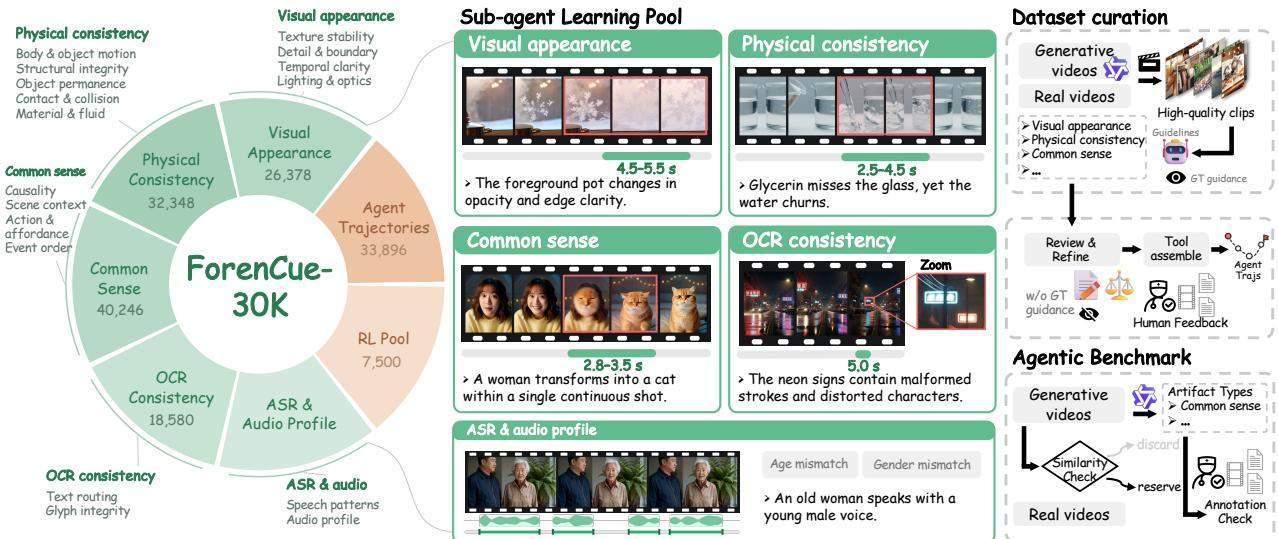
这一过程产生了一个综合数据集,提供由角色专属伪影记录、交互轨迹和强化学习池组成的多级监督。角色结构化分类体系将伪影细分为纹理稳定性、运动学运动、因果性和字形结构等细粒度维度。这确保 inspector 学会报告的证据与 investigator 学会请求和解释的证据完全一致。
训练流程分两个阶段进行。第一阶段通过监督微调初始化模型。所有 agents 共享一个冻结的骨干网络,而 investigator 和四个视觉 inspectors 作为独立的低秩适配器进行训练。这种参数化方式允许系统以单一骨干网络加轻量适配器的形式高效部署。
第二阶段采用蒸馏与轨迹策略优化(Distillation and Trajectory Policy Optimization),通过它们自身的交互共同改进 investigator 和 inspectors。快速过程使用 Group Relative Policy Optimization 更新 investigator 策略。为了解决终端奖励稀疏的问题,作者引入了调用级效用估计(Call-Level Utility Estimation),衡量冻结参考模型在每次检查调用前后对正确标签支持程度的变化。第 j 次调用的 CLUE 分数计算如下:
cj=clip(log−ℓj++ϵ−ℓj−+ϵ,−b,b)其中 ℓj− 和 ℓj+ 分别表示响应前后正确标签的对数概率。这提供了每个动作的贡献信号,使检查选择能够获得关于所产生的证据信息量的反馈。工具覆盖率奖励会进一步惩罚通过不相关检查得出正确结论的调查。
慢速过程利用特权信息蒸馏来改进 inspectors。交互调用以标注的伪影区间为依据。一个指数移动平均 teacher 模型会接收特权上下文,例如视频标签或标注区间,而 student 模型仅依赖推理时输入。该目标结合了蒸馏损失和标签校正项,标签校正项对比相反的结论,确保 inspector 纠正误报和漏报,同时不会抑制有效的不确定响应。此外,系统引入了 skill-card evolution,由一个冻结的 reflector 模型提出明确的报告规则来处理特定失效模式,例如区分运动模糊与结构缺陷。这些更新会周期性同步,使 investigator 能在 inspector 刷新之间学习,并确保 forensic sub-agent library 适应生成器分布的变化。
实验
该工作引入了 AgenticCue 基准,这是一个涵盖更新商业生成器和五个取证类别的域外评估,同时评分最终准确率以及 agent 是否调用了相关专家工具。主要实验使用 GenBuster-Bench 作为域内基准,GenBuster-Bench++ 和 MintVid 作为域外基准,并表明带工具增强检查的 WeVisForensics 比二分类检测器和 chain-of-thought MLLM 具有更好的泛化能力,尤其在基线崩溃的伪影类别上。消融实验表明,快速主策略优化和较慢的 sub-agent 进化是互补的,进化的 inspectors 产生更清晰的证据,训练后的主 agent 发出更有针对性的调用。视觉和定性示例确认,正确的假视频判断通常同时需要能够报告细微伪影的 inspector,以及能够适当权衡该证据的主策略。
forensic sub-agent library 覆盖六种角色:四个视觉 inspectors 和两个音频工具。三个视觉 inspectors 以 2 FPS 检查窗口帧,并返回有问题、无问题或不确定;OCR 在带时间戳的帧和文本裁剪上运行,返回 text_ok、text_suspicious 或 no_text。联合进化该库和主 agent 带来互补的准确率提升,进化的 inspectors 学会标记它们之前视为连贯的伪影。外观、物理一致性和常识 inspectors 共享窗口范围、2 FPS 帧输入以及有问题、无问题或不确定结论。OCR 一致性以时间戳为范围,接收帧加文本裁剪,返回 text_ok、text_suspicious 或 no_text。音频分析分为固定的声音画像成员和一个 ASR 成员,后者检查整轨转录时间是否存在自然度或时序异常。仅进化库能改进 SFT investigator,但将库与 DTPO 训练的 investigator 一起进化所提升的准确率超过两者单独收益之和。进化的 sub-agents 学会报告它们曾称为连贯的伪影,从而减少生成视频上的漏检异常,并提高 evidence F1。
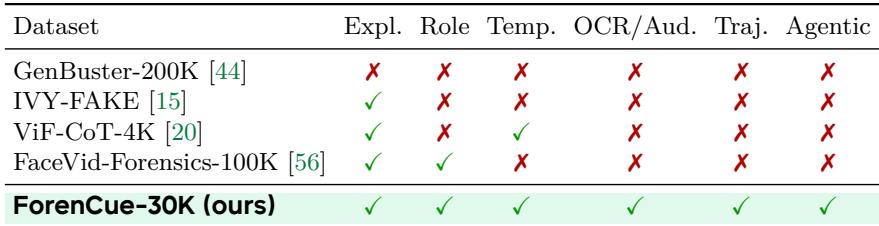
在比较的数据集中,ForenCue-30K 是最完整的取证视频训练数据集,增加了角色专属记录、时间伪影区间、OCR/音频标注、调用观察轨迹和 agentic 工具导向评估。现有数据集只提供部分监督,例如仅提供解释,或提供解释加上角色或时间标签。新增的轨迹和 agentic 信号支持主 agent 和 sub-agent 训练,超出了先前资源所能提供的范围。ForenCue-30K 是唯一包含 OCR/音频标注、调用观察轨迹和 agentic 工具导向评估的比较数据集。时间伪影区间仅出现在 ViF-CoT-4K 和 ForenCue-30K 中,而角色级标注仅出现在 FaceVid-Forensics-100K 和 ForenCue-30K 中。早期数据集只覆盖这些监督信号的子集,没有一个同时结合角色、时间、证据模态、轨迹和 agentic 标注。
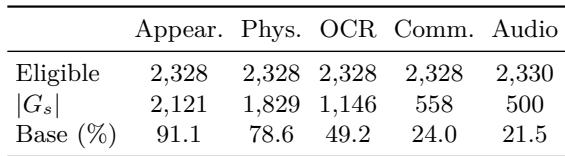
生成视频最可能需要外观检查,其次是物理检查,而 OCR、常识和音频角色则逐渐更少见。基准率显示了每个角色对应需要检查的生成视频比例,这也是对所有符合条件的视频调用专家时达到的精度。对于较少见的角色,不加区分地调用因此更加浪费,有针对性的调用变得更加重要。外观和物理伪影是最常见的角色,使不加区分地调用这些专家相对高效。OCR、常识和音频线索则少见得多,因此固定调用这些专家往往会针对并不需要它们的视频。
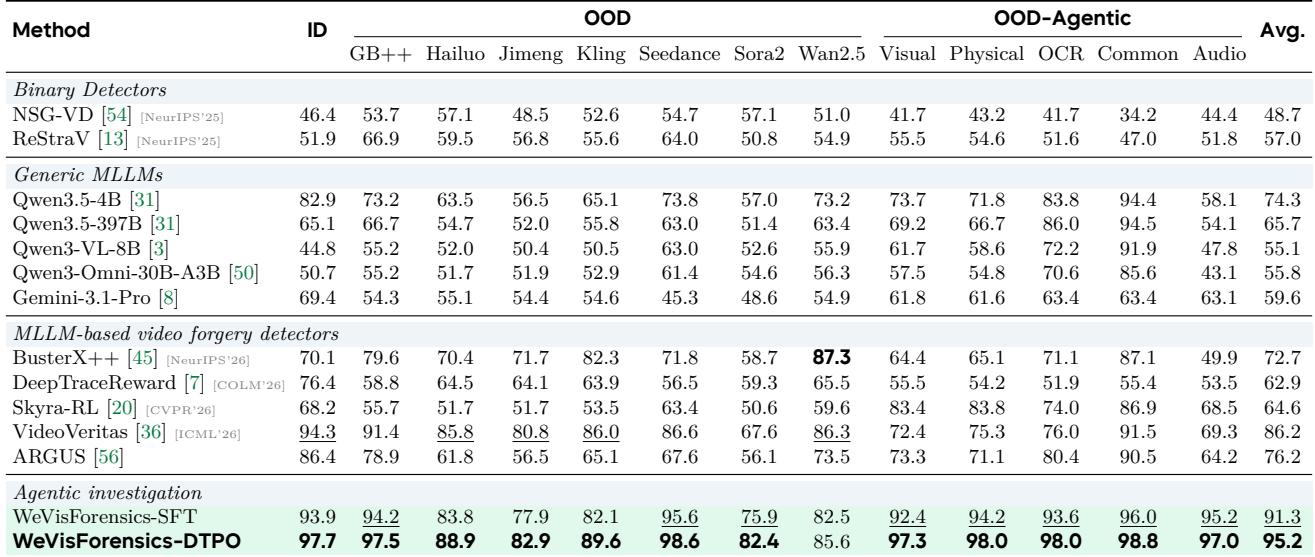
WeVisForensics 在域内、域外和 AgenticCue 评估中取得了最强的整体检测性能,优于二分类、通用 MLLM 和 chain-of-thought 基线。二分类检测器在域内数据上保持接近随机水平,而通用 MLLM 和 chain-of-thought 方法在未见生成器和细粒度伪影类别上表现挣扎。WeVisForensics 在 AgenticCue 各类别上保持较高的平衡准确率,DTPO 相比监督微调 agent 带来一致提升。WeVisForensics 在域外基准上排名第一,包括六生成器 MintVid 平均值和 AgenticCue 伪影类别。二分类检测器在域内划分上接近随机水平,在 AI 生成视频检测上效果有限。通用 MLLM 在常识违例上表现良好,但在音频和 OCR 等细粒度类别上明显下降。Chain-of-thought 检测器在未见生成器上急剧下降,并在若干 AgenticCue 伪影类别上接近随机。DTPO 在所有 AgenticCue 类别上均优于监督微调 agent,其中视觉外观和 OCR 的提升最大。
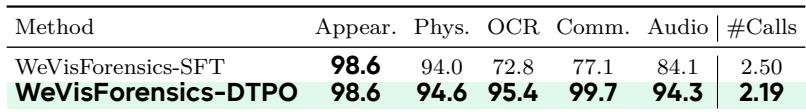
与 SFT agent 相比,DTPO 训练的 agent 在全部五个角色上匹配或提高了 sub-agent 调用精度,同时每个视频发出的工具调用更少。OCR 和常识的提升最大,外观精度保持不变。这表明 DTPO 学会了瞄准信息量大的 inspectors,而不是更频繁地调用工具。与 SFT 相比,DTPO 将 OCR 和常识的调用精度各提高了 20 个百分点以上。DTPO 每个视频使用的调用次数比 SFT 少 12.4%,同时在每个角色上达到相同或更高的精度。
实验评估了一个具有六种 sub-agent 角色的取证视频检测框架、一个名为 ForenCue-30K 的 agentic 数据集,以及一个将监督微调与 DTPO 结合的训练流程。数据集比较显示,ForenCue-30K 是唯一增加角色、时间、OCR/音频、轨迹和 agentic 工具标注的资源,而角色频率分析发现外观和物理伪影最常见,有针对性的调用对稀有角色最有用。WeVisForensics 在域内、域外和 AgenticCue 评估中优于二分类、通用 MLLM 和 chain-of-thought 基线,且 DTPO 带来一致提升。DTPO 还提高了各角色的 sub-agent 调用精度,同时减少了每个视频的工具调用,表明该 agent 学会选择信息量大的专家,而不是过度调用工具。