Command Palette
Search for a command to run...
ALIVE:让流式视频模型具备交互能力
ALIVE:让流式视频模型具备交互能力
摘要
流式视频大语言模型能够持续观察世界,但往往孤立地处理用户请求。我们提出了 ALIVE,一种支持主动监控、流式任务协调和寻求反馈式交互的交互式流式视频模型。我们构建了 ALIVE-SFT-288K 和 ALIVE-RL-3K 用于两阶段训练。对比监督微调教会模型何时以及如何回应,而结合行为对齐信用分配(BACA)的强化学习则融合轨迹级优势和局部优势,在多轮交互中优化决策、回应和静默。我们还提出了 FSI-Bench,用于评估寻求反馈及后续任务完成情况。在四个公开基准和 FSI-Bench 上,ALIVE 在所比较的模型中取得了最高的综合得分,展现出强大的流式理解和交互能力。
一句话总结
来自清华大学、北京大学、字节跳动等机构的研究人员提出 ALIVE,一个交互式流式视频模型,支持主动监控、流式任务协调和反馈寻求,并通过对比监督微调和结合行为对齐信用分配(BACA)的强化学习进行训练,以优化多轮决策、响应和沉默,在四个公开基准和 FSI-Bench 上取得最高综合得分。
核心贡献
- ALIVE 被提出为一个交互式流式视频模型,支持持续视频流中的主动监控、流式任务协调和反馈寻求交互。
- 两个训练数据集 ALIVE-SFT-288K 和 ALIVE-RL-3K 支持两阶段方法:对比监督微调教会模型何时以及如何响应,而结合行为对齐信用分配(BACA)的强化学习则在多轮交互中优化决策、响应和沉默。
- FSI-Bench 被提出用于评估反馈寻求和后续任务完成情况,ALIVE 在四个公开基准和 FSI-Bench 上在所比较模型中取得最高综合得分。
引言
大语言模型的进展正在推动对话式 AI 走向能够持续感知视频流并与用户交互的多模态交互式助手。然而,当前流式视频 LLM 在很大程度上仍是被动的:它们往往孤立地响应单个请求,缺乏维持或修改用户任务、或随事件发展主动参与的能力。这一差距限制了它们作为交互式助手基础的能力。作者围绕主动监控、流式任务协调和反馈寻求交互来构建交互式流式视频理解。他们引入了用于两阶段后训练的 ALIVE-SFT-288K 和 ALIVE-RL-3K,以及用于评估反馈寻求交互的 FSI-Bench。其 ALIVE 模型将对比监督微调与使用行为对齐信用分配的强化学习相结合,使离线视频 LLM 在保持强大视频理解能力的同时,学会管理多个任务、修改或取消任务,并在流式过程中主动寻求用户反馈。
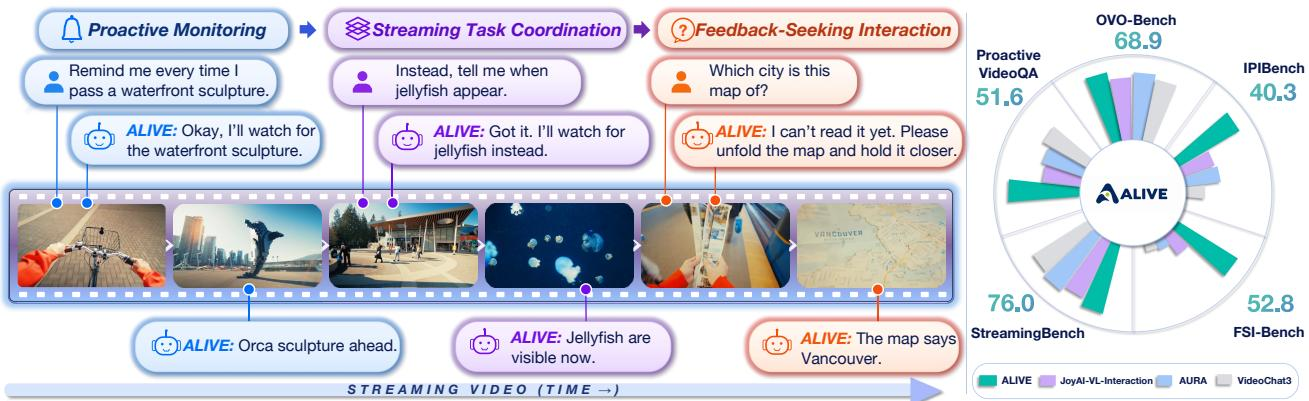
数据集
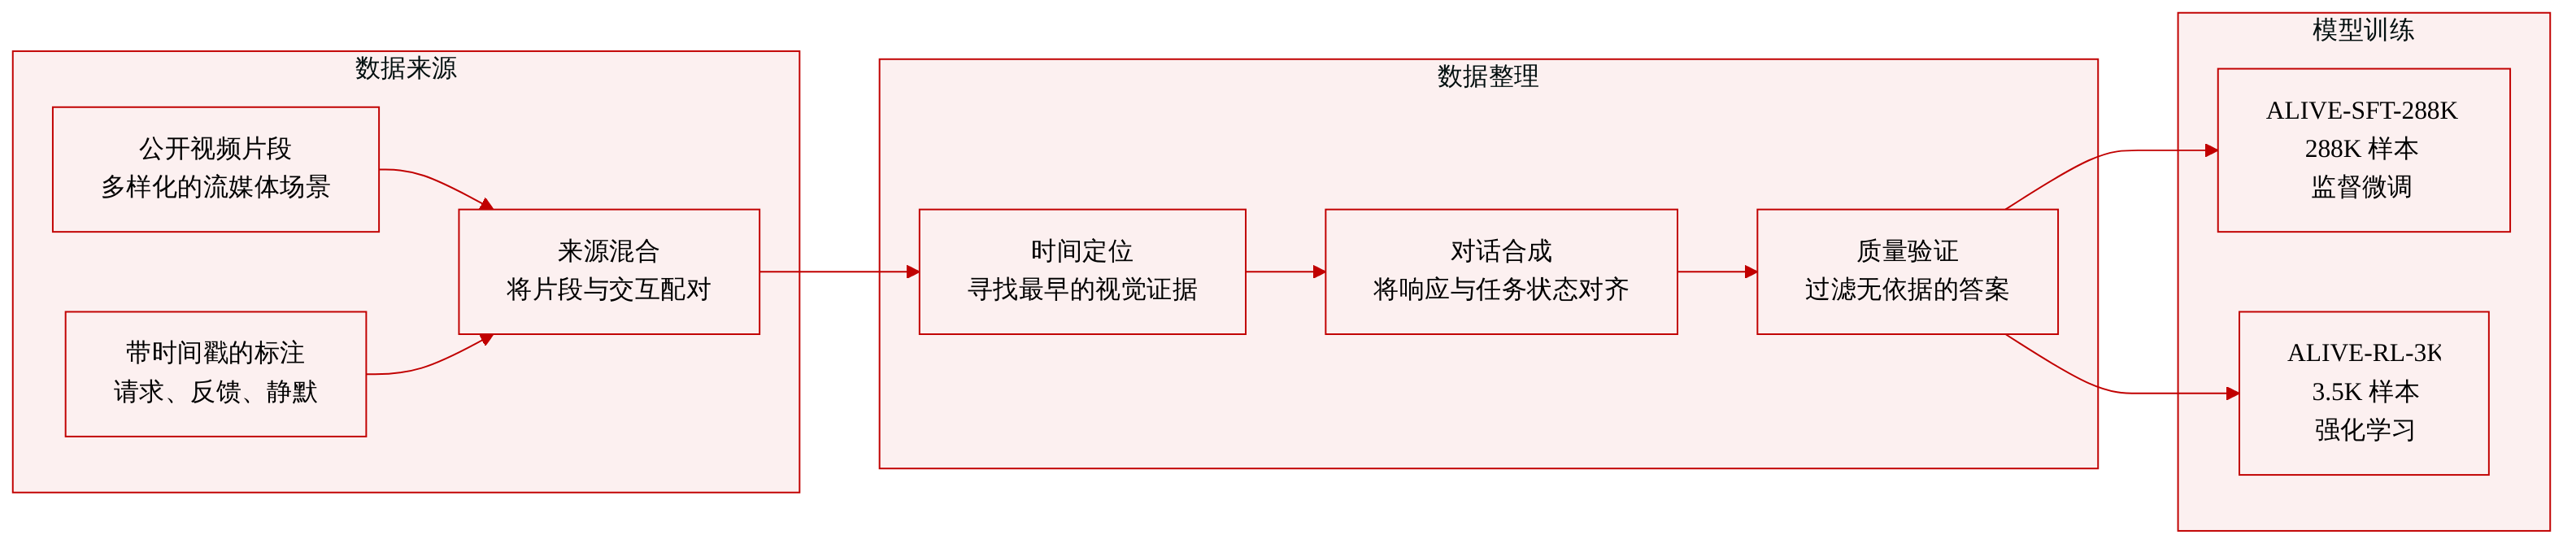
作者为流式任务构建了两个交互数据集:ALIVE-SFT-288K 和 ALIVE-RL-3K。
-
数据集组成与来源
- 由来自多个来源的公开视频片段和标注构建,包括 TimeLens2、LLaVA-Video、TimeLens、Shot2Story、VideoGPT+、VideoRefer-700K、QVHighlights、Vript、WebVid、DiDeMo、Ref-YouTube-VOS、Nymeria、EPIC-KITCHENS、Charades-Ego、Ego4D、HoloAssist、Ego-Exo4D、DenseStep2M、COIN、HACS、Charades-STA、STAR、ActivityNet 和 Oops。
- 每个示例将视频片段与带时间戳的用户请求、反馈、助手响应或沉默配对,以形成交互轨迹。
-
子集与规模
- ALIVE-SFT-288K:用于监督微调的 288,436 个交互示例。
- ALIVE-RL-3K:用于强化学习的 3,523 个交互示例。
- 两个数据集涵盖多种场景,并覆盖主动监控、流式任务协调和反馈寻求交互中的八种任务类型。
-
任务分类
- 主动监控:主动时机选择、主动理解、重复主动性。
- 流式任务协调:任务状态更新、并发请求。
- 反馈寻求交互:请求监控、请求信息、请求执行。
-
处理与过滤
- 时间证据定位与细化:在有可用信息时使用现有描述和大致时间戳。否则,先由离线 MLLM 检测相关目标并粗略定位其出现位置,然后由离线 MLLM 利用候选事件前后的视频上下文细化每个候选,识别所需视觉条件满足的最早采样时间。
- 对话合成与时间对齐:使用已定位目标和时间戳合成用户请求、助手响应、任务更新和反馈交换,并将其与不断演化的任务状态和视觉证据对齐。
- 质量验证:基于交互策略有效性和因果可回答性过滤示例。答案必须由截至指定时间戳已观察到的视频以及先前交互历史支持,不能依赖未来帧或后续用户反馈。
- 构建重点在于时间定位,而非空间裁剪。文中未描述额外的空间裁剪元数据。
-
在模型中的使用
- ALIVE-SFT-288K 用于监督微调。
- ALIVE-RL-3K 用于强化学习。
- 所提供部分未报告额外的训练混合比例或划分细节。
方法
作者构建 ALIVE-SFT-288K 和 ALIVE-RL-3K 数据集以训练交互式流式视频模型。该过程将公开视频片段与带时间戳的用户请求、反馈和助手响应配对,形成完整的交互轨迹。构建流程依次经过时间证据定位、对话合成与对齐以及严格的质量验证。
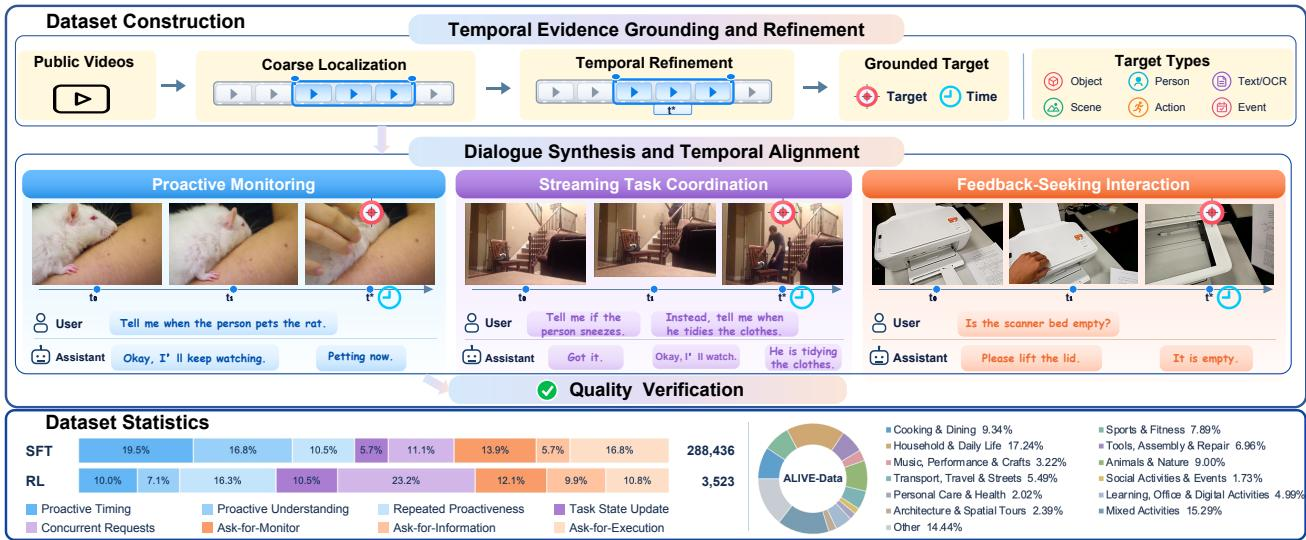
在时间证据定位与细化方面,作者利用离线多模态大语言模型检测并粗略定位相关目标。随后使用双向时间上下文细化这些候选,以识别所需视觉条件满足的最早采样时间,例如实体可识别性或动作完成。之后,对话合成与时间对齐生成将用户请求与适当助手响应配对的交互,确保每个答案都发生在必要观察或用户反馈之后。最后,质量验证过滤掉未通过交互策略有效性或因果可回答性检查的示例,确保每个答案严格由截至其指定时间戳已观察到的视频和先前交互历史支持。
为建立流式所需的条件交互行为,作者采用对比监督微调。在每个决策时刻,自回归模型生成包含控制 token 的输出,指示是响应还是保持沉默。作者构建了两个互补的受控对比族来监督这些依赖关系。响应门控对比固定视觉前缀,同时改变交互条件,例如查询相关性或任务状态,以教会模型何时响应而不是保持沉默。动作策略对比改变证据可用性或指代歧义,以教会策略选择,例如直接回答、请求澄清或请求用户执行。在交互感知训练期间,他们采样连续视觉窗口,并平衡响应与沉默监督。监督微调目标表示为:
LSFT=−∑j∈Bmjwj∑j∈Bmjwjlogpθ(yj∣x<j)其中 mj 选择受监督的 tokens,wj 是平衡响应和沉默 tokens 的相应权重,x<j 表示前面的多模态上下文。
为进一步在模型生成的轨迹上优化这些行为,作者引入结合行为对齐信用分配(BACA)的强化学习。从监督策略开始,他们按时间顺序回放视频观察和用户轮次来采样轨迹。每条轨迹获得一个奖励,该奖励评估所需交互策略、汇总任务完成情况,并施加冗余惩罚因子以降低响应过多轨迹的权重。为提供细粒度学习信号,他们构建局部行为单元,捕捉策略选择、任务响应和关键沉默。这些单元支持计算局部优势,并将其与轨迹级全局优势结合。对于特定模型调用,组合优势计算为:
Aic=AiE+αAi,u(i,c)B其中 AiE 是轨迹级优势,Ai,u(i,c)B 是所分配行为单元的局部优势,α 加权局部信号。然后使用这些组合优势优化策略,以保留对整体交互质量的监督,同时为特定行为要求提供不同的学习信号。
实验
该研究以 Qwen3-VL-8B-Instruct 初始化 ALIVE,并通过两阶段 SFT 和 RL 过程训练,在公开流式视频问答基准和新引入的用于反馈寻求交互的 FSI-Bench 上进行评估。公开基准结果表明,ALIVE 达到了最先进的整体性能,尤其在需要交互能力并适应不断变化的用户状态的任务上。在 FSI-Bench 上,ALIVE 在显式和自由形式决策协议下均优于专有和开源基线,但仍低于人类表现,表明仍有较大改进空间。消融实验确认,对比 SFT 和 BACA 局部优势机制共同改善了流式交互能力。
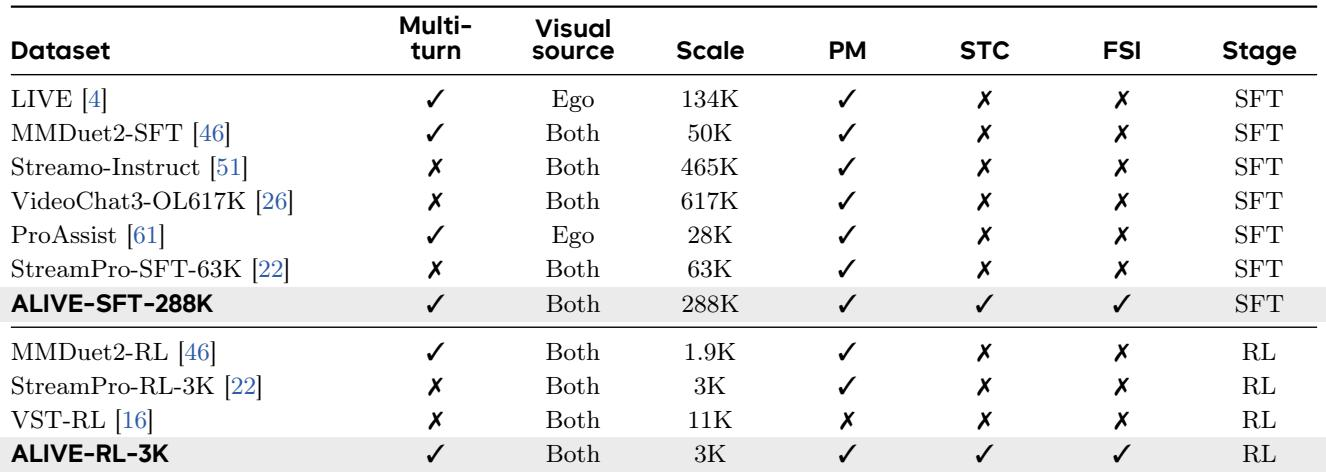
现有流式视频训练数据集普遍提供主动监控,但明确支持流式任务协调和反馈寻求交互的数据集很少。ALIVE-SFT 是所列数据集中唯一覆盖全部三种交互类型的数据集,相关 ALIVE-RL 资源将这一覆盖扩展到强化学习。各数据集在规模和多轮设计上差异很大,所有列出的条目都是监督微调资源。每个被比较的数据集都包括主动监控支持,而只有 ALIVE-SFT 明确支持流式任务协调和反馈寻求交互。ALIVE-SFT 是一个多轮数据集,其视觉来源同时来自第一人称和非第一人称场景,而若干更大的数据集并非多轮。所有列出的数据集都是监督微调资源,最大数据集的规模是最小数据集的二十多倍。
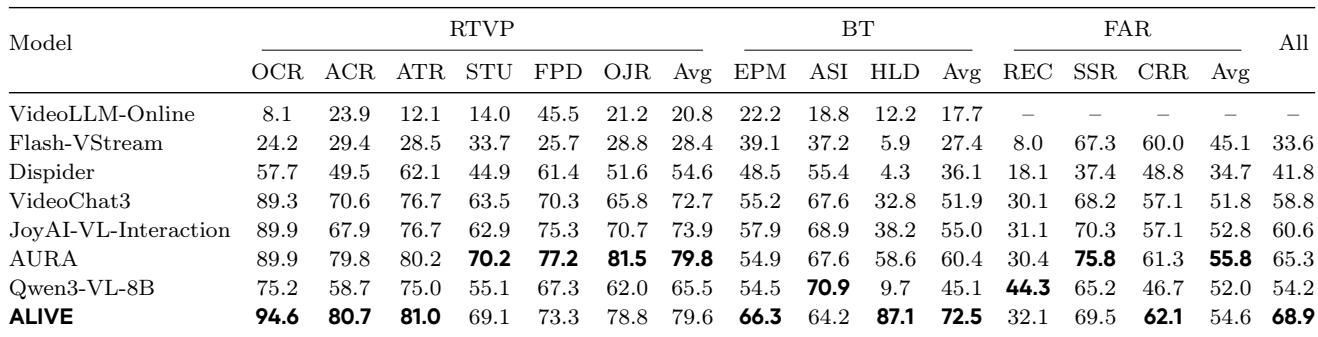
在所报告的公开流式视频基准上,ALIVE 在被比较模型中取得了最强的整体性能。基线结果差异很大,AURA 通常在所列基线中领先,而早期流式模型在实时视觉感知任务上明显落后。ALIVE 的最大提升出现在 IPIBench 上,其明显超过最强基线。ALIVE 在与所评估模型比较的全部四个公开基准上均取得最先进的整体性能。在基线中,AURA 往往最强,而 VideoLLM-Online 和 Flash-VStream 在实时视觉感知任务上得分低得多。ALIVE 相对最佳基线的最大改进发生在 IPIBench,比 AURA 高 18.7 个百分点。
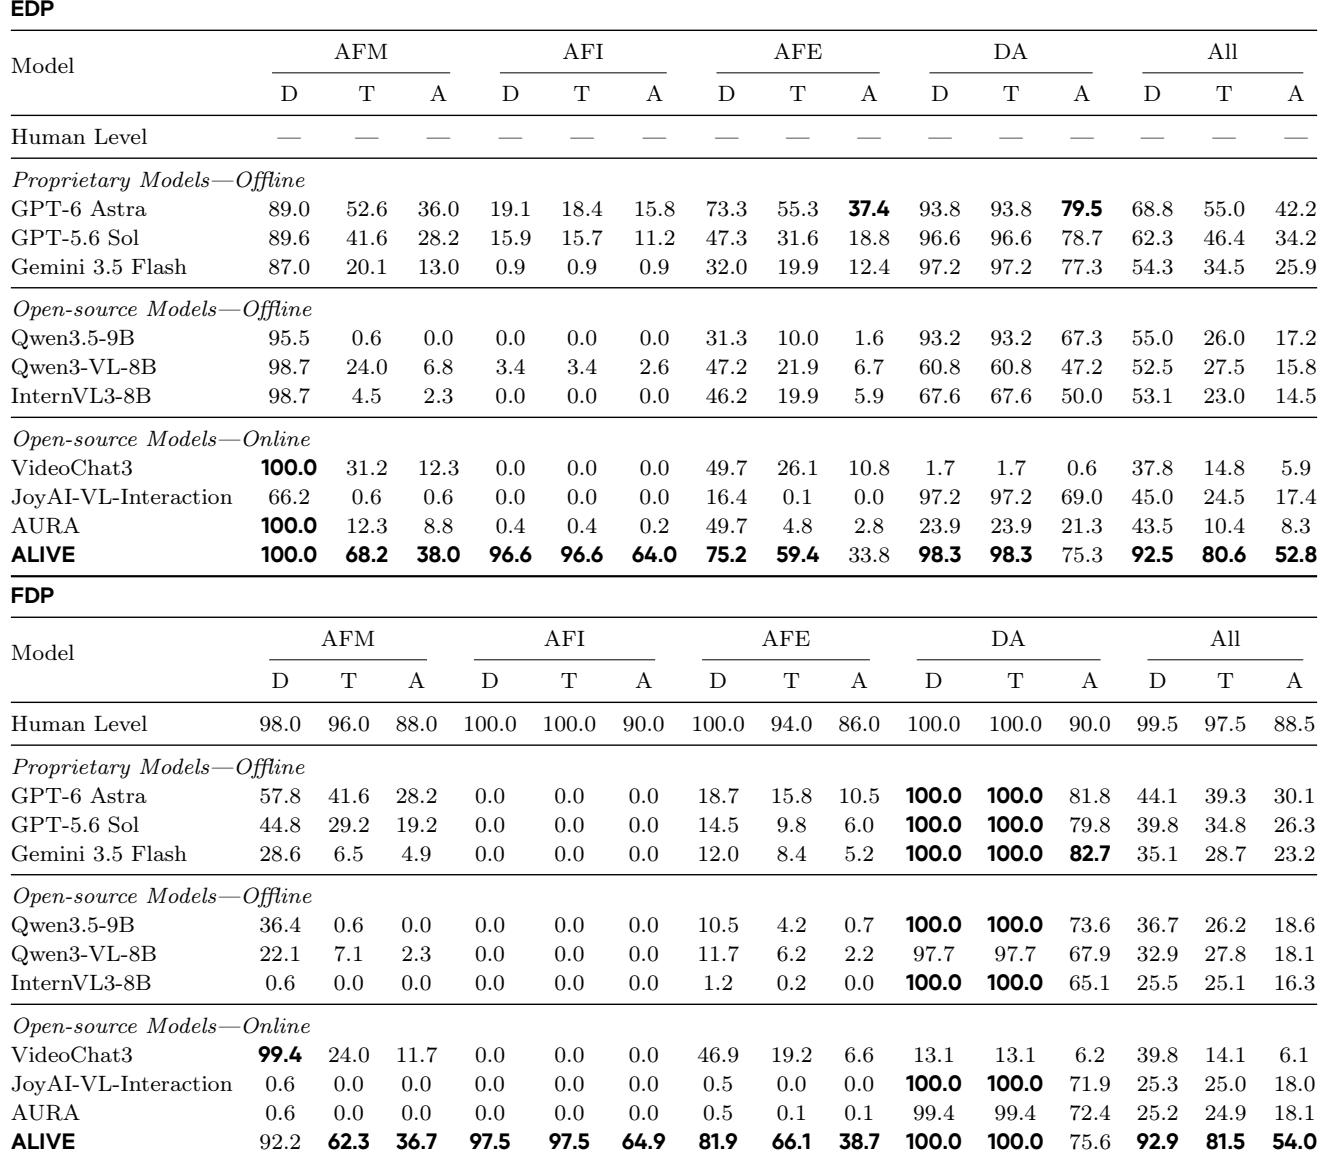
在 FSI-Bench 上,ALIVE 在显式和自由形式协议下均取得最高整体准确率,分别比最强专有基线高 10.6 和 23.9 个百分点。专有模型在直接回答方面相对较强,但在请求信息和请求执行方面较弱。尽管 ALIVE 处于领先地位,其自由形式表现仍远低于人类参考水平。ALIVE 相对最强专有基线的提升在自由形式协议下大于显式协议。专有模型在直接回答任务上表现相对较好,但在反馈寻求任务上表现挣扎,而除 ALIVE 外,开源流式模型在这些任务上仍然较差。
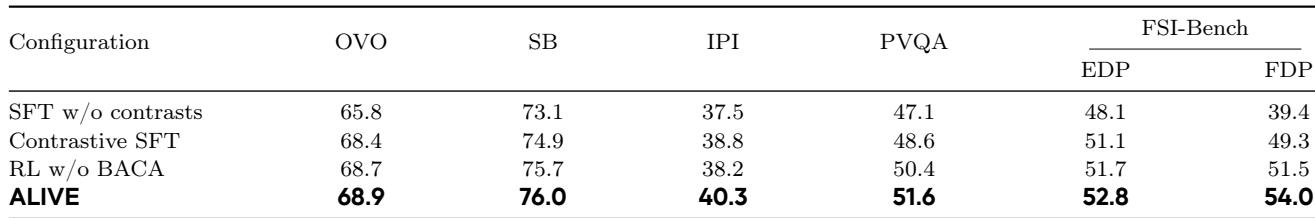
对比 SFT 相对不含对比示例的 SFT 改善了所有报告的聚合分数,其中在 FDP 下 FSI-Bench 上提升最大。加入仅轨迹 RL 进一步改善了大多数分数,但与单独使用对比 SFT 相比,IPI 表现略有下降。具有局部行为优势的完整模型在所有基准和两种 FSI-Bench 协议上均取得最高分数。对比 SFT 相对非对比 SFT 改善了所有报告的聚合指标。仅轨迹 RL 改善了大多数评估,但相对对比 SFT 略微降低 IPI 表现。具有局部行为优势的完整模型在所有六项评估和两种 FSI-Bench 协议上均取得最高分数。
实验评估了流式视频数据集覆盖范围、公开基准性能、FSI-Bench 交互协议和训练阶段消融。ALIVE-SFT 是唯一在多轮设置中同时结合主动监控、流式任务协调和反馈寻求支持的数据集,ALIVE 在公开流式基准和 FSI-Bench 上取得最强结果,尤其在反馈寻求任务上提升显著。消融表明,对比 SFT 一致优于非对比 SFT,仅轨迹 RL 在大多数评估中有帮助,而具有局部行为优势的完整模型整体表现最佳。