Command Palette
Search for a command to run...
多分支 Transformer
多分支 Transformer
Gaotang Li Lingjie Chen Chunyuan Deng Zhiwei Xu Hongzheng Chen Christopher De Sa Jingrui He Yingheng Wang Hanghang Tong
摘要
Transformer 语言模型通常通过加宽模块或加深堆叠来扩展规模。本文探索了一条互补路径:分支,即完整 Transformer 模块的并行组合。我们提出多分支 Transformer(MBT),它先通过共享的初始层处理输入,并行执行参数独立的分支顺序模块,再融合各分支输出,最后经过共享的末端层得到结果。在与标准 Transformer 相当训练计算量的条件下,我们研究了三种 MBT 变体:宽浅型保持模块宽度,窄深型保持顺序深度,均衡型在两者之间插值。在四个混合专家模型规模(总参数量从 0.8B 到 2.1B)的受控预训练实验中,我们表明在匹配参数量和训练计算预算下,2 分支宽浅型 MBT 始终优于顺序 Transformer。均衡型 MBT 相比宽浅型进一步提升了建模性能。当分支数从 2 增加到 3 或 4 时,这些模型仍保持相当的质量。为进一步提升长上下文下的推理效率,我们提出 Joint-KV,它在每个深度利用分支表示构建共享 KV 缓存。我们最终的模型方案将均衡型 MBT 与 Joint-KV 相结合,并配套一个利用分支分组和共享缓存复用的推理引擎。拟合的扩展曲线表明,标准 Transformer 需要多达 1.26 倍的训练主体计算量才能达到我们最终模型的验证损失。在所评估的配置中,这些模型将全模型 KV 缓存存储最多降低 34%,并在单块 H200 GPU 上实现最高 51.4% 的解码吞吐量提升。大量消融研究表明,分支带来的收益超越了宽度和深度变化本身,能够支持有效的 KV 共享策略(Joint-KV),在不同融合函数下保持稳健,并在中间层表现最佳。综上,这些发现表明分支为语言模型扩展提供了一条实用路径,可同时提升建模质量和推理速度。
一句话总结
伊利诺伊大学厄巴纳-香槟分校、莱斯大学及合作研究者提出了多分支 Transformer(MBT),它通过共享初始层处理输入,运行独立参数化的并行 Transformer 块,并在共享最终层之前融合输出;在匹配参数和训练计算预算下,其采用 Joint-KV 共享缓存的均衡变体优于顺序 Transformer,将 KV 缓存存储最多降低 34%,并将解码吞吐量最多提高 51.4%。
核心贡献
- 本工作提出了多分支 Transformer(MBT),它通过共享初始层处理输入,并行执行独立参数化的顺序 Transformer 块分支,并在共享最终层之前融合其输出;同时定义了宽浅、窄深和均衡的分支分配变体。
- 论文提出了 Joint-KV,它在每个深度从并行分支表示构造共享 KV 缓存,同时保留各分支特定的查询,并将其与使用分支分组和共享缓存复用的推理引擎结合,将全模型 KV 缓存存储最多降低 34%,将单 GPU H200 解码吞吐量最多提高 51.4%。
- 在 0.8B 到 2.1B 参数的混合专家模型上进行的受控预训练实验表明,在相同参数和训练计算预算下,2 分支宽浅 MBT 优于匹配的顺序 Transformer,均衡 MBT 进一步改善,拟合的扩展曲线表明标准 Transformer 需要最多 1.26 倍的训练主体计算才能达到最终模型的验证损失。
引言
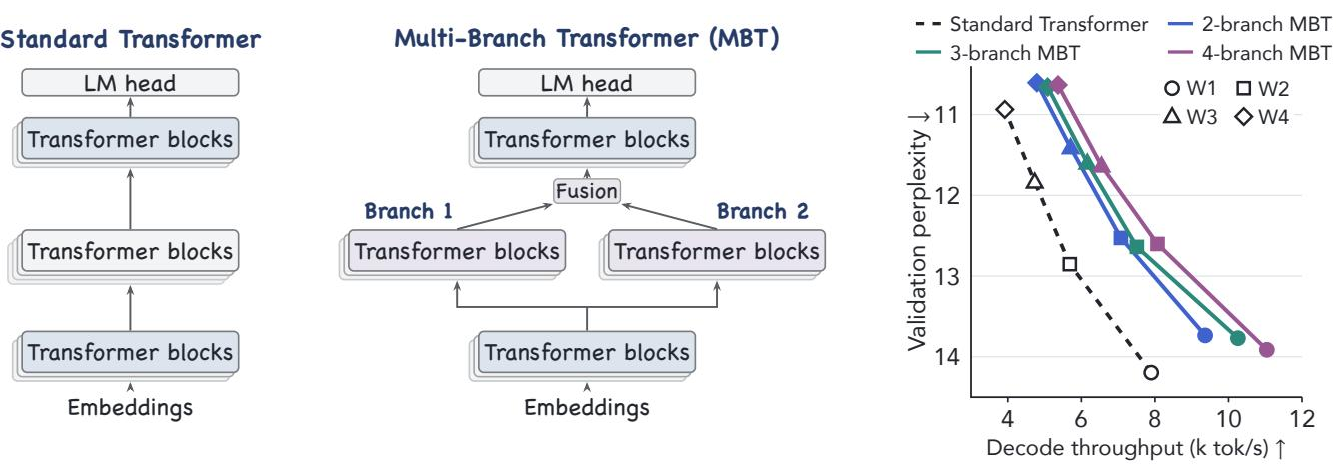
扩展 Transformer 语言模型通常依赖深度和宽度选择,而近期架构扩展了注意力、稀疏专家计算和残差设计,但仍然依赖完整块的顺序堆叠。先前工作探索了块内并行、宽度与深度权衡或系统级执行,对完整 Transformer 块的并行组合仍探索不足。作者提出了多分支 Transformer,将完整块组织为共享初始层和最终层之间的并行分支,并提出 Joint-KV,在同一深度跨分支共享键值缓存,以改善长上下文推理效率,同时保持模型质量。
方法
作者提出了多分支 Transformer(MBT),它能够在完整 Transformer 块的粒度上实现并行计算。
MBT 通过共享初始层(前奏层)处理输入,将计算拆分到 K 个独立参数化且并发执行的分支上,融合其输出,并将结果通过共享最终层(收尾层)。其核心思想是保持每个分支内的顺序组合,同时允许后续共享层建立在多个变换路径的结果之上。
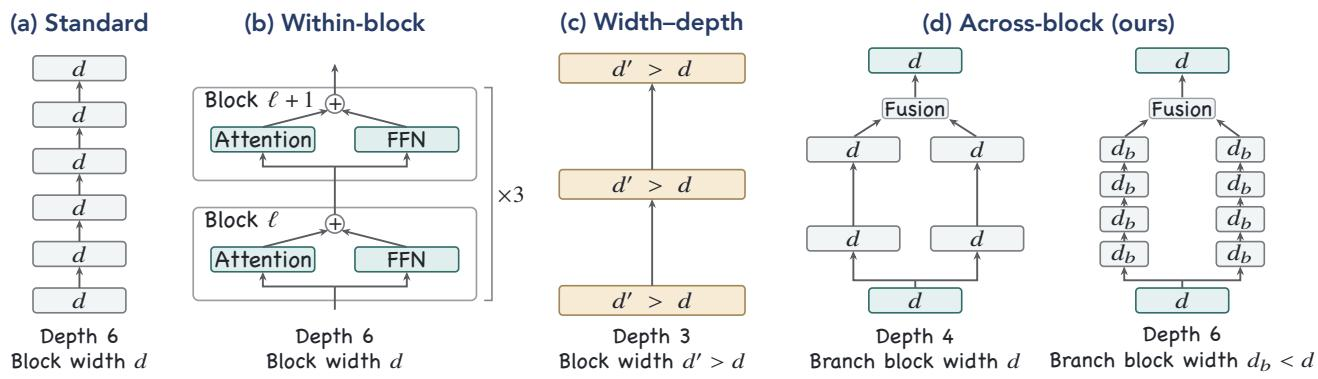
与探索单个块内并发、宽度和深度分配或替代并行计算路径的相关工作相比,MBT 在完整 Transformer 块的粒度上探索了一条正交的并行性维度。
设 x=(x1,…,xT) 为输入 token 序列,H∈RT×d 为块输入处的隐藏状态,其中 d 为残差宽度。每个块 Tℓ 先应用因果注意力,再应用混合专家(MoE)前馈模块:
H′=H+Attnℓ(H),Tℓ(H)=H′+MoEℓ(H′).MBT 用 K≥2 个独立参数化的分支堆栈 Gi 替换串行中间堆栈。前奏层 P、融合层 F 和收尾层将它们连接起来:
H=P(X),Zi=Gi(H),Y=Dec(C(F(Z1,…,ZK))).在融合时,作者对分支输出进行归一化,沿隐藏维度拼接,并将结果投影回共享宽度 d:
F(Z1,…,ZK)=Concat(N1(Z1),…,NK(ZK))WF.为了在可比计算量下定义 MBT,作者提出了三种分支宽度和深度分配方式。
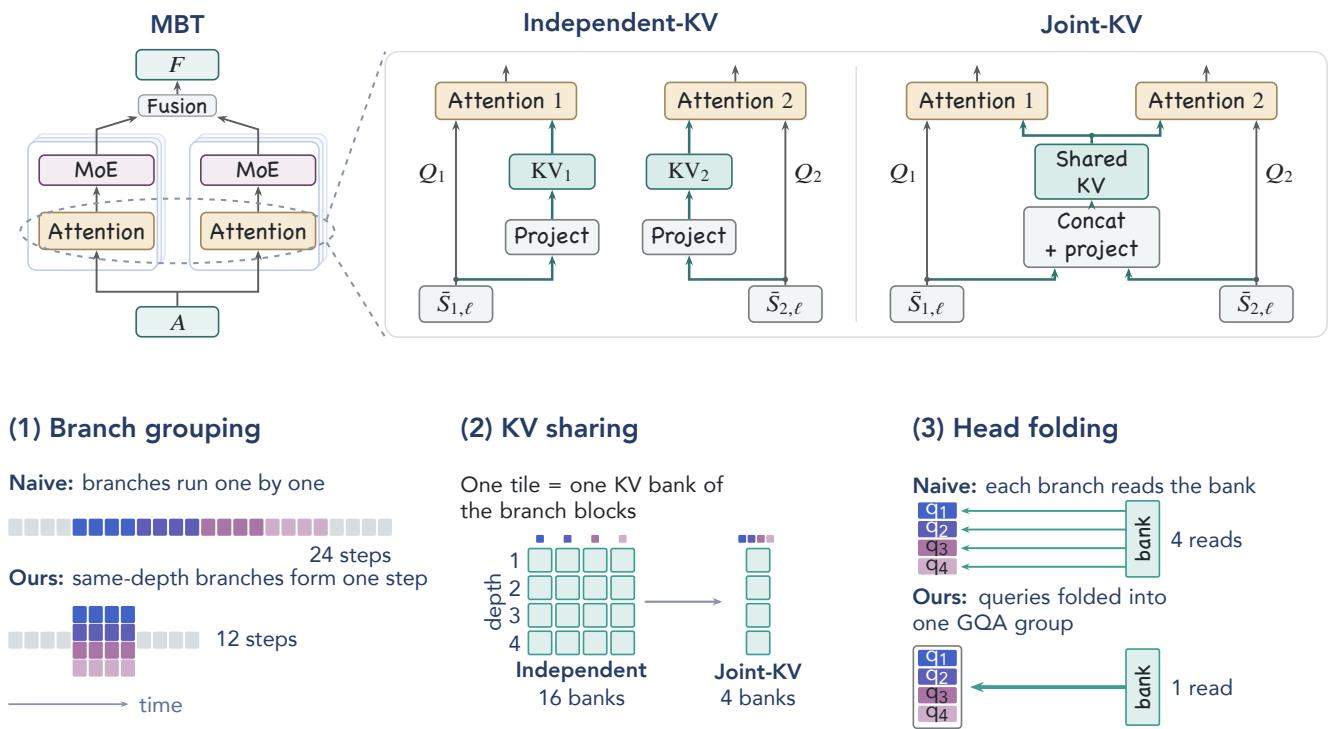
宽浅 MBT 保持原始块宽度,并将中间块重新分配到并行分支上。窄深 MBT 保持沿每个分支的原始顺序深度,同时减小块宽度。均衡 MBT 通过联合调整分支宽度和深度在这两种选择之间插值。
为了进一步利用并行分支结构,作者提出了 Joint-KV,它在每个深度根据所有分支表示构造共享的键值(KV)缓存,同时为每个分支保留单独的查询,并提出一个基于 nano-vLLM 的推理引擎。
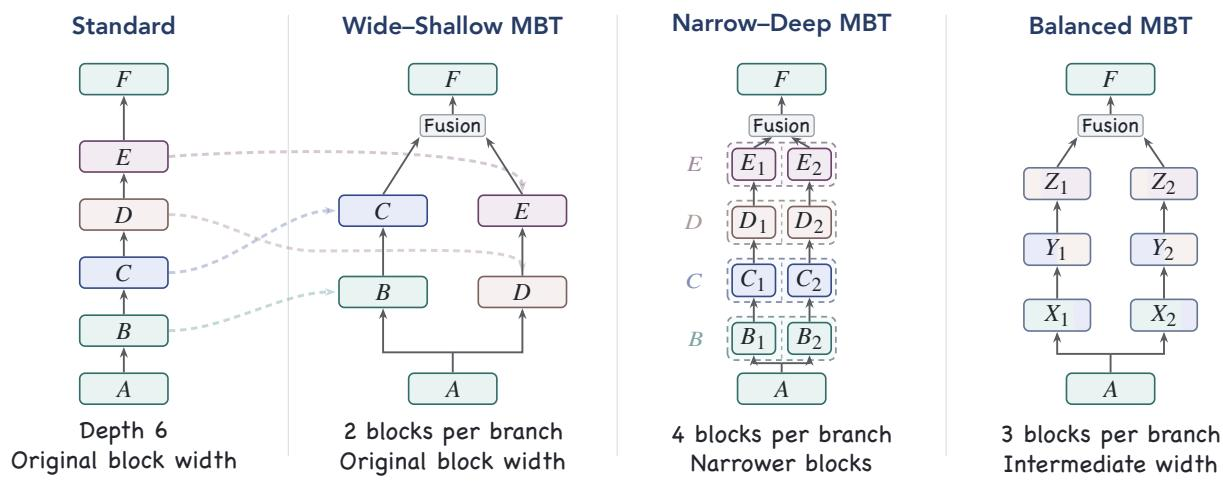
在默认的 Independent-KV 配置中,每个分支中的每个块维护单独的 KV 缓存。在 Joint-KV 中,所有分支在每个深度共享一个 KV 缓存,该缓存由注意力前的输入联合构造。形式化地,令 Sˉi,ℓ∈RT×db 表示深度 ℓ 处分支 i 的 RMS 归一化输入。KV 缓存构造如下:
KVi,ℓind=Sˉi,ℓWi,ℓind,KVℓshared=K1[Sˉ1,ℓ;…;SˉK,ℓ]Wℓshared.在固定分支深度和 KV 维度下,分支区域中的 Joint-KV 缓存是 Independent-KV 的 1/K。
推理引擎采用两种额外的执行机制。分支分组将各分支中相同深度的块分组到一个批量执行阶段。使用 Joint-KV 时,引擎先从分支输入表示构造共享 KV 缓存,然后一起计算分支特定的注意力和 MoE 输出。这减少了顺序块阶段的数量。头折叠将分支维度折叠到查询头维度中,按共享 KV 头对查询进行分组,使所有分支使用一次分组查询注意力(GQA)调用。这使注意力内核能够跨分支复用共享 KV 数据,减少冗余内存访问,同时保持注意力函数不变。
实验
实验在 FineWeb-Edu 上跨四个规模梯级预训练标准 Transformer 和多分支 Transformer,系统性地改变分支数量、宽度与深度分配、KV 共享、融合方式和分支位置。将约三分之一的块分配给两个并行分支可一致地改善验证损失和零样本下游性能,且这一优势在三个或四个分支时仍然存在,尤其是在均衡宽度与深度调优下。Joint-KV 在保持这些质量收益的同时,显著减小了 KV 缓存大小,并相比标准 Transformer 提高了解码吞吐量。消融实验表明,分支带来的收益超越了简单的加宽或深度匹配,共享 KV、拼接投影融合和中间分支位置是最有效的选择。
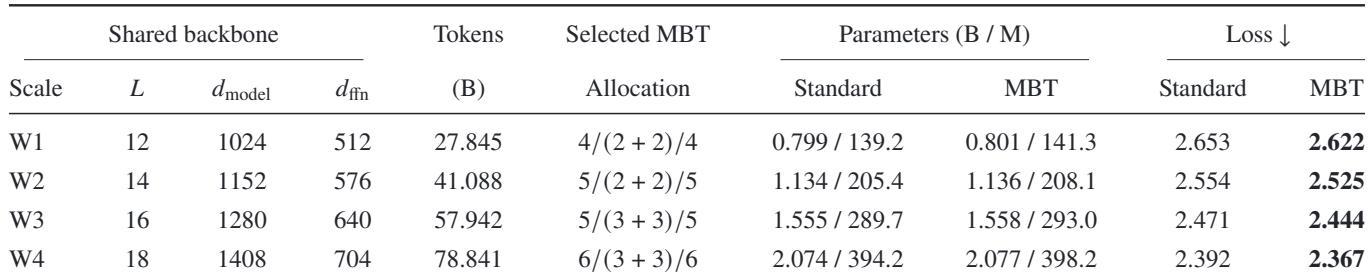
跨四个模型规模,选定的宽浅 2 分支 MBT 在总参数和活跃主体参数上几乎与标准 Transformer 相同,同时在每个规模上都取得更低的验证损失。最佳模型将少数物理块置于两个相等的并行分支中,前奏层和收尾层深度相等,并行块比例约集中在三分之一。损失降低幅度适中,约为 0.025 到 0.031。选定的 MBT 在每个规模上都降低了验证损失,同时总参数和活跃主体参数相对于标准 Transformer 几乎不变。最佳分配一致地将约三分之一的物理块置于两个相等的并行分支中,每个选定配置的前奏层和收尾层深度匹配。验证损失改善在较小规模时略大,随着模型规模增加从约 0.031 下降到 0.025。
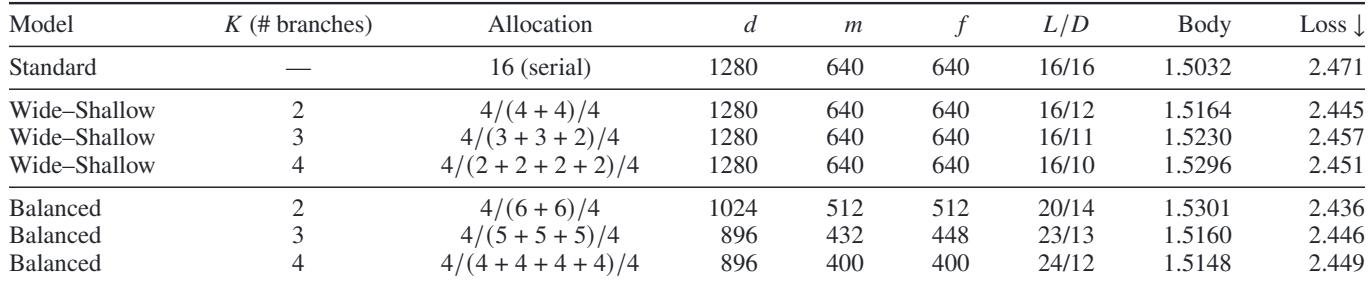
在这一匹配计算设置下,具有两个、三个或四个并行分支的多分支 Transformer 一致地比串行基线改善了验证损失。均衡的宽度与深度分配会调整块宽度和总深度以保持主体计算量,通常比宽浅分配达到更低的损失,后者保持基础宽度并将固定块预算分散到各分支。将分支数量从两个增加到四个只带来不大的损失变化,同时保持多分支优势。所示每个多分支配置在可比主体计算量下都优于串行基线。在每个分支数量下,均衡分配都取得比宽浅分配更低的验证损失。均衡模型使用更窄的块和更多的总物理块,而宽浅模型保持基础宽度并随着分支增加而减少深度。
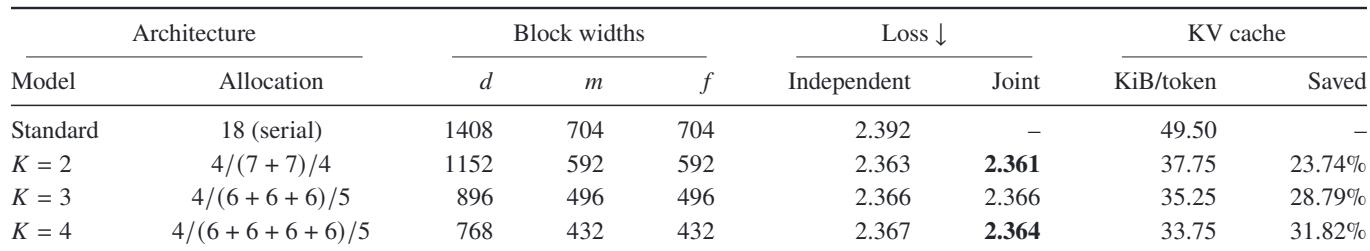
在 W4 规模下,具有 2、3 和 4 个分支的均衡 MBT 在验证损失上优于 Standard 模型,同时每个 token 使用更少的 KV 缓存。Joint-KV 变体在损失上与对应的 Independent-KV 变体相当,并且随着分支数量增加,相对于 Standard 的缓存节省也在增加。结果表明,跨分支共享 KV 可以在保持语言建模质量的同时提高缓存效率。所有 W4 MBT 变体都取得低于 Standard 的验证损失,同时也减小了 KV 缓存大小。Joint-KV 相对于 Standard 的缓存节省随分支数量增加,在四个分支时达到约 32%,而不同配置间的损失几乎保持平稳。
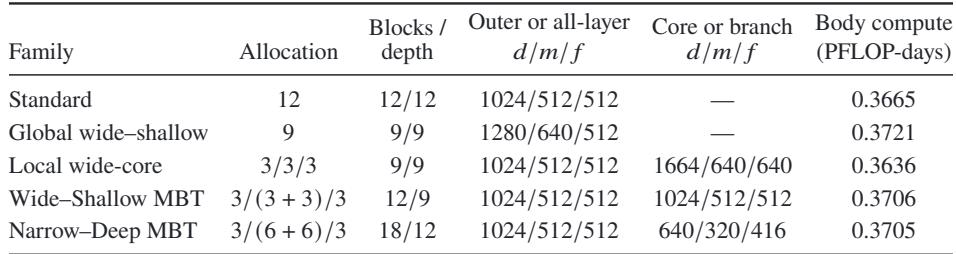
消融实验将分支模型与顺序加宽和深度匹配的对照模型在大致相等的主体计算量下进行比较。宽浅 MBT 优于全局和局部加宽基线,而窄深 MBT 优于 Standard 并表现出最陡的扩展指数。这些模式表明,分支带来的建模质量改善超越了更浅或更宽的顺序替代方案,并且宽度和深度可以联合调优。在匹配计算量下,全局加宽和仅核心加宽都不能复现分支模型的收益。深度匹配的窄分支模型优于标准顺序模型,并取得最陡的扩展趋势。
在所有四个规模的匹配 KV 缓存比较中,Joint-KV 一致地取得比 Independent-KV 更低的验证损失。这一改善在各规模间相似,而 Joint-KV 较大的 KV 投影只增加少量主体计算量。这表明跨分支共享键和值比维护总大小相同的较小私有 KV 缓存更有效。Joint-KV 在每个测试规模上将验证损失降低 0.011 到 0.012。Joint-KV 较大的 KV 投影增加的主体计算量不到 0.6%,远不足以解释损失改善。
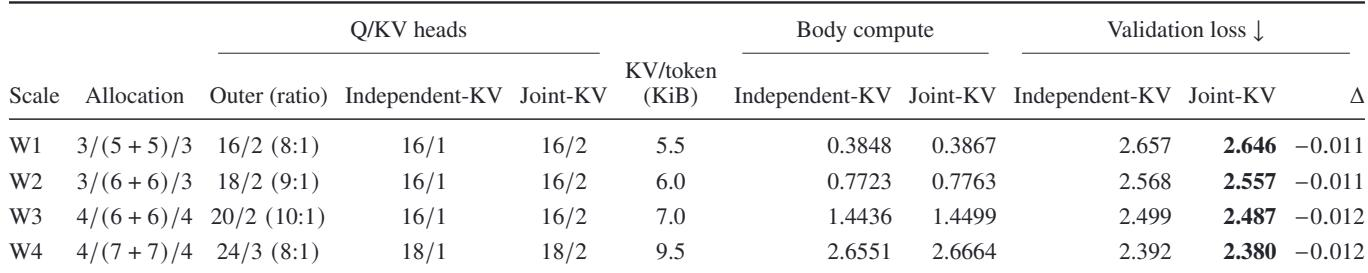
跨四个模型规模和匹配计算设置,具有两到四个并行分支的多分支 Transformer 一致地比串行基线改善了验证损失,同时总参数和活跃主体参数几乎不变,并且均衡的宽度与深度分配通常优于宽浅分配。消融实验表明,这些收益来自分支本身,而不是来自简单的加宽或深度扩展。共享 Joint-KV 缓存变体在减少缓存使用的同时保持或略微改善语言建模质量,相对于标准模型的节省在四个分支时增长到约 32%,并且它们在每个测试规模上都一致优于等大小的独立 KV 缓存。