Command Palette
Search for a command to run...
MMFlash:面向视觉语言模型的更快投机解码
MMFlash:面向视觉语言模型的更快投机解码
Sicheng Feng Zigeng Chen Song Wang Gongfan Fang Xinchao Wang
摘要
投机解码通过让轻量级起草模型提出词元,并由目标模型并行验证来加速生成。DFlash 等扩散起草模型能够在单次前向传播中提出整个词元块,但主要聚焦于纯文本任务,多模态起草尚未得到充分探索。为研究这一设定,我们首先基于有视觉输入和无视觉输入时下一词元分布之间的 KL 散度,引入词元级视觉依赖度量。我们发现,接受率从视觉依赖最低四分位数的 46% 下降到最高四分位数的 22%,且这种差异在多模态训练后仍然存在。受此观察启发,我们提出 MMFlash,一个简单而有效的框架,能够自适应地提高起草模型预测较差的视觉依赖词元的权重。对于长视频输入,MMFlash 进一步采用稀疏注意力来减少冗余注意力计算并提升起草质量。在多个多模态基准上,MMFlash 实现了最高 3.58 倍的无损解码加速,分别比 EAGLE-3 和 DFlash 高出最多 195.4% 和 17.1%。
一句话总结
新加坡国立大学的研究人员提出 MMFlash,一种用于视觉语言模型的投机解码框架,该框架自适应地提高草稿模型预测较差的视觉依赖 token 的权重,并对长视频输入应用稀疏注意力,实现高达 3.58× 的无损加速,分别比 EAGLE-3 和 DFlash 最多高出 195.4% 和 17.1%。
核心贡献
- 论文引入了一种 token 级视觉依赖度量,该度量基于有视觉输入与无视觉输入时下一个 token 分布之间的 KL 散度,并表明草稿接受率从视觉依赖最低四分位数的 46% 下降到最高四分位数的 22%。
- 论文提出 MMFlash,一种扩散草稿框架,该框架自适应地提高草稿模型预测较差的视觉依赖 token 的权重,并在长视频中采用稀疏注意力以减少冗余注意力计算。
- 在七个图像基准和三个长视频基准上,MMFlash 实现高达 3.58× 的无损解码加速,分别比 EAGLE-3 和 DFlash 最多高出 195.4% 和 17.1%,并可推广到其他模型系列和规模。
引言
视觉语言模型(VLM)在视觉问答和视频理解等多模态任务上表现良好,但其自回归解码限制了推理效率,尤其是在推理模型生成更长响应时。投机解码通过让小型草稿模型提出 token 以进行并行验证来加速这一过程,但自回归草稿模型仍需要串行前向传播,并且往往为轻量设计牺牲草稿质量。基于扩散的草稿模型(如 DFlash)可以在一次前向传播中生成整个块,但将其扩展到 VLM 暴露出一个关键限制:即使在多模态训练之后,视觉依赖 token 上的接受率仍会急剧下降。作者提出 MMFlash,一种扩散草稿框架,通过 KL 散度衡量视觉依赖,并重新加权训练以强调预测较差的视觉依赖 token,同时为长视频添加稀疏注意力并实现显著解码加速。
方法
作者在将块扩散草稿扩展到视觉语言模型时发现一个关键限制:对于严重依赖视觉输入的 token,接受率显著下降。为量化这一现象,他们引入一种 token 级视觉依赖度量,定义为在相同文本前缀条件下,目标模型在有视觉输入与无视觉输入时下一个 token 分布之间的 KL 散度:
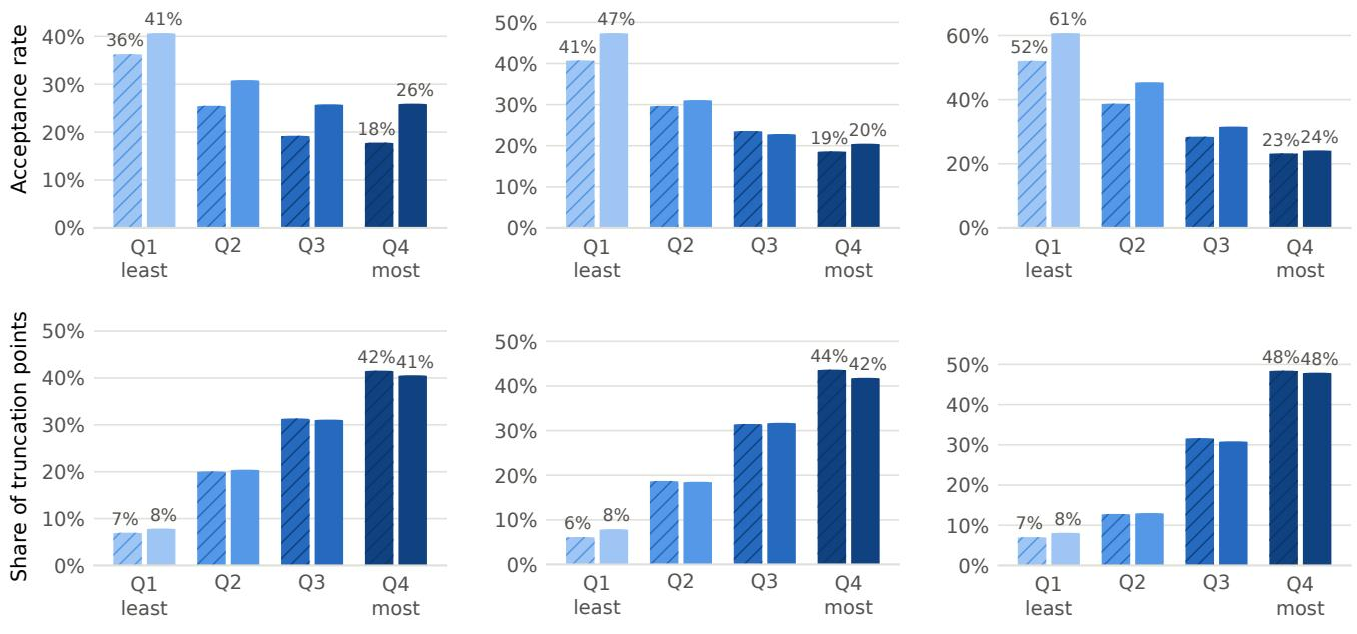
d=KL(p(⋅∣prefix,I)∥p(⋅∣prefix))如下图所示,经验分析表明,随着视觉依赖增加,草稿 token 的接受率单调下降,而截断点高度集中在视觉依赖最高的四分位数中。这一观察促使提出 MMFlash,该框架明确将草稿模型的训练容量导向视觉依赖 token,而不是对所有位置一视同仁。
视觉依赖分数 dt 会针对训练集中的每个 token 离线预先计算。为确保草稿模型关注目标模型具有明确预测的 token,该分数按目标模型的置信度进行缩放,置信度由其有图像分布的熵 Ht 衡量:
gt=g~t⋅exp(−Ht)其中 g~t 是训练数据集中 dt 的分位数。
训练目标将纯位置权重替换为三个因子的乘积。对于块中 B−1 个被掩码的位置,权重 wk 定义为:
wk=bk(1+αgk(1−sg(qk))) LMMFlash=k=1∑B−1wk(−logqk)这里,bk 是验证感知的位置权重,用于根据草稿模型自身的置信度估计链式存活概率:
bk=i=1∏kqˉi,qˉi=(1−λ)sg(qi)+λ项 (1−sg(qk)) 作为动态分量,表示草稿模型当前错过该 token 的概率。这确保额外训练工作在视觉相关 token 尚未被掌握时最大,并随着草稿模型逐渐拟合而减弱,从而防止以牺牲文本 token 为代价过度拟合视觉 token。
将草稿模型应用于长视频上下文时,作者发现全上下文注意力效率较低。对训练后草稿模型注意力模式的分析显示,注意力高度集中在问题、已生成答案和最近位置上,而较远的视觉帧则获得分散注意力。
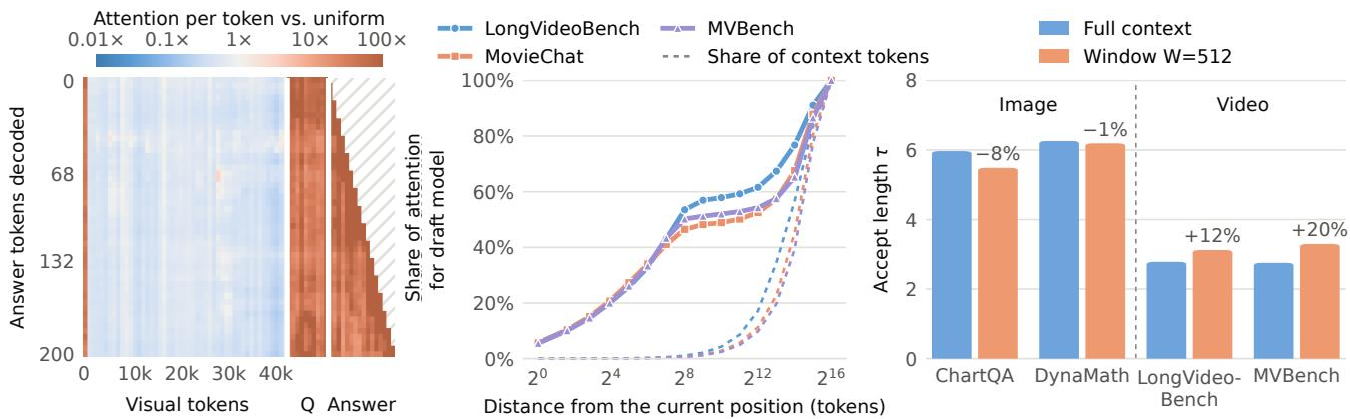
如下图所示,应用简单注意力窗口会降低图像基准上的接受长度,但会提高视频基准上的接受长度。基于这些观察,作者专门为视频任务设计了一种稀疏注意力模式。该模式保留前 4 个 sink token、以步长 32 采样的视觉 token、所有文本 token 以及长度为 256 的局部窗口。同一模式在训练和推理期间一致应用,以确保稳定的上下文访问并提高视频任务中的接受长度。
实验
为说明多模态草稿的必要性,作者通过比较目标模型在有图像和无图像时预测之间的 KL 散度来衡量每个 token 的视觉依赖,发现视觉依赖越高,草稿接受率越低,截断点越多。主要实验在 LLaVA-OV-1.5 的大约 900K 个多模态样本上针对 Qwen3.5-4B 和 Qwen3.5-9B 训练 MMFlash,并在七个多模态基准上评估,其中 MMFlash 在贪心解码下实现 3.00 到 3.05 倍的平均加速,在温度 1 下实现 2.54 到 2.70 倍的平均加速,优于 MTP、EAGLE-3 和 DFlash 基线。额外结果显示,经过轻量微调后在视频基准上的加速有所提升,并可推广到 Gemma4 和 Qwen3.8-27B,而诊断研究证实了在高服务并发下的鲁棒性,并验证了所选块大小、草稿模型深度和目标隐藏状态数量。
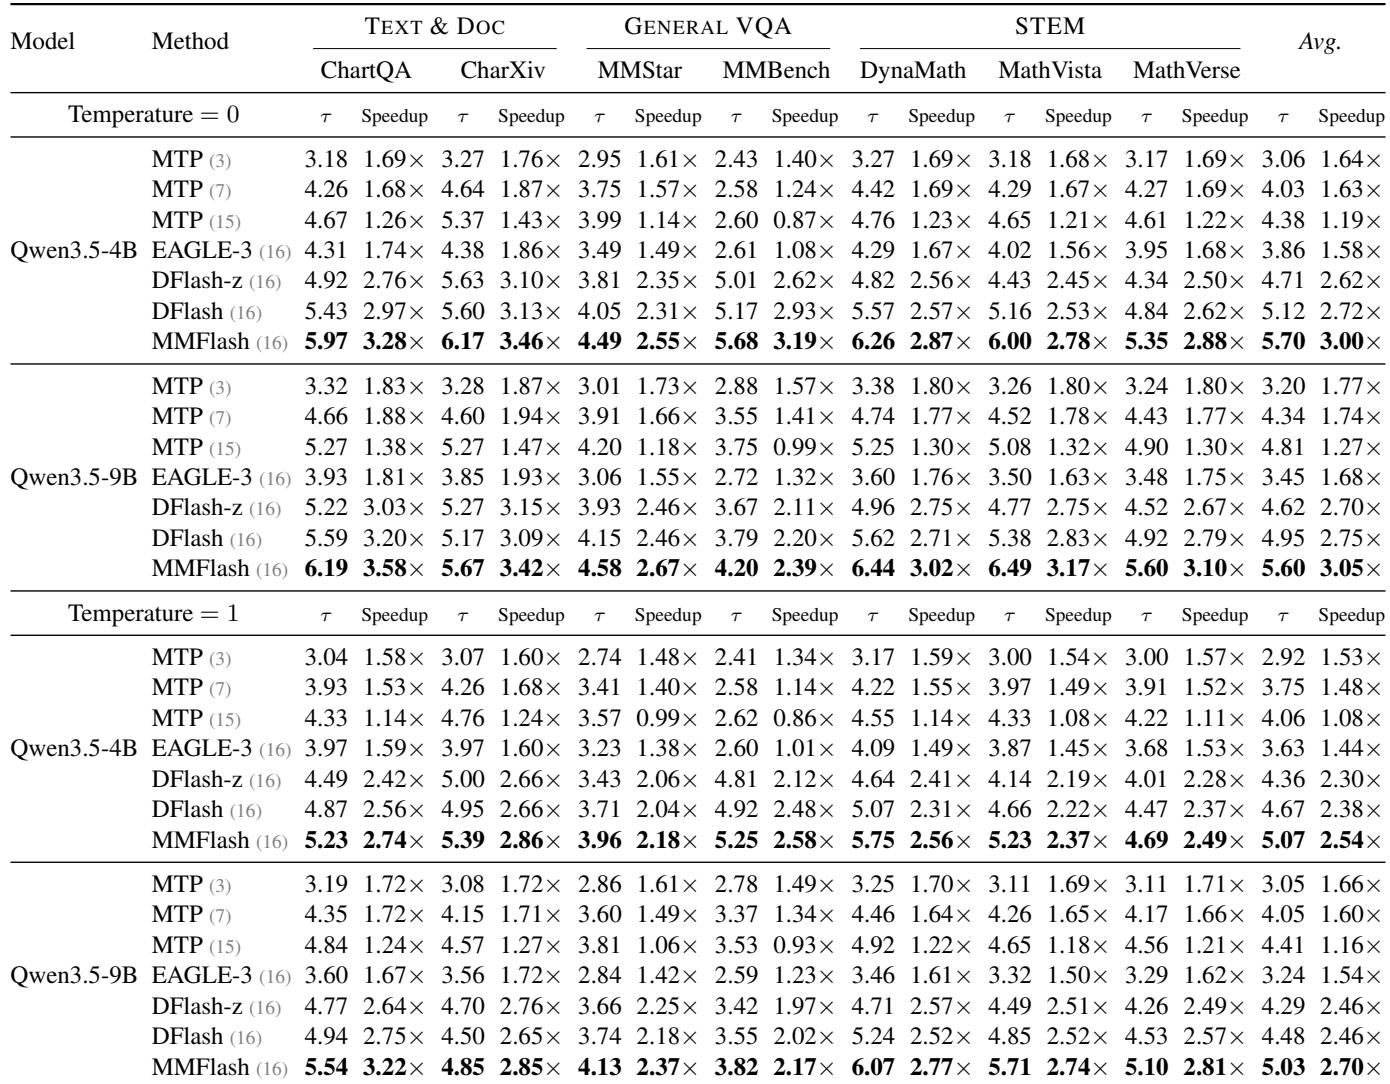
MMFlash 在 Qwen3.5 模型的文本/文档、通用 VQA 和 STEM 基准上一致取得最高的接受长度和解码加速。在贪心解码下,其平均加速约为 3.0 到 3.1 倍,在温度 1 下约为 2.5 到 2.7 倍,比 DFlash 高出 6.7% 到 10.9%。这一优势在不同目标模型和基准类别中均保持。MMFlash 在不同基准组中的接受长度和解码加速均超过 MTP、EAGLE-3 和 DFlash。相对于 DFlash,MMFlash 在 Qwen3.5 模型的贪心解码和温度 1 设置下额外提供约 7% 到 11% 的解码加速。
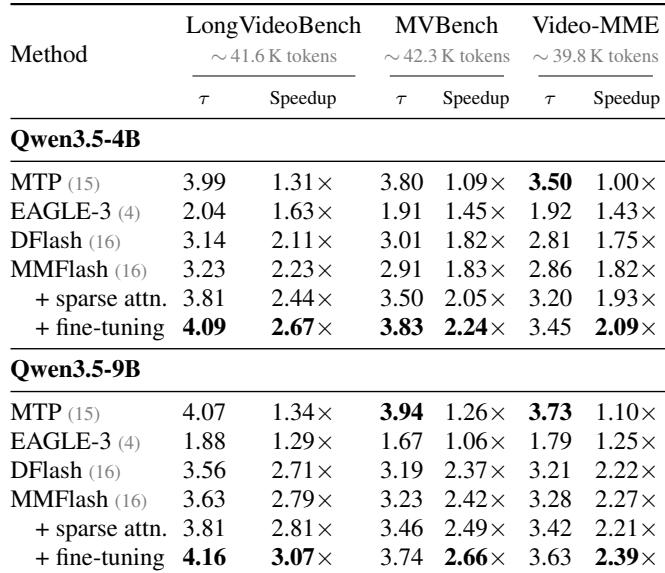
在三个长上下文视频基准上,采用稀疏注意力的 MMFlash 变体取得最高解码加速,并相比基础 MMFlash 提高了接受长度。这些收益在各基准上一致存在,其中在 LongVideoBench 上加速最大,在 Video-MME 上提升较小。与 DFlash 相比,MMFlash 变体在每个视频基准上都提供更高的加速。稀疏注意力 MMFlash 配置在全部三个视频基准上达到最佳加速,其中在 LongVideoBench 上增益最大。添加稀疏注意力同时提高了接受长度和加速,微调进一步增强了相对于 DFlash 的优势。
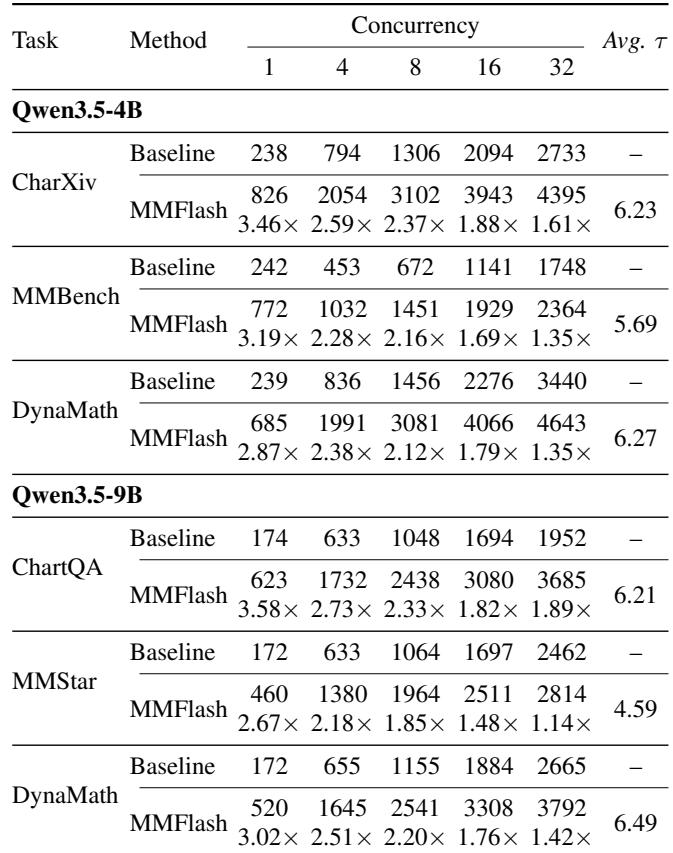
在 SGLang 服务中,MMFlash 在 1 到 32 的每个并发级别上都比基线提高了解码吞吐量,其中在较低并发下加速最大,并且随着解码变得更受计算限制,优势逐渐缩小。在并发 16 时,MMFlash 在所有任务上的吞吐量仍超过基线在并发 32 时达到的水平。在所报告的 Qwen3.5-4B 任务上,平均接受长度保持较高,约为 5.7 到 6.2 个 token。相对于基线的加速在并发 1 时最高,并随着并发从 4 增加到 32 稳步下降。在所有六个任务上,并发 16 时的 MMFlash 提供的吞吐量高于并发 32 时的基线。在 Qwen3.5-4B 的 CharXiv 和 MMBench 上,即使吞吐量扩展,平均接受长度也保持在约 6 个 token。
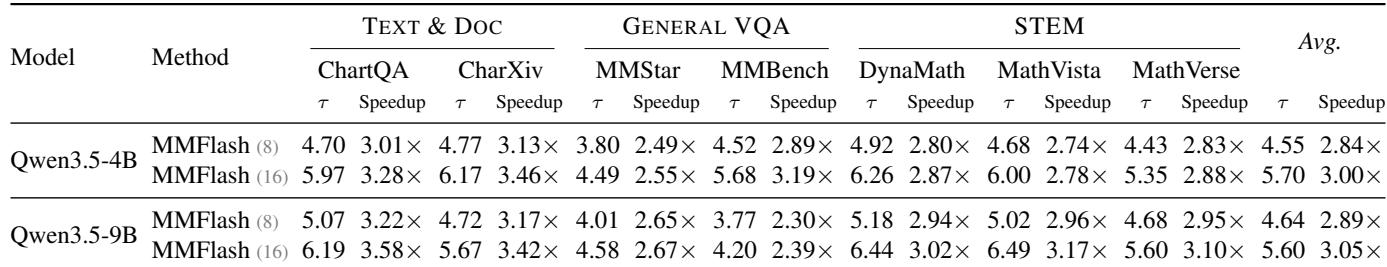
在 Qwen3.5-4B 和 Qwen3.5-9B 上,测试时块大小为 16 的 MMFlash 与其训练配置一致,在所有评估任务上都比块大小 8 取得更高的接受长度和加速。将测试时块大小减小到 8 可保留大部分加速,但接受长度下降更明显。这表明草稿模型能够泛化到较小的块大小,但在块上限较低时未充分利用其容量。测试时块大小 16 在所有评估任务和两种模型规模上均一致取得高于块大小 8 的接受长度和加速。使用块大小 8 只会导致平均加速小幅下降,但平均接受长度下降更大,这反映了草稿块容量受到限制。在 ChartQA 和 CharXiv 上,相当一部分草稿块达到了最大接受长度 8,表明较小的块大小限制了每次草稿可接受的 token 数。
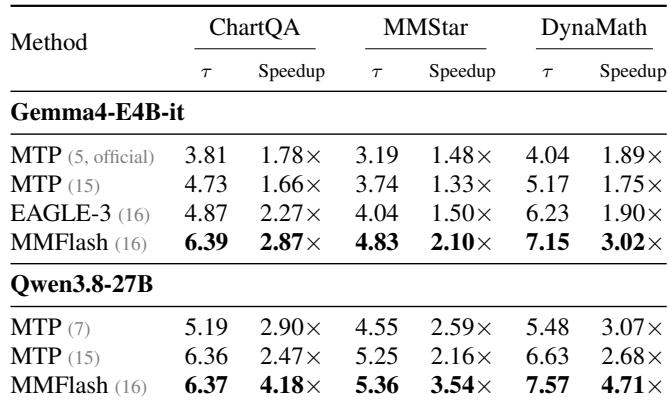
在贪心解码下,块大小为 16 的 MMFlash 在 Gemma4-E4B-it 上的 ChartQA、MMStar 和 DynaMath 中,与 MTP 和 EAGLE-3 草稿模型相比取得最高的接受长度和解码加速。这一优势在所报告的模型系列中保持,Qwen3.8-27B 上的加速超过 Gemma4-E4B-it。在 Gemma 基准中,MMFlash 在 DynaMath 上显示出最大的相对增益。在 Gemma4-E4B-it 的每个所列基准上,MMFlash 均取得最佳接受长度和加速。EAGLE-3 优于 MTP 变体,但在评估任务中仍低于 MMFlash。所报告的解码加速在 Qwen3.8-27B 上高于 Gemma4-E4B-it,而 MMFlash 保持排名第一。
实验在 Qwen 和 Gemma 模型上评估了 MMFlash 作为投机解码草稿模型在文本/文档、通用 VQA、STEM、长上下文视频和服务工作负载中的表现。与 DFlash、MTP 和 EAGLE-3 相比,MMFlash 在贪心解码和温度 1 设置下均一致取得最高的接受长度和解码加速。稀疏注意力变体进一步提高了长上下文视频性能,吞吐量增益在服务并发级别上保持为正,尽管在高负载下有所缩小,并且使用与训练匹配的块大小 16 表现最佳,而较小的块大小可保留大部分加速。