Command Palette
Search for a command to run...
Gamer:面向长时程实时游戏智能体的通用视觉-语言-动作基础模型
Gamer:面向长时程实时游戏智能体的通用视觉-语言-动作基础模型
摘要
我们提出了 Gamer,一个为复杂交互环境中的长时程任务而构建的通用智能体框架。其端到端架构融合了感知、记忆管理和多步推理。统一的训练与部署流程支持与常规 2D 图形界面以及复杂 3D 模拟世界进行交互。我们首先在由数万小时设备级键盘和鼠标交互数据构建的数据集上继续进行预训练。这些轨迹涵盖模拟游戏和具身环境,使模型能够学习跨物理域和虚拟域的环境动态。稀疏思考指令微调随后显著减少了冗余计算,同时保留了复杂决策所需的推理能力。我们采用一种稳定的多轮强化学习方法训练长时程交互策略,以应对有限上下文窗口、累积 rollout 误差和稀疏奖励等问题。为实现实时交互,云端-边缘推理引擎可同时服务大量模拟游戏环境,支持无界上下文执行,并保持较低的在线推理延迟。在多个具有挑战性的 3D 开放世界游戏中,Gamer 展现出扎实的泛化能力和与熟练玩家相当的操作效率。它在一系列常规 2D 游戏基准上也取得了具有竞争力的结果。这些结果表明,即使是重复性的键盘和鼠标轨迹,也能通过扩展数据和学习算法带来显著提升。在这些轨迹上进行训练有助于 Gamer 在兼具物理与数字属性的环境中更稳定地学习复杂技能。该方法为构建能够跨数字世界与物理世界进行交互的通用智能体提供了一条路径。
一句话总结
米哈游崩坏 AI 研发团队、新加坡国立大学、清华大学、中国科学院大学、中国科学技术大学和西安交通大学的研究人员提出了 Gamer,一个面向长时程实时 game agents 的通用视觉-语言-动作基础模型。该模型结合了感知、记忆管理和多步推理,并通过在数万小时设备级键盘和鼠标轨迹上的继续预训练、稀疏思考指令微调和稳定多轮强化学习进行训练,还配备了一个云边端推理引擎,能够在具有挑战性的 3D 开放世界游戏和传统 2D 游戏基准上实现实时、低延迟交互。
核心贡献
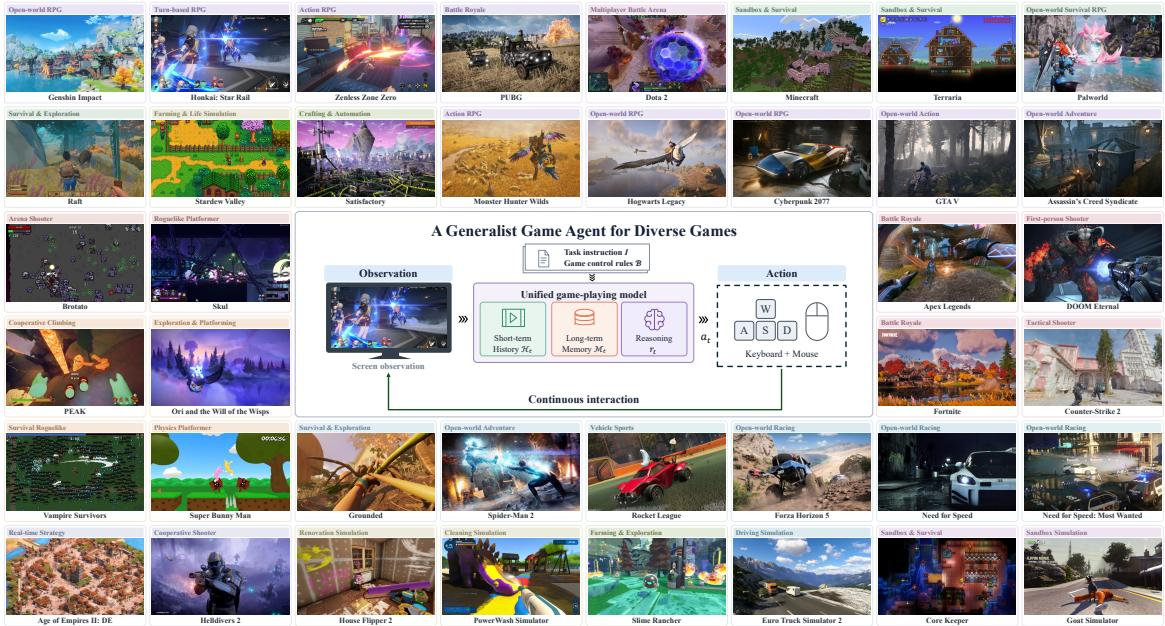
- Gamer 是一个通用 agent 框架,采用端到端架构,将感知、记忆管理和多步推理结合起来,用于长时程任务。它使用屏幕观测和统一的键盘鼠标动作空间,覆盖传统 2D 图形界面和复杂 3D 模拟世界。
- 训练流程在数万小时设备级键盘和鼠标轨迹上进行继续预训练,然后采用稀疏思考指令微调和时序感知组相对策略优化(TA-GRPO)。这减少了冗余计算,并在有限上下文窗口、累积 rollout 误差和稀疏奖励下稳定了长时程强化学习。
- Streaming-vLLM 作为云边端推理引擎,支持并发游戏实例、无界上下文执行和低延迟实时交互。Gamer 在具有挑战性的 3D 开放世界游戏中达到了与熟练玩家相当的运行效率,并在标准 2D 游戏基准上取得了有竞争力的表现。
引言
多模态大语言模型正在演化为交互式 agents,视觉-语言-动作模型为具身通用智能提供了一条路径,但对真实世界物理 agents 的评估受到高试错成本和有限环境可控性的阻碍。现代大规模游戏提供了受控但要求严格的基准,然而现有 game agents 通常依赖特权内部状态、定制动作空间或专用 API,而传统推理延迟会导致动作滞后于变化的游戏状态,削弱闭环控制和在线强化学习。作者提出了 Gamer,一个通用 agent 框架,以原始屏幕像素为输入,以原生键盘鼠标动作作为统一接口,结合了多源游戏数据的继续预训练、LLM 辅助的长时程指令数据构建、稀疏思考指令微调、时序感知组相对策略优化,以及实时 Streaming-vLLM 推理系统。
数据集
来源与构成
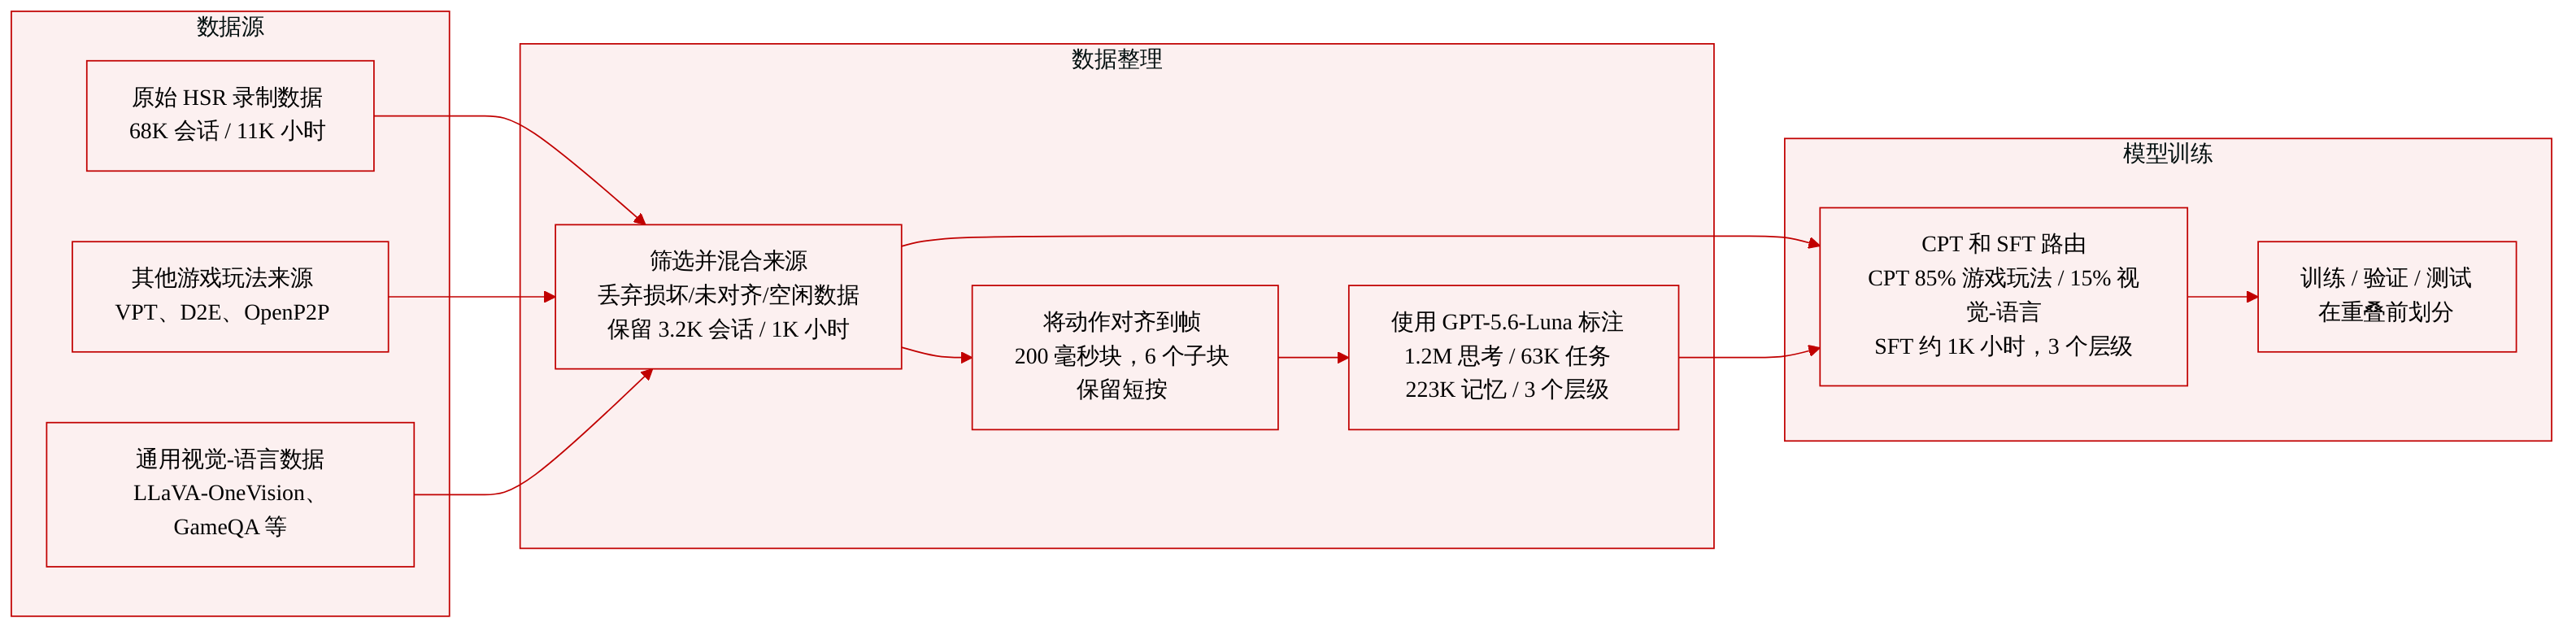
- 作者从多个来源收集带有相关键盘和鼠标事件的原始游戏录像。
- HSR 录像轨道包含约 68K 个会话和 11K 小时的视频。
- 经过过滤和场景平衡后,约 3.2K 个会话和 1K 小时被保留用于 SFT 标注。
- 在 CPT 语料的 HSR 部分中,过滤后保留约 149K 个对齐片段,对应约 332 小时的游戏过程。
- CPT 扩展中使用的其他游戏来源包括 VPT、D2E 和 OpenP2P。
- 通用视觉-语言来源包括 LLaVA-OneVision、Zebra-CoT、GameQA、Embodied-Reasoner 和 Cambrian-S。
过滤与覆盖平衡
- 作者剔除损坏或重复的会话、缺失或不连续的帧,以及视频和动作时间戳无法一致对齐的轨迹。
- 移除无效的动作轨迹,包括超出有效屏幕或控制边界的鼠标坐标、格式错误的动作状态,以及跨越录制或交互边界的事件。
- 过滤掉长时间不活跃时段和没有有意义交互的录像,同时保留有效的按住输入和与任务相关的等待时段。
- 作者还对过度表示的流和过度空闲的区间进行下采样,通过保留出现频率较低的交互和较长的任务过渡来平衡覆盖。
动作-观测对齐
- 保留键盘和鼠标事件的原始顺序。
- 每个动作块使用校正后的录制时间戳与其对应帧关联。
- 每个设备级动作区间大约持续 200 毫秒,包含六个更细的控制块。
- 动作窗口不允许跨越帧间隔、不连续索引或录制边界。
- 短按键保持为短脉冲,而不是被时间聚合丢弃。
标注输出
- 稀疏推理:作者将动作流划分为 50 个设备级动作区间的窗口,约 10 秒交互。每个窗口包含 25 个有序游戏观测和相关的 50 个动作区间。GPT-5.6-Luna 识别稀疏决策点,并生成约 1.2M 个时间戳对齐的 Think 标注。
- 视觉任务分割:每个会话被划分为长度相等、最长 288 秒的视觉片段。帧按大约一秒间隔采样,并排列成 3x2 带时间戳的马赛克,每个片段最多 49 个马赛克。GPT-5.6-Luna 识别连续任务片段,并为每个片段分配任务指令、玩法标签和简短场景描述。这生成约 63K 个任务片段,中位时长约 40 秒。
- 活动标签涵盖七类玩法:导航、NPC 对话、战斗、小游戏、系统菜单、货币战争和其他活动。
- 记忆标注:第二轮对话复用片段图像和清理后的任务片段。GPT-5.6-Luna 返回摘要,通常每 16 秒窗口一个,以第一人称描述累计完成事项和结果。短于 8 秒的最后窗口被合并到前一窗口。这生成约 223K 个记忆标注,每个标注与当前任务指令以及窗口结束前或结束时的最新图像帧关联。
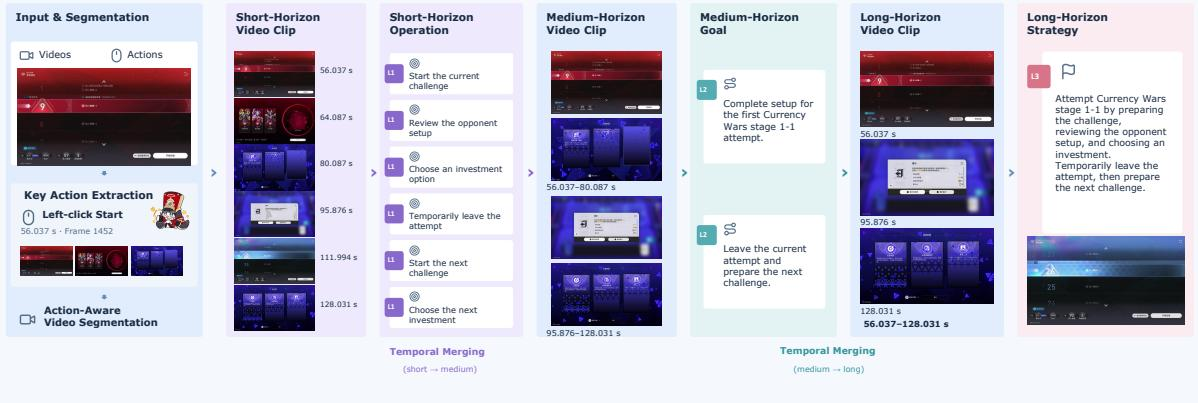
三级指令层级
- 简单:局部操作。 这些覆盖一个或两个标注决策,例如接近 NPC、选择菜单选项或拾取物品。
- 中等:中间子目标。 这些将相关操作组合为一个跨越三到五个标注决策的子目标。
- 困难:扩展任务阶段。 这些将多个子目标连接为一个跨越六个或更多标注决策的任务阶段。
- 该层级从任务片段、Think 标注和记忆标注自底向上构建。人工标注示例指导措辞和范围。同一录制区间可以支持多个级别的指令。
训练使用与采样
- CPT 阶段使用 85% 游戏过程数据和 15% 通用视觉-语言数据的 token 比例。Gamer CPT 将 HSR 游戏轨迹加入该混合数据。
- SFT 阶段使用整理后约 1K 小时的 HSR 游戏轨迹。操作级示例训练局部控制和稀疏推理,子目标级示例添加中间目标和更长记忆,任务级示例覆盖长时程任务。
- 不同标注级别的示例可能来自同一轨迹,其派生样本和监督 tokens 分别计数。
- RL 阶段还使用在线策略经验,而跨游戏交互轨迹、通用多模态数据和多级任务监督被分别用于 CPT、SFT 和 RL。
- 数据划分在创建重叠窗口或多级示例之前按录像或完整任务级别分配,因此来自同一来源的派生样本保留在同一划分中。
- 每个监督示例表示为 xth=(B,Ih,Mth,Ht) 和 yt=[rt,at],其中 h 是指令级别。每一步都包含动作监督,包括没有 Think 标注的步骤。
方法
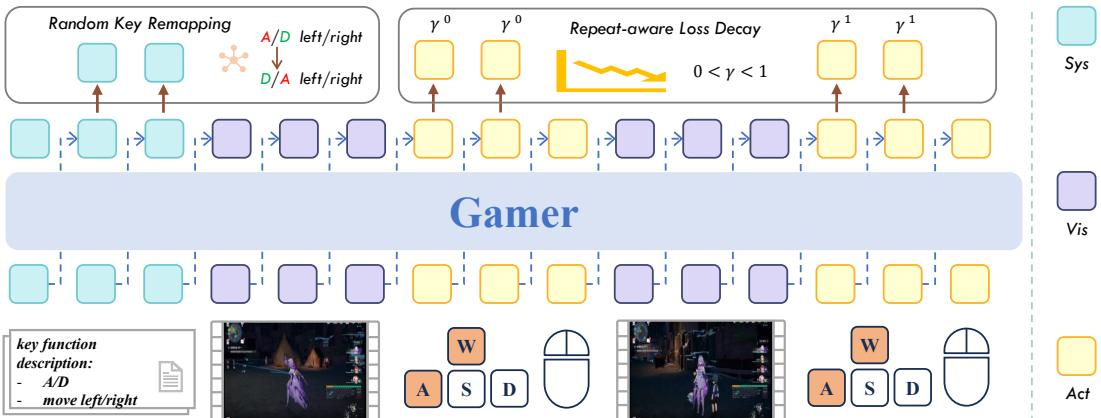
作者将预训练多模态模型适配到统一的设备级接口,使用屏幕观测和原生键盘鼠标输入。他们将游戏轨迹表示为交替的观测和动作,将视觉决策与低层动作执行解耦。观测以 5 Hz 采样,每个区间被划分为六个键盘鼠标动作块,得到 30 Hz 的动作率。区间 t 的动作定义为 at=(ΔPt;Kt,1,…,Kt,6),其中 ΔPt 是累计鼠标移动,Kt,j 是块 j 中按下的键集合。为了解决键频率不均和重复动作带来的偏差,作者采用随机键重映射和重复感知损失衰减。随机键重映射在可重新绑定的键上采样随机双射,以降低对键身份的依赖;重复感知损失衰减使用 ωt=γnt−1 对连续重复动作进行降权,以强调行为转换。
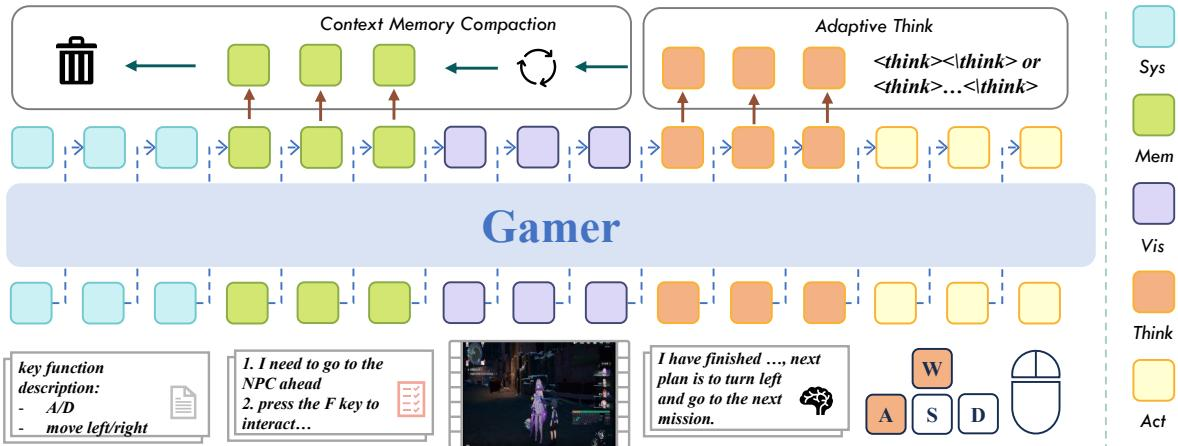
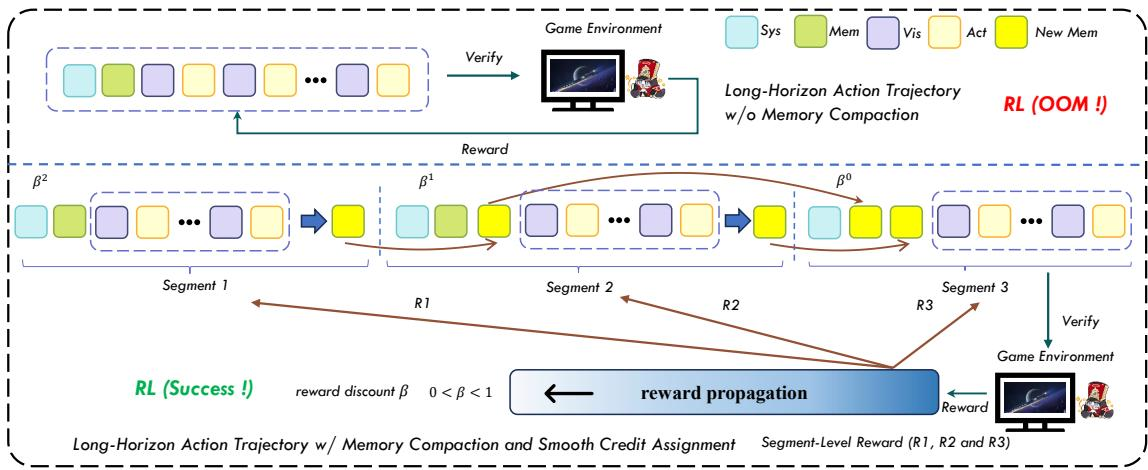
为了让模型遵循明确的任务目标,作者使用多级任务条件进行监督微调。策略以任务指令 I 和长期记忆 Mt 为条件,同时以控制规范 B 和近期交互历史 Ht 为条件。指令在三个难度级别上实例化:局部操作、中间子目标和完整任务。模型在生成可执行动作 at 前会生成可选推理序列 rt。常规控制步骤跳过推理,而决策关键步骤则生成显式推理或记忆摘要。上下文记忆压缩通过总结历史来在旧交互离开活跃上下文之前保留任务进度。
对于长时程策略优化,作者引入了时序感知 GRPO(TA-GRPO),以应对交互超出模型上下文窗口的挑战。TA-GRPO 将长 rollout 划分为有限片段,并通过与监督微调中相同的记忆压缩机制连接。来自同一任务不同 rollout 的片段使用环境可验证结果进行评分。时序信用分配机制将片段级优势 Ag,m 分配给各个决策,对时间上更接近已验证结果的后续步骤赋予更大权重,使用 dg,m,t=Tg,m1∑u=0Tg,m−1βTg,m−1−uβTg,m−1−t。
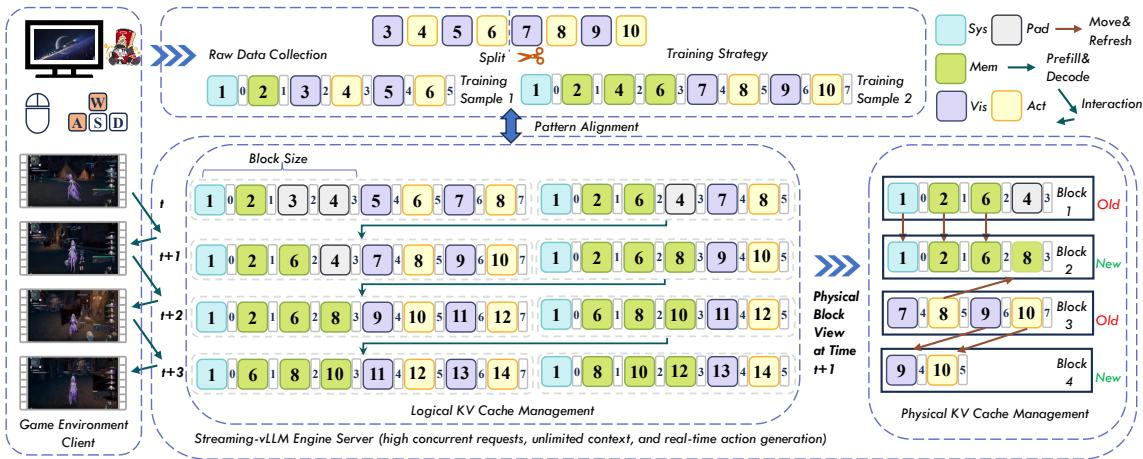
为了满足实时游戏过程的时间约束,作者开发了 Streaming-vLLM 作为通用执行后端。它保留已保留上下文的 KV 状态,只对新追加的 tokens 计算新状态,遵循有状态流式推理。短期队列保存近期的完整交互轮次,而长期队列存储生成的记忆摘要。在压缩边界处,策略在驱逐之前总结历史,并且相应缓存键的旋转相位使用位置偏移更新,而无需重新计算其投影。
作者开发了可扩展的标注流水线,将异构原始游戏录像转化为用于长时程任务遵循的监督数据。他们过滤无效录像并平衡场景覆盖。使用大语言模型,生成稀疏动作推理、带指令的任务片段和任务状态记忆。这些标注被组织为三级指令层级:简单指令覆盖局部操作,中等指令将相关操作组合为中间子目标,困难指令将多个子目标连接为扩展任务阶段。
实验
评估结合了公开游戏基准、受控的 120 配置 GameScaling 研究,以及留出的《崩坏:星穹铁道》支线任务和小游戏,以验证跨游戏控制、长时程指令遵循和实时在线 RL。GameScaling 显示,继续预训练首先使模型适应共享的键盘鼠标接口,而后续收益取决于相关游戏的覆盖;差异较大的未见游戏在早期适应后趋于平台期或性能下降。在《崩坏:星穹铁道》上,HSR 增强的 CPT 提供了控制基础,SFT 大幅改善了留出任务执行和小游戏泛化,而带游戏原生验证的在线 RL 带来了进一步收益。实时 Streaming-vLLM 在降低延迟的同时保持流式视觉理解,及时的 rollouts 对于稳定有效的在线策略学习至关重要。
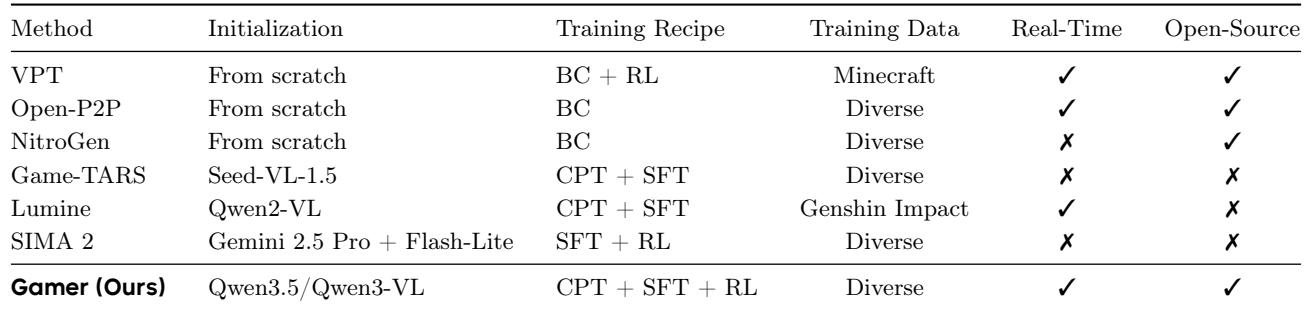
Gamer 从 Qwen3.5 或 Qwen3-VL 初始化,并在多样数据上通过继续预训练、监督微调和强化学习进行训练。在比较的 game agents 中,它是唯一同时具备实时推理和开源发布,并使用这种多阶段训练方案的。其他开源 agents 主要依赖行为克隆或行为克隆加强化学习,且从头训练。Gamer 是唯一同时结合实时推理、开源可用性和 CPT 加 SFT 加 RL 训练方案的比较 agent。在开源 agents 中,Gamer 是唯一从预训练视觉-语言模型初始化而不是从头训练的。使用预训练视觉-语言初始化的 agents 通常会牺牲开源发布或实时推理,而 Gamer 两者都保留,并使用多样训练数据。
Gamer 的训练数据结合了跨游戏游戏过程、通用多模态来源、分层任务监督和在线策略经验。预训练混合以游戏轨迹为主,同时保留较小的通用视觉-语言组成部分。监督微调在操作、子目标和任务级别之间分配样本,没有单一级别占主导。CPT 阶段以 85:15 的比例将约 2.4K 小时的跨游戏过程与通用多模态来源混合。SFT 监督在操作级、子目标级和任务级示例之间拆分,其中操作级样本占比最大,为 37.0%。RL 使用约 14.6K 条经过验证的在线轨迹进行策略优化。
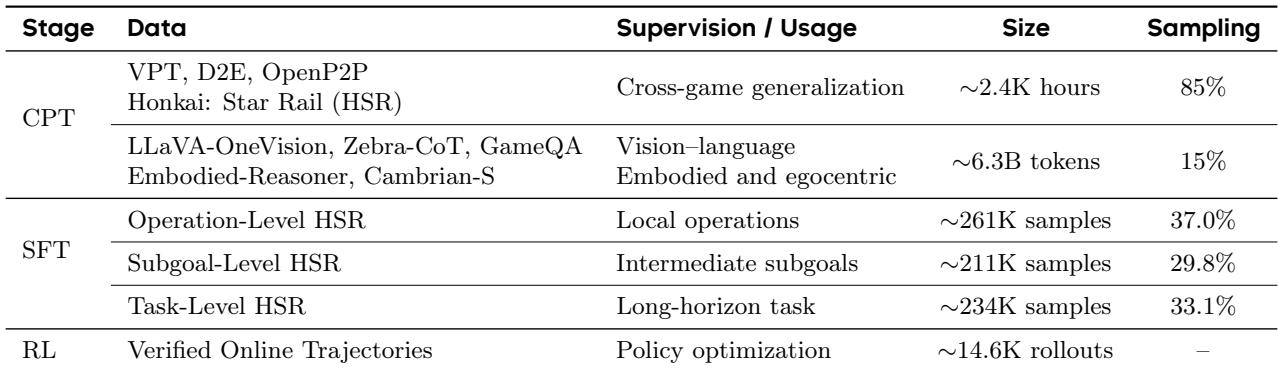
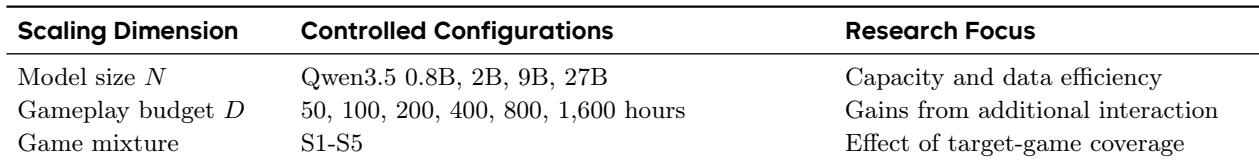
受控缩放研究在大型配置网格上改变模型大小、游戏过程预算和游戏混合。游戏轨迹占训练 tokens 的大部分,其余来自固定的通用多模态池。游戏混合从仅 Minecraft 的游戏过程变化到不含 Minecraft,而其余游戏过程数据来自共享的多游戏池。模型大小从不足十亿参数到数百亿参数,以研究容量和数据效率。游戏过程预算从几十小时到超过一千小时,以研究额外交互带来的收益。Minecraft 覆盖从全部游戏过程数据减少到无,其余游戏过程部分从多游戏池中采样。
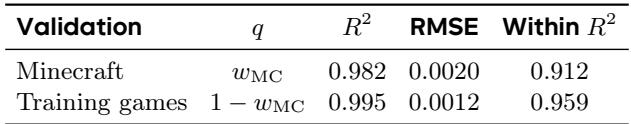
组合感知的缩放关系在 Minecraft 和训练游戏分布上都紧密拟合了验证损失。训练游戏验证显示最强的整体拟合和最低误差,而 Minecraft 验证准确性略低但仍然很强。混合物内部解释方差低于整体拟合,表明不同混合物之间的均值差异对该关系的解释力有所贡献。训练游戏验证在报告条件下实现了最高的拟合准确度和最低 RMSE。Minecraft 验证也显示出高解释方差,但其混合物内部拟合弱于训练游戏的混合物内部拟合。
CPT 训练的策略在四个游戏基准上取得了高于所列通用多模态基线的平均实时得分,无论使用 Dense 还是 MoE 骨干。通用模型在实时与时间暂停的差异上往往为负,而 CPT 策略更稳健,MoE CPT 策略平均甚至有所提升。CPT 检查点在各个游戏中表现出互补优势,其中 MoE 策略在 MCU 上尤其强。来自两个评估骨干的 CPT 策略在平均实时得分上均超过最强的所列通用基线。大多数通用基线在实时交互下性能下降,而 Dense CPT 策略仅显示适度下降,MoE CPT 策略则显示正的 RT-TP 平均差异。CPT 的最明显优势出现在 MCU 上,两个 CPT 骨干在四个基准上具有互补优势。
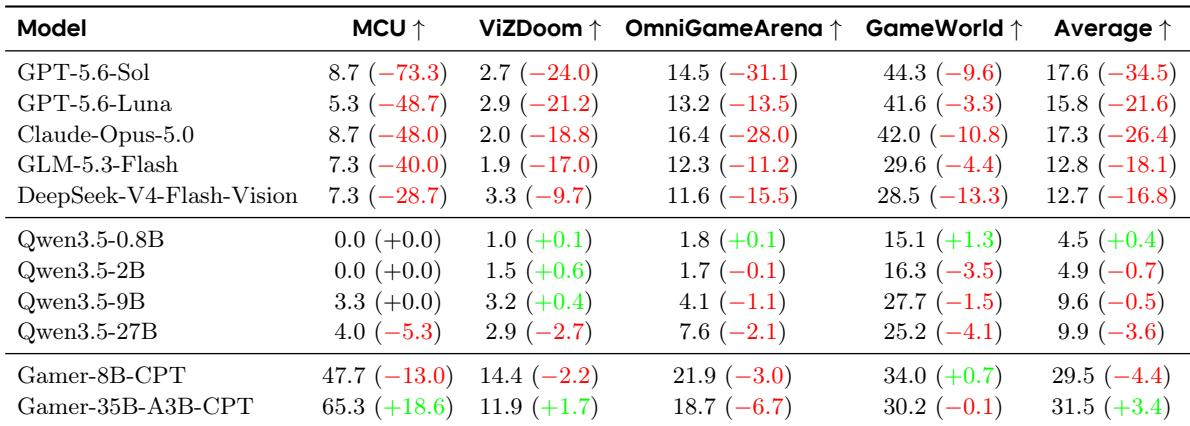
Gamer 作为一个开源 agent 进行评估,它从预训练视觉-语言模型初始化,并通过继续预训练、监督微调和强化学习进行训练,这与主要依赖从头行为克隆的基线不同。其数据混合将大规模跨游戏游戏过程与通用多模态来源、分层监督和在线策略经验相结合,而受控缩放研究改变模型大小、游戏小时数和 Minecraft 覆盖,以考察缩放行为。组合感知缩放关系紧密跟踪验证损失,尤其是在训练游戏数据上,CPT 训练的策略在平均实时得分上优于通用多模态基线,其中 MoE 检查点表现出互补优势并在 MCU 上获得显著提升。