Command Palette
Search for a command to run...
AscendGYM:面向昇腾 NPU 真实工作负载的成本感知内核优化基准
AscendGYM:面向昇腾 NPU 真实工作负载的成本感知内核优化基准
摘要
内核优化对于在昇腾 NPU 上高效训练和推理大语言模型(LLM)至关重要。现有的昇腾内核基准主要关注内核生成,较少强调智能体在来自真实工作负载的输入配置下优化现有实现的能力。为满足这一需求,我们提出了 AscendGYM,其初始套件包含三个难度级别的 48 个内核。每个内核都配有测试用例,其数据类型和张量形状采集自真实的训练与推理任务。因此,AscendGYM 上的性能提升可直接映射到相应的工作负载。在易用性方面,AscendGYM 支持两种评估模式:模型评估和模型–测试框架评估,可用于衡量训练模型和自定义智能体的内核优化能力。它提供了一个完整的执行环境,高度还原了实际流水线中昇腾内核的调用方式。对于模型评估,它还内置了一个配备搜索编排和经验积累功能的测试框架。最后,我们提出了一个新指标——加速比–令牌得分(STS),用于量化相对于令牌成本的性能收益。通过同时考虑加速比和成本,STS 能够在可接受的预算下评估模型或测试框架的实际内核优化能力。AscendGYM 可在 https://github.com/SLAI-AITP/AscendGYM 获取。
一句话总结
深圳环路研究所的研究人员提出了 AscendGYM,一个面向 Ascend NPU 的成本感知内核优化基准,包含三个难度级别的 48 个内核和来自真实负载的测试用例,支持通过内置 harness 进行模型评估和模型-harness 评估,并提出 Speedup-Token Score,用于评估实际内核优化收益相对于 token 成本的表现。
核心贡献
- 论文提出了 AscendGYM,一个面向 Ascend NPU 的内核优化基准,包含三个难度级别的 48 个内核、完整可运行的初始源代码,以及取自真实 LLM 训练和推理负载的输入配置。
- 提供了 AscendForge,一个用于候选代码编译、正确性检查和性能测量的执行环境,支持带内置 harness 的模型评估和模型-harness 评估。
- 提出了 Speedup-Token Score (STS),一种将性能收益与累计 token 成本结合起来的指标,并报告了 17 个任务上的 Batch 1 结果,表明该基准仍然具有挑战性,且 STS 能揭示仅凭加速比无法捕捉到的差异。
引言
高效的大语言模型训练和推理在很大程度上依赖底层内核性能,而在 Ascend NPU 上针对真实负载优化现有内核是一项关键工程任务。以往的基准主要评估模型能否根据任务规范生成正确的内核,但没有在源自负载的输入配置和明确的资源预算下,系统评估对已有正确实现的迭代优化。作者提出了 AscendGYM,一个包含 48 个内核优化任务的基准,这些任务取自真实的 LLM 训练和推理负载。该基准提供可运行的基线实现、与负载匹配的输入形状和数据类型、名为 AscendForge 的执行沙箱,用于编译、正确性检查和性能测量,以及一个 Speedup-Token Score,共同衡量已实现的加速比和 token 消耗。在 Batch 1 上的评估显示,大多数当前 agent 仅取得有限收益,这证明优化现有 Ascend 内核仍然具有挑战性。
数据集
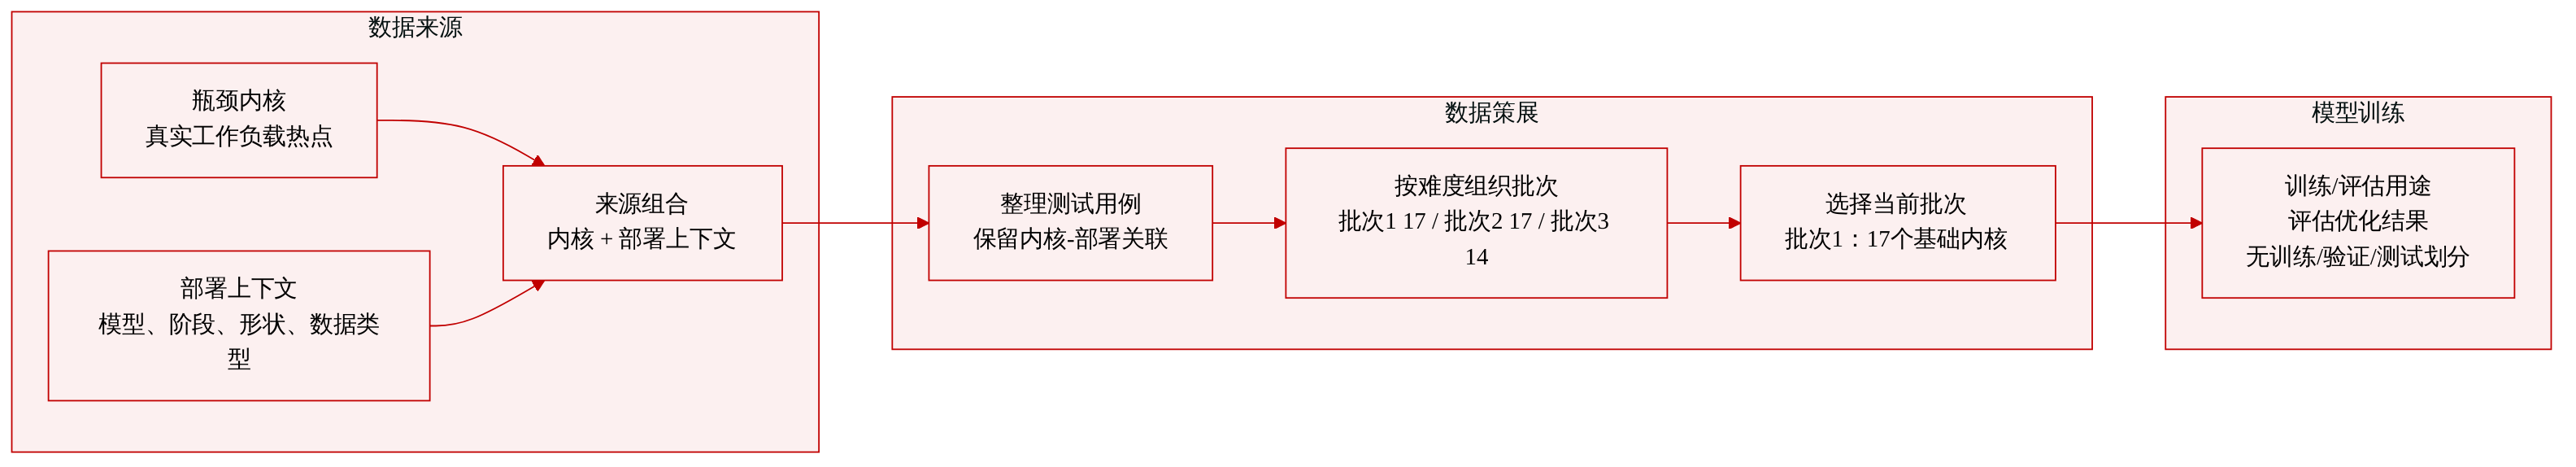
作者将 AscendGYM 描述为面向 Ascend NPU 的内核优化基准,而不是模型训练数据集。它旨在评估模型-harness 系统能否在一致的规则下改进现有内核实现。
数据集构成和来源
- 该基准有四个主要组成部分:
- 内核优化任务集和测试用例
- AscendForge 评估环境和工具
- 评估指标
- 共享评估工作流
- 任务来源于在真实负载中具有显著性能影响的瓶颈内核。
- 任务被组织为三个难度批次:
- Batch 1:17 个基础内核,侧重于内存访问优化
- Batch 2:17 个任务,涵盖归一化和量化等多步计算
- Batch 3:14 个任务,涵盖复杂注意力机制和融合计算,包括稀疏注意力
- 当前论文仅评估 17 个 Batch 1 任务。Batch 2 和 Batch 3 的结果留待后续更新。
测试用例设计和元数据
- 每个测试用例保留了内核输入与部署上下文之间的联系。
- 上下文包括:
- 目标模型
- 执行阶段
- 硬件和并行配置
- 张量形状
- 数据类型
- 计算参数
- 例如,AddRMSNorm 任务捕捉了 Qwen3-0.6B 推理前向过程中残差加法后接 RMS 归一化的计算。
- 该测试用例使用:
- Prefill 阶段
- 无量化
- Eager 执行
- 单 NPU
- 张量并行度为 1
- BF16 精度
- 批大小为 1
- 输入序列长度 32 tokens
- AddRMSNorm 的性能分析元数据显示,每次前向过程调用 56 次,占总计算时间的 8.77%,并按累计执行时间排在前 5 个内核中。
处理和评估用途
- 该基准提供任务和执行反馈,用于评估优化结果。
- 评估覆盖多个部署场景、特定形状和场景下可实现的最佳性能,以及优化成本。
- 这些维度用于刻画:
- 跨用例适用性
- 形状特化
- 优化效率
- 未报告训练划分或数据混合比例,因为 AscendGYM 用于评估,而不是用于模型训练。
方法
AscendGYM 将内核优化任务组织为三个难度递增的批次,从基本独立的内核逐步过渡到多阶段融合和复杂执行协调。Batch 1 侧重于基础内核的内存访问优化,Batch 2 涵盖归一化和量化等多步计算,Batch 3 针对复杂注意力机制和融合计算。任务选择优先考虑在真实负载中具有显著性能影响的瓶颈内核。每个测试用例保留内核输入与其部署上下文之间的联系,包括目标模型、执行阶段、硬件和并行配置以及由此产生的张量形状。这种上下文将测得的内核加速比与真实负载中相应的算子调用联系起来,使评估与部署需求保持一致。
AscendGYM 包含 AscendForge,一个面向 Ascend 的原生执行沙箱,用于候选代码编译、正确性检查和性能测量。AscendForge 在 SandboxFusion 的基础上引入了适配器,管理主机侧注册、设备侧内核、目标片上系统以及自定义内核包之间的依赖关系,从而支持面向 NPU 设备的编译和 Python 接口绑定。
如下图所示:
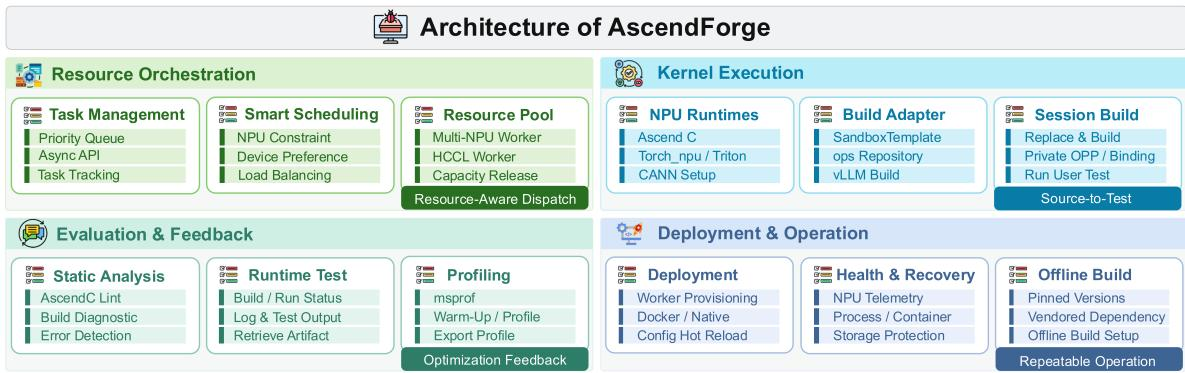
AscendForge 包含四个层次,分别用于内核构建与执行、资源调度、开发反馈以及部署与运维。执行与构建层支持 Ascend C 和 Python NPU 执行后端,并提供面向 CANN 内核仓库以及 vLLM Ascend 等项目的适配器。该层自动完成源码提交、编译与安装、Python 接口绑定和测试执行。资源编排层通过调度代理、任务队列和多个执行节点管理评估请求,并根据所需的 NPU 数量和设备型号分配资源。开发反馈层集成静态代码分析和性能分析能力,返回构建日志、正确性结果和性能测量数据,以帮助 agents 诊断错误并指导下一轮优化迭代。部署与运维层提供硬件健康监控、配置热加载和进程自动恢复。
作者利用性能-预算联合指标、独立的性能和预算指标以及可靠性指标,来评估优化结果以及达到这些结果所需的资源。
Speedup-Token Score (STS) 共同衡量在 token 预算内所取得的最佳加速比,以及获得改进所需的 token 消耗:
STS=final performance gain100log2Sn−penalty for delayed improvements50k=1∑nBmaxBkΔgk其中 Bmax>0 是 token 预算,n 是在该预算内完成的候选评估次数,Bk 表示第 k 次评估完成时的累计 token 消耗。Sk 表示第 k 次评估之后可用的、经过正确性验证的最佳加速比,相对于参考实现。增量对数加速收益为 Δgk=log2Sk−log2Sk−1。
Cost-to-Gain (CTG) 指标衡量相对于参考检查点,将加速比提高指定比例所需的额外 token 消耗:
CTG(δ;r)=r≤k≤nSk≥(1+δ)Srmin(Bk−Br),δ∈{0.01,0.05,0.10}CTG 越低,表明 token 效率越高。
对于独立性能,AscendGYM 报告 GM Speedup 和 fastp 指标。fastp 指标衡量在一个正确实现取得严格大于 p 的加速比的任务所占比例:
fastp=N1i=1∑N1[Si,ni>p],p≥1GM Speedup 使用各任务加速比的几何平均值来汇总整体性能:
GM Speedup=(i=1∏NSi,ni)1/N预算指标使用累计和平均 token 消耗、LLM 交互轮数以及墙钟时间来衡量优化成本。可靠性指标包括 Candidate Pass Rate,它衡量 LLM 或 agent harness 生成正确候选的可靠程度,以及 Task Pass Rate,它衡量在尝试过的任务中至少有一个候选通过正确性检查的任务所占比例。
AscendGYM 支持两种评估模式:模型-harness 评估,将模型-harness 对作为完整系统进行评估;以及模型评估,使用名为 AuraKernel 的默认 harness 运行模型。
如下图所示:
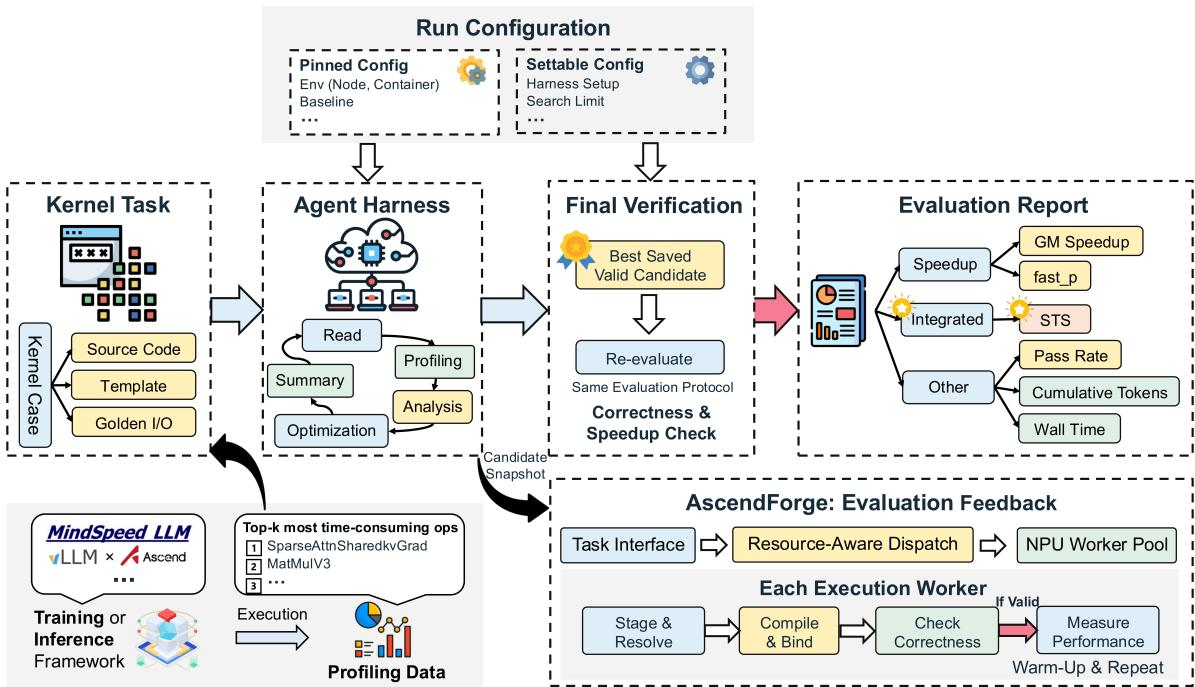
该工作流根据真实训练和推理负载构建内核优化任务。系统收集在 Ascend 框架中运行的负载的性能分析数据,以识别 top-k 瓶颈内核。每个内核优化任务包括基线源代码、指定输入和输出张量形状的模板元数据、测试输入,以及由相应 CPU 实现生成的参考输出。启动评估时,用户配置执行环境和优化设置。AscendGYM 首先测量基线性能,然后进入迭代循环,依次进行瓶颈分析、代码优化、性能测量和经验总结。每个优化后的候选代码都会提交到 AscendForge 沙箱,进行编译、Python 接口绑定和正确性检查。通过检查的候选将进行性能分析,其结果会指导后续优化。搜索在资源预算耗尽或达到最大迭代次数时终止。系统随后重新验证最佳实现,并利用性能测量和优化轨迹计算定义的指标。
实验
AscendGYM 通过 AscendForge 沙箱执行和两种模式评估 NPU 内核优化:使用 Claude Code、Codex CLI 和 OpenCode 的模型-harness 对,以及使用 Default AuraKernel harness 的仅模型评估。实验使用联合 speedup-token 和 cost-to-gain 指标,以及性能、预算和可靠性度量,在 10M、20M 和 50M token 预算下比较不同方法。实验表明,仅看最终加速比会掩盖收益何时取得以及以何种成本取得,而通过率和总体加速比可能出现背离。当前系统大多只取得有限改进,约 70% 的模型-harness 组合几何平均加速比低于 1.2 倍,并且 warm Default 配置在模型评估中表现最佳,表明 harness 配置和预算约束都会对优化结果产生实质性影响。