Command Palette
Search for a command to run...
超越应答:学会在流式视频中主动发言与行动
超越应答:学会在流式视频中主动发言与行动
摘要
大多数 AI 助手仅在收到提示时才作出回应,即使视频流中的事件提供了有意义的对话机会,也始终保持沉默。为了超越纯粹由用户驱动的交互,我们提出了 AURA 2.0,一个流式视频大语言模型,在 AURA 的基础上引入了三项核心升级。关键进展是模型主动发起对话(MIC),使模型能够在不断演变的视觉流中识别值得讨论的话题,并在没有用户提问的情况下于适当时机发起对话。流式感知工具调用(SATC)使模型能够利用当前视觉和对话上下文调用外部工具,对所见内容采取行动,并将返回的信息纳入正在进行的交互中。交互式视觉定位(IVG)同时支持用户输入和模型输出中的视觉定位。模型能够识别用户在视频帧上标记的对象,并生成与帧对齐的边界框,从而将其回应与特定对象和区域关联起来。为发展这些能力,我们构建了一个专用的流式交互数据集,并采用三阶段训练方案,将新行为与 AURA 现有的流式交互能力相整合。我们进一步引入长时程交互记忆(LHIM),以在长时间视频流中保持上下文连续性。在公开流式基准上的评估表明,AURA 2.0 在开源流式模型中取得了领先性能,而针对性评估进一步验证了其新的交互能力。
一句话总结
来自华为研究院、CUHK MMLab 和香港科技大学的研究人员提出 AURA 2.0,这是一种流式视频大语言模型,它通过模型发起对话、流式感知工具调用、交互式视觉定位和长时程交互记忆扩展了 AURA;在专门的流式交互数据集上训练后,它在公开基准上取得了开源流式模型中的领先性能。
核心贡献
- AURA 2.0 是一种流式视频大语言模型,其核心进步是模型发起对话:它从不断演变的视觉观察和对话历史中识别值得讨论的话题,决定何时发起对话或保持沉默,从而超越纯粹由用户提示驱动的交互。
- 该模型贡献了流式感知工具调用,它决定何时调用外部工具并将返回结果纳入持续响应中,以及交互式视觉定位,它解释用户标记的对象并为被引用的对象和区域生成与帧对齐的边界框。
- 为开发这些能力,构建了专门的流式交互数据集和三阶段训练方案,并使用长时程交互记忆实现上下文连续性。在四个公开流式基准上的评测显示领先的开源性能,针对性评测显示有用的 MIC 开场、通过工具访问提升的回答准确率,以及更少的边界框输出缺失。
引言
流式 VideoLLM 增量处理传入帧,并协调持续的视觉感知与响应决策,使模型在观察期间保持沉默,并仅使用目前所见内容进行回答。上下文管理和记忆机制有助于在长视频流中保持连续性。然而,此前的交互在很大程度上仍由用户驱动:模型根据既定指令和监控规则响应用户查询或主动触发,现有系统不会在没有事先请求的情况下发起开放式对话。作者通过 AURA 2.0 解决这一差距,其主要贡献是模型发起对话,使模型能够在不断演变的视觉流中识别值得讨论的话题并在适当时刻先开口,同时还增加了流式感知工具调用和交互式视觉定位。
数据集
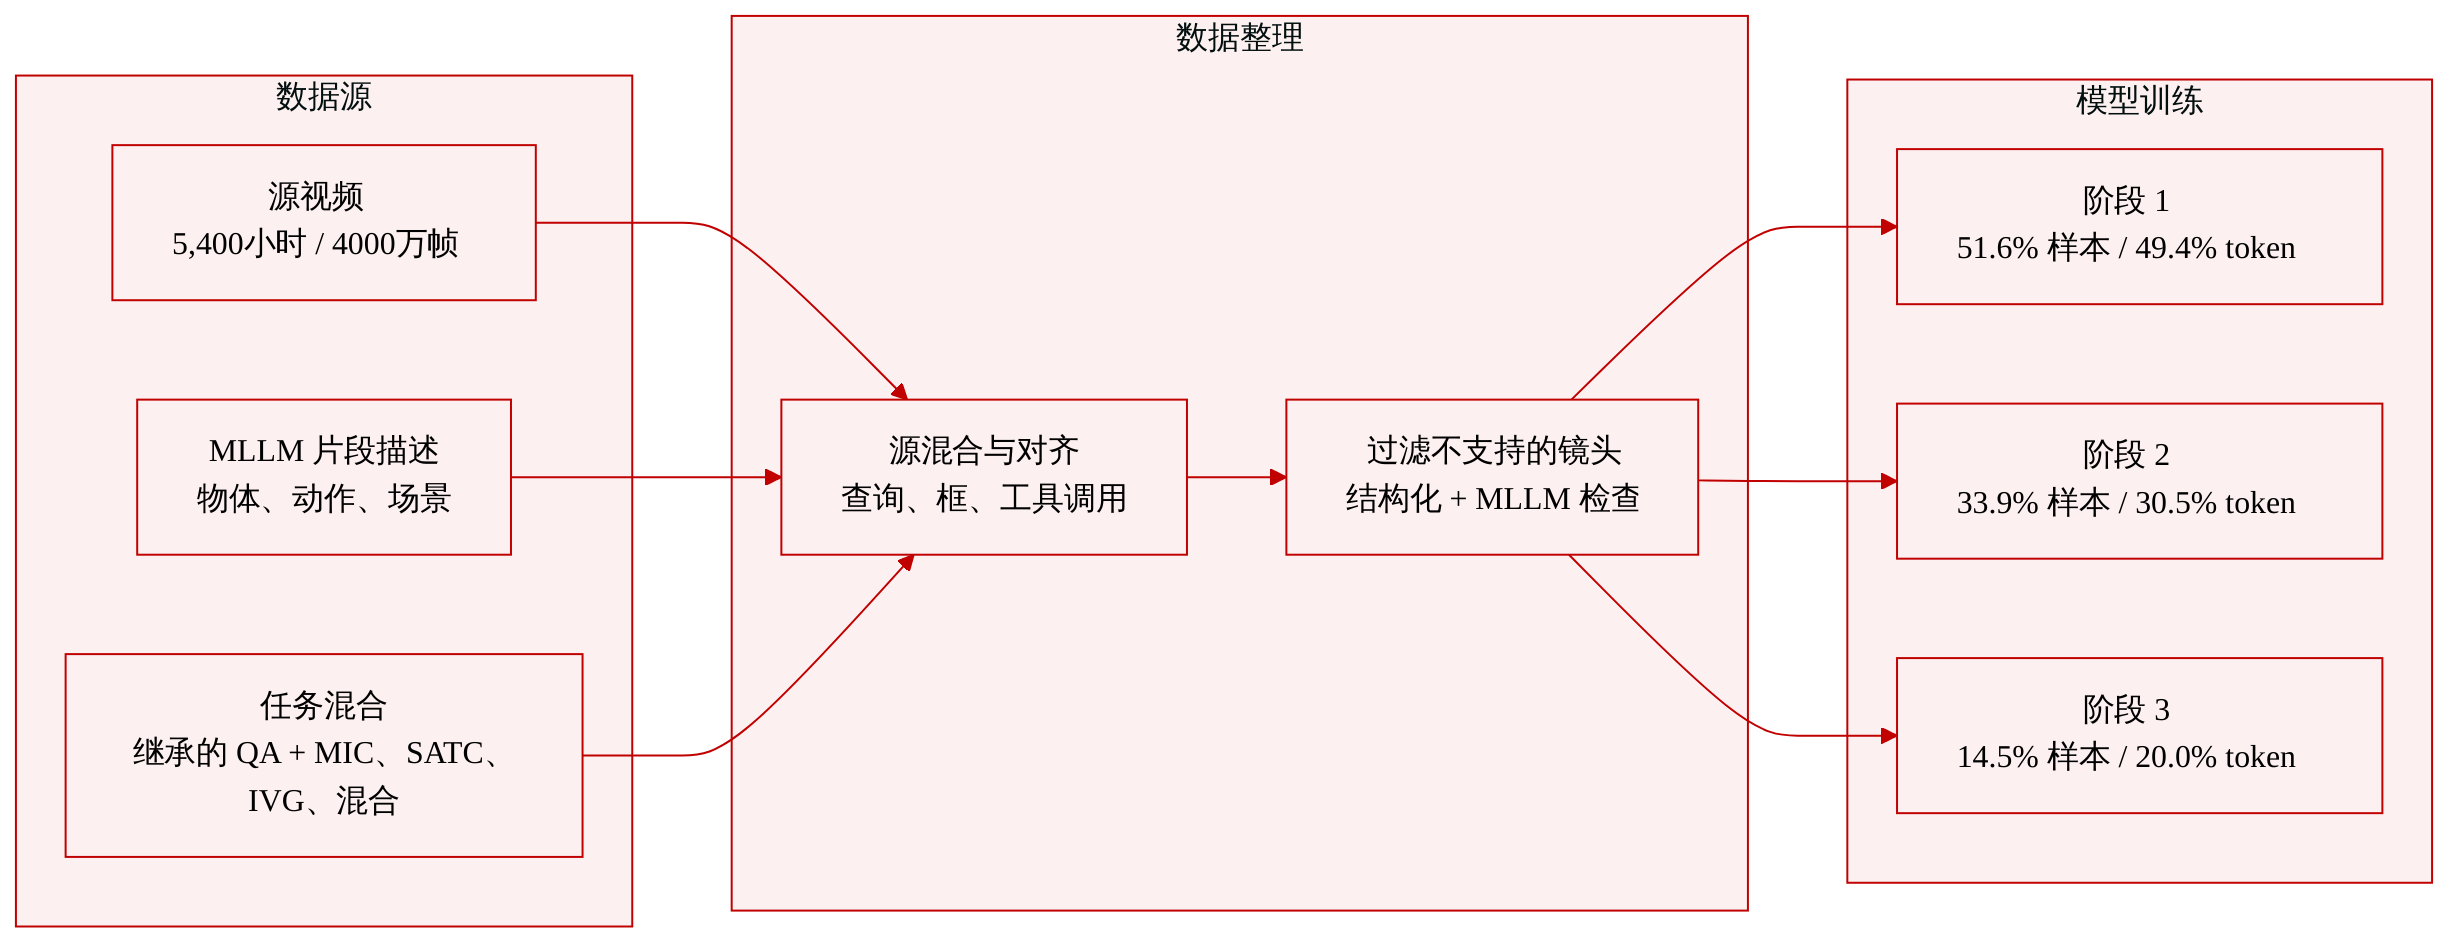
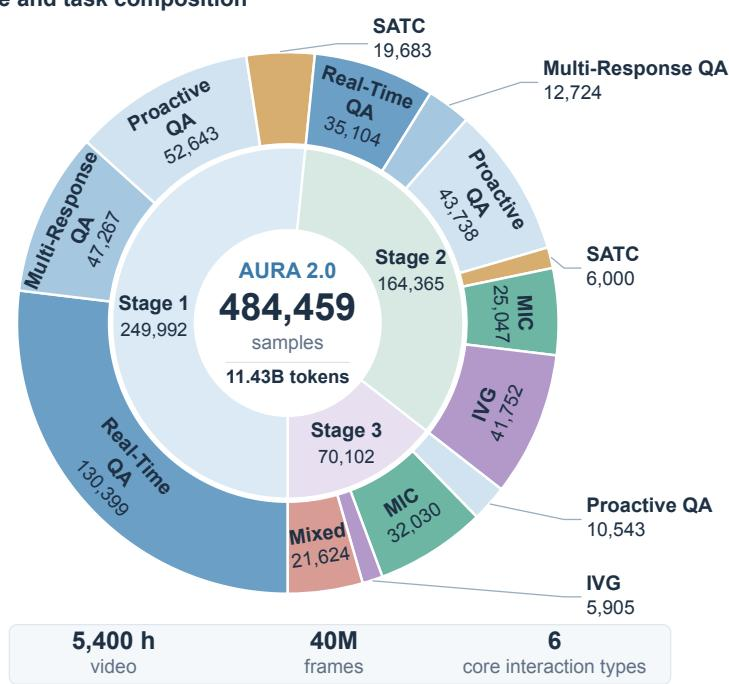
作者使用 AURA 2.0 数据流水线扩展 AURA 的流式交互数据,加入三种新的监督类型:MIC、SATC 和 IVG。源视频经过重新编码、调整尺寸并划分为片段;随后由 MLLM 生成片段级别的对象、动作和场景上下文描述。
数据集构成与来源
- 经验证的训练混合包括继承的 Real-Time QA、Proactive QA 和 Multi-Response QA,以及 MIC、SATC、IVG 和混合能力数据。
- 该流水线包含 484,459 个样本和 114.3 亿个 token,覆盖约 5,400 小时视频和 4,000 万训练帧。
- 样本和 token 数量包含跨训练阶段重放的示例,不代表不同的源视频。
子集详情
- Real-Time QA:占样本的 34.2%。监督即时回答。
- Proactive QA:占样本的 22.1%。监督在获得充分证据时的延迟响应。
- Multi-Response QA:占样本的 12.4%。监督对单个用户查询的多次响应。
- MIC:占样本的 11.8%。由 MLLM 决定何时开始对话以及说什么。每个开场都有时间戳和简短消息,并得到截至该时间戳的可用视觉观察支持。开场可以引起对某个视觉细节的注意、提供警报、给出上下文信息或建议某项活动。
- IVG:占样本的 9.8%。基于约 55,000 条来自 MeViS、Refer-YouTube-VOS、DanceTrack 和 SportsMOT 的视频定位和跟踪轨迹构建。由 MLLM 将标注重写为流式定位交互,并带有与视频帧对齐的边界框。涵盖六种模式:带框响应、多候选消歧、带解释的主观选择、多轮追问与目标切换、仅框跟踪以及目标缺失响应。
- SATC:占样本的 5.3%。结合真实执行记录与 MLLM 生成的工具调用轨迹。每条轨迹包括工具调用参数、返回结果以及后续响应。对于 50% 的非工具调用流式样本,在保留原始目标的情况下添加一到四个随机工具模式,这教会模型选择性地使用工具。
- 混合能力数据:占样本的 4.5%。组合多种能力。
处理与过滤
- 合成轨迹与视频块对齐,使查询、静默观察、响应、工具调用和边界框共享一致的时间线。
- 结构检查验证时间顺序一致性以及边界框与视频帧之间的正确对齐。
- MLLM 校验器评估响应是否得到可用视觉证据支持,并且是否发生在适当时间。对于与记忆相关的 QA,使用相关视频历史。
- MIC 开场会使用超出建议发起时间五秒的片段来审查时机和场景一致性。
- 对于 IVG,边界框会渲染在相应帧上以验证目标正确性。
- 未通过这些检查的样本会被排除在训练之外。
训练使用
- 样本分布在三个训练阶段:分别占样本的 51.6%、33.9% 和 14.5%,占 token 的 49.4%、30.5% 和 20.0%。
- 第 3 阶段的 token 占比高于样本占比,表明每个样本的平均 token 数量更高。
- 静默观察在全部三个阶段中主导响应控制目标:96.3%、94.9% 和 96.7%。这种不平衡促使训练中采用响应控制目标。
方法
AURA 2.0 采用流式架构,传入视频被组织为时序块,并与用户输入和交互历史一起增量处理。上下文通过滑动窗口保留最近的视觉观察和文本交互,使模型能够持续观察视频流并决定是否生成响应。对于每个视频块,助手在保持沉默时输出 <|silent|>,或者输出 <|respond|> 及后续响应内容,其中可以包含对话语句或工具调用。这种格式明确区分静默观察和响应生成,并在同一按块结构中容纳不同的交互行为。
如下图所示:
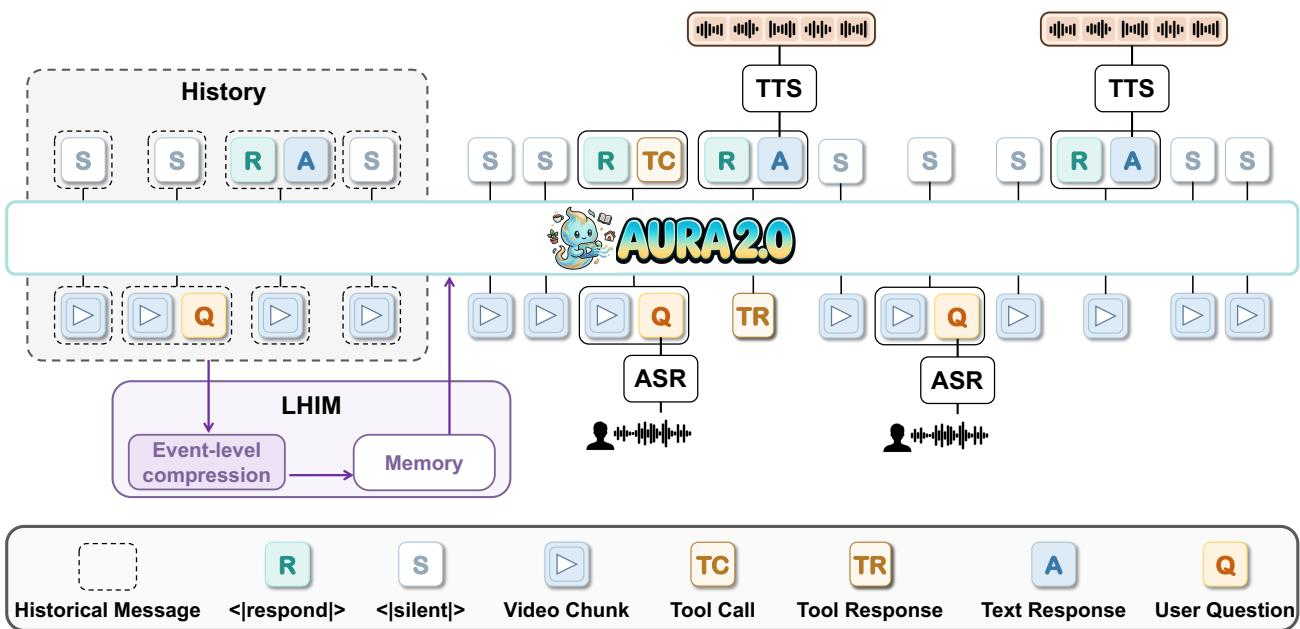
主要的架构新增是长时程交互记忆(LHIM)模块,通过辅助摘要模型实现。该模型处理离开活跃视觉窗口的视觉内容以及所有可用的文本上下文。它在事件层面组织信息,并以 QA 形式生成摘要,这些摘要被插回交互上下文,以在过去事件的视觉观察不再可用后保留其历史信息。
数据流水线以三种新的监督形式扩展流式交互数据:模型发起对话(MIC)、流式感知工具调用(SATC)和交互式视觉定位(IVG)。它从视频准备开始,到任务特定合成,最后到流式组装和质量验证。
如下图所示:
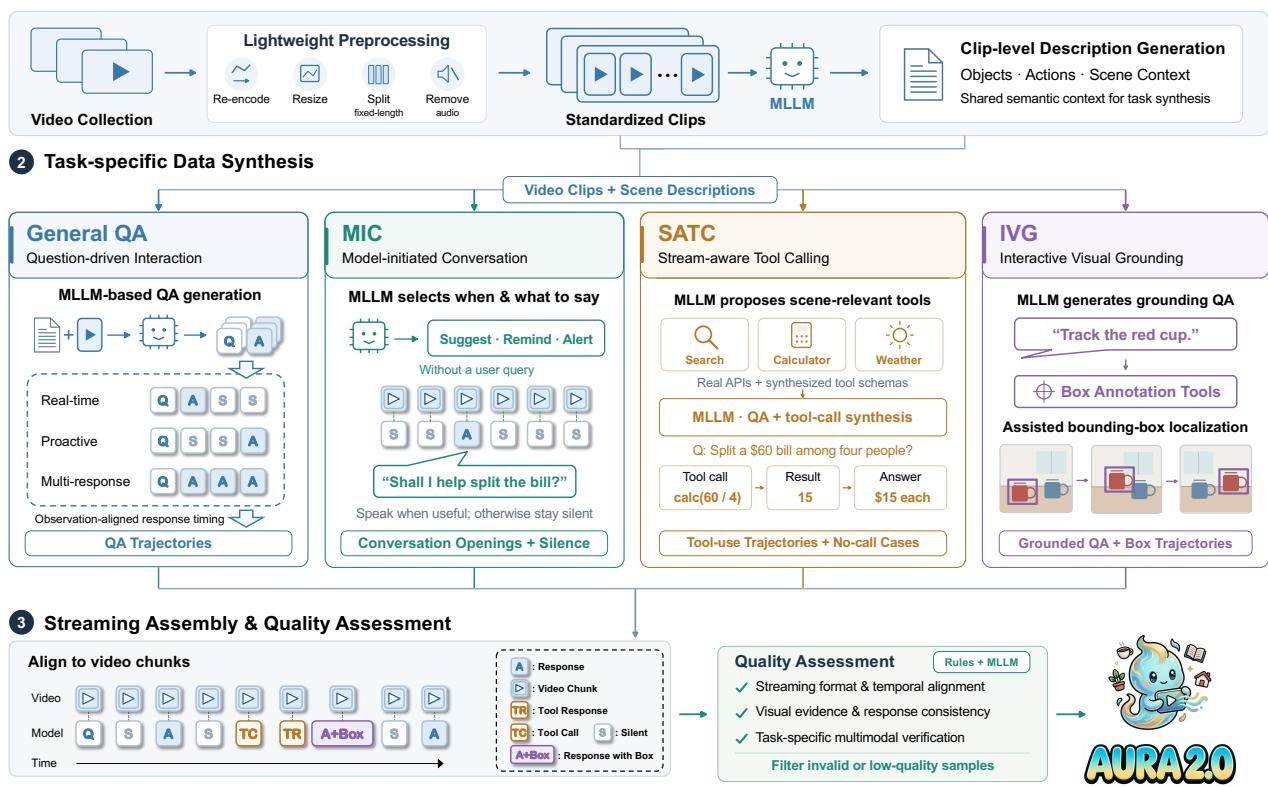
源视频经过重新编码、调整尺寸并划分为片段,由 MLLM 生成片段级别的对象、动作和场景上下文描述。MIC 数据通过要求 MLLM 决定何时发起对话以及说什么来构建,确保开场得到视觉观察支持并避免重复先前的讨论。SATC 数据结合真实执行记录与 MLLM 生成的工具调用轨迹,包括工具调用参数、返回结果和后续响应。为鼓励选择性使用工具,随机选择的工具模式被添加到非工具调用样本中。IVG 示例由视频定位和跟踪轨迹构建,其中 MLLM 将标注重写为带边界框坐标的流式定位交互。结构检查和任务特定的 MLLM 验证过滤合成轨迹,以确保时间顺序一致性和视觉证据支持。
AURA 2.0 从 Qwen3.5-9B 初始化,并采用三阶段课程逐步引入新能力,而不降低现有响应策略。
如下图所示:
第 1 阶段使用通用流式 QA 和 SATC 数据建立通用流式交互和工具使用基础。第 2 阶段使用 MIC 和 IVG 数据引入视觉定位和模型发起对话,同时重放先前的任务以防止性能退化。第 3 阶段专注于能力组合和偏好优化,在组合多种能力的示例上进行训练,例如 Proactive QA 与 SATC 的组合以及 MIC 与 SATC 的组合。
为解决静默步骤占监督控制决策 94% 以上的不平衡问题,作者将类别平衡归一化与针对控制 token <|silent|> 和 <|respond|> 的 focal 加权相结合。令 pi 表示位置 i 处真值 token 的预测概率,并令 ℓi=−logpi。使用 S 和 R 分别表示受监督的 <|silent|> 和 <|respond|> 位置集合,使用 O 表示所有其他受监督位置,训练目标为:
其中 γ=2。focal 因子降低了被自信预测的控制 token 的贡献,从而将更多重点放在困难决策上。响应文本和序列化工具调用内容使用标准交叉熵,不进行 focal 加权。两个控制类别的损失分别求平均,以确保无论各自受监督位置数量如何,都获得相等的基础权重。
为在不持续增加视觉上下文的情况下支持长时程流式视频理解,LHIM 将历史视频观察压缩为带时间戳的文本描述。上下文被组织为一个保留最近 30 秒视频和对话的滑动窗口,以及一个存储压缩视觉记忆的上下文历史。滑动窗口之前的视频被划分为 30 秒切片,并由单独的摘要 MLLM 处理,该 MLLM 将每个切片划分为语义连贯的事件。这些事件形成一级记忆记录,以纯文本 QA 对形式存储。随着会话进行,较早的记录会逐步合并为更粗略的二级和三级摘要,从而在事件分辨率下保持最近的 30 秒视觉上下文并保留近期历史。
推理延迟通过会话历史缓存、静默输入和输出的快速路径以及句子级语音交接进行优化。每个请求仅携带当前视频块的帧,并缓存在按会话划分的历史中。输出 <|silent|> 的轮次在单个解码步骤后结束,不运行语音合成;而语音合成在 MLLM 完成生成完整响应之前开始,方法是在句子边界处拆分文本并转发已完成片段。
实验
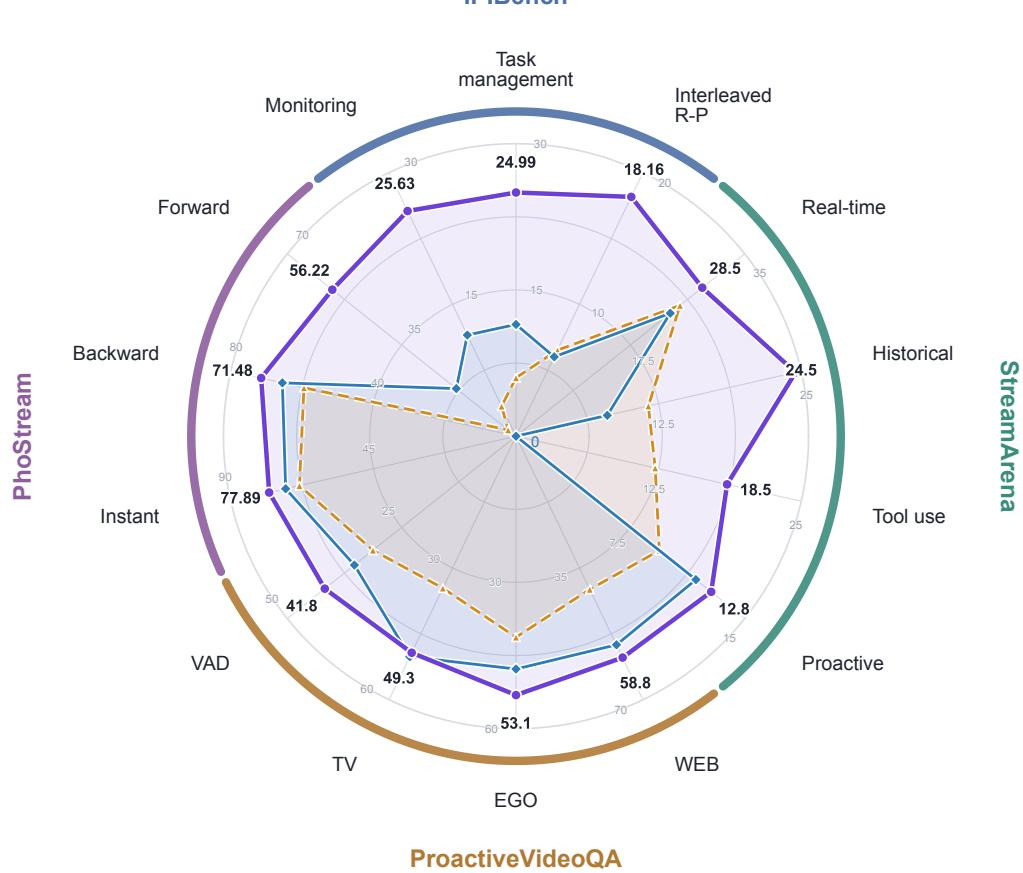
AURA 2.0 在四个公开流式基准上进行了评测,这些基准评估主动交互、历史推理、实时感知、工具使用和时间理解,同时还对模型发起对话、流式感知工具调用、交互式视觉定位和推理效率进行了针对性测试。结果显示强大的主动和前瞻时间推理能力、改进的历史检索能力,以及具有竞争力的实时感知能力,外部工具和视觉定位相比骨干模型带来了明显提升。效率测量表明响应延迟低,即使在 16 个并发会话下也能稳定地实时语音输出,服务优化大幅缩短了首次音频时间。
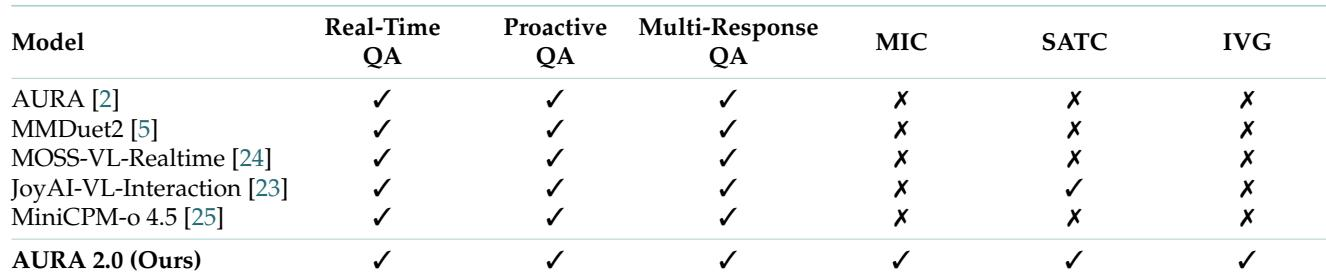
代表性流式交互模型一致支持实时问答、主动问答和多响应问答。AURA 2.0 是所列模型中唯一报告支持全部六项比较能力的模型,增加了多模态交互上下文、流式感知工具调用和交互式视觉定位。在更早的系统中,这些新增能力大多缺失,流式感知工具调用仅在 JoyAI-VL-Interaction 中有报告。所有比较模型都支持实时 QA、主动 QA 和多响应 QA。AURA 2.0 是所列系统中唯一报告支持 MIC、SATC 和 IVG 的系统。更早的模型通常缺乏 MIC 和 IVG;在先前系统中,SATC 仅在 JoyAI-VL-Interaction 中有报告。
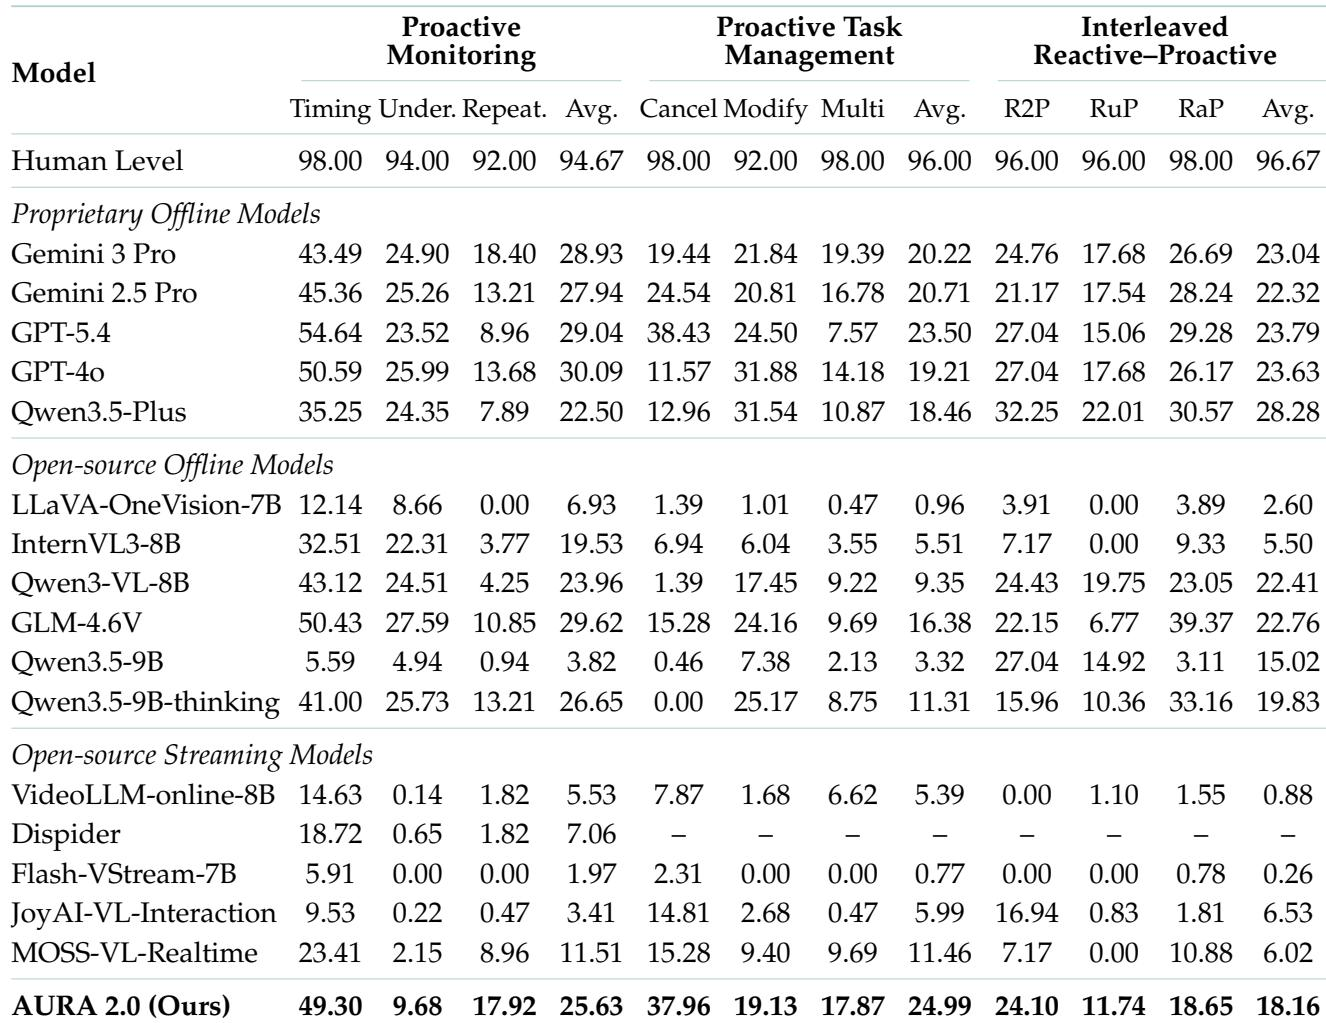
AURA 2.0 在 IPIBench 上展示了强大的主动交互性能,尤其是在主动任务管理方面,其类别平均值在所有评测模型中最高,包括专有离线系统。在主动监控方面,其时机准确率超过若干近期基线和 Gemini 3 Pro,同时接近 GPT-4o,其重复主动性得分接近 Gemini 3 Pro。人类水平得分在所有子任务中仍远高于所有模型结果。AURA 2.0 在所有评测模型中取得了最高的主动任务管理平均值,多任务管理超过 Gemini 2.5 Pro 和 GPT-5.4。AURA 2.0 在主动监控时机上优于 Qwen3.5-9B、Qwen3-VL-8B 和 Gemini 3 Pro,接近 GPT-4o,其重复主动性得分接近 Gemini 3 Pro。所有评测模型仍远低于人类水平表现,尤其是在交错反应式-主动式交互和重复主动性方面。
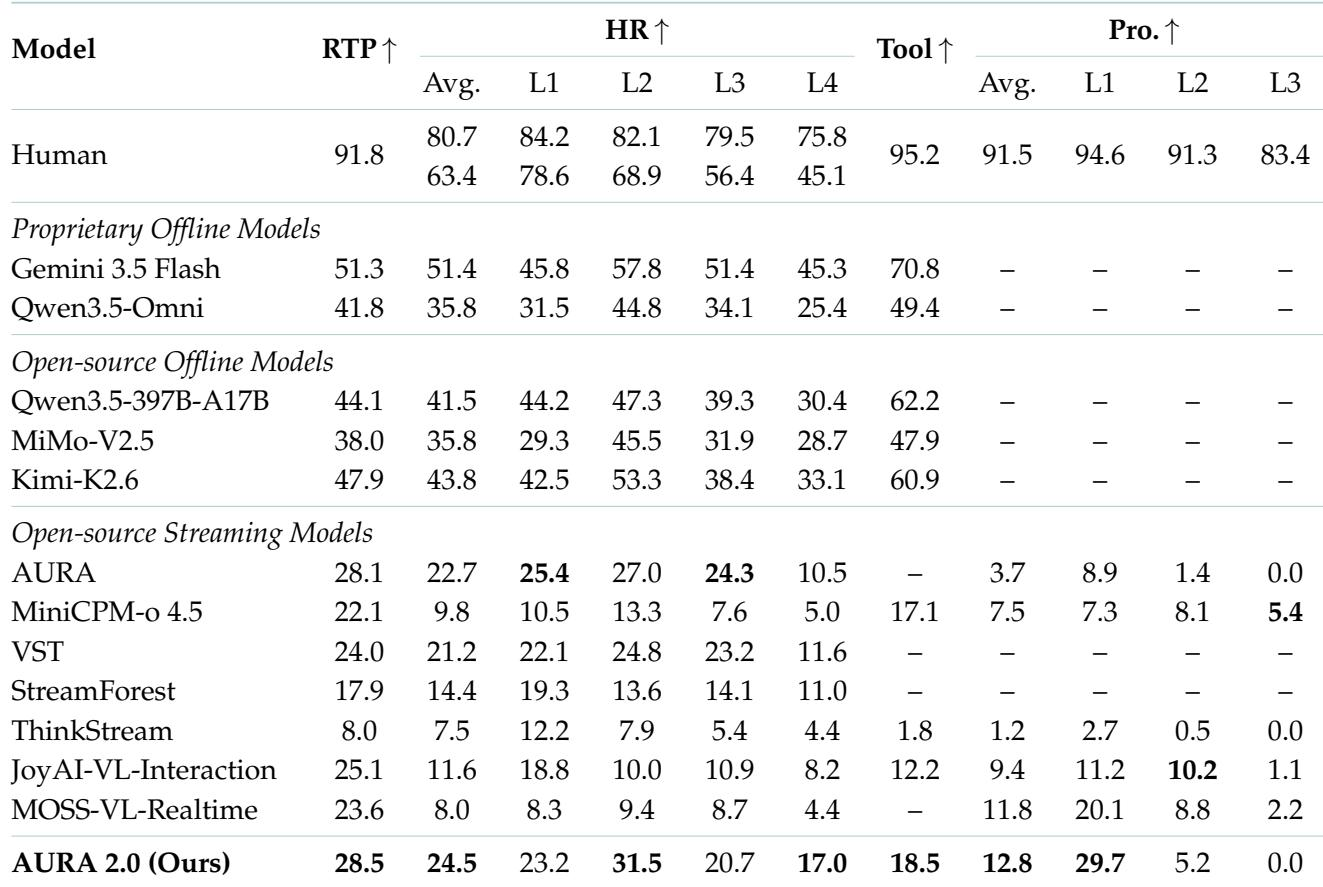
AURA 2.0 在主要 StreamArena 维度上较其前代有所提升,其中主动交互提升最大,并在长时程历史回溯方面有显著改进。它在实时感知和历史回溯方面也优于其他被评测的开源流式模型,其工具使用准确率超过所列的 MiniCPM-o 4.5 和 JoyAI-VL-Interaction 结果。人类参考在每一个报告的维度上仍遥遥领先于所有模型。AURA 2.0 在实时感知和历史回溯方面超越了 JoyAI-VL-Interaction 和 MOSS-VL-Realtime,并在所列开源流式模型中拥有最强的长时程 L4 结果。主动交互准确率从 3.7% 提升至 12.8%,超过 JoyAI-VL-Interaction 和 MOSS-VL-Realtime。工具使用准确率也超过所列的 JoyAI-VL-Interaction 和 MiniCPM-o 4.5 结果,达到 18.5%。
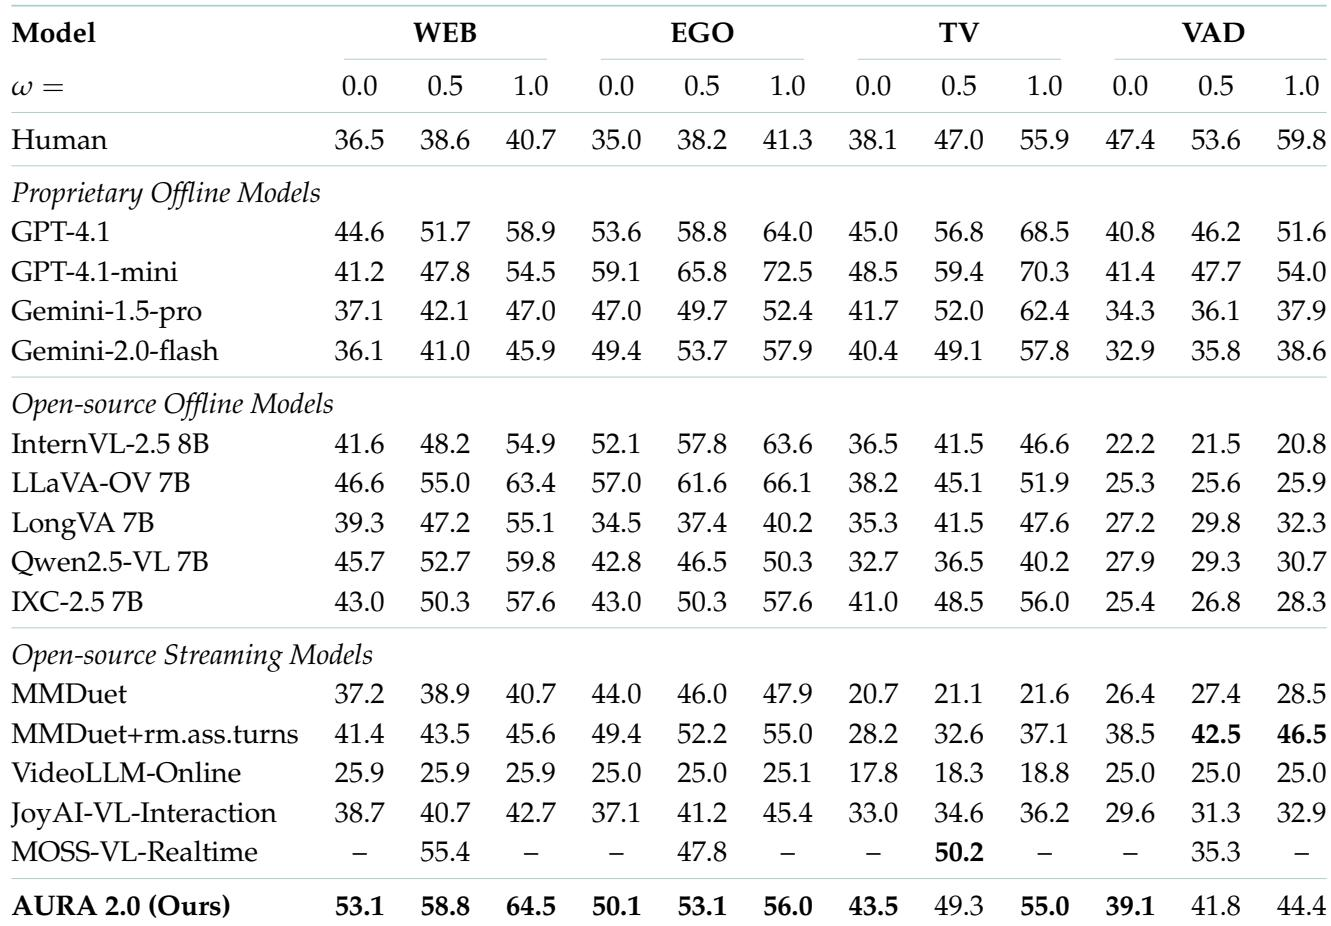
AURA 2.0 在四个 ProactiveVideoQA 类别中展示了强大的主动视频理解能力。在默认强调下,它在每个类别上都优于 JoyAI-VL-Interaction,并在四个类别中的三个上超过 MOSS-VL-Realtime。其 WEB 表现尤为强劲,在每个强调级别上都超过所有所列模型。在默认强调下,AURA 2.0 在 WEB、EGO、TV 和 VAD 上优于 JoyAI-VL-Interaction。与默认强调下的 MOSS-VL-Realtime 相比,AURA 2.0 在 WEB、EGO 和 VAD 上得分更高,而 MOSS-VL-Realtime 在 TV 上仍略微领先。AURA 2.0 在所有所列模型中每个强调级别上都取得了最佳的 WEB PAUC,包括专有离线基线。
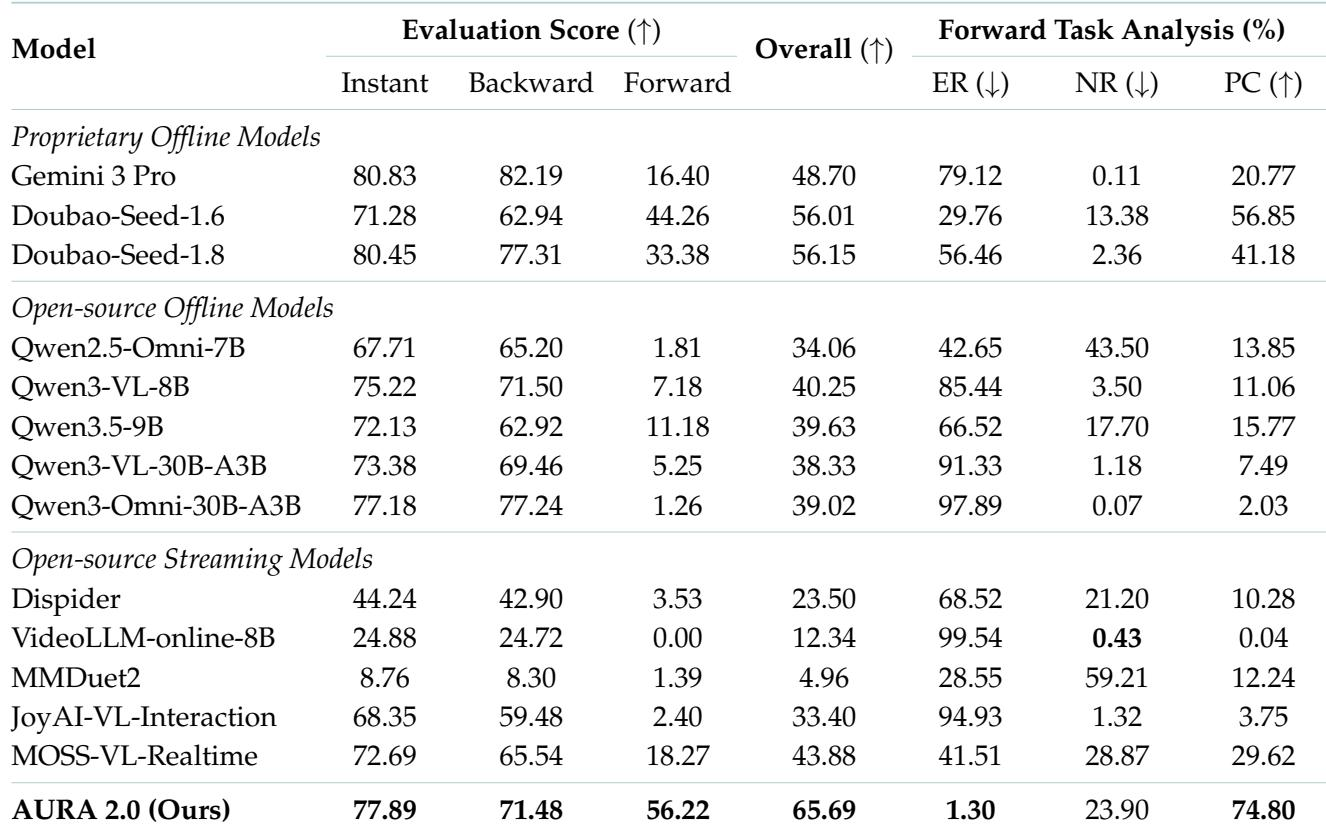
在 PhoStream 上,AURA 2.0 在已报告模型中取得了最高的 Overall 分数,并在 Instant、Backward 和 Forward 任务上领先开源流式模型。其最大的相对优势出现在 Forward 推理中,同时还报告了最低的 Early Response 率和最高的 Partly Correct 率。剩余的非零 No Response 率表明仍有一些响应被遗漏。AURA 2.0 取得了最佳 Overall 分数,并超过最强专有基线九分以上。它在 Instant、Backward 和 Forward 任务上领先开源流式模型,在 Forward 推理中优势最大。AURA 2.0 在所有所列模型中记录了最低的 Early Response 率,远低于 MOSS-VL-Realtime、Qwen3.5-9B 和 JoyAI-VL-Interaction。它还取得了最高的 Partly Correct 率,而非零的 No Response 率表明存在一些遗漏的响应。
评测涵盖流式能力覆盖、主动交互、流式理解、主动视频问答和流式推理基准。AURA 2.0 是唯一报告全部六项流式交互能力的模型,它持续领先开源基线,同时在面对专有系统时也表现出强劲结果,包括最高的主动任务管理和整体推理得分,以及最强的 WEB 表现。其主要剩余局限性是在某些流式推理任务上存在非零的无响应率,以及在交互式和主动式场景中与人类水平表现之间存在较大差距。