Command Palette
Search for a command to run...
Open Vision Banana:面向生成式视觉感知的完全开放配方
Open Vision Banana:面向生成式视觉感知的完全开放配方
Arpit Jadon Valentinos Pariza Jona Ruthardt Ryousuke Yamada A. Sophia Koepke Andrei Bursuc Yuki M. Asano
摘要
近期研究表明,预训练图像生成器编码了超越图像合成的真实世界理解能力。Vision Banana 利用这一点,将视觉任务构建为条件图像编辑。然而,其数据、权重、代码和实现细节均未公开。我们提出 Open Vision Banana(OVB),一个完全开放且可复现的配方,用于将预训练生成器转换为统一的多任务感知系统。我们的分析确定了最能影响泛化能力的设计选择,包括颜色编码、提示设计、参数适配和任务平衡。这些选择之间存在交互作用,因此单独有益的选择在与其他选择组合时可能产生不利影响。基于 4B 和 9B 参数的开源权重基础模型,并使用来自公开数据集的 210 万至 380 万个训练样本对,OVB 超越了 Vision Banana 所报告的 Cityscapes 零样本性能(73.9 对 69.9 mIoU),并可与最先进的仿射不变深度估计器相媲美。其非零样本变体在指代分割和推理分割上与 Vision Banana 的差距在五个百分点以内,但在实例分割上仍落后较多。所有模型都在很大程度上保留了基础模型的图像编辑能力。通过图例集成,我们引入了一种面向基于生成器的感知的测试时扩展方法。该方法在多个类别-颜色图例下对图像进行分割,并通过多数投票融合结果,从而纠正不稳定的颜色-类别绑定,在无需重新训练的情况下,在 Cityscapes 上将 mIoU 提升最多 8.7 个百分点,在 COCO-Object 上提升最多 15.0 个百分点。我们公开了数据集构建与处理流程、训练与评估代码,以及最终、中间和消融检查点。
一句话总结
来自 Fundamental AI Lab、纽伦堡工业大学、DLR、AIST 等机构的研究者提出 Open Vision Banana,这是一个完全开放且可复现的方案,用于将预训练生成器转换为统一多任务感知系统,在 Cityscapes 零样本上超越 Vision Banana,并引入 legend ensembling,这是一种测试时扩展方法,无需重新训练即可在 Cityscapes 上将 mIoU 提升最多 8.7 个点,在 COCO-Object 上提升最多 15.0 个点。
核心贡献
-
Open Vision Banana(OVB)提供了一个完全开放且可复现的方案,用于将预训练图像生成器转换为统一多任务感知模型,涵盖四项分割任务、深度估计和表面法线估计,并发布数据流水线、训练代码和模型检查点。从 4B 和 9B 开放权重基础模型以及 210 万到 380 万公开训练对开始,OVB 超越 Vision Banana 报告的 Cityscapes 零样本性能(73.9 对 69.9 mIoU),与最先进的仿射不变深度估计器相当,并在很大程度上保留图像编辑能力。
-
受控实验确定了最影响泛化能力的设计选择,包括颜色编码、提示设计、参数适配和任务平衡,并表明这些选择之间存在交互。最终方案倾向于随机且分离良好的调色板、相对逆深度和全 Transformer 适配,同时揭示了感知精度与保留生成质量之间的权衡。
-
Legend ensembling 被引入为一种无需训练的测试时扩展方法,用于基于生成器的分割。它在多个类别颜色图例下对每张图像进行分割,并通过多数投票融合结果,纠正不稳定的颜色与类别绑定,无需重新训练即可在 Cityscapes 上将 mIoU 提升最多 8.7 个点,在 COCO-Object 上提升最多 15.0 个点。
引言
图像生成模型现在可以生成逼真的视觉内容,最近的研究表明这种能力可以被重新用于通用视觉感知。Vision Banana 表明,一个专有图像生成器可以被适配为以 RGB 图像形式输出预测,在分割和几何任务上与领域专家模型相当,同时保留编辑能力,但其封闭的基础模型、数据和代码使得该方案难以复现,且不清楚哪些设计选择是重要的。为了解决这一问题,作者引入 Open Vision Banana(OVB),这是一个完全开放的方案和模型家族,将公开图像生成器转换为感知模型。他们系统地研究训练数据、目标表示、提示设计、适配参数和推理读出方式,并引入 legend ensembling,这是一种无需训练的测试时方法,通过融合多个随机化调色板预测来提高分割精度。
数据集
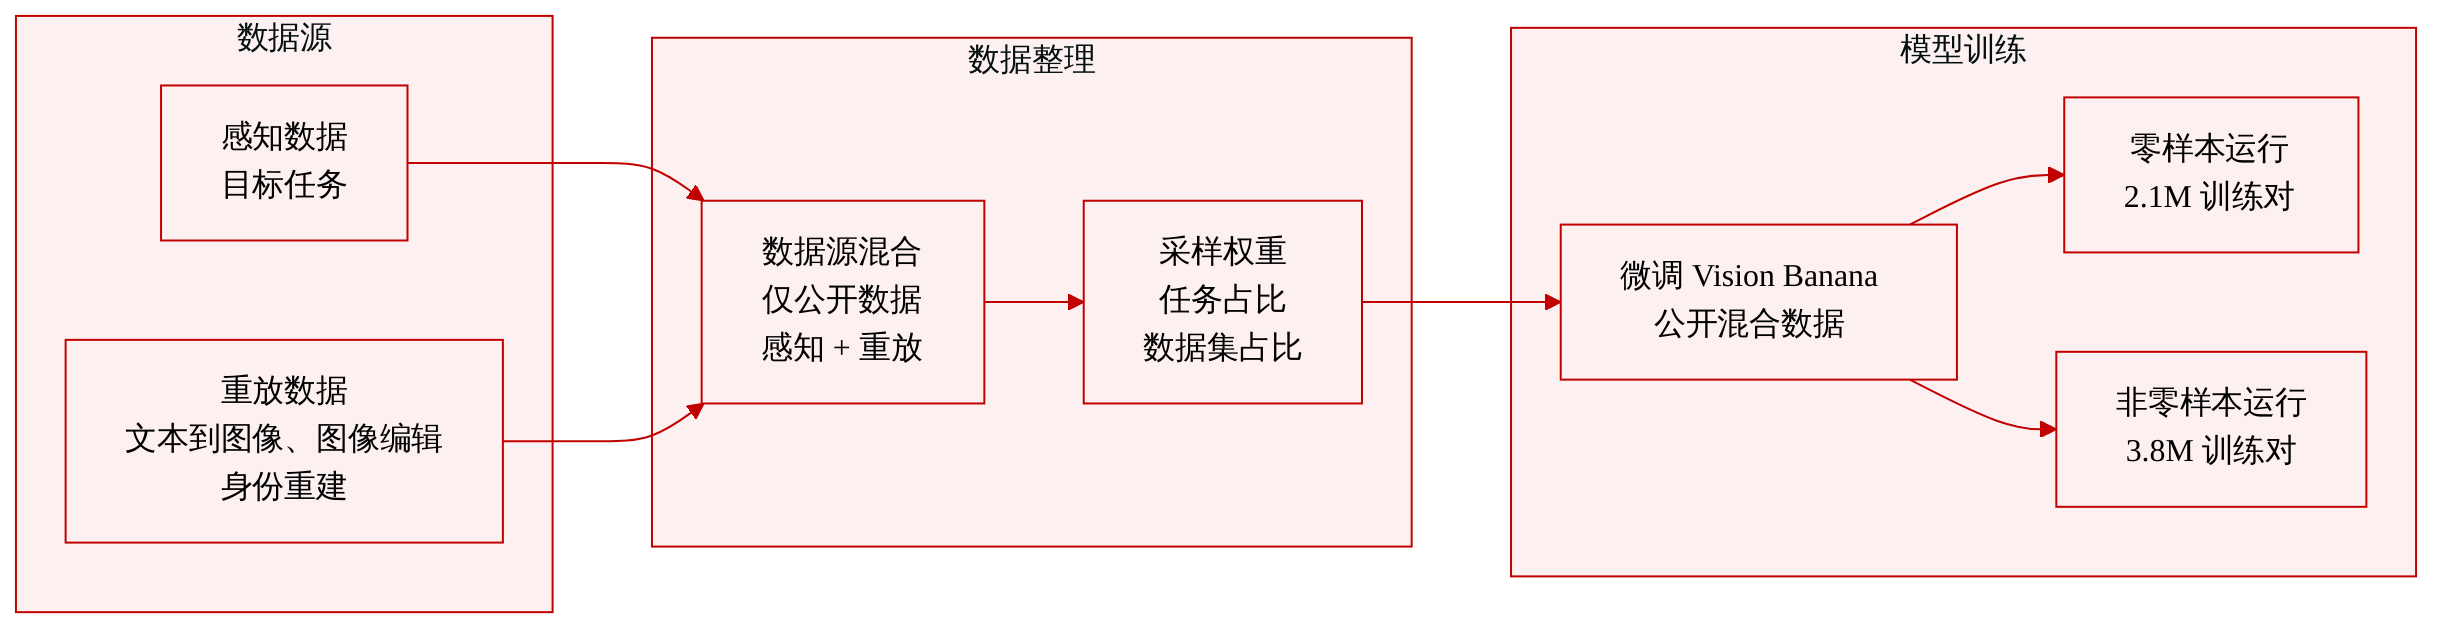
作者描述了一个用于微调 Vision Banana 的公开数据混合方案。
-
数据集组成与来源:
- 完整的 Vision Banana 方案在一个专有基础模型上,使用专有视觉数据与基础模型原始训练数据混合进行微调。
- 对于公开方案,仅使用公开数据集。
- 该混合方案将用于目标任务的 Perception 数据与来自公开文本到图像、图像编辑和身份重建数据集的 replay 数据相结合。
-
数据集规模:
- 零样本模型使用 210 万训练对。
- 非零样本模型使用 380 万训练对。
-
数据使用方式:
- 所得到的数据池作为 Vision Banana 的微调数据。
- 每个任务的采样权重以及每个任务内各数据集的占比在附录表 20 和表 21 中报告。
-
处理细节:
- 摘录未描述除数据集混合和采样权重之外的裁剪、元数据构建或其他预处理步骤。
方法
作者将 Open Vision Banana 表述为一种将预训练图像生成器转换为通用感知模型的方案,无需任务特定头部。给定输入图像 x 和指令 p,模型生成 RGB 图像 y,再由一个确定性、任务特定的读出过程转换为预测。这一设计将分割、几何估计和相关任务统一在单一条件图像生成框架下。
核心是经过微调的 FLUX.2-Klein 生成器,规模为 4B 和 9B。开放权重模型以输入图像为条件,所有 Transformer 参数都参与训练,从输入和上下文嵌入器到输出层。VAE 和文本编码器保持冻结。
每个任务通过确定性 RGB 编码器和解码器表示。编码器将标注渲染为 RGB 目标,解码器将生成图像读回为预测。两个方向都使用逐样本元数据,如颜色图例、深度缩放和尺寸调整。对于分割,提示将颜色指定为 RGB 三元组、从 64 种最分离颜色的调色板中抽取的十六进制代码,或 37 种常见颜色名称之一,黑色保留用于背景。
在语义分割中,提示列出请求的类别及其颜色。颜色在训练和推理中按照相同流程逐样本随机分配。目标将每个被提示的类别涂成其分配的颜色,并将所有其他像素设为黑色。推理时,每个生成像素被分配到最近被提示的颜色或背景。训练提示分布包括随机子集的现有类别、全部现有类别,以及添加了不存在的负类别的子集。负类别教会模型不要幻觉出不存在的掩码。对于实例分割,提示指定一个类别并列出 32 种颜色。按最左侧像素对 32 个最大实例进行排序,并以固定颜色顺序着色,使训练目标对每个图像和提示都是唯一的。评估时,预测通过重叠与真值实例匹配,不惩罚替代颜色分配。读出过程加入颜色吸附、间隙填充和 GrabCut 细化。对于指代分割,表达式与从命名调色板中独立采样的颜色配对,模型将所指区域渲染为该颜色,然后进行二值掩码读出。
几何任务使用类似的颜色通道表示。深度被编码为仿射不变逆深度,逐图像归一化到 RGB 范围并跨通道复制,因此更近的点更亮。推理时,预测被映射回逆深度,并在逐图像仿射对齐后评估。对于表面法线,法线被转换到统一的相机空间约定,每个向量分量线性映射到一个归一化的 RGB 通道。生成的 RGB 预测被映射回相机空间向量并归一化为单位长度。提示明确说明预期的输出表示。
由于所有目标都是 RGB 图像,训练使用基础生成器的 rectified-flow 目标。目标被编码为 zy,采样高斯噪声 ϵ,并均匀抽取插值系数 t∈(0,1]。噪声潜在表示为
zt=(1−t)zy+tϵ.以干净图像 x 和文本提示 p 为条件,Transformer 预测 v^=vθ(zt,t,p,x),其 flow 目标为 ϵ−zy。令 mj 表示潜在位置 j 是否被监督,C 表示潜在通道数,flow-matching 损失为
LFM=E(x,p,y),t,ϵ[C∑jmj∑jmj∥v^j−(ϵ−zy)j∥22].有效性掩码是唯一依赖任务的训练组件。几何标注包含由占位颜色编码的未定义区域,模型可能会学习复现这些区域。这些区域约占非零样本池中目标像素的 8%,并从损失中排除。零样本模型和非几何任务不使用掩码,采用标准 flow matching。在掩码训练期间,有效性掩码随图像变换,并被面积缩放到潜在网格。有效覆盖率至少 50% 的位置参与损失计算。最终模型不使用腐蚀,排除没有有效潜在位置的样本,并按有效面积对每个合格样本进行归一化。
全规模模型训练 100K 步,全局批量大小为 192,使用约 5122 像素的纵横比桶,包括 512×512、576×448、608×416 及其转置。优化器为 AdamW,权重衰减 10−4,使用 FSDP、bf16 自动混合精度和 fp32 参数。恒定学习率跟随线性预热:4B 模型为 5×10⁻⁶,预热 500 步;9B 模型为 2×10⁻⁶,预热 1,000 步。每个 epoch 有放回地抽取 100 万个样本,并在各任务间分配。最终模型使用几个后期 Transformer 检查点的权重空间平均。
实验
实验在零样本和非零样本设置下评估从 FLUX.2 Klein 4B 和 9B 微调得到的 Open Vision Banana 模型,涵盖语义、指代、实例分割、几何和保留的图像生成,使用标准密集预测指标和用于测试时扩展的 legend ensembling。零样本 9B 模型在语义和实例任务上通常达到或超过专门基线,而 ensembling 主要纠正类别与颜色绑定错误,产生更强的共识预测。消融实验表明,随机颜色图例以及子集或全集提示混合可以防止固定的类别与颜色记忆,均衡的生成和编辑数据可以保留生成能力,更新大多数 Transformer 参数可以改善分割和法线,微调还会锐化冻结的特征表示。
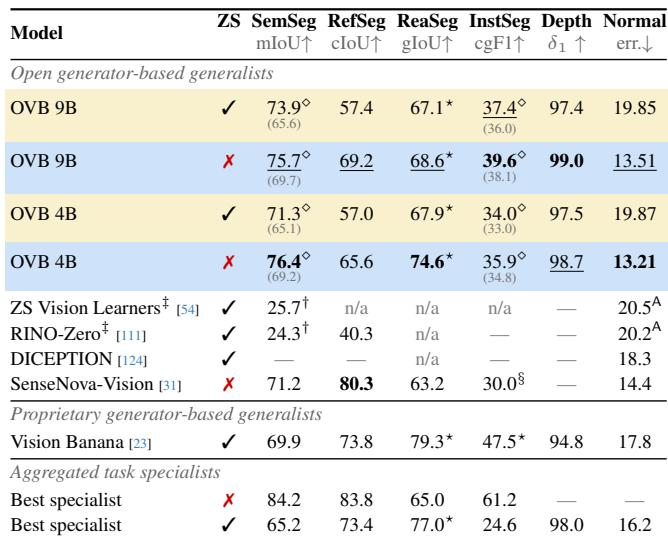
OVB 在支持的感知任务上一致优于所列的冻结零样本视觉学习器,测试时 ensembling 和非零样本适配带来额外提升。9B 零样本模型在 Cityscapes 语义分割和深度上尤其强大,而非零样本训练改善了指代分割、实例分割和表面法线误差。在 OVB 变体中,更大规模通常有利于深度和实例精度,但 4B 非零样本模型在语义和推理分割上达到最佳。OVB 9B 零样本在 Cityscapes mIoU 上高于所引用的专家和通用基线,且 ensembling 在单次均值之上带来显著提升。非零样本 OVB 在大多数任务上优于其零样本对应模型,在指代分割和表面法线误差上相对提升最大。冻结零样本视觉学习器在语义分割上得分低得多,且不支持若干任务,而 OVB 覆盖全部六个基准。
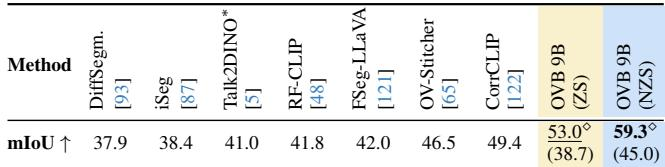
在 COCO-Object 上,所报告的专家方法范围从不足 38 mIoU 到略低于 50 mIoU,CorrCLIP 领先,基于扩散的 DiffSegm 和 iSeg 在比较方法中得分最低。带测试时扩展的零样本 9B 模型超过所有所列专家,而其平均单次性能仅与 DiffSegm 和 iSeg 相当。测试时扩展在这个 80 类基准上尤其有益,因为许多错误来自颜色被分配到错误的类别。CorrCLIP 是 COCO-Object 上所列最强的专家方法,领先于 OV-Stitcher 和 FSeg-LLaVA,而 DiffSegm 和 iSeg 在该比较中最弱。借助测试时扩展,零样本 9B 模型超过所有所列 COCO-Object 专家,但其平均单次性能与基于扩散的 DiffSegm 和 iSeg 相当。
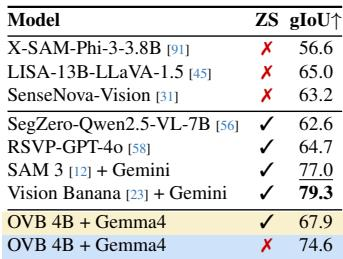
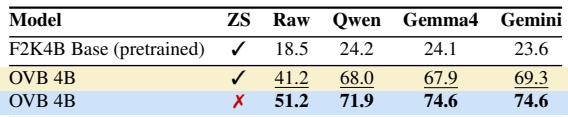
在 ReasonSeg val 上,带查询重写的零样本 4B 模型在不使用 Gemini 2.5 Pro 的方法中达到最高 gIoU,领先于零样本 SegZero 和 RSVP-GPT-4o,以及目标训练的 LISA 和 SenseNova-Vision。SAM 3 和 Vision Banana 得分仍然更高,但两者都依赖 Gemini 2.5 Pro 作为推理器。查询重写在微调后比在预训练基础模型中增加更多 gIoU。带重写查询的零样本 4B 模型在 ReasonSeg val 上优于零样本和目标训练基线。SAM 3 和 Vision Banana 仍然更强,但使用 Gemini 2.5 Pro 作为其推理器。
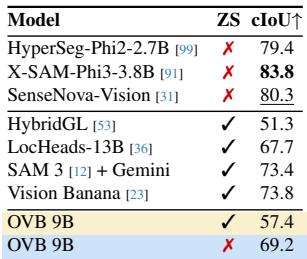
在 RefCOCOg 指代分割基准上,X-SAM、SenseNova-Vision 和 HyperSeg 是所示最强的目标训练模型。所评估的零样本 9B 模型超过 HybridGL,但落后于 LocalizationHeads-LLaVA、带 Gemini 的 SAM 3 和 Vision Banana。经过目标训练后,9B 模型显著提升,但仍落后于顶级目标训练专家。在目标训练方法中,X-SAM、SenseNova-Vision 和 HyperSeg 达到最高的报告重叠分数。零样本 9B 模型领先于 HybridGL,但落后于 LocalizationHeads-LLaVA、带 Gemini 的 SAM 3 和 Vision Banana。
这一比较隔离了预训练基础模型、OVB 微调和查询重写在 ReasonSeg 上的作用。预训练基础模型从显式重写中获益很少,而 OVB 4B 在重写查询下显著提升。微调还提升了原始查询的性能,表明模型学会了自己解析隐式表达。预训练基础模型在原始和重写查询下都保持低分,因此仅靠查询重写而没有微调是不够的。零样本设置下的 OVB 4B 从原始查询到显式重写提升约 27 gIoU,三种重写器都带来大幅提升。从零样本到非零样本对原始查询性能的提升超过对 Gemma4 重写性能的提升,表明模型部分学会了自己解释隐式查询。
实验在语义、指代、实例和推理分割基准上评估零样本和非零样本 OVB 变体,对比冻结零样本学习器和专家模型。零样本 OVB 一致优于所列冻结零样本基线,测试时 ensembling 或扩展带来额外提升,尤其在 Cityscapes 和 COCO-Object 上。微调和查询重写在推理和指代分割上带来显著改进,微调帮助模型解释隐式查询,而不仅仅依赖显式重写,尽管顶级专家模型在某些指代基准上仍然更强。