Command Palette
Search for a command to run...
VibePrevisBench:评估 Blender 中面向 4D 场景生成的智能体编程能力
VibePrevisBench:评估 Blender 中面向 4D 场景生成的智能体编程能力
摘要
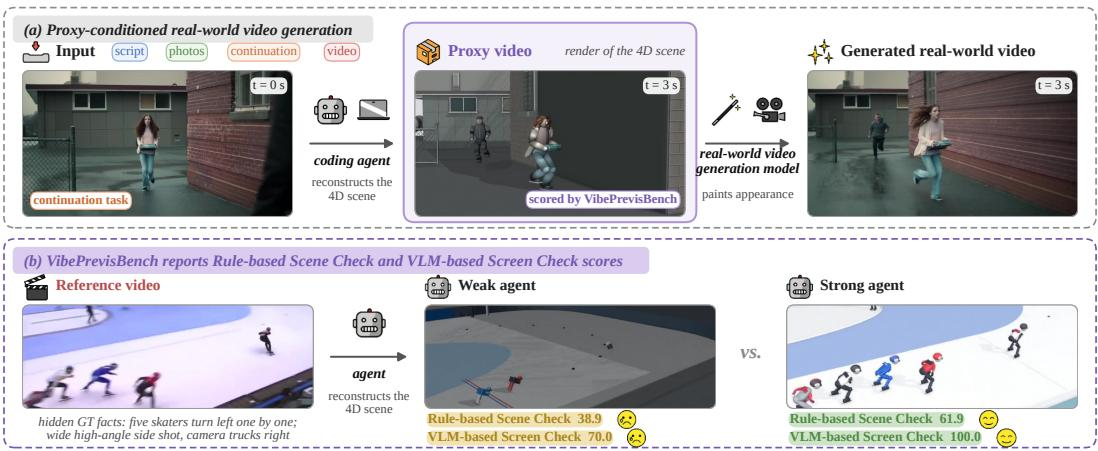
可控的真实世界视频生成模型可以以渲染的灰盒代理视频为条件,从而固定布局、运动和摄像机。编程智能体可以通过在 Blender 中重建 4D 场景来构建此类视频,但目前尚无基准同时检验这些视频及其背后的长镜头、多镜头场景。我们提出 VibePrevisBench,一个用于 4D 场景重建的基准:智能体将一份简报转化为可执行的 4D 场景,并渲染其代理视频。其 242 个任务涵盖四种输入类型,包括脚本、照片、续写和参考视频。每个交付成果都沿两个评估维度进行评分。基于规则的 Scene Check 重新运行代码,并在九个维度上将导出的 4D 场景与隐藏的真值事实进行比较。基于 VLM 的 Screen Check 要求 VLM 评判者判断通过检验的事实能否在代理视频中被识别出来。我们分析了 11 个前沿编程智能体的评估结果和轨迹,并得出三个关键观察。第一,多模态理解能力区分了这些智能体,尤其是在理解空间和摄像机运动方面。第二,所有智能体似乎已经掌握了基本的摄像机工作和场面调度,但在具有挑战性的请求上表现不佳。第三,智能体会检查自己的渲染结果,却未能纠正其中的错误。因此,智能体需要更好的空间与摄像机视觉理解能力、针对挑战性请求的显式检查,以及逐项对照简报验证渲染结果。
一句话总结
来自天津大学、Kling AI、北京邮电大学等机构的研究者提出了 VibePrevisBench,这是一个包含 242 个任务的基准,用于评估将简报转化为可执行 Blender 4D 场景和渲染代理视频的 coding agents,并通过基于规则的 Scene Check 和基于 VLM 的 Screen Check 打分,发现前沿 agents 需要更好的空间与相机理解能力和纠错能力。
核心贡献
- VibePrevisBench 提供 242 个任务,涵盖脚本、照片、续写和参考视频,要求 coding agents 重建可执行的 4D 场景并渲染其代理视频。
- 基于规则的 Scene Check 重新运行代码,并在九个维度上将导出的 4D 场景与隐藏真值事实进行比较;基于 VLM 的 Screen Check 让 VLM 判断器判断通过的事实能否在代理视频中被识别。
- 对 11 个前沿 coding agents 的分析表明,空间和相机运动的多模态理解能力区分了 agents,具有挑战性的场景调度和拍摄请求仍然困难,agents 会检查自己的渲染结果但无法纠正错误。
引言
可控的真实世界视频生成越来越依赖于从 4D 场景渲染的代理视频,该场景固定了布局、人物、动作、相机和剪辑。coding agents 可以通过编写 Blender 代码来构建这些场景,但代理中的错误会传播到最终的真实世界视频中。现有基准只部分评估这一任务:它们使用较窄的输入,侧重静态内容,或仅依赖屏幕评估,而没有对包含人物的长多镜头场景检查底层 4D 场景与真值的一致性。作者提出了 VibePrevisBench,这是一个让 agents 将脚本、照片、续写或参考视频转化为可执行 4D 场景和代理视频的基准,并通过基于规则的场景检查和基于 VLM 的屏幕检查进行评估。
数据集
VibePrevisBench 数据集
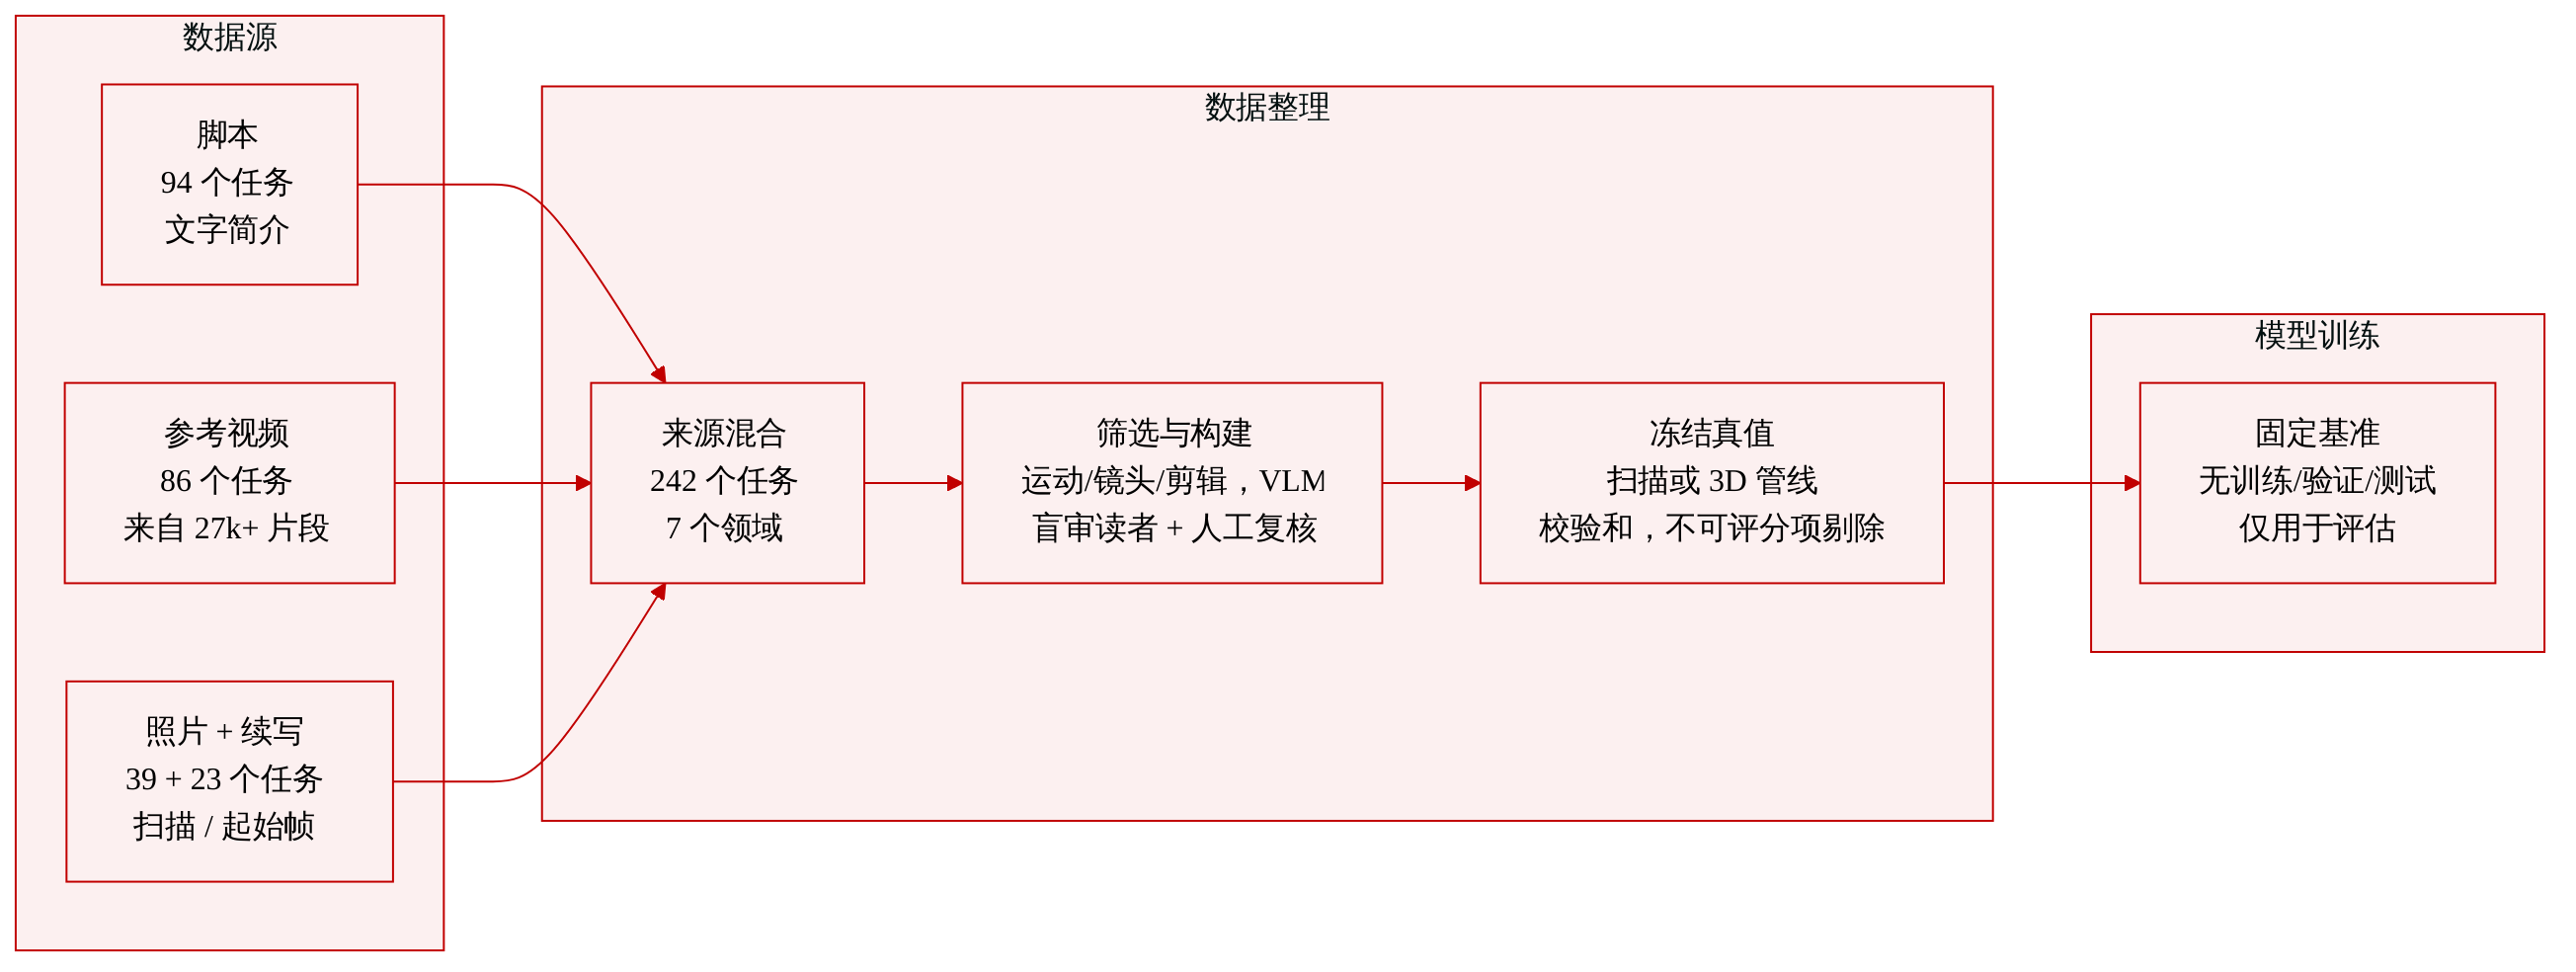
作者将 VibePrevisBench 介绍为一个用于 4D 场景重建的 242 个任务的基准。每个任务是一个元组 (b,m,E,o):英文简报 b、可选媒体 m、带 id 的地点和主体列表 E,以及指定代理视频帧数、帧率和分辨率的输出要求 o。该基准覆盖七个场景领域和四种输入类型。
子集与来源
- 脚本:94 个任务。 场景仅用散文描述,不包含距离或角度。脚本简报相对较长,约 800 词。
- 参考视频:86 个任务。 片段来自超过 27,000 个源视频。作者保留包含多个运动人物、相机运动或剪辑的片段,留下 1,800 个片段。其中,388 个片段通过 VLM 对真实动作、可见事件和不同主体的检查,由人工审核员选出最终视频任务。
- 照片任务:39 个任务。 共 38 个任务使用带有已测量 3D 框和相机位姿的扫描数据集。一个照片任务由重建流程估计。
- 续写:23 个任务。 每个任务展示一个片段的首帧,并描述接下来几秒钟的内容。
模式与隐藏真值
每个任务都将简报与可单独检查的隐藏真值事实配对。一个事实是关于场景的一条可检查陈述,例如主体站在哪里、地点如何连接、谁在何时移动到何处,或者相机如何取景、运动和剪辑。这些事实属于九个维度:实体、布局、空间、画面结构、路线、事件、相机、剪辑和物理有效性。画面结构仅对照片、续写和视频任务检查,因为它会将深度、法线和分割与参考帧进行比较。外观从不检查。
构建与处理
- 收集与整理: 两个冻结的分类体系为场景应包含什么以及任务应如何提问设定配额。视频和续写片段通过运动、相机和剪辑过滤器从大型源池中选取,随后经过 VLM 检查和人工审核。
- 任务构建: 对于脚本任务,模型从一张卡片构建场景并编写脚本。来自 Claude 和 DeepSeek 系列的两个盲审读者仅根据脚本重建事件;两者都无法恢复的声明会被改写或删除。媒体简报为每个地点和主体分配 id 和描述。人工审核员检查并纠正每个简报及其隐藏事实。
- 真值与检查: 脚本任务从已构建场景获取隐藏事实,照片任务从扫描数据获取。对于视频、大多数续写和一个照片任务,一个流程通过恢复镜头、主体、相机、深度和人体并将其提升到 3D 来估计真值。该流程无法验证的事实被标记为不可评分,永不计入。未能区分 11 个 agents 的候选任务会根据条目与总分相关性和离散度被剔除,而不是根据任何单个 agent 的分数。任务、媒体、隐藏事实和评分器均通过校验和冻结。
规模与统计
242 个任务分布为 94 个脚本、86 个参考视频、39 个照片任务和 23 个续写任务。七个领域各包含 19 到 46 个任务,33 个地点各出现在 3 到 13 个任务中。简报长度为 153 到 1,200 词,中位数为 368 词。每个任务带有 20 到 2,175 个检查项,中位数为 408,总检查项数为 99,000。大多数任务要求较高:88% 的任务有两个或更多镜头,80% 有运动相机,79% 有两个或更多人物,69% 有手与物体的交互,61% 涉及两个或更多地点。
基准的使用方式
VibePrevisBench 用于评估而非模型训练。一个 agent 返回一个 Blender 程序 p。基准在一个全新沙箱中运行 p,逐帧导出 4D 场景 S,并渲染代理视频 V。隐藏真值事实构成用于对场景评分的评分标准。
- 基于规则的 Scene Check: 它通过带标签 id 绑定主体和地点,并按类别匹配未标记物体。脚本事实是关系性的,而媒体事实是度量性的,并在相似度对齐后进行比较。分数会针对随机概率和缺失实体进行校正,然后在任务涉及的维度上取平均。
- 基于 VLM 的 Screen Check: VLM 判断器 Gemini 以 2 fps 观看代理视频,对 agent 和物体名称不可见,先复述片段,然后接收来自隐藏事实的简报和检查清单。它按识别、动作、可见性和故事将条目评定为 no、partial 或 yes。照片任务仅使用识别。
- 总体分数: 最终分数为 (Scene+Screen)/2。
未描述训练/验证/测试划分,因为该数据集是一个固定基准,其评分可通过已发布的校验和复现。
方法
作者将任务形式化为 τ=(b,m,E,o),包括英文简报 b、可选媒体 m、地点与主体列表 E 以及输出要求 o。agent 返回一个 Blender 程序 p。为了评估该程序,执行该程序以生成 4D 场景 S=({xe(t)}e∈E,c(t),K) 和代理视频 V。
请参考框架图了解评估流程。
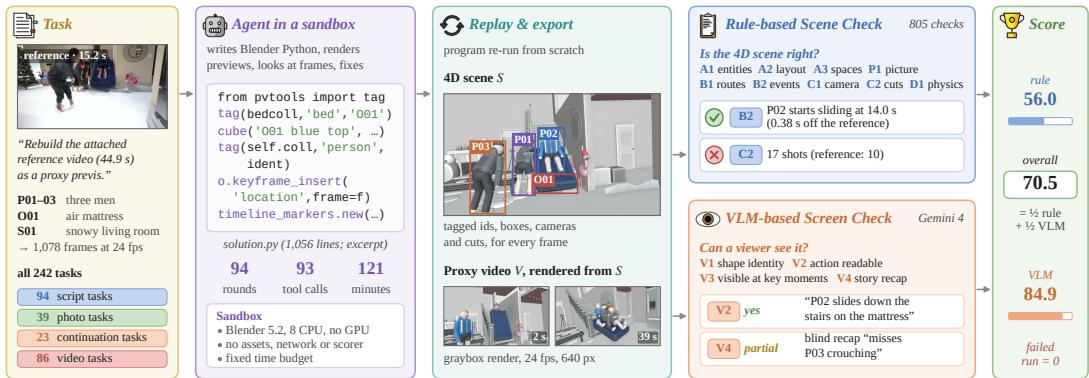
该流程确保交付的程序可以在全新沙箱中独立运行,逐帧导出场景并渲染代理视频。这防止 agents 提交与底层代码不匹配的预渲染视频。评估包括两个主要检查。基于规则的 Scene Check 验证 4D 场景在结构上是否正确。它通过带标签的 ID 绑定主体和地点,并按类别匹配未标记物体。分数的计算分为三步:为一个事实块计算原始分数 Pb,使用 Qb=clip((Pb−Rb)/(1−Rb))κb 对随机概率和缺失实体进行校正,其中 Rb 是随机概率,κb 是存在实体的比例,然后将各块合并为维度分数。基于 VLM 的 Screen Check 使用 VLM 判断器评估正确的场景元素是否可见。判断器观看代理视频,并在识别、动作、可见性和故事等维度上评定条目。最终分数是 Scene 分数和 Screen 分数的平均值。
作者分三个阶段构建该基准,以确保高质量和可复现性。
如下图所示:
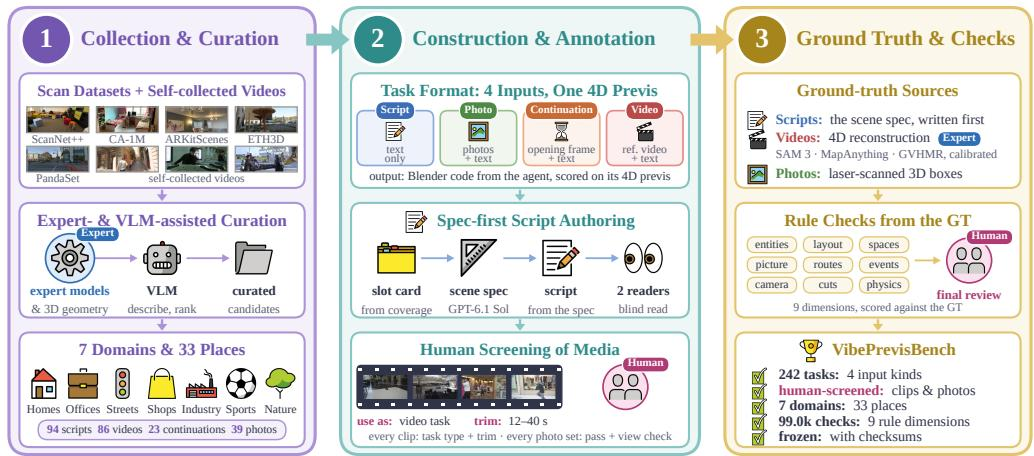
阶段 1 包括从扫描数据集和自行收集的视频中进行收集与整理,并由专家模型和 VLM 过滤到特定领域和地点。阶段 2 聚焦于任务构建,脚本先写规格并通过来自不同模型家族的盲审读者验证,媒体简报由人工筛选。阶段 3 建立真值与检查。对于脚本,事实来自已构建场景;对于视频,一个流程恢复镜头、主体和相机并将其提升到 3D。未能基于条目与总分相关性和离散度区分 agent 表现的任务会被剔除,从而确保基准稳健并通过校验和冻结。
实验
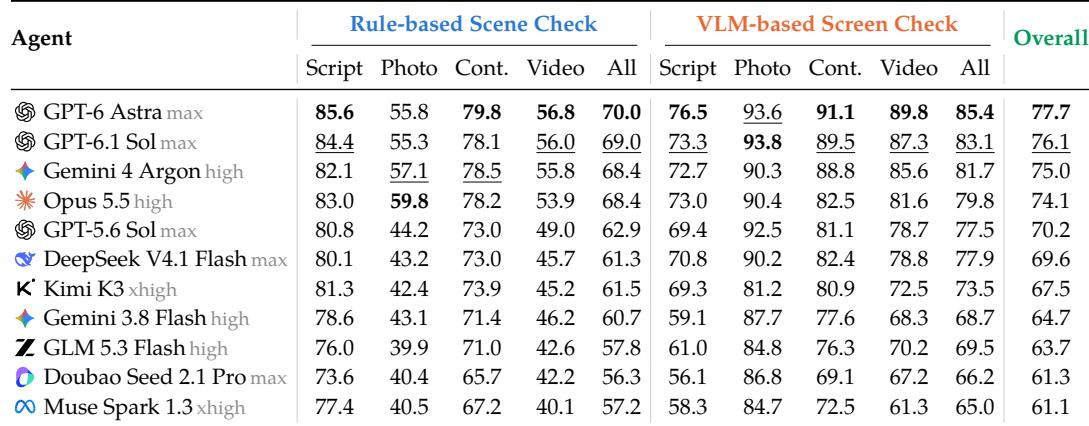
该研究在 Blender 沙箱中评估 11 个前沿 coding agents,预算为四小时,评分它们在不同输入类型下生成、渲染和修订场景的能力。GPT-6 Astra 以 77.7 的总体分数领先,但没有一个 agent 接近解决该基准,而且成本与分数并不一致,更便宜的模型也能接近领先者的性能。空间和相机运动的多模态理解比编码能力更能区分 agents,同时所有模型都能处理常见的场景调度请求,但会把具有挑战性的请求转化为常见选择。agents 经常检查自己的渲染结果,但无法可靠地检测错误,这表明需要根据简报逐项显式验证,而不是更多次查看图像。
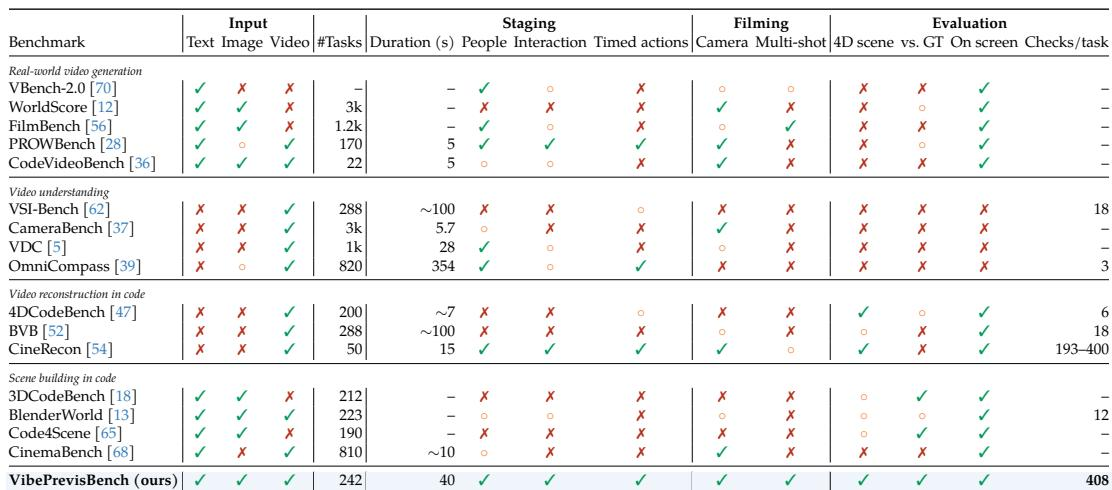
比较结果表明,现有基准在输入、场景调度、拍摄和评估维度上都只是部分的。许多基准支持渲染帧评分,但不要求布置人物、定时动作、多镜头拍摄,也不检查重建的 4D 场景与真值是否一致。只有 VibePrevisBench 满足所有列出的标准。若干相关基准在屏幕上对渲染帧评分,但大多数不验证底层 4D 场景与真值。只有 VibePrevisBench 在所列维度上具有完整覆盖,而相关基准只部分覆盖场景调度和拍摄。
在 242 个任务的基准上,GPT-6 Astra 总体领先,略高于 GPT-6.1 Sol、Gemini 4 Argon 和 Opus 5.5。这四个顶尖模型得分接近,并且比下一批 agents 至少领先 3.9 个总体分,但没有一个 agent 接近解决该基准。视觉密集型输入扩大了模型差异,而成本与排名并不紧密相关。GPT-6 Astra 获得最高总体分数,其后依次是 GPT-6.1 Sol、Gemini 4 Argon 和 Opus 5.5。前四个 agents 比下一组至少领先 3.9 个总体分。GPT-6 Astra 在脚本、续写和视频输入上的基于规则的 Scene Check 中领先,而 Opus 5.5 在照片输入上领先。基于规则的 Scene Check 的最好与最差差距从纯文本脚本的 12.0 分扩大到照片的 19.9 分,其中空间和相机错误占照片差距的很大一部分。没有一个 agent 解决该基准:在 242 个任务中,只有 35 个任务有 agent 达到 90 分的基于规则的 Scene Check 分数。成本与分数背离;一些便宜得多的 agents 接近领先者的总体分数,而高成本模型可能排在成本更低的竞争者之后。agents 检查了许多渲染帧,但不能可靠地纠正错误,而且更多检查与大幅提高分数并无关联。
评估比较表明,现有基准在输入、场景调度、拍摄和评估维度上都只是部分的,只有 VibePrevisBench 覆盖所有标准并验证重建的 4D 场景与真值一致。在 242 个任务的基准上,GPT-6 Astra 略领先于 GPT-6.1 Sol、Gemini 4 Argon 和 Opus 5.5,但没有一个 agent 接近解决该基准,视觉密集型输入扩大了模型差异。成本与排名并不紧密相关,agents 检查了许多渲染帧,却不能可靠地纠正错误。