Command Palette
Search for a command to run...
SO-Arena:评测 System One 模型的能力谱系与决策可靠性
SO-Arena:评测 System One 模型的能力谱系与决策可靠性
Lichen Li Ziping Dong Sicheng Feng Qi Li Xinchao Wang
摘要
System One 模型有望实现快速、通用的决策,而无需冗长的 token 生成过程。然而,理解其能力谱系与决策可靠性,需要的不仅仅是当前基准上的聚合性能。现有评测往往对模型能力的广度及其决策的可靠性提供的洞察有限。我们提出 SO-Arena,一个在 11 个领域和五个能力族上刻画 System One 模型能力谱系与决策可靠性的基准。在能力谱系方面,SO-Arena 通过可靠来源和对参考标签与模型可见输入的人工核验,提供基于证据的评测;通过领域特定的难度标准,提供细粒度能力评估;并提供真实的交互式评测,使模型在沙盒中迭代执行动作。推理密集型任务进一步支持 System One 与 System Two 的对比。除准确率之外,SO-Arena 还通过两个互补指标评估决策可靠性:受控选项集变化下的决策稳定性,以及在无有效选项时的缺答识别能力。对 21 个模型的评测表明,规模扩展和额外推理带来的收益在不同领域间差异显著。更重要的是,整体性能优异并不必然意味着决策可靠:性能最好的 System One 模型在可靠性上仅排名第七。这些发现共同表明,有必要将能力谱系与决策可靠性作为互补维度加以刻画,从而为 System One 模型的优势与局限提供系统性视角。
一句话总结
作者提出了 SO-Arena,这是一个在 11 个领域和五个能力族中评估 System One 模型的基准,采用基于证据的评估,使用可靠来源和人工验证的参考标签、细粒度的领域特定难度标准以及交互式沙箱执行,同时通过受控选项集变化下的决策稳定性以及没有有效选项时对缺失答案的识别来评估决策可靠性;在 21 个模型中,规模扩展和推理收益因领域而异,表现最好的 System One 模型在可靠性方面仅排名第七。
核心贡献
- SO-Arena 是一个基准,用于刻画 System One 模型在 11 个领域和五个能力族上的能力谱系和决策可靠性,采用基于证据的标签、领域特定的难度层级和基于交互式沙箱的动作评估。
- 该基准提供了补充性的可靠性度量,评估受控选项集变化下的决策稳定性以及没有有效选项时对缺失答案的识别,将判断可靠性与准确性区分开。
- 对 21 个模型的评估表明,规模扩展和额外推理带来的收益取决于领域,而不是均匀提升;高能力并不能保证可靠决策,表现最好的 System One 模型在可靠性方面仅排名第七。
引言
System Two 推理能提升语言模型在数学、编码和科学上的表现,但会增加推理成本,因为模型会生成额外的推理 token。许多常规软件决策,例如请求路由、工具选择和完成验证,可以由 System One 模型在一次前向传递中预测预定义结果上的分布来完成,从而降低延迟并为下游软件提供结构化输出。此前对这些模型的评估衡量了准确性、校准、延迟和成本,但并未一致地结合可信的模型可见参考标签、按难度分层任务、交互式行动者与验证者角色,以及受控的选项集可靠性检查。作者提出 SO-Arena,这是一个包含 11 个领域和五个能力族的 2,919 个任务的基准,统一了静态决策和基于环境的决策,将领域组织为难度层级,区分动作选择与完成验证,并报告单独的可靠性分数,涵盖选项重排和缺失正确答案。对 21 个模型进行评估后,作者发现高能力与可靠决策并不总是一致。
数据集
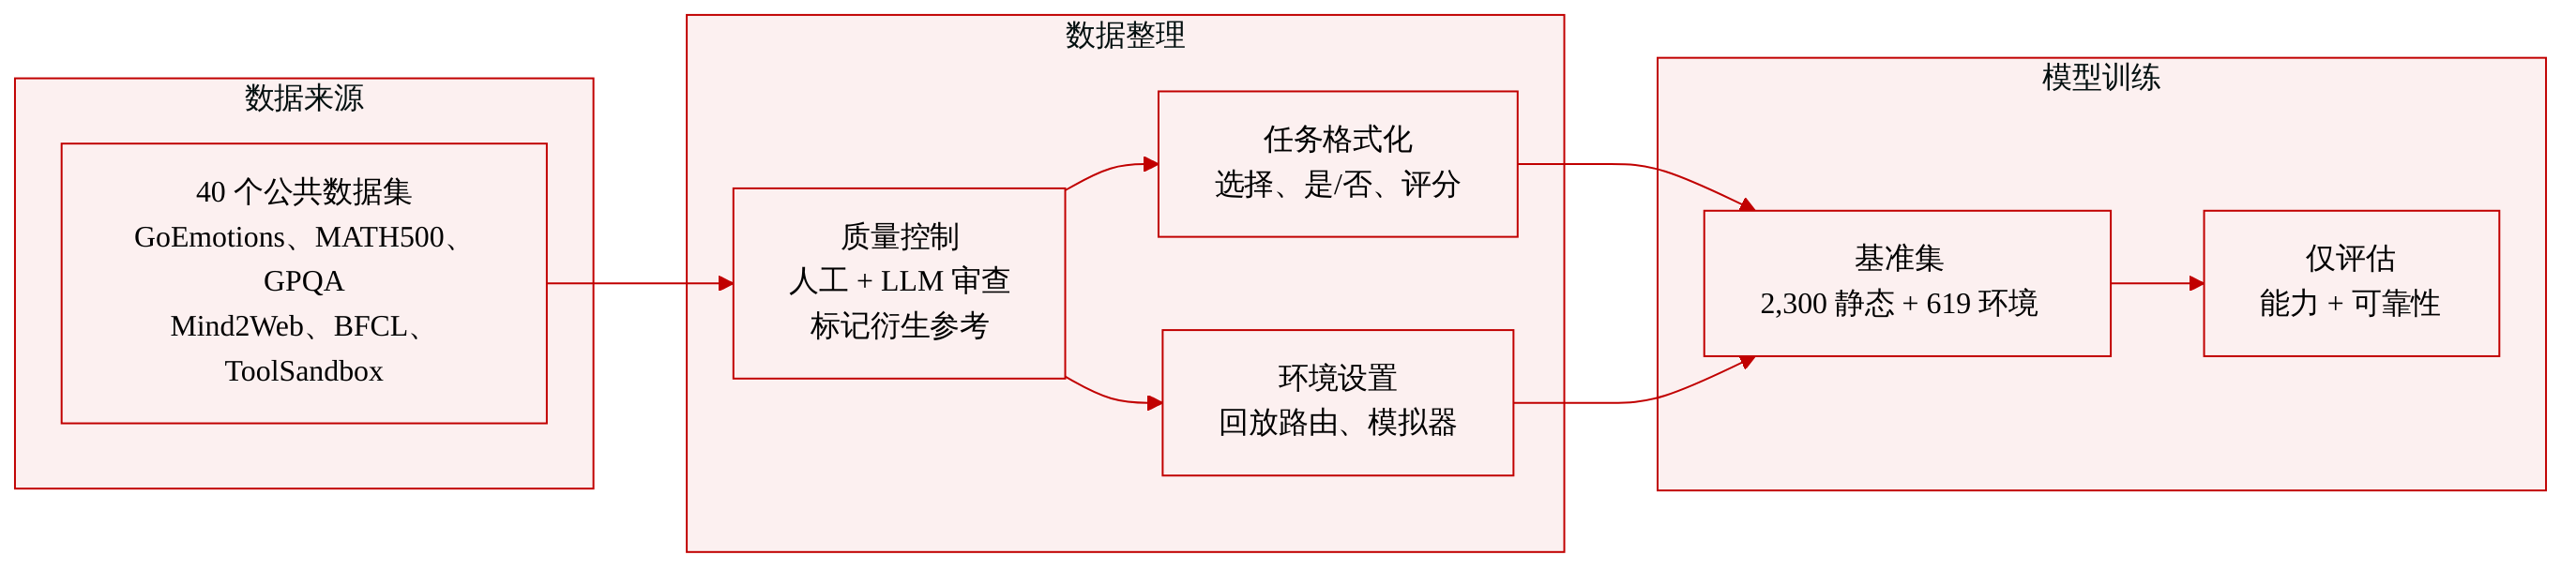
作者从 11 个领域的 40 个不同公开数据集、基准和环境中构建了一个决策基准。代表性来源包括 GoEmotions、MATH500、GPQA Diamond、Mind2Web、BFCL 和 ToolSandbox。一些任务直接由源数据转换而来,另一些则是新构建的,例如对 BrowseComp-Plus 搜索运行的完成检查以及 VirtualHome 轨迹。
质量控制与元数据
- 源标签作为参考保留,并经人工和 LLM 审查。
- 参考存在疑问的条目被排除。
- 每个任务在适用时记录其来源、版本和原始标识符。
- 模型派生的参考在元数据中被标记。
任务构成
- 11 个领域被归为五个能力族:语义理解、知识与推理、安全与策略合规、证据评估和 agent 任务完成。
- 九个领域设有难度层级;情感与情绪理解和知识与常识未分层。
- 该基准包含 2,300 个静态任务和 619 个基于环境的任务。
- 基于环境的任务分为 337 个网页任务,其中 100 个单步判断和 237 个参考路由任务,外加 282 个交互式工具使用回合。
- 表 3 总结了各领域的来源、任务数量、难度层级和决策格式。
处理与任务表述
- 静态任务被转换为 choice、是/否风格或 score 格式。
- choice 条目直接使用多项选择题;分类标签变为选项。
- 开放答案的数学问题使用由错误基座模型答案、中间结果和基于规则的近似错误构建的干扰项。
- 二元和多标签任务变为是/否问题。
- score 任务保留原始的序数尺度。
- 自建任务使用执行、经过验证的构建或标注作为参考。
- 自由文本响应任务被排除。
- 基于环境的任务使用记录的页面状态或模拟器执行,多步网页路由通过回放进行验证。
- 未描述裁剪策略;主要转换是格式转换和选项扰动。
数据使用方式
- 该基准用于评估,而非作为训练划分。
- 能力评分将原始任务作为评分单元,并对各领域等权加权。
- 对于分层领域,评分集中在最难层级;数学使用困难层和极难层;未分层领域使用所有任务。
- 可靠性评估以原始顺序和 12 种重排顺序展示每个条目,同时展示原样条目和移除正确选项后的条目,以测试对缺失正确选项的识别。
方法
作者将 System One 决策模型定义为将给定状态和决策规范映射到可接受结果上的结构化预测的系统。一个实例表示为 x=(s,q,C),其中 s 包含给定信息,q 规定决策目标,C={c1,…,cK} 定义可接受的结果。模型返回一个满足非负性与和为 1 约束的概率分布 pθ(⋅∣x)。该接口支持三种主要输出格式:针对显式指定备选项的分类选择(choice)、针对结果空间 {0,1} 的是/否问题的二元判断(noul),以及针对有序描述等级的有序评估(score),其中预测等级对应概率最高的等级。
SO-Arena 基准的构建遵循一条结构化流水线,包括来源收集、质量控制、任务组织和评估。
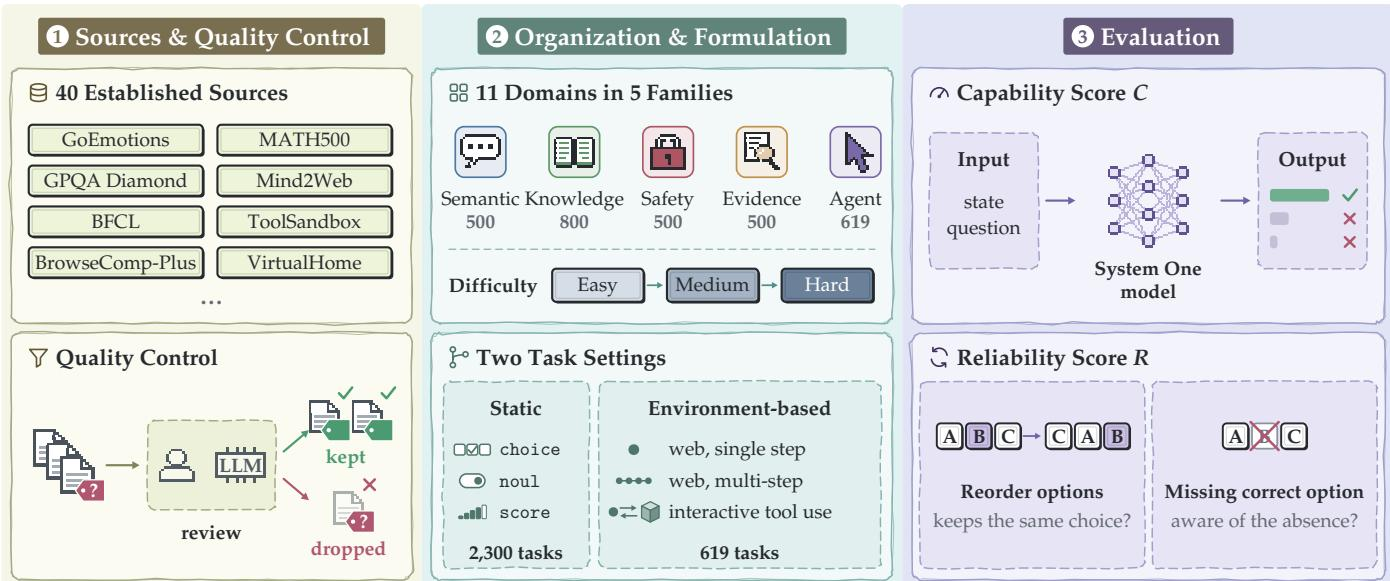
首先,任务取自 40 个已有公开来源。涉及人工和 LLM 审查的质量控制阶段过滤掉标签存疑的条目。随后,整理后的任务被组织到领域和能力族中,并在适用时分配难度层级。最后,评估阶段根据模型在这些结构化任务上的表现计算能力分数和可靠性分数。
该基准包含 2,919 个任务,涵盖 11 个领域,归为五个能力族:语义理解、知识与推理、安全与策略合规、证据评估和 agent 任务完成。
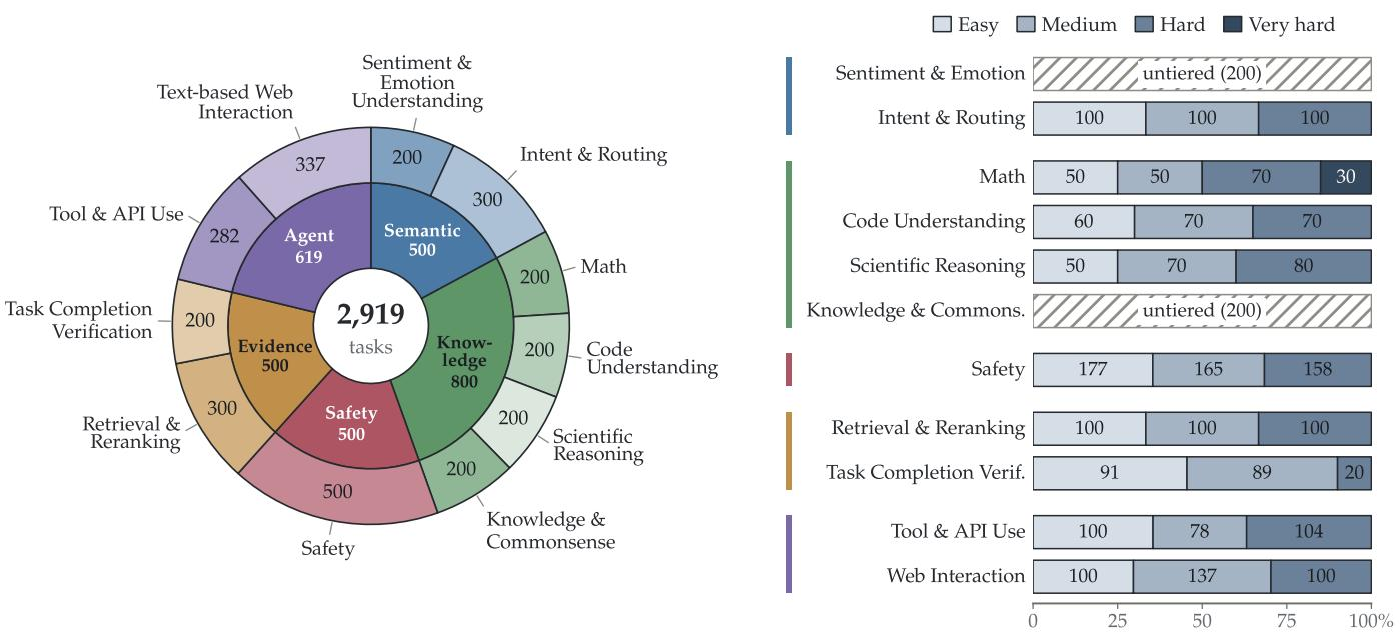
其中九个领域具有从易到极难的领域相对难度层级,另两个领域由于复杂度变化空间有限而未分层。任务被表述为两种不同设置,以反映真实应用:
- 静态任务:模型判断固定输入。多项选择题直接使用,而开放答案问题使用由基座模型错误或基于规则的近似错误生成的干扰项。二元判断表述为是/否问题。
- 基于环境的任务:模型根据来自网页或工具环境的观察来评估或选择动作。这包括单步网页判断、沿参考路由的多步顺序决策,以及交互式工具使用回合,其中模拟器执行动作并返回观察以供下一步决策。
为了评估模型表现,作者定义了两个主要度量:能力和可靠性。能力分数 C(m) 对每个领域最难层级的性能取平均,以确保领域等权,避免较大领域主导评估:
C(m)=D100d=1∑D∣Td∣1i∈Td∑ci(m)其中 D 是领域数量,Td 包含最难层级的任务。
可靠性分数 R(m) 结合两个组成部分,以确保稳健决策。第一个是选项顺序稳定性(S),衡量选项重排时的一致性。S(m) 将 12 种重排下的一致率 A(m) 相对于随机概率 pe 进行重新缩放。第二个是对缺失正确选项的识别(N),衡量当提供的选项中没有正确答案时,模型为不存在正确答案(Null)分配更高概率的能力,使用 ROC 曲线下面积(AUC)量化。综合可靠性分数是这两个组成部分的几何平均,前提是两者都超过随机水平:
R(m)={S(m)N(m),0,S(m)>0 and N(m)>0,otherwise.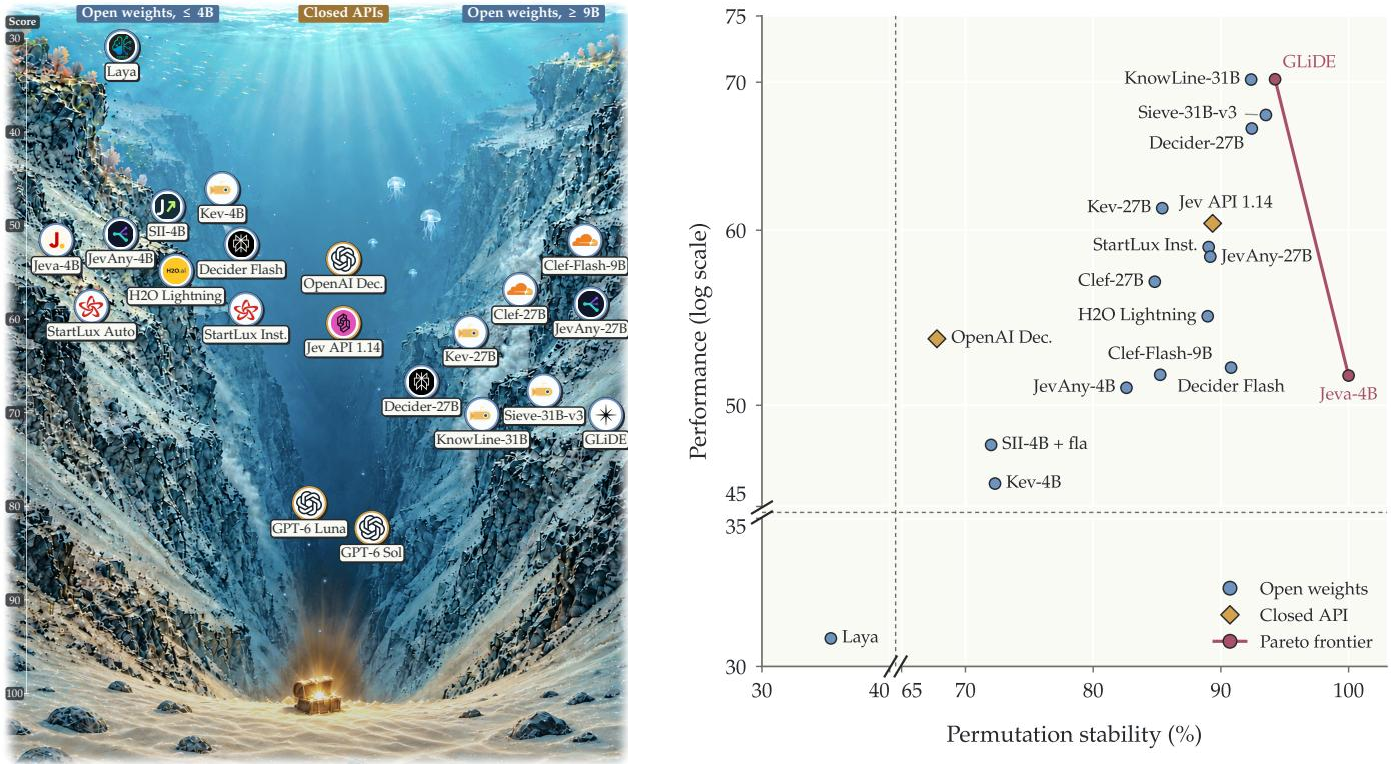
该评估框架利用这些度量生成综合排行榜,并分析不同模型规模和访问类型下性能与排列稳定性之间的权衡。
实验
该基准使用 2,300 个静态任务和 619 个基于环境的任务,在 11 个领域中评估决策能力,并分别使用能力和可靠性度量。对 21 个模型的实验将 System One 模型与 System Two 参考模型在性能、延迟、选项顺序稳定性和缺失选项检测方面进行比较。System Two 模型整体领先但速度慢得多,而 System One 模型在直接语义判断上具有竞争力或更优,更大的基座模型在基于环境的决策上大幅缩小差距,显式思考主要在数学和科学推理上有帮助。可靠性结果表明,选项顺序稳定性与性能相关,但对缺失正确选项的敏感度差异很大,需要直接测量。
该研究评估了 21 个决策模型,涵盖开放权重 System One 模型、封闭决策 API 和封闭 System Two 参考模型。性能与延迟配对测量,可靠性通过选项重排和缺失正确选项来度量。所列开放权重条目主要包括参数规模最高达 31B 的非推理模型,其中有一个紧凑模型能够自动切换推理。开放权重 System One 模型构成评估中最大的群体,此外还有封闭决策 API 和封闭 System Two 参考模型。可靠性通过选项重排和省略正确答案来评估,顺序稳定性的表现与性能的相关性比 null 判别的相关性更强。
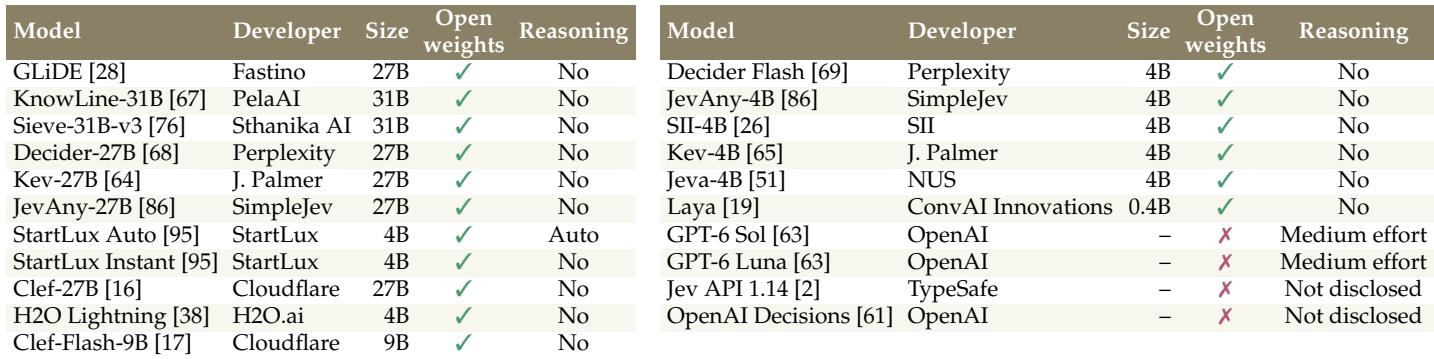
System Two 模型保持最高的总体分数,但其优势在各领域并不一致。System One 模型速度快得多,在直接语义判断和细粒度基于环境的决策任务上可达到或接近 System Two 表现,但在多步推导上远远落后。可靠性只能部分由性能解释:顺序稳定性与性能密切相关,但 null 判别差异很大,必须直接测量。两个 System Two 参考模型在总体分数上领先,最强的开放权重 System One 模型落后 Luna 约 10 分。开放权重 System One 模型在单块 H100 GPU 上每个任务在 0.3 秒内完成,比 System Two 参考模型快数十倍。更高的性能并不能保证更高的可靠性;最可靠的 System One 模型在 18 个模型中性能排名第八和第六。选项顺序稳定性随性能上升,而 null 判别差异很大,与性能的关系很弱。
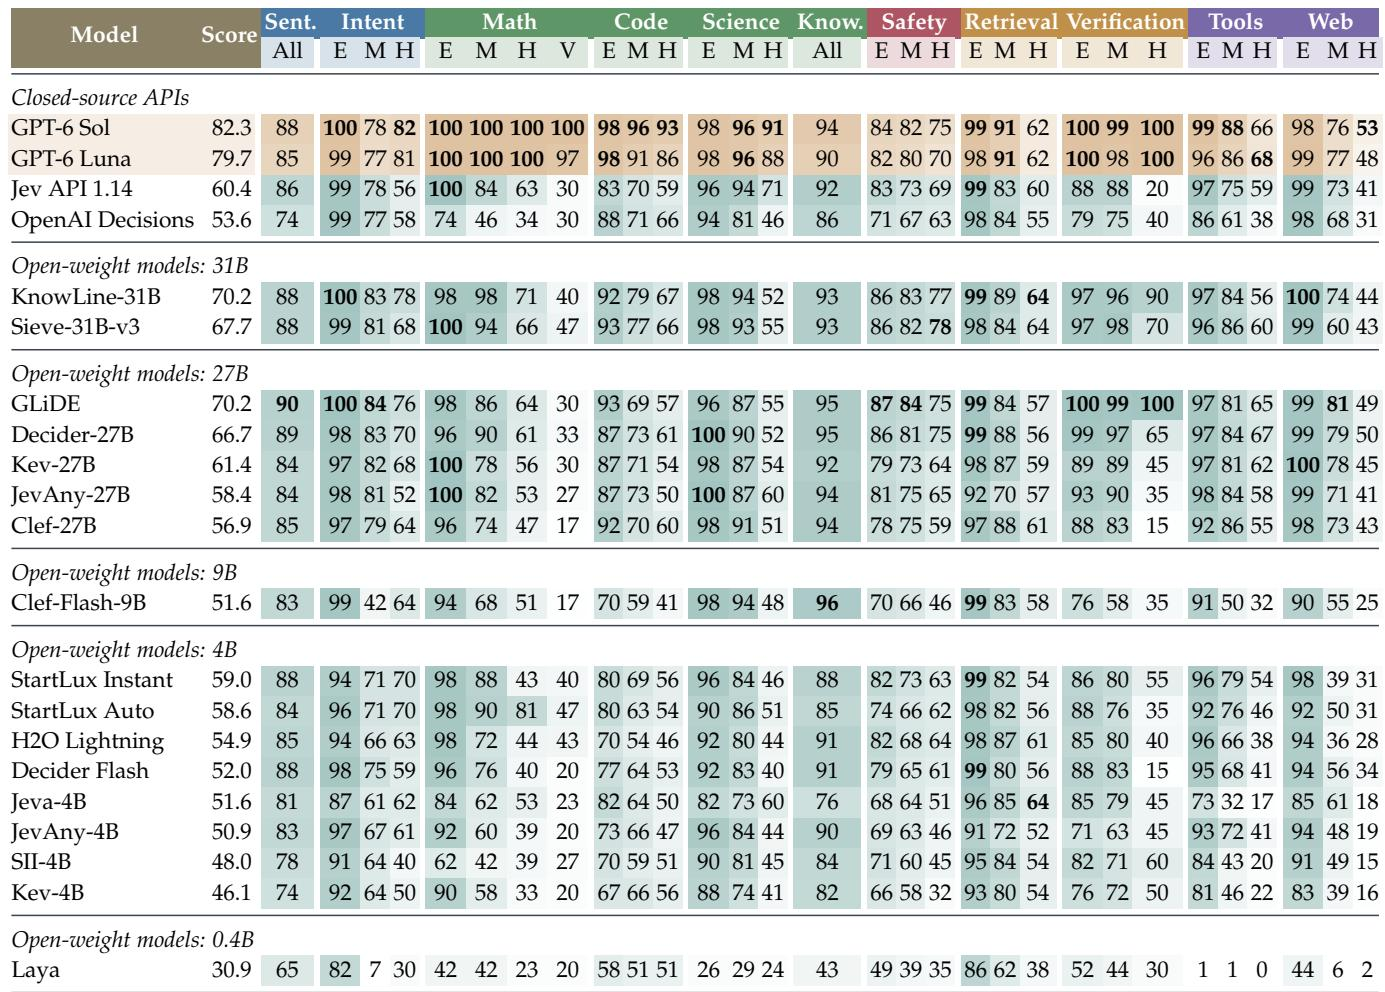
该研究评估了 21 个决策模型,涵盖开放权重 System One 模型、封闭决策 API 和封闭 System Two 参考模型,通过选项重排和缺失正确选项测量性能、延迟和可靠性。System Two 模型取得最高总体分数,但速度更慢且并非一致更优;System One 模型速度更快,在直接语义和基于环境的决策任务上可达到或接近 System Two 模型,但在多步推导上明显滞后。可靠性仅部分与性能相关,因为顺序稳定性随分数提高而改善,但 null 判别差异很大,最可靠的 System One 模型在性能方面并未排在最前。