Command Palette
Search for a command to run...
BirdDreams:面向合理且可反应驾驶世界模型的联合视角与 BEV 视频生成
BirdDreams:面向合理且可反应驾驶世界模型的联合视角与 BEV 视频生成
Junyoung Seo Jaewoo Seo Seungryong Kim Laura Leal-Taixé Xiuming Zhang Seung Wook Kim
摘要
驾驶世界模型旨在模拟场景在不同自车动作下如何演变。这既需要周围车辆运动的合理性,也需要精确的自车轨迹控制。仅从视角视频中学习车辆运动具有挑战性,因为运动与外观相互纠缠,且车辆可能被遮挡。因此,先前工作将视频生成条件化于指定车辆运动的布局上,从而能够控制周围车辆,但需要其未来轨迹作为输入。我们提出 BirdDreams,一种自回归驾驶世界模型,联合生成视角视频和示意性鸟瞰图(BEV)视频,使场景布局成为预测未来的一部分。BEV 在训练时由场景标注渲染而成,以固定度量尺度将道路和车辆描绘为简单形状,提供其位置和运动的俯视视图,并减少车辆之间的遮挡。相比之下,视角视频保留了 BEV 所省略的场景细节,例如交通信号和物体外观。两个视频扩散 Transformer(每个流一个)之间的联合注意力使每个流在生成过程中能够相互传递信息。预测的 BEV 还为自车控制提供了几何接口:我们沿输入自车轨迹平移和旋转其最新帧,并将所得帧用作软条件,以展示如果只有自车移动,场景将如何呈现运动。在推理时,BirdDreams 从单张相机图像生成两种视频,无需高清地图或车辆状态输入。在 PhysicalAI-AV 和 nuScenes 上,BirdDreams 比先前的驾驶世界模型更忠实地遵循输入自车轨迹,并在没有自车动作条件化的情况下生成更合理的自车运动。人类评估表明,BirdDreams 在生成逼真的周围车辆行为方面优于仅使用视角的基线方法。
一句话总结
来自 NVIDIA 和 KAIST 的研究者提出 BirdDreams,一种自回归驾驶世界模型,它联合生成透视视频和鸟瞰(BEV)视频,并在两个视频扩散 Transformer 之间使用联合注意力;该模型将预测的 BEV 作为几何自车控制接口,仅从单张相机图像出发,在 PhysicalAI-AV 和 nuScenes 上更忠实地跟随输入的自车轨迹,而不需要 HD 地图或车辆状态输入。
核心贡献
- BirdDreams 是一种自回归驾驶世界模型,联合预测透视视频和示意性鸟瞰(BEV)视频,使场景布局成为预测未来的一部分,而非外部输入。BEV 流以固定度量尺度将道路和车辆表示为简单形状,两个视频扩散 Transformer 之间的联合注意力让透视流和 BEV 流相互提供信息。
- 预测的 BEV 提供了一个几何控制接口:其最新帧沿输入自车轨迹进行平移和旋转,所得帧被用作软条件。推理时,BirdDreams 仅从单张相机图像生成两种视频,不需要 HD 地图或车辆状态输入。
- 在 PhysicalAI-AV 和 nuScenes 上,BirdDreams 在有无自车动作条件的情况下,均比先前驾驶世界模型获得更低的自车轨迹误差。人类评估显示,BirdDreams 生成的周围车辆行为比仅透视基线更真实。
引言
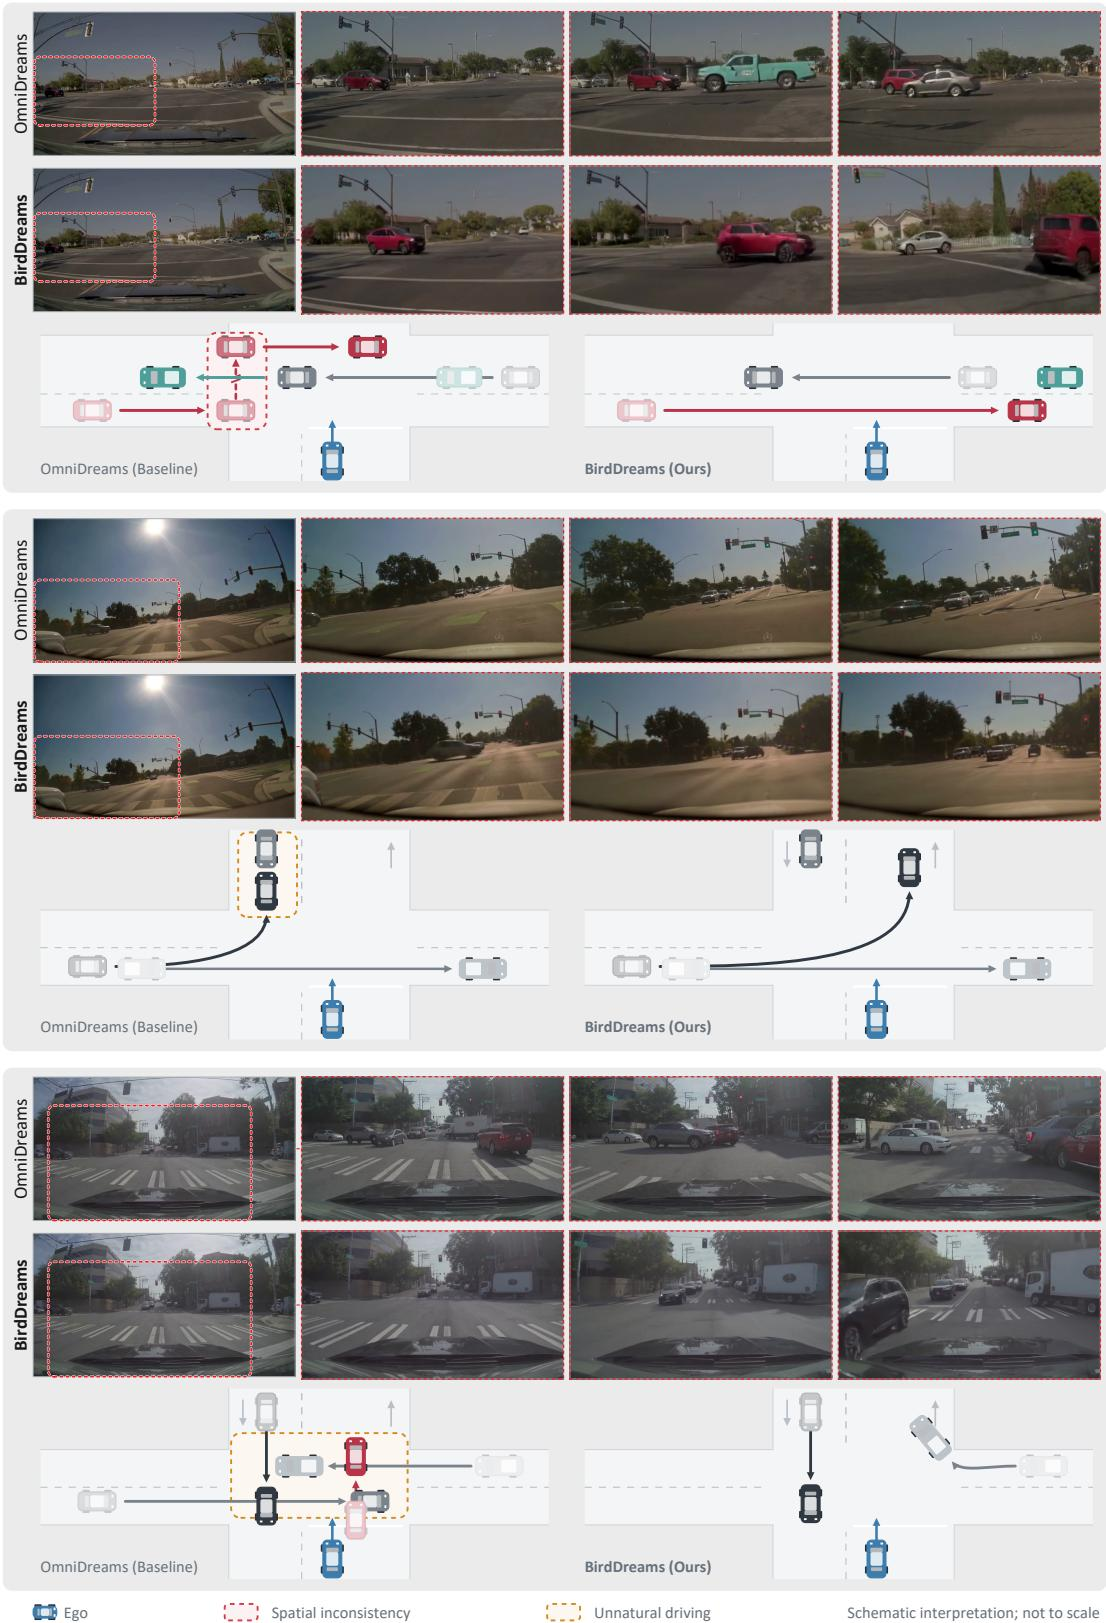
仿真使自动驾驶系统能够在真实道路上难以安全复现的罕见危险场景中得到测试。驾驶世界模型从真实驾驶视频中学习,以自车动作为条件合成未来观测,但周围车辆必须对新自车操控作出合理响应。OmniDreams 等先前模型以外部场景布局为条件进行生成;当这些布局来自记录轨迹时,周围车辆被固定在录制运动中,无法对新自车操控作出反应,而没有布局输入的模型则因透视运动与纹理、光照、遮挡和相机距离纠缠而表现挣扎。作者提出 BirdDreams,一种自回归驾驶世界模型,联合生成透视视频和示意性鸟瞰视频,使场景布局成为预测未来的一部分。BEV 流提供固定度量尺度、俯视视角和面向车辆运动的简化语义场景表示,联合注意力将其与照片级透视视频耦合;预测的 BEV 还通过沿自车轨迹重投影作为动作接口,改善轨迹跟随。
数据集
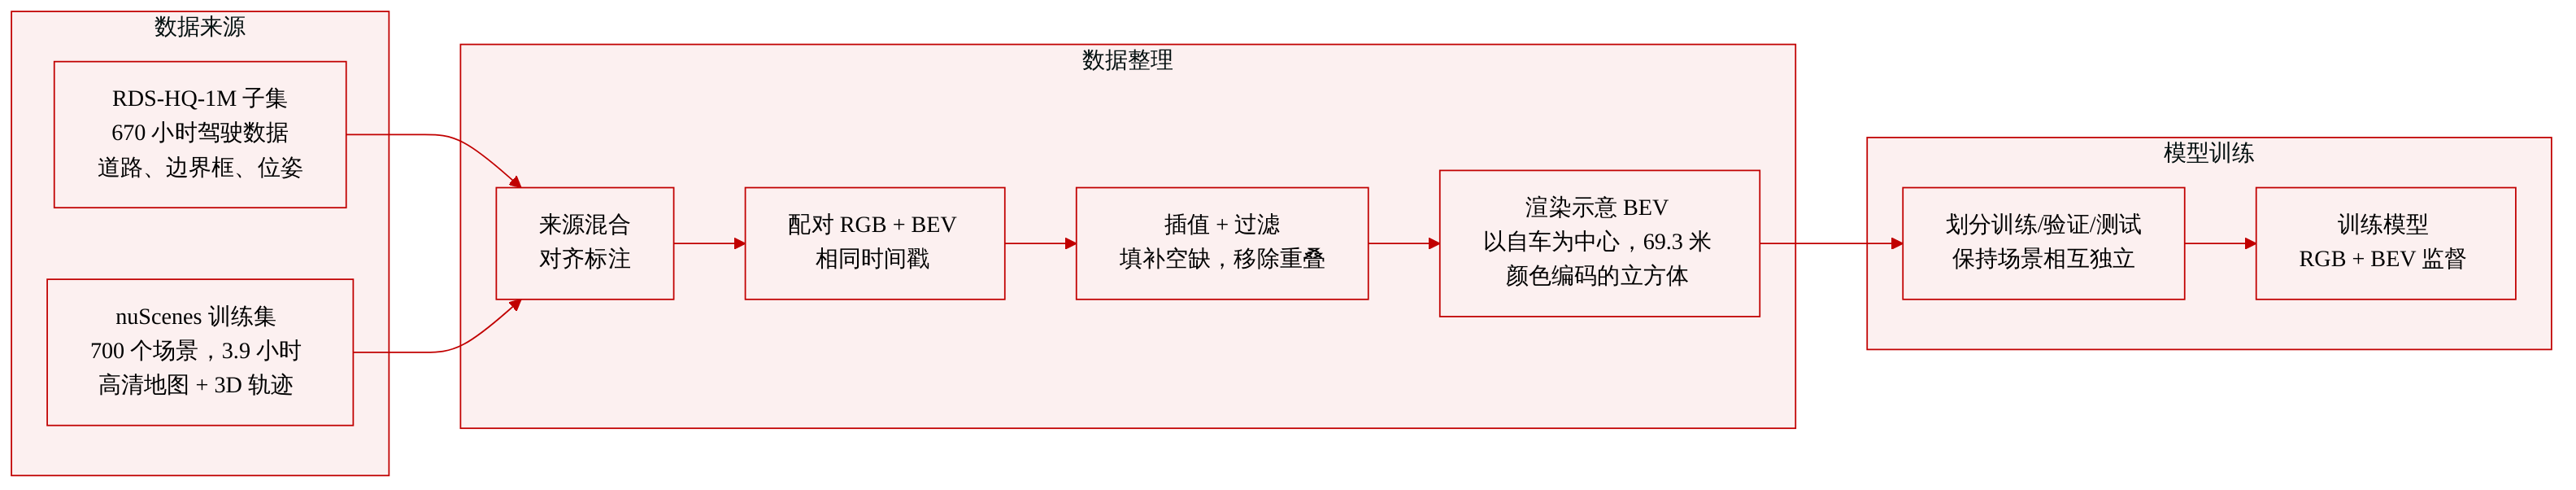
作者从同一场景的前视相机 RGB 视频和渲染的示意性鸟瞰(BEV)视频构建配对训练样本。
-
来源与规模:数据组合了 RDS-HQ-1M 的一个子集(约 670 小时驾驶数据)和 nuScenes 官方训练划分(700 个场景,约 3.9 小时)。RDS-HQ-1M 子集提供道路布局标注、跟踪物体框、自车位姿和相机标定。道路几何由车道、道路边界、人行横道和停止等待线构建。对于 nuScenes,作者使用 HD 矢量地图和标注的 3D 框轨迹。
-
样本对构建:每个 RGB 帧与同一采集时刻根据物体位置和朝向渲染的 BEV 帧配对。
-
轨迹插值与过滤:物体框的标注频率可能低于 RGB 帧。作者使用轨迹 ID 在同一物体较早和较晚的标注之间插值位置和朝向,包括在暂时遮挡期间。渲染前会移除重复或过度重叠的车辆框。
-
BEV 渲染:BEV 帧以正交俯视图渲染,自车居中并朝上。道路元素绘制为折线和多边形,物体绘制为带朝向的长方体。在两个数据集中,每帧覆盖约 69.3 m 边长的正方形区域,因此像素位移在不同场景中可以一致地映射到物理距离。该像素到米的映射也用于自车动作重投影。
-
视觉模式:道路边界为品红色,人行横道为紫色,行人为黄色。车辆长方体前部着红色、后部着蓝色,以显示朝向。BEV 表示保留物体相对道路的位置和朝向,同时去除纹理和透视。
-
模型使用:配对的 RGB 和 BEV 视频用作训练数据。BEV 视频为车辆相对道路的运动提供显式监督,补充 RGB 视频提供的外观和运动监督。
方法
作者提出 BirdDreams,一种驾驶世界模型,联合预测照片级透视视频和示意性鸟瞰(BEV)视频,以捕捉自车动作下的场景动态和车辆响应。给定初始透视 RGB 图像 I0 和可选的自车动作 A0:T,模型生成联合条件分布 pϕ(I1:T,B0:T∣I0,c)。通过从 BEV 预测目标中去除纹理和光照变化,该架构将学习重点放在车辆相对于道路的运动上,同时允许透视分支利用显式场景动态。
框架图如下:
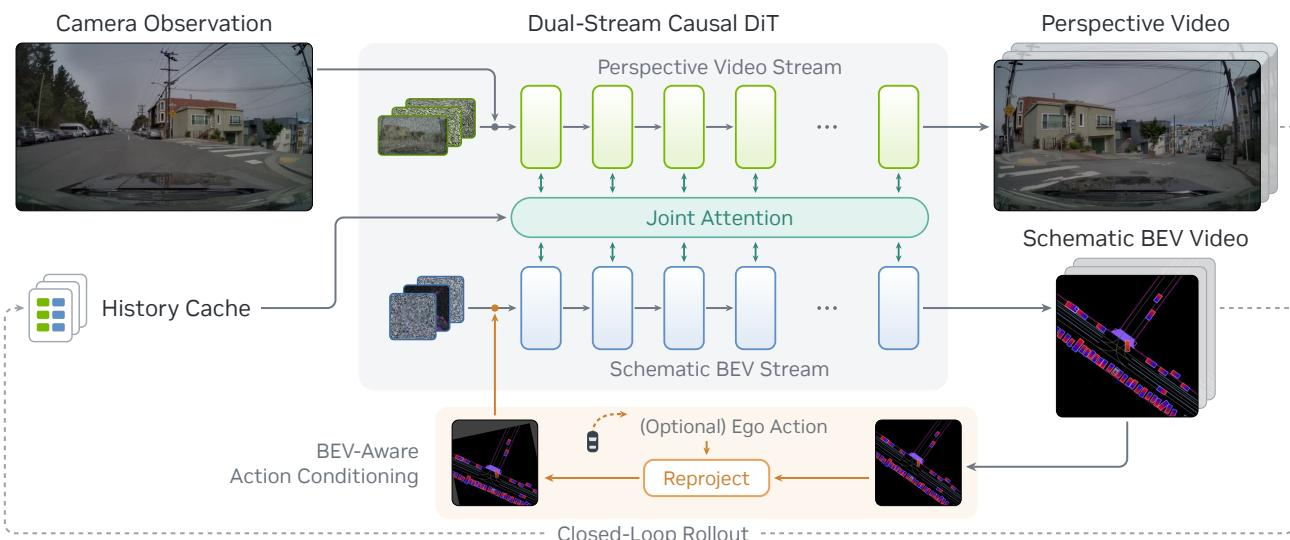
核心架构是一个双流因果 Transformer 混合模型。透视分支继承预训练的 OmniDreams 主干,BEV 分支用其权重副本初始化。冻结的视频 VAE 将每条流编码为 latent,并将其划分为由三个 latent 帧组成的块。注意力在每个块内是双向的,在块之间是因果的。在每个 Transformer 块中,联合注意力允许来自每个分支的 query 关注来自两条流的 key 和 value,从而交换度量场景动态和视觉细节,同时保留独立的投影和输出头以实现专门化。
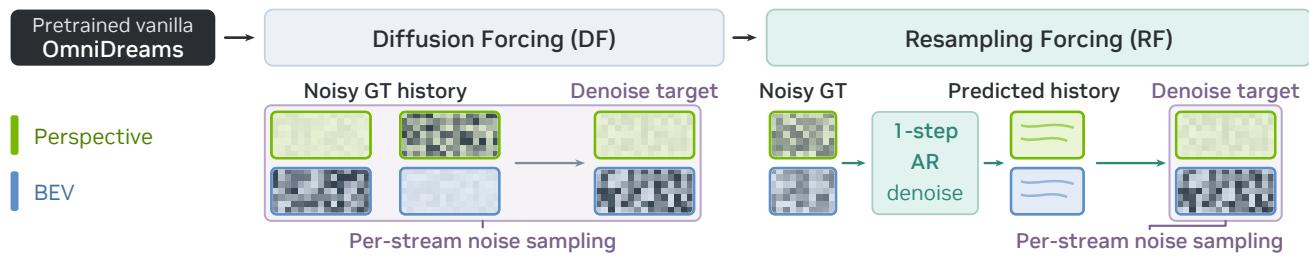
为训练这种联合生成,作者采用 Diffusion Forcing 并对每条流独立采样噪声。噪声水平在每个块内对透视流和 BEV 流分别独立采样。干净的 VAE latent zks 通过整流流插值进行加噪:
xks=(1−σks)zks+σksϵks,ϵks∼N(0,I)其中 σks 在一个块内的三个 latent 帧之间共享,但在不同块和不同流之间独立采样。模型用联合流匹配损失预测流速,该损失对 latent 元素和块求平方误差平均,并对两条流赋予相等权重,以避免较大的透视帧占据主导。
如下图所示:
对于自车动作条件,模型利用 BEV 的固定度量尺度。最新预测的 BEV 帧 Br 被重投影到目标自车位姿 (pt,θt),以考虑自车引起的表观运动。重投影将每个目标像素 u 映射回参考帧:
Bt(u)=Br(Π[R(θr)T(R(θt)Π−1(u)+pt−pr)])这些重投影帧经 VAE 编码、轻微加噪,并通过零初始化投影添加到 BEV 输入 token 中。联合注意力随后将该条件传递给透视分支。
推理时,模型执行因果式 rollout,逐块生成 latent,同时缓存先前块的 key 和 value。为了提高自回归生成的鲁棒性,作者使用 Resampling Forcing 对模型进行微调。该过程在共享噪声水平 τ 下对真值块加噪,并通过单个 Euler 步对每个块去噪,以自回归方式构造条件历史:
zk=sg[xk(τ)−τvϕ(xk(τ),z<k,τ)]随后目标去噪在块和流之间使用独立采样的噪声水平进行。
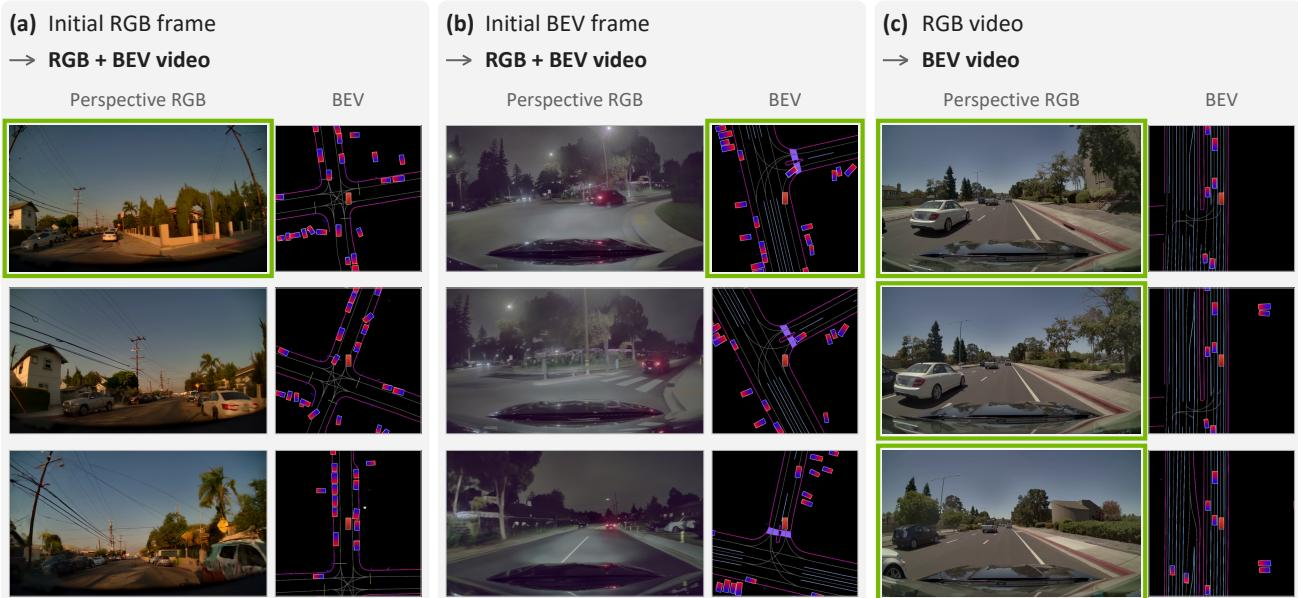
按流训练还使推理时的条件设置更加灵活。当一条流中提供完整视频时,模型可以生成同步视频;也可以仅从任一模态的初始帧生成透视和 BEV 视频。
如下图所示:
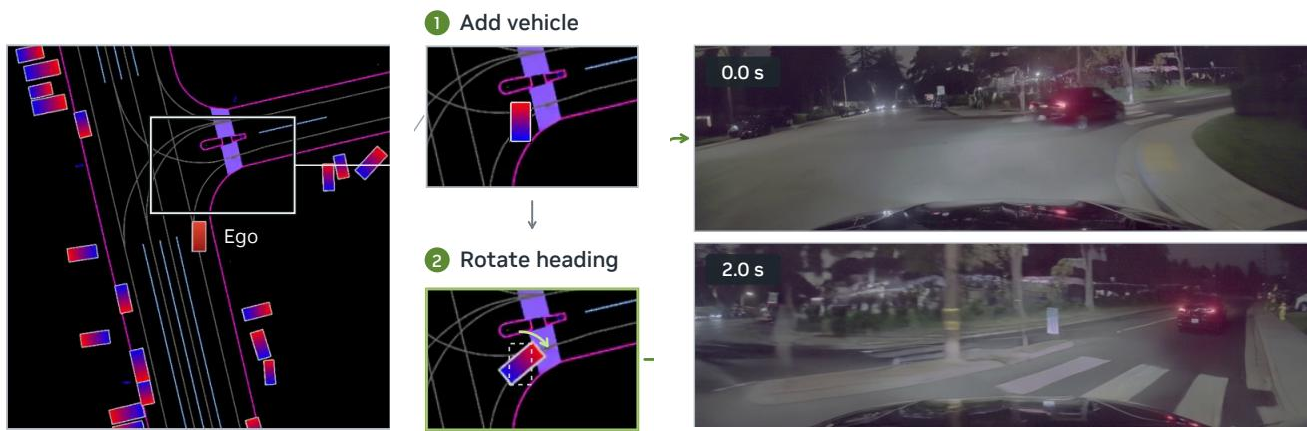
此外,示意性俯视图便于场景编辑。用户可以直接在投影的 BEV 布局中添加车辆或调整其位置和朝向,从而定制驾驶场景。模型随后从该编辑后的初始布局联合生成相应的透视和 BEV 视频,在不需要对应透视图像的情况下合成场景外观和后续车辆运动。
如下图所示:
实验
实验在 PhysicalAI-AV 和 nuScenes 上评估 BirdDreams 的透视视频生成和自车轨迹控制,包括有无自车动作条件两种情况,并与开放的驾驶世界模型进行比较。结果表明,BirdDreams 生成更准确的自车运动和更高质量的视频,反事实 rollout 和人类评估表明其周围车辆反应比基线更真实。额外分析验证了按流独立噪声采样能提高生成质量,联合透视-BEV 建模对自车轨迹预测有少量收益,以及 BEV 编辑支持可控场景生成。
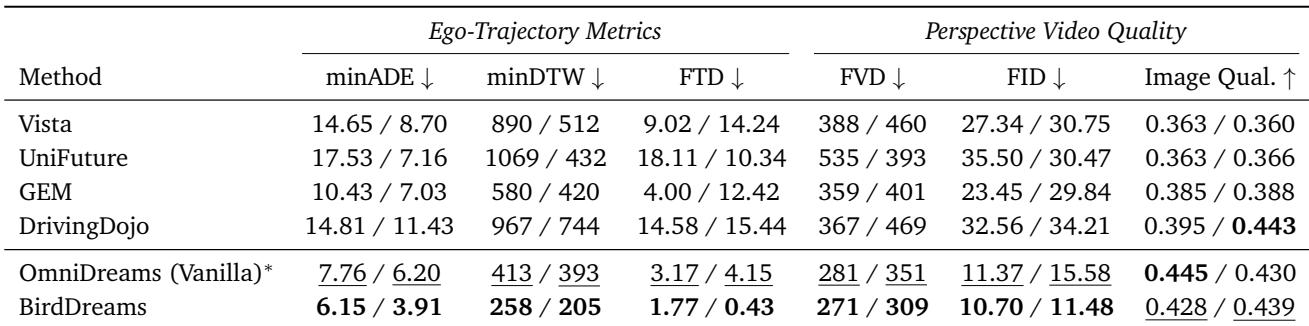
在没有提供自车动作条件时,BirdDreams 在比较方法中取得最佳的自车轨迹和视频质量结果,包括在 PhysicalAI-AV 和 nuScenes 上最低的 minADE、minDTW、FTD、FVD 和 FID。其帧级图像质量并非最佳,在两个基准上均排名第二,在 PhysicalAI-AV 上落后于 OmniDreams (Vanilla),在 nuScenes 上落后于 DrivingDojo。相对于 OmniDreams (Vanilla) 的 minADE 改进在 nuScenes 上大于 PhysicalAI-AV。BirdDreams 在两个基准上的所有评估方法中具有最低的自车轨迹误差和最低的 FTD、FVD 和 FID。BirdDreams 在两个数据集上的图像质量均排名第二,在 PhysicalAI-AV 上落后于 OmniDreams (Vanilla),在 nuScenes 上落后于 DrivingDojo。相对于 OmniDreams (Vanilla) 的 minADE 改进在 nuScenes 上大于 PhysicalAI-AV。
在有自车动作条件时,BirdDreams 在两个基准上比所比较的驾驶世界模型更忠实地执行给定的自车轨迹,取得最低的轨迹误差指标。它还取得最佳的透视视频保真度指标,并且逐帧图像质量在 PhysicalAI-AV 上排名第一,在 nuScenes 上排名第二。最强基线 OmniDreams (Plücker) 使用 Plücker 射线嵌入进行自车运动条件设置。BirdDreams 在两个基准上的评估方法中记录了最低的 ADE、DTW 和 FTD。相对于 OmniDreams (Plücker),BirdDreams 在 PhysicalAI-AV 上将 ADE 降低 35%,在 nuScenes 上降低 36%。BirdDreams 还取得最佳的 FVD 和 FID,图像质量在 PhysicalAI-AV 上排名第一,在 nuScenes 上排名第二。
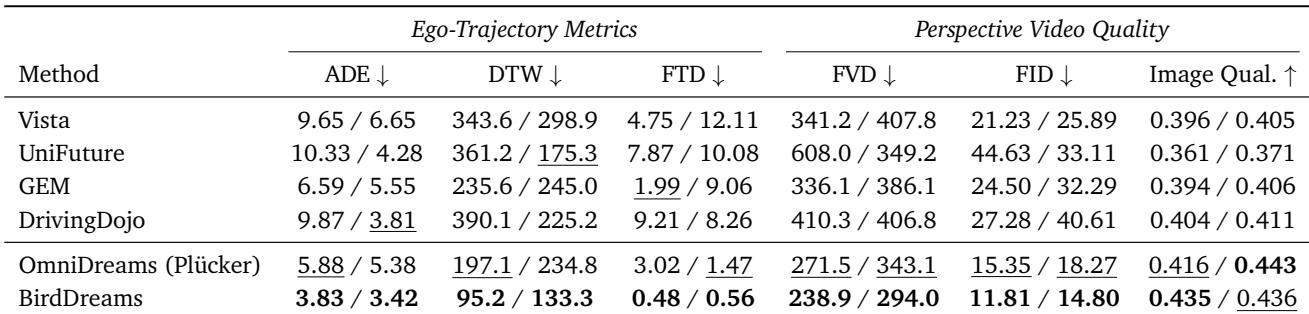
第一项实验在 PhysicalAI-AV 和 nuScenes 上评估无条件生成的自车轨迹质量和视觉保真度,BirdDreams 取得最强的整体轨迹和视频质量,帧级图像质量排名第二。第二项实验加入自车动作条件,以验证轨迹跟随和条件视觉生成,结果显示 BirdDreams 比基线更忠实地执行给定自车轨迹,并取得最佳视频保真度,图像质量在 PhysicalAI-AV 上排名第一,在 nuScenes 上排名第二。在两种设置下,BirdDreams 一致优于最强基线 OmniDreams,且在条件设置下的轨迹改进明显更大。