Command Palette
Search for a command to run...
Tree-Ising:通过比特级 Ising 编辑修复语言模型
Tree-Ising:通过比特级 Ising 编辑修复语言模型
Hadi Salloum Ammar Ali
摘要
权重空间编程在 Takehi 等人近期的 MIT 工作中被提出,它使前沿 LLM 智能体能够读取网络权重并编写修复方案。他们的 GPT-6 Astra 智能体在无梯度条件下纠正了 Qwen3.5-0.8B 的推理循环,使用了 158 个智能体轮次、8970 万个 token 以及 50 次前向传递请求。我们的方法 TREE-ISING 将这种修复建模为在模型原生 BF16 权重上的稀疏离散优化问题。我们利用前向统计量定义目标函数,以削弱循环方向、增强结论方向,并在有效 token 上保持该层输出。在状态树表示中(其中无损 BF16 存储是一个特例),允许的编辑由符号翻转和指数移位组成,并保持所有共享组指数和尾数不变。我们将该目标精确分解为相互独立的 QUBO(Ising)问题,每个输出行对应一个,并在 GPU 上使用模拟退火或量子启发的模拟分岔方法求解。在智能体所针对的两个层上进行评估时,TREE-ISING 在 MATH-500 上达到 54.6%,在相同评估协议下优于智能体编辑(51.7%),而基础模型仅得 7.9%。此外,模拟分岔求解器得到的修复方案在统计上不可区分,得分为 55.1%。至关重要的是,在全部五个数学基准上,两种求解器均优于智能体编辑;在对多重比较进行校正后,MATH-500 和 GSM8K 上的提升具有统计显著性。此外,我们的方法修改的权重数量减少了 13% 至 17%,并将 BF16 比特翻转次数降低至原来的 1/2.2 至 1/2.3。它仅需四次前向传递请求和零个 LLM token,退火方案在 GPU 时间上的成本约为 0.90 美元。将这一方法扩展到 Qwen3.5-2B,其中层和剂量仅使用基础模型来选择,同一方案将贪婪 GSM8K 准确率从 21.6% 提高到 69.4%。最后,作为概念验证,我们在 IBM Heron 处理器上使用 QAOA 执行了一个八变量修复子问题。
一句话总结
来自 QDeep、LEAD 和 ITMO 大学的研究人员提出 TREE-ISING,该方法通过将稀疏离散 BF16 权重编辑建模为逐行 QUBO(Ising)问题,并用模拟退火或模拟分岔求解,来修复语言模型;在相同评估协议下,其在 MATH-500 上达到 54.6%,而 agent edit 为 51.7%,所用权重少 13% 至 17%,且零 LLM tokens,并将 Qwen3.5-2B 的贪婪 GSM8K 准确率从 21.6% 提升到 69.4%。
核心贡献
- TREE-ISING 将 LLM 权重修复形式化为对模型原生 BF16 权重进行无梯度、稀疏离散优化,使用状态树表示,将可允许编辑限制为符号翻转和指数偏移,同时保留共享组指数和尾数。前向统计目标被精确分解为独立的 QUBO/Ising 问题,每个输出行一个,并在 GPU 上通过模拟退火或模拟分岔求解。
- 在 Qwen3.5-0.8B 上,TREE-ISING 修复了早前 GPT-6 Astra agent edit 所针对的两个层,使用模拟退火在 MATH-500 上达到 54.6%;模拟分岔达到在统计上无差异的 55.1%,而 agent edit 为 51.7%,基础模型为 7.9%。在所有五个数学基准上,它优于 agent edit,修改权重少 13% 至 17%,将 BF16 位翻转减少 2.2 至 2.3 倍,并且仅需四次前向传递请求和零 LLM tokens,每次运行约 0.90 美元。
- 同一方法扩展到 Qwen3.5-2B,仅从基础模型选择目标层和剂量,就将贪婪 GSM8K 准确率从 21.6% 提高到 69.4%。在 IBM Heron 处理器上的概念验证 QAOA 实验执行了一个八变量、源自修复的 Ising 子问题,表明在量子硬件上的初步可行性。
引言
权重空间编程最近表明,前沿 LLM agent 可以直接编辑另一个模型的权重,以修复小型推理模型中的常见故障:循环行为耗尽 token 预算并严重限制在 MATH-500 等基准上的准确率。这一点很重要,因为此类故障在长推理轨迹中频繁出现,但先前的基于 agent 的修复成本高昂、启发式,并且无法保证所选编辑是最优的。作者将该修复形式化为对存储的 BF16 权重进行稀疏离散优化,用状态树表示网络,并将问题分解为独立的逐行 Ising 模型。他们的方法 TREE-ISING 使用前向统计选择层并定义目标,然后用 GPU 退火器或量子启发求解器求解所得 Ising 问题,产生比 agent 基线更准确且成本显著更低的修复。
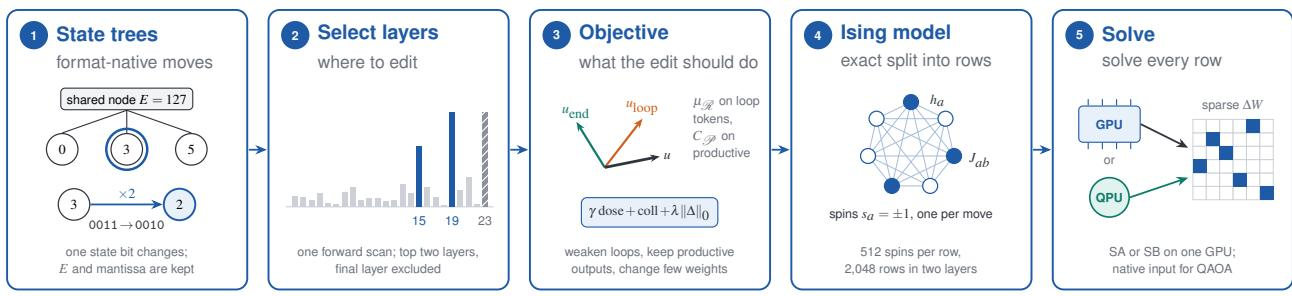
方法
作者提出 TREE-ISING,一种编辑冻结 MLP 输出投影 W∈Rd×n 以纠正语言模型中推理循环的方法。他们将此权重空间编程任务形式化为包含五个关键步骤的离散优化问题。
如下图所示:
步骤 1:便于 QUBO 的权重表示
作者使用状态树表示权重,将低位压缩与精确存储统一起来。对于无损 BF16 存储,一行中 64 个连续权重共享一个最大指数 E。每个权重存储一个 4 位状态 D=E−e 和一个包含符号和尾数的叶子。编辑被限制为一组可允许移动 F={−1,2,21,4,−2,−4,−21,41}。这些移动保持共享指数并避免越界,确保编辑只改变单个权重的符号位和 4 位状态。通过为每个候选权重预选一个可允许移动,编辑变为二元决策,符合二次无约束二元优化(QUBO)格式。
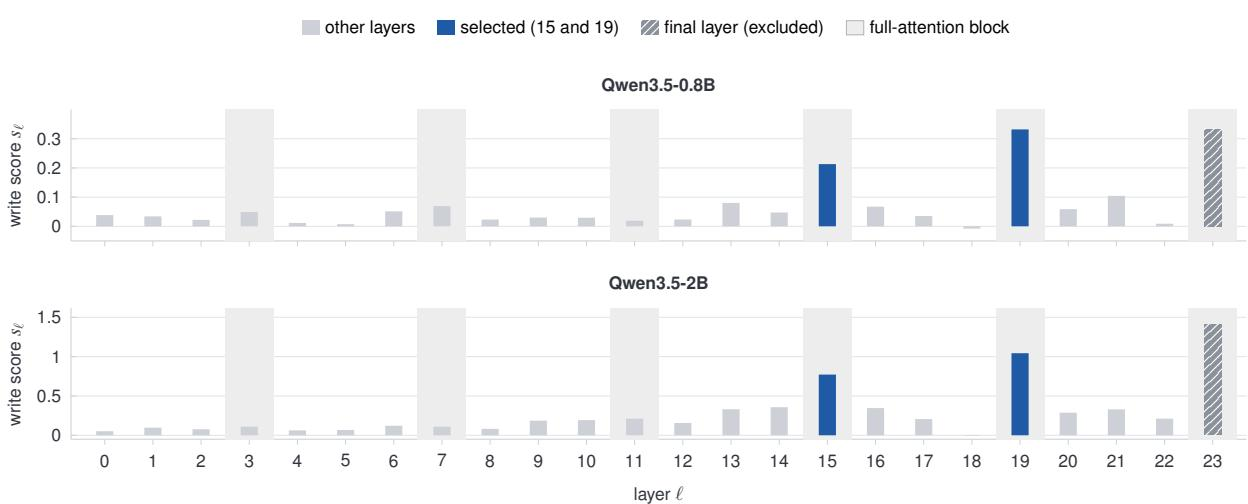
步骤 2:选择层
为了确定要编辑哪些层,作者执行前向层扫描。基础模型生成答案,teacher-forced 前向过程记录残差流、MLP 输出和输出投影输入。他们计算结合循环方向和结束方向的目标方向 uℓ:
uℓ,loop∝hˉℓ,R−hˉℓ,P,uℓ,end∝hˉℓ,Z−hˉℓ,M,uℓ∝uℓ,loop−βuℓ,end其中 β=0.5。层 ℓ 的写入分数衡量其 MLP 在 loop tokens 上相比 productive tokens 沿 uℓ 推动残差流的程度:
sℓ=uℓ⊤(mˉℓ,R−mˉℓ,P)选择规则针对得分最高的两个层,排除最后一层。
如下图所示:
步骤 3:定义目标
对于给定的被编辑层,目标是最小化编辑的剂量,即沿 u 对 loop tokens 的影响,以及附带损伤,即对 protected tokens 的扰动,再加上稀疏惩罚:
E(Δ)=γdose(Δ)+coll(Δ)+λ∥Δ∥0其中 dose(Δ)=u⊤ΔμR,coll(Δ)=∑r=1dΔr:CPΔr:⊤。参数 γ 确保编辑达到目标剂量,而 λ 将编辑限制在特定的变更权重预算内。
步骤 4:精确分解为行 Ising 模型
目标被精确分解为每个输出行的独立问题。作者保留得分最高的 K 列,并为每个列预选最佳可允许因子。行问题被表述为 QUBO:
Er(x)=a=1∑Khaxa+a=b∑Jabxaxb其中 ha 聚合了剂量、自附带损伤和稀疏成本,Jab 表示联合附带损伤。代入自旋 s=2x−1 将该能量转换为 Ising 模型。
步骤 5:求解 Ising 模型
作者使用 GPU 模拟退火或离散模拟分岔(dSB)求解行问题。在求解之前,他们校准稀疏权重 λ,并执行几何二分以找到达到目标剂量的最小 γ。该公式保持求解器无关,可与量子退火器或 QAOA 无缝集成。
实验
实验评估了一种应用于 Qwen3.5 模型的离散、低足迹修复方法:对于 Qwen3.5-0.8B,该方案针对第 15 层和第 19 层的 down_proj 矩阵,并在共享数学基准测试框架下与 LLM agent edit 进行比较,结果表明该修复提高了各基准上的准确率和终止率,同时降低了计算成本和权重级变更。消融实验表明,方向性目标,尤其是结束方向项,带来了大部分收益,并且离散求解器以少得多的修改权重匹配了连续秩一解。在 Qwen3.5-2B 上的迁移实验中,层和剂量仅从基础模型统计信息自主选择,大幅提高了贪婪 GSM8K 准确率并减少了循环导致的截断,证实该方案无需参考编辑即可运行。量子硬件概念验证表明,一个小的源自修复的 Ising 实例可在 IBM Heron 处理器上编码和采样,但并未展示量子优势;同时所述局限性突出了狭窄的故障模式范围、代理目标启发式,以及对较小模型先前 agent 见解的部分依赖。
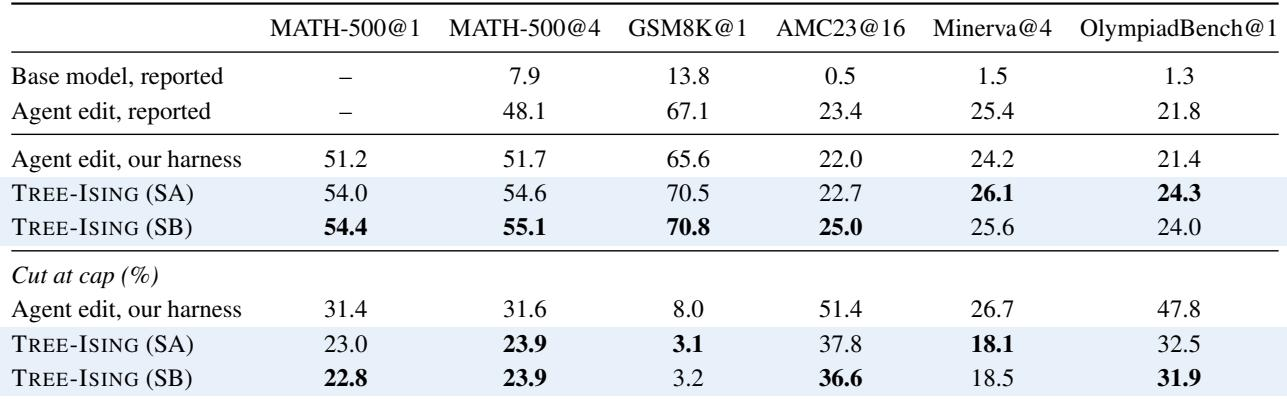
TREE-ISING 相比 LLM agent edit 提高了 MATH-500 准确率,同时降低了在 token 上限处被截断的答案比例。它还在基准比较中领先,并实现大幅成本降低:不使用 LLM tokens,所需前向传递请求少得多,GPU 时间和墙钟时间也更短。TREE-ISING 在 MATH-500 上取得了相对 agent edit 的统计显著准确率提升。它在全部五个基准上领先,其中两项领先在校正后仍然显著。相对于 agent edit,它减少了 MATH-500 截断答案,并且无需 LLM tokens,同时使用的计算量和墙钟时间少得多。
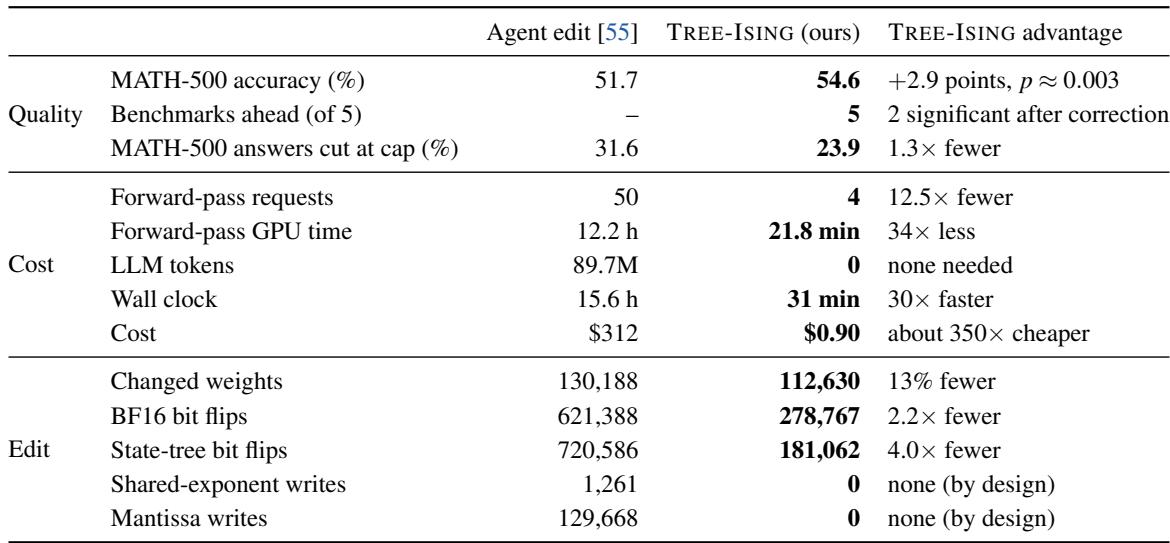
修复过程定义了四个 token 集合,完全来自基础模型自身的练习答案。loop 集合捕获重复 8-gram 出现后的位置,而 protected、concluding 和 continuing 集合标记非循环、与完成相关以及更早的推理 tokens。对比这些集合之间的平均残差方向,可得到一个综合方向,抑制循环并鼓励模型得出结论。loop tokens 仅在重复开始后收集,而 protected tokens 包括重复开始前的位置以及正确完成轨迹中的所有生成 tokens。concluding tokens 选择正确结束前的最后推理位置,而 continuing tokens 覆盖同一正确轨迹中更早的推理位置。
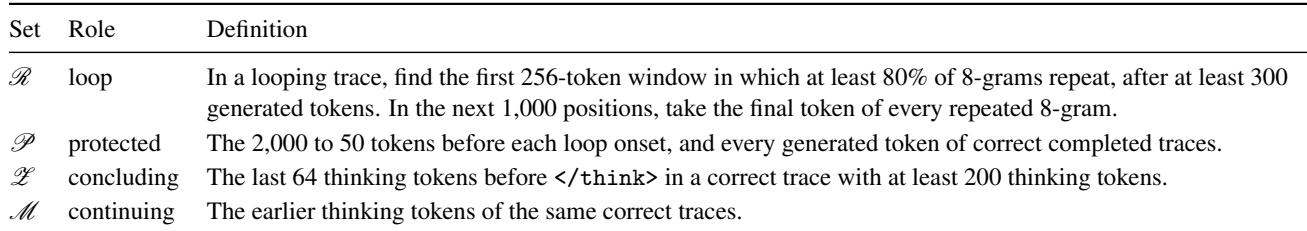
在 Qwen3.5-0.8B 的已评估基准上,TREE-ISING 编辑优于 agent edit,其中在 MATH-500 和 GSM8K 上的提升最强且统计稳健。这些改进伴随着更低的 token 上限截断率,表明编辑后的模型更常在预算内完成推理。结果还超过了原先报告的 agent 分数,在五个基准系列中的四个上均如此。无论使用哪种求解器,TREE-ISING 在全部五个基准系列上都取得了比 agent edit 更高的准确率,其中在 MATH-500 四次补全和经校正后的 GSM8K 上具有统计显著提升。TREE-ISING 编辑在每个基准上触及 token 上限的频率都更低,截断率在 GSM8K 和 OlympiadBench 上大幅下降,并推动了大部分准确率提升。
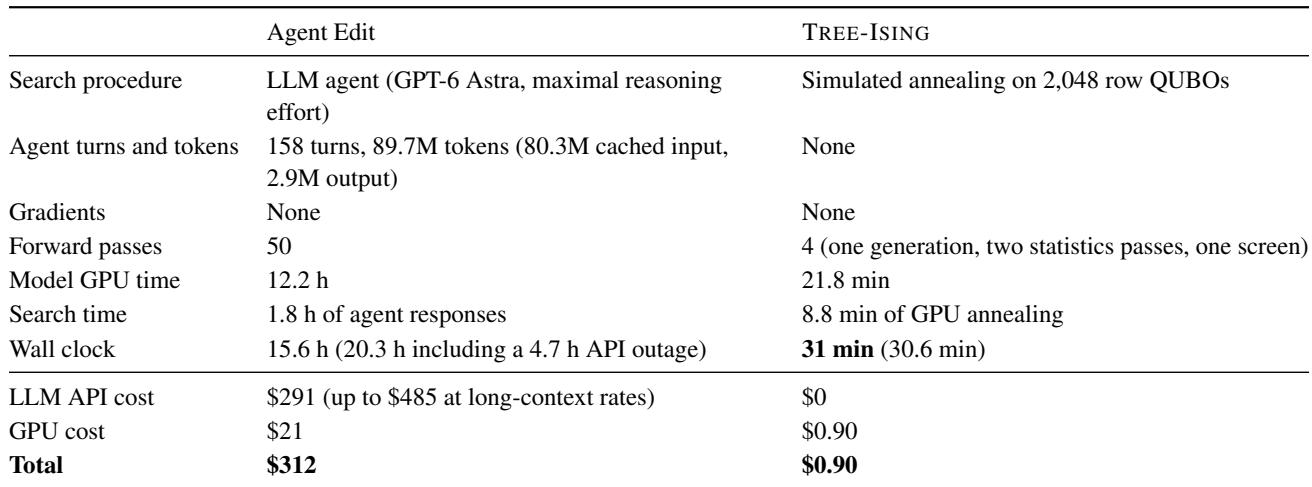
固定修复方案使用的计算量远小于 agent 的穷举式发现运行:只需四次前向传递且不使用 LLM tokens,而 agent 需要五十次前向传递和数千万 tokens。前向传递 GPU 时间从超过十二小时降至约二十二分钟,总体墙钟时间从超过十五小时降至约半小时。该比较不包括方法开发成本,反映的是对已知修复的高效应用,而非原始发现过程。与 agent 的发现运行相比,固定方案将前向传递 GPU 计算量减少了 34 倍。固定方案在约半小时墙钟时间内完成,且需要零 LLM tokens,而 agent 需要超过十五小时并消耗近九千万 tokens。
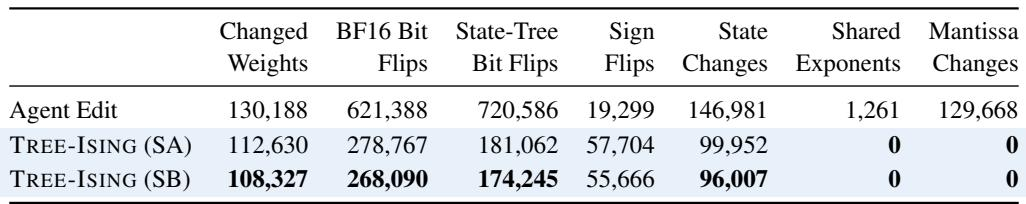
在两个被编辑矩阵上,TREE-ISING 编辑的结构足迹都小于 agent edit。它们更改的权重更少,产生的 BF16 和状态树位翻转更少,并且不改变共享指数和尾数。随机分支变体比模拟退火略紧凑,而 agent edit 进行了大量尾数重写和共享指数偏移。TREE-ISING 修改的权重更少,其中随机分支变体在三种编辑中变更权重数最少。相对 agent edit,BF16 位翻转减少一半以上,状态树位翻转减少约四倍。TREE-ISING 不进行共享指数或尾数更改,而 agent edit 对几乎所有触及权重重写尾数,并偏移了一千多个共享指数。在 TREE-ISING 下符号翻转显著更频繁,这与缩放和符号移动是其典型编辑的组成部分一致。
实验在多个基准上评估 TREE-ISING 与 LLM agent edit,显示 MATH-500 和 GSM8K 准确率提高、截断答案更少,整体基准表现更强。基于基础模型自身正确轨迹和循环轨迹构建的修复过程产生了一个抑制重复并鼓励完成的方向。固定修复方案比 agent 发现运行便宜得多,无需 LLM tokens,GPU 和墙钟时间也少得多,同时所得编辑的结构足迹更小,权重和位翻转更少,且没有共享指数或尾数更改。