Command Palette
Search for a command to run...
基于条件偏移的少步流式视频生成
基于条件偏移的少步流式视频生成
摘要
少步采样降低了流式视频生成的成本。分布匹配蒸馏(DMD)使用一个独立的伪分数网络来监督少步生成器,这增加了训练内存和计算量,并且必须跟踪不断演化的生成器。我们通过条件偏移在生成器内部估计生成分布的速度场,从而将 APEX 扩展到流式视频。原始文本条件用于选择生成,而偏移后的条件则使用相同参数选择伪估计。这移除了独立的伪网络,同时保留了 S2-Avatar 的冻结参考教师、自回放强制(Self-Replay Forcing)和感知正则化。我们在 180 秒视频上评估 APEX,每个块使用三次骨干评估和一个单步空间 Refiner,并进行 70 例人类研究和 320 例 StreamAV-Bench 对比。与 S2-Avatar 相比,APEX 在 Progressive 赛道上实现了更高的视频指令满足度(3.856 对 3.831),并且在两条赛道上均获得更高的视觉美学评分(0.641898 对 0.632606)。人类评估者在指令遵循方面最偏好 APEX,净偏好为 +30.0%,其次是一致性和视频质量,均为 +4.3%。运动质量偏向 S2-Avatar,音画同步大多数情况下持平,可用性无变化。在匹配训练设置下的单独测量表明,与 DMD 相比,每 GPU 峰值分配显存降低 4.4%,平均迭代时间缩短 9.2%。
一句话总结
来自清华大学、生数科技和西湖大学的研究人员将 APEX 扩展到少步流式视频生成,方法是在生成器内部使用条件偏移来估计生成分布的速度场,从而消除 DMD 单独的伪分数网络,同时保留 S2-Avatar 的冻结参考教师、Self-Replay Forcing 和感知正则化;在 180 秒视频上评估,每个块进行三次骨干评估,使用一步空间 Refiner、70 例人类研究和 320 例 StreamAV-Bench 对比,APEX 在 Progressive 轨道上取得更高的视频指令满足度(3.856 对 3.831),并在两条轨道上取得更高的视觉美学分数(0.641898 对 0.632606),人类评分者在指令遵循上最偏好 APEX(净偏好 +30.0%),其次是一致性和视频质量(各 +4.3%),而运动质量更偏好 S2-Avatar,音视频同步大多持平,可用性不变;在匹配的训练设置下,APEX 每块 GPU 的峰值分配 GPU 内存比 DMD 低 4.4%,平均迭代时间短 9.2%。
核心贡献
- APEX 将条件偏移的伪估计集成到 S2-Avatar 的流式视频框架中,在同一个生成器内估计生成分布的速度场,并消除了单独的伪分数网络。
- 该方法保留了 S2-Avatar 的冻结参考教师、Self-Replay Forcing 和感知正则化,同时共享生成器和伪估计器参数,从而能够对 180 秒视频进行少步采样,而无需承担 DMD 伪网络的开销。
- 在 320 例 StreamAV-Bench 对比和 70 例人类研究中,APEX 相比 S2-Avatar 取得了更高的 Progressive 轨道指令满足度(3.856 对 3.831)和两条轨道上更高的视觉美学分数(0.641898 对 0.632606),人类评分者在指令遵循上对 APEX 的净偏好最高,达到 +30.0%;匹配训练还显示,每块 GPU 的峰值分配 GPU 内存比 DMD 低 4.4%,平均迭代时间短 9.2%。
引言
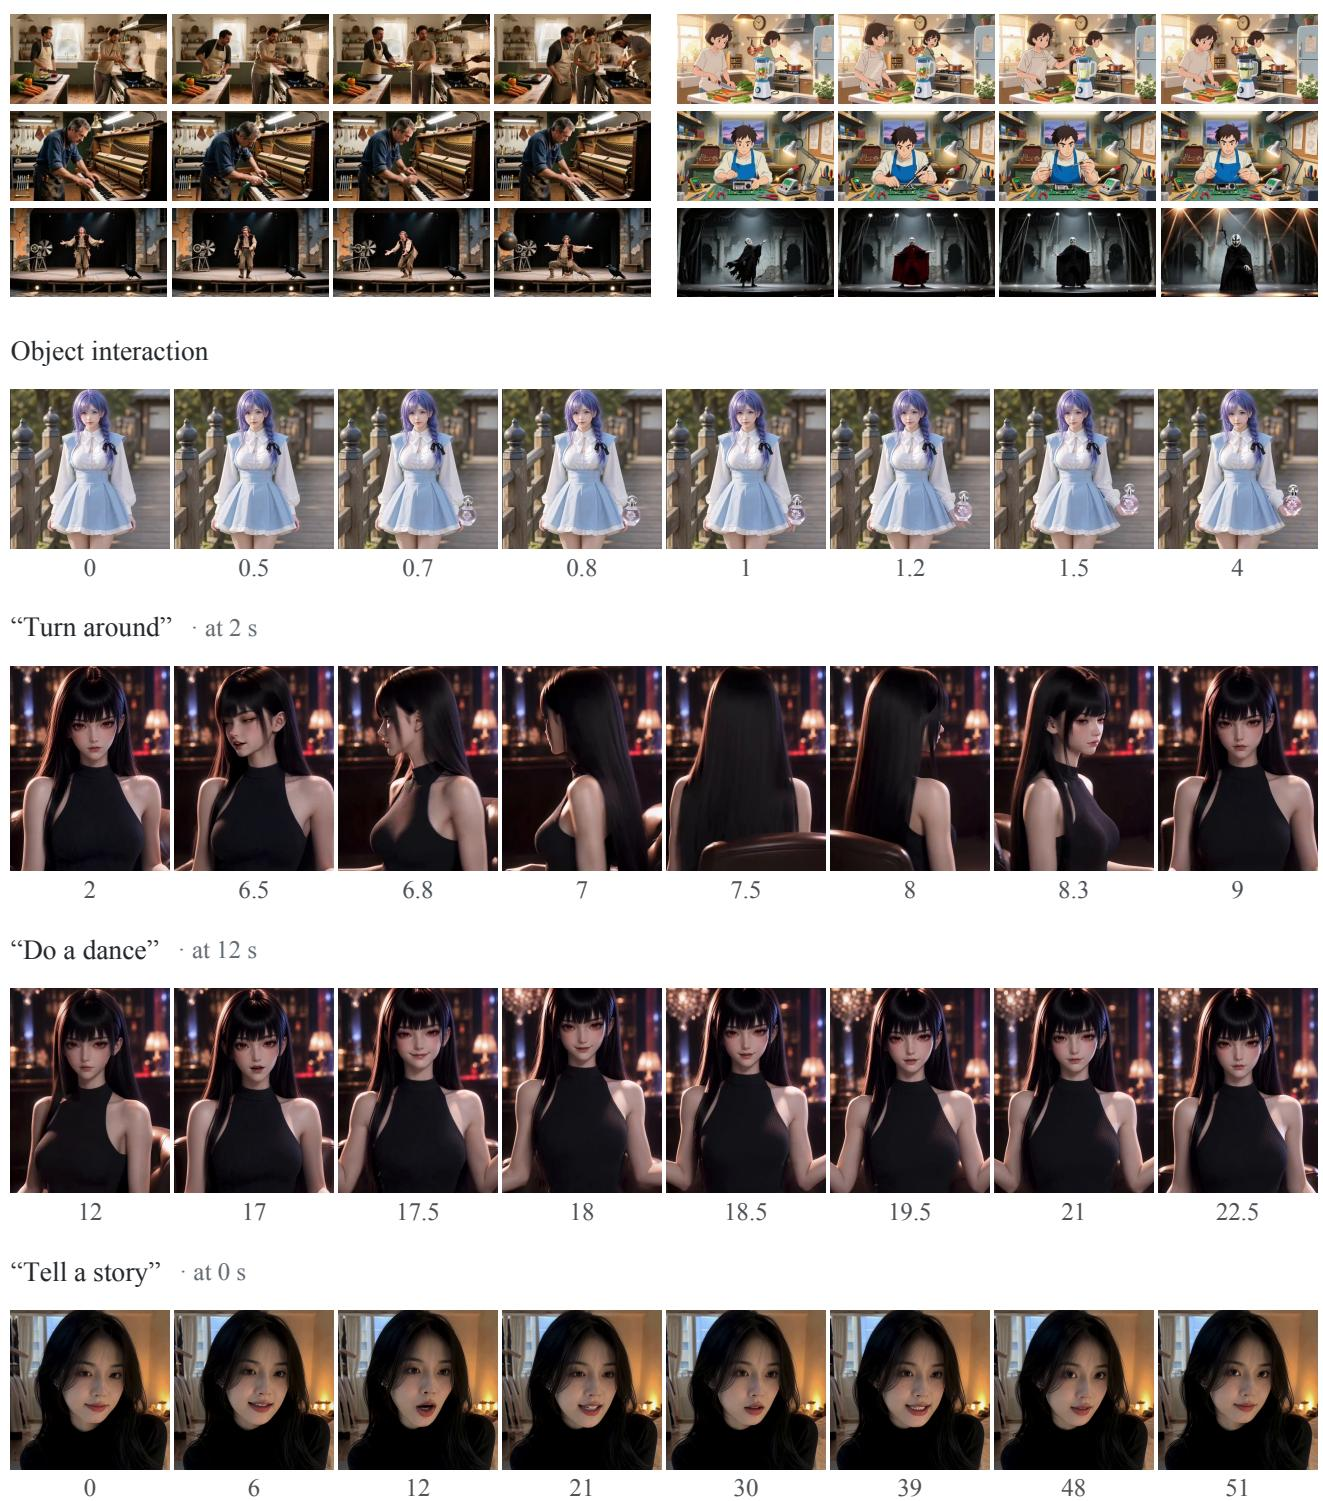
基于扩散或流模型的流式视频生成需要对每个新块进行重复网络评估,因此少步采样对长序列尤为有价值。分布匹配蒸馏可以降低这一成本,但通常使用辅助伪分数网络,这会增加训练内存和计算量,并且必须与不断变化的生成器保持同步。作者提出了 APEX,它将条件偏移的伪估计集成到 S2-Avatar 的 Self-Replay Forcing 框架中。该方法在生成器和伪估计器之间共享参数,去除了独立的伪网络,并保留了冻结的预训练教师。APEX 改善了指令遵循和视觉美学,同时降低了峰值 GPU 内存和平均迭代时间。
方法
作者在 Self-Replay Forcing 框架中利用 APEX 的条件偏移机制来优化流式视频生成。在该架构中,生成器和伪估计器共享相同的参数 θ,而冻结的教师模型 Fϕ 提供参考预测和引导。这种共享参数设计与传统分布匹配蒸馏方法形成对比,后者为伪估计器使用独立参数。
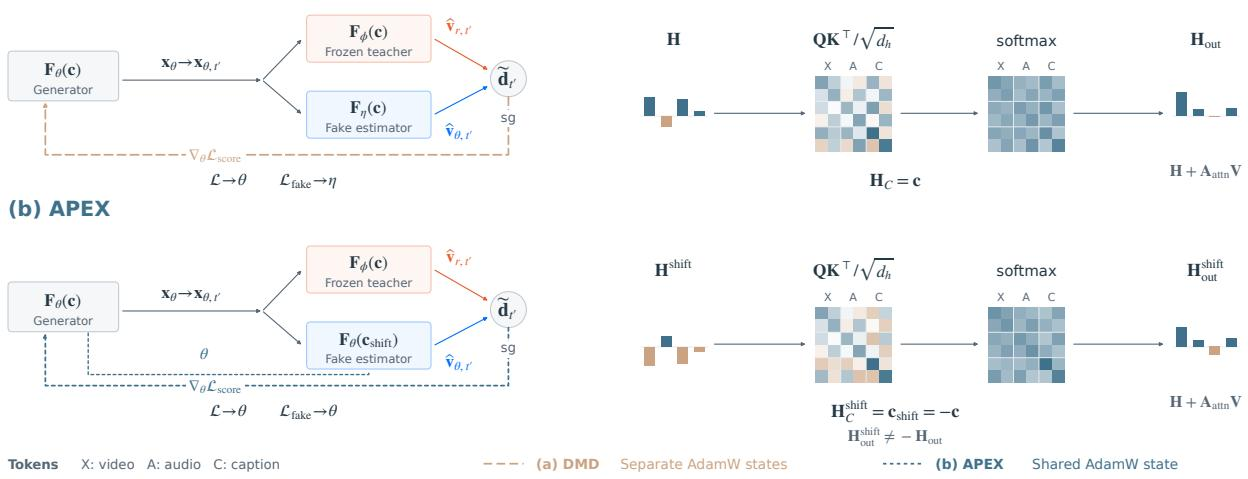
如下图所示,训练过程包括在特定条件 ci 下生成视频序列,随后使用偏移条件 cshifti=−ci 从这些输出中估计伪速度。投影文本在 transformer 块之前被取反,同时在两个前向传播中保持正的扩散时间。被评估的块包括重放输出和任何已分离的前缀。这些块被分离,并在评分时间 t′∈(0,1) 使用新的高斯噪声 ϵ′∼pz 重新加噪:
xθ1:N,sg:=sg(xθ1:N),xθ,t′1:N,sg:=(1−t′)xθ1:N,sg+t′ϵ′.为序列中的所有已生成块抽取一个单一的评分时间 t′,它不同于用于干净预测的重放时间。随后,偏移条件网络从重新加噪的视频潜变量中预测伪速度:
vθ,t′1:N:=Fθ(xθ,t′1:N,sg,t′,cshift1:N).为了学习生成样本的速度场,作者采用流匹配损失,并在当前和前面的含噪块上使用因果注意力:
Lfake(θ)=E[MSE(vθ,t′1:N,ϵ′−xθ1:N,sg)].将生成序列和回归目标分离,确保该更新仅精修偏移条件预测。
为了形成生成器校正,框架计算冻结教师的干净潜变量预测 x0,r1:N 与在相同含噪视频和评分时间下的伪干净潜变量预测之间的差值。干净潜变量差值与速度差值成比例:
x0,ri−x0,θi=t′dt′i,dt′i:=vθ,t′i−vr,t′i.该差值被归一化以获得 dt′1:N,并被加到当前输出上,为重放预测提供分离的回归目标:
Lscore(θ)=E[MSE(xθ1:N,sg(xθ1:N+dt′1:N))].在此步骤中目标保持固定,这意味着梯度只通过重放输出及其在活动片段内的相连因果表示传播。
最后,生成器目标将该分布匹配损失与感知正则化结合在一起:
L(θ)=Lscore(θ)+Lperc(θ).生成器更新与共享参数 θ 上的伪估计损失交替进行。默认情况下,这些更新共享 AdamW 状态,从而保证高效优化,同时保留感知正则化并保持教师参数 ϕ 冻结。在推理时,原始投影文本使用选定的少步调度选择生成结果,随后经过标准的一步空间 Refiner。
实验
评估在 StreamAV-Bench 上考察 180 秒流式生成,涵盖十项指标和五个人类偏好维度,并与 S2-Avatar 进行额外的训练成本和采样对比。APEX 在指令遵循和美学质量上显示出明显提升,在十二个模型中排名靠前,而视觉质量、音视频对齐和运动质量则存在权衡或更有利于基线。人类评估者在指令遵循上强烈偏好 APEX,认为同步性和可用性大体相当,并观察到运动质量较弱。训练在内存和迭代时间上更高效,并且默认重放时间采样与共享优化器状态有助于在降低采样预算时保持较强的指令偏好。
在已报告的 StreamAV-Bench 指标中,APEX 在 VA、VIF 和 AIF 上排名第一,在 VQ 上排名第二(在具有可用结果的模型中)。在其他列出的基线中,IAMFlow 和 Self-Forcing 在 VIF、AIF 和 AVAlign 上具有竞争力,而 AvatarForcing 和 Hallo-Live 在 BC 和 SC 上领先或接近前列。所引用的比较还表明,指令遵循和美学提升伴随着 AQ、AVAlign 和 SC 的降低,以及 AVSync 误差略有上升。APEX 在 VA、VIF 和 AIF 上排名第一,在 VQ 上排名第二(在具有可用结果的模型中)。指令遵循和美学改善伴随着 AQ、AVAlign 和 SC 的下降,以及 AVSync 误差小幅上升。
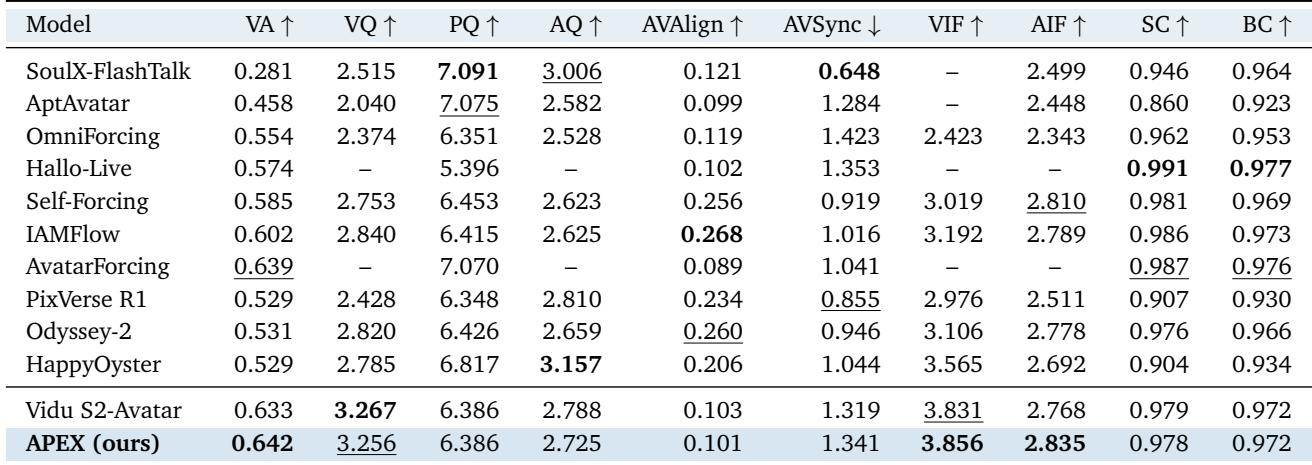
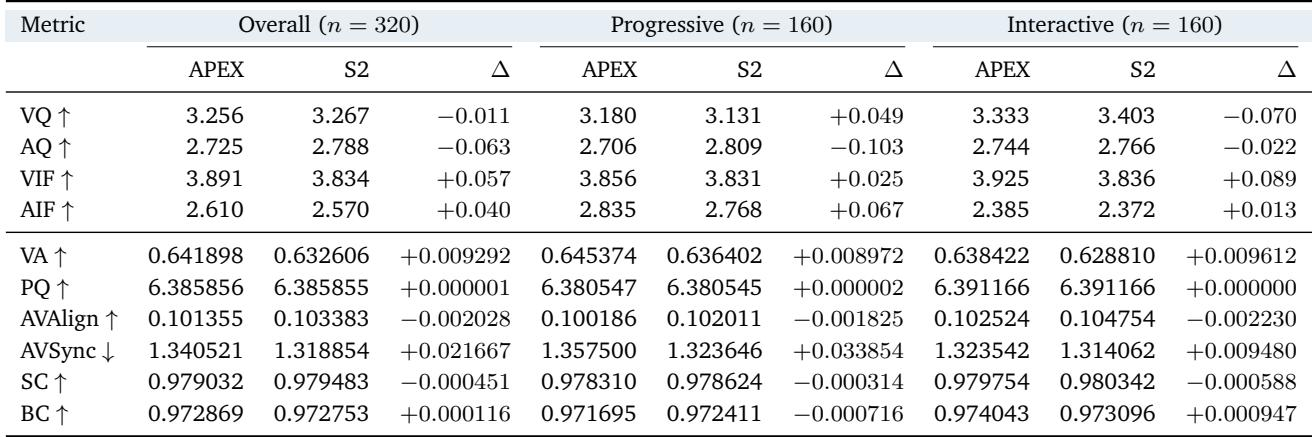
APEX 在 Progressive 和 Interactive 两条轨道上都改善了指令遵循和美学对齐,VIF、AIF 和 VA 出现正增量。视觉质量仅在 Progressive 上改善,而音视频对齐和同步出现小幅权衡,包括合并 AVSync 误差略有上升,PQ 基本不变。APEX 在两条轨道上的 VIF、AIF 和 VA 均改善,合并 VIF 上升 0.057,合并 AIF 上升 0.040。视觉质量在 Progressive 上上升(+0.049),但在 Interactive 上下降(-0.070),使合并 VQ 略低(-0.011)。美学质量和音视频对齐在两条轨道上均下降,合并 AVSync 误差从 1.319 秒增加到 1.341 秒。合并 PQ 基本不变,表明该模型的指令和美学提升伴随着视觉和音视频权衡。
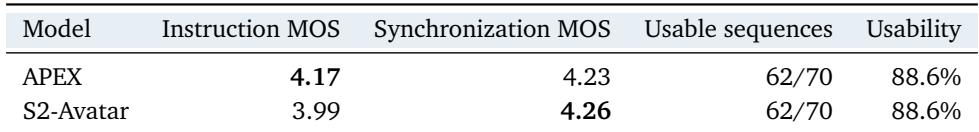
APEX 在指令遵循方面相比 S2-Avatar 表现出明显优势,指令 MOS 更高,并且配对偏好差距显著。音视频同步在两个模型之间几乎无法区分,而运动质量更有利于 S2-Avatar。两个模型在大多数被评估序列中达到相同的可用性标准。指令遵循是 APEX 最明显的优势:其 MOS 更高,配对偏好显示大幅净胜。同步评分几乎持平,除一个配对外,所有配对同步判断均为平局。两个模型在 70 个序列中的 62 个达到可用性阈值,可用率同为 88.6%。
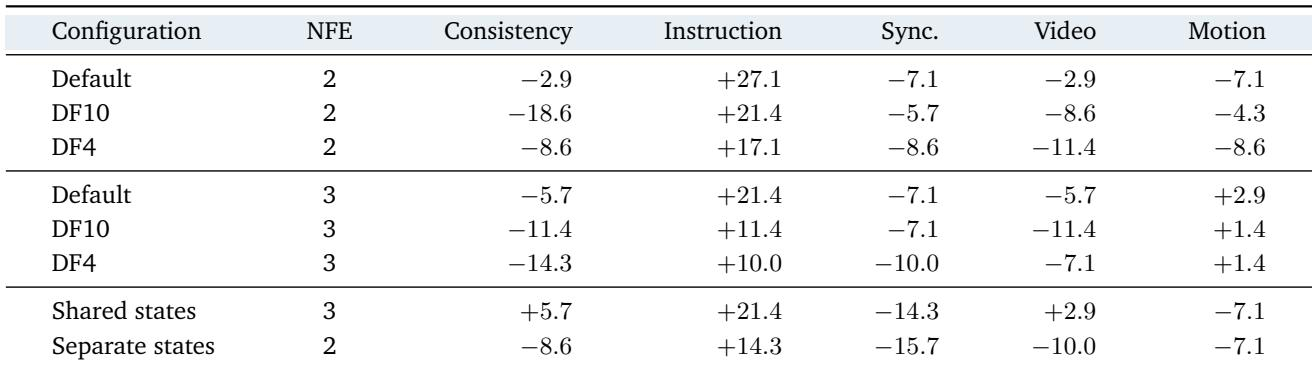
在评估的采样和优化器设置中,指令遵循是相对 S2-Avatar 最强的正向偏好,而一致性、同步、视频质量和运动质量大多为中性或负向。默认等权时间步采样在 2 NFE 和 3 NFE 下均给出最佳的指令偏好,3 NFE 下的共享优化器状态是唯一也改善一致性和视频质量的列出配置。将重放采样偏向更低噪声并未带来一致优势。默认采样在两个推理预算下均取得最高的指令偏好,且在 2 NFE 下的优势大于 3 NFE。3 NFE 下的共享优化器状态是唯一具有正一致性和视频质量的列出设置,尽管同步和运动质量仍为负。DF4 和 DF10 时间步变体相对默认采样降低了指令偏好,并且未一致改善其他质量维度。
实验在 StreamAV-Bench 上评估 APEX,并通过与 S2-Avatar 的对比考察指令遵循、视觉和音视频质量、同步性和可用性,以及对推理采样和优化器设置的消融。APEX 持续改善指令遵循和视觉美学对齐,在 VIF、AIF 和视觉美学上排名靠前,但这些提升伴随着 Interactive 轨道上的视觉质量、美学质量、音视频对齐、同步和运动质量的适度权衡。相对 S2-Avatar,APEX 最明显的优势是指令遵循,而同步几乎持平,运动质量更有利于基线,但两个模型同样满足可用性;消融进一步显示,默认等权时间步采样对指令偏好最佳,3 NFE 下的共享优化器状态是唯一也改善一致性和视频质量的列出变体。