Command Palette
Search for a command to run...
SteerDistill:通过闭环教师引导实现 LLM 智能体的量化
SteerDistill:通过闭环教师引导实现 LLM 智能体的量化
Genming Cui Xiangyu Li Zixu Hao Xin Ding Yunxin Liu Ting Cao
摘要
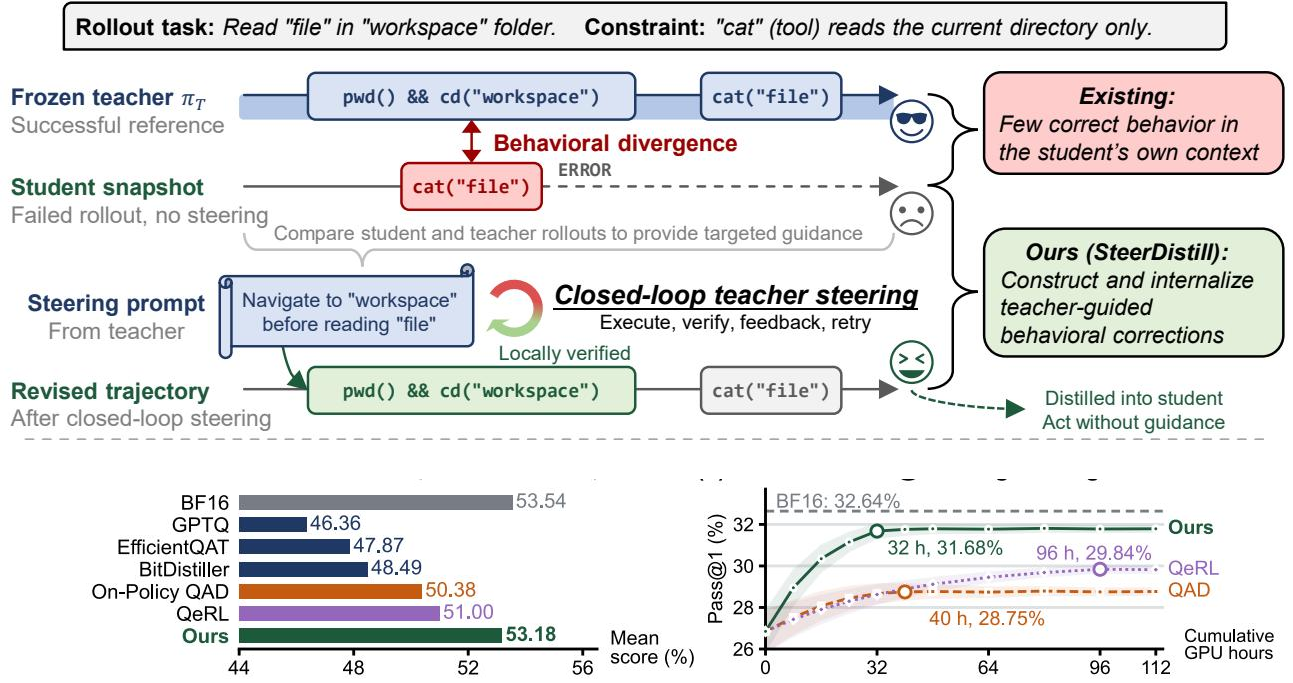
低位量化可降低 LLM 智能体的推理成本,但可能损害任务成功率。通过分析失败的执行轨迹,我们发现量化后的智能体会忽略任务要求或环境条件,从而产生偏离成功全精度参考轨迹的环境转移。纠正这些行为偏差仍然困难:离线数据可能无法覆盖学生的失败情境,而学生自身的执行轨迹在这些情境中又很少提供正确响应。我们提出 SteerDistill,一种量化感知的蒸馏方法,由全精度教师引导学生修正失败响应,并利用学生执行反馈迭代优化其引导。这种闭环教师引导能够产生经过局部验证的行为修正。我们通过训练学生在无引导条件下,在修正轮次匹配受引导学生的预测、在其他轮次匹配全精度教师的预测,从而将这些修正内化,实现无辅助推理。在五个智能体基准和三个模型上,SteerDistill 在 W4A16 下的平均得分比最强量化基线高出 1.67–2.18 分,并且与 BF16 的差距保持在一分以内。在 ??2-Bench 上,其成功率比 QeRL 高出 1.84 个百分点,同时训练 GPU 小时数减少 67%,并产生比量化基线更短的成功轨迹。
一句话总结
清华大学智能产业研究院(AIR)和中国科学技术大学的研究人员提出 SteerDistill,一种量化感知蒸馏方法,其中全精度教师通过闭环反馈引导量化 LLM agent 修改失败响应,生成经局部验证的修正,用于无需辅助的推理,在 W4A16 下平均得分提升 1.67–2.18 分,同时与 BF16 的差距保持在一分以内。
核心贡献
- SteerDistill 是一种量化感知蒸馏方法,其中全精度教师利用闭环执行反馈引导量化学生修改失败响应,产生经局部验证的行为修正。
- 这些修正在训练学生时被内化:在不向学生提供引导的情况下进行训练,使其在修正轮次匹配受引导学生的预测,并在其他轮次匹配全精度教师的预测,从而实现无需辅助的推理。
- 在五个 agentic 基准和三个模型上,在 W4A16 下,SteerDistill 比最强量化基线平均得分高 1.67 到 2.18 分,与 BF16 差距在一分以内;在 τ²-Bench 上成功率比 QeRL 高 1.84 个百分点,同时训练 GPU 小时减少 67%,并且产生的成功轨迹短于量化基线。
引言
大型语言模型(LLM)agent 在多轮中调用工具,使得推理成本成为部署中的核心问题,而低位量化是一种实用的缓解手段。然而,量化 agent 通常表现不如全精度对照,原因在于其忽略任务要求或环境条件,导致行为偏离成功参考。先前的恢复方法面临覆盖/修正缺口:离线数据和蒸馏可能遗漏学生出现偏离的上下文,而 on-policy rollout 在这些上下文中可能包含过少的正确响应。作者提出 SteerDistill,一种量化感知蒸馏方法,使用全精度教师通过闭环引导生成并细化针对性的行为修正,然后蒸馏局部验证后的修正,使量化学生在推理时无需教师引导即可适当行动。
方法
作者提出 SteerDistill,一个在每个训练周期中构造并内化行为修正的框架。令 πT 表示冻结的全精度教师,πθ≡πQ(θ) 表示可训练的量化学生,其中 θ 代表主权重,Q 是固定的量化算子。在第 k 个周期中,冻结快照 πθk 生成初始 rollout 和引导修正。随后,蒸馏在保留轨迹上更新学习器 πθ,得到下一周期的 θk+1。
如下图所示,训练流程由两个主要模块组成:教师引导的轨迹修正和引导行为的内化。
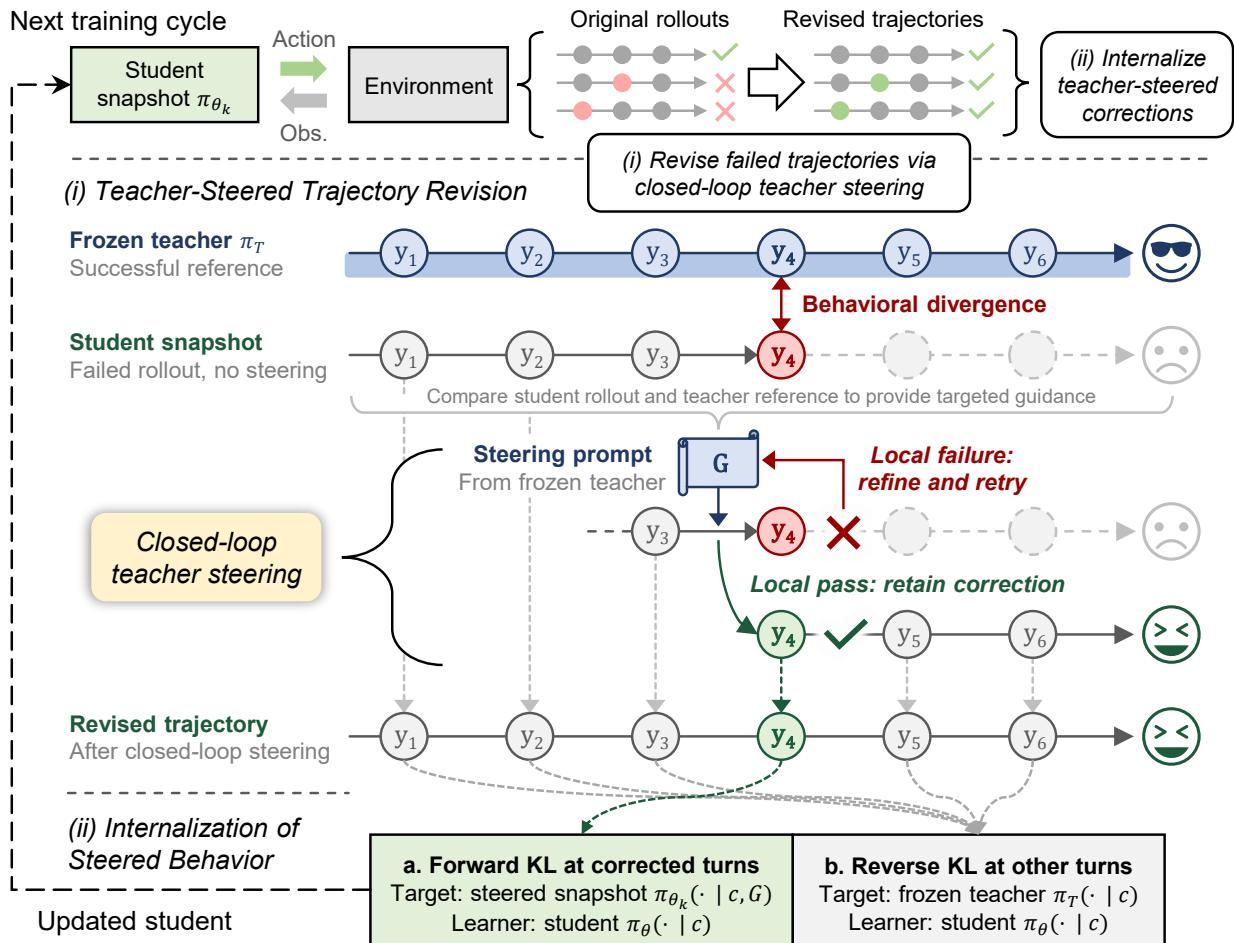
在教师引导的轨迹修正阶段,系统针对失败的学生 rollout,寻找同一任务和初始环境状态下的成功教师参考。作者按环境转移将学生轨迹与参考轨迹对齐,以将第一个行为偏离定位在第 t∗ 轮。为在原始上下文中修正该决策,系统恢复第 t∗ 轮之前的历史和环境状态。随后,教师分析失败响应与成功参考,以识别被忽略的任务要求或环境条件。教师生成引导提示 Gt∗,说明差异、指出适用条件并提供修正规则。以该提示为条件,冻结学生生成修正响应 yt∗∼πθk(⋅∣ht∗,Gt∗) 并执行相应动作。
修正后,系统通过比较产生的环境状态和返回信息与参考来执行局部验证。若验证失败,教师利用此次尝试的反馈细化其引导,学生从相同的出错前历史和环境状态重试。该闭环过程持续到修正被局部验证或单轮尝试预算耗尽。一旦验证通过,修正后的响应替换失败轮次,学生无需引导生成新的后续步骤。若任务仍然失败,修订后的 rollout 会与固定参考重新对齐,以定位下一个行为偏离。无论最终是否成功,该轨迹及其经验证的修正都会被保留用于蒸馏。
在引导行为内化阶段,作者在保留轨迹上使用两种不同的监督来源训练学生,而不向学习器提供任何引导提示。在修正轮次,系统利用受引导的学生快照。令 c 表示去除所有引导提示后的交互历史和响应前缀。冻结学生快照 πθk 从 (c,G) 预测 tokens,而学习器 πθ 仅从 c 预测。作者最小化前向 KL 散度,以匹配受引导学生的预测:
ℓFKL(c,G;θ)=DKL(πθk(⋅∣c,G)∥πθ(⋅∣c))在所有其他轮次,包括未收到进一步修正的后续步骤中,系统对学生生成的响应保留全精度教师监督。教师和学习器都接收相同的上下文 c 且无引导。作者最小化反向 KL 散度:
ℓRKL(c;θ)=DKL(πθ(⋅∣c)∥πT(⋅∣c))整体训练目标按轮次分配损失,并对所有保留的助手响应 tokens 取平均。对于轨迹 i,令 Ii 表示其保留的修正轮次,每个轮次关联一个引导提示 Gi,t。对于轮次 t 和 token j,上下文定义为 ci,t,j=(hi,t,yi,t,<j)。令 Ak 包含第 k 个周期中所有保留的助手 token 位置。最终目标表示为:
L(k)(θ)=∣Ak∣1(i,t,j)∈Ak∑{ℓFKL(ci,t,j,Gi,t;θ),ℓRKL(ci,t,j;θ),t∈Ii,t∈/Ii.实验
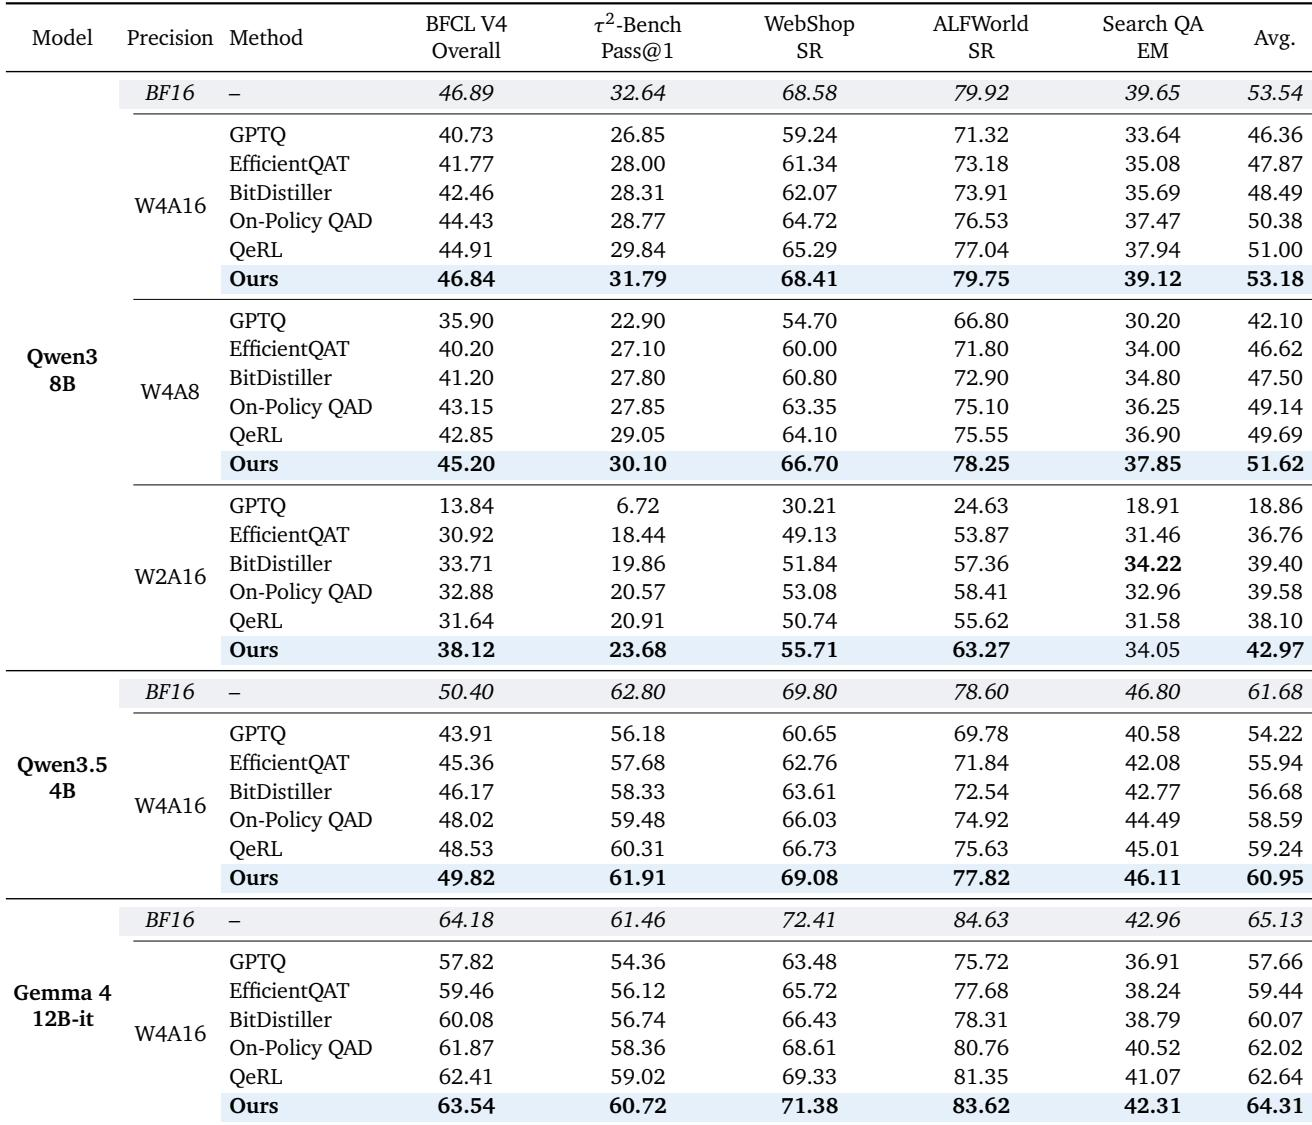
评估覆盖五个 agentic 基准、三个模型和多种低位设置,将 SteerDistill 与训练后量化、量化感知训练、离线和 on-policy 量化感知蒸馏以及强化学习基线进行比较。主要结果表明,SteerDistill 在基准、模型和精度设置上一致优于量化基线,并保持接近全精度参考。效率实验表明,它在更少的 GPU 小时、更少的输出 tokens 和交互步数下达到更高成功率。消融实验确认,在行为偏离处介入、通过结构化教师生成提示进行引导、保留局部验证的修正,以及在修正轮次使用前向 KL、在其他轮次使用反向 KL,都是重要的设计选择。
SteerDistill 在所有评估方法中取得了最强的量化结果,并在 W4A16 下几乎恢复到 Qwen3-8B 的 BF16 参考性能。相对于最佳量化基线的提升在多个基准上出现,并在不同模型和更低精度设置中持续存在。一个例外是 W2A16 下的 Search QA,其中 BitDistiller 得分略高。在 Qwen3-8B 的 W4A16 设置下,SteerDistill 相比最强量化基线 QeRL 平均得分提高 2.18 分,且仅比 BF16 参考低 0.36 分。在 Qwen3-8B W4A16 比较中,SteerDistill 在每个单独基准上都优于所有量化基线。在其他模型和更低精度下,SteerDistill 仍然是平均得分最高的量化方法,仅在 W2A16 的 Search QA 上略低于 BitDistiller。
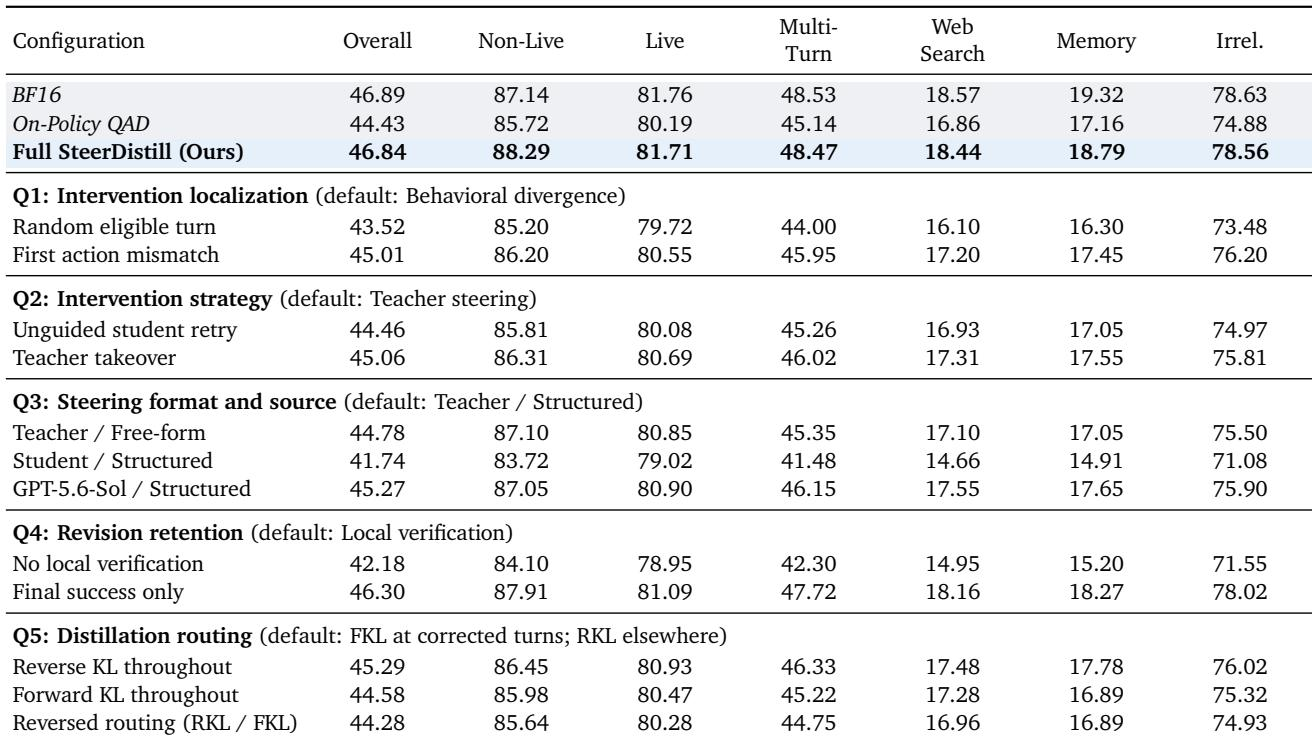
消融实验评估为量化 agent 构造和内化行为修正时的设计选择。在第一个行为偏离处介入、通过教师引导来引导学生,以及使用结构化的教师生成引导提示,均提高了 BFCL V4 的整体得分。蒸馏通过在修正轮次使用前向 KL、在其他轮次使用反向 KL 来内化修正。与在动作不匹配处介入相比,在行为偏离处介入可提高整体性能,而随机介入低于 on-policy QAD 参考。教师引导的修正过程优于无引导重试和从相同恢复状态直接由教师接管。结构化引导提示优于自由形式提示,使用全精度教师作为引导来源优于学生和外部模型。仅最终成功(success only)变体在局部验证后加入最终成功过滤。
主要评估将 SteerDistill 与量化基线和 BF16 参考进行比较,表明 SteerDistill 几乎恢复参考性能,并在各基准、模型和精度设置下取得最高平均得分,仅在 W2A16 下 Search QA 上略低于 BitDistiller。消融实验验证了修正流程:在第一个行为偏离处介入、通过教师引导进行修正、使用结构化教师生成提示,以及选择全精度教师作为引导来源,均能提高整体性能。蒸馏通过在修正轮次应用前向 KL、在其他轮次应用反向 KL 来内化这些修正,最终成功过滤进一步改善了最终变体。