Command Palette
Search for a command to run...
GTAGym:用于评估与强化学习的真实 AAA 游戏任务环境
GTAGym:用于评估与强化学习的真实 AAA 游戏任务环境
Jiajun Chen Shicheng Fang Jiahao Lu Yuxin Wang Xipeng Qiu
摘要
AAA 游戏为评估智能体的感知、推理与控制能力提供了丰富的测试平台。然而,评估智能体能否完成 AAA 游戏中的任务具有挑战性,且往往需要人工标注,因为任务结果通常难以自动验证,更不用说将其应用于强化学习(RL)。我们提出了 GTAGym,一个用于在 GTA V 任务上进行评估和强化学习的环境与框架。其评估基准 GTAVBench 源自 GTA V 主线任务,包含跨九个任务族重建的 103 个在线任务,以及 47 个使用 GTA V 图像的基于图像的射击与狙击任务。一个 Web 服务器提供对在线环境和评估接口的访问,通过截图和键盘鼠标操作支持并行测试,并带有自动引擎状态结果检查。我们在 GTAVBench 上以文本任务指令评估了六个前沿大语言模型,并在其 GTAVBench-AGI 分支上进行了评估,在该分支中指令仅出现在第一张截图中,且一个自动化框架会压缩交互历史。最佳配置在 GTAVBench-AGI 上达到了 70.9% 的总体准确率,但空中导航、规避与拦截仍然困难。GTAGym 还提供了一个可扩展的生成器,在固定模板下于用户指定范围和选项集内采样任务参数,批量创建用于强化学习的 3D 和基于图像的射击环境,并带有自动奖励与终止信号。对 Qwen3.8-27B 在生成的步行导航任务上进行 LoRA 强化学习,提升了域内性能,并迁移到域外任务类别以及原生 GTA V 任务,成功率从 15% 提升至 23%。
一句话总结
上海创新研究院和复旦大学的研究人员提出了 GTAGym,一个 GTA V 评估与强化学习环境;其 GTAVBench 包含跨九个类别的 103 个在线主线任务,以及 47 个基于图像的射击任务,并具有自动引擎状态结果检查和并行测试。对 Qwen3.8-27B 在生成导航任务上进行 LoRA 强化学习,可提升域内表现、迁移到域外类别,并将原生 GTA V 任务成功率从 15% 提高到 23%。
核心贡献
- 论文提出了 GTAGym,一个 GTA V 环境与评估框架,包含 GTAVBench:跨九个类别的 103 个在线主线任务,以及 47 个基于图像的射击和狙击任务,并通过 Web 界面提供并行截图、键鼠控制和自动引擎状态结果检查。
- 论文贡献了一个可扩展的基于模板的生成器,可在用户指定范围内采样移动模式、路线长度、转弯次数和角色速度等参数,批量创建用于强化学习的 3D 和基于图像射击环境,并提供自动奖励和终止信号。
- 对六种前沿 LLM 在 GTAVBench 以及 GTAVBench-AGI 上进行评估,后者仅在第一个截图中显示指令并自动压缩历史,最佳总体准确率为 70.9%;在生成的步行导航任务上对 Qwen3.8-27B 进行 LoRA RL,可提升域内完成率并迁移到域外类别,原生 GTA V 任务表现从 15% 提高到 23%。
引言
构建能够在真实环境中像人类一样灵活感知、推理和行动的 agents 是 AGI 的核心目标,而 sim-to-real 迁移是实现该目标的常见路径。AAA 开放世界游戏提供了高要求的测试平台,因为导航、车辆控制和动态交互需要空间理解、时间推理和长时间动作执行。此前工作沿不同方向推进:沙盒或专用游戏中的可验证任务、商业 3D 世界中的 agents,以及基于视觉轨迹或离线问题的基准。然而,这些方法尚未完全结合真实 AAA 任务目标、自动结果验证和新可执行训练任务的生成。作者提出 GTAGym,一个环境和框架,将 GTA V 主线任务分解为可复用任务,提供 GTAVBench,包括 103 个在线任务,涵盖导航、车辆控制和动态交互,以及 47 个基于图像的射击任务;同时增加 GTAVBench-AGI 分支,仅在第一个截图中呈现目标并自动进行上下文压缩。该框架还提供统一的截图与动作交互接口、引擎状态评估器,以及基于模板的批量 RL 环境生成器,具备自动奖励和终止信号。
数据集
数据集描述:GTAVBench
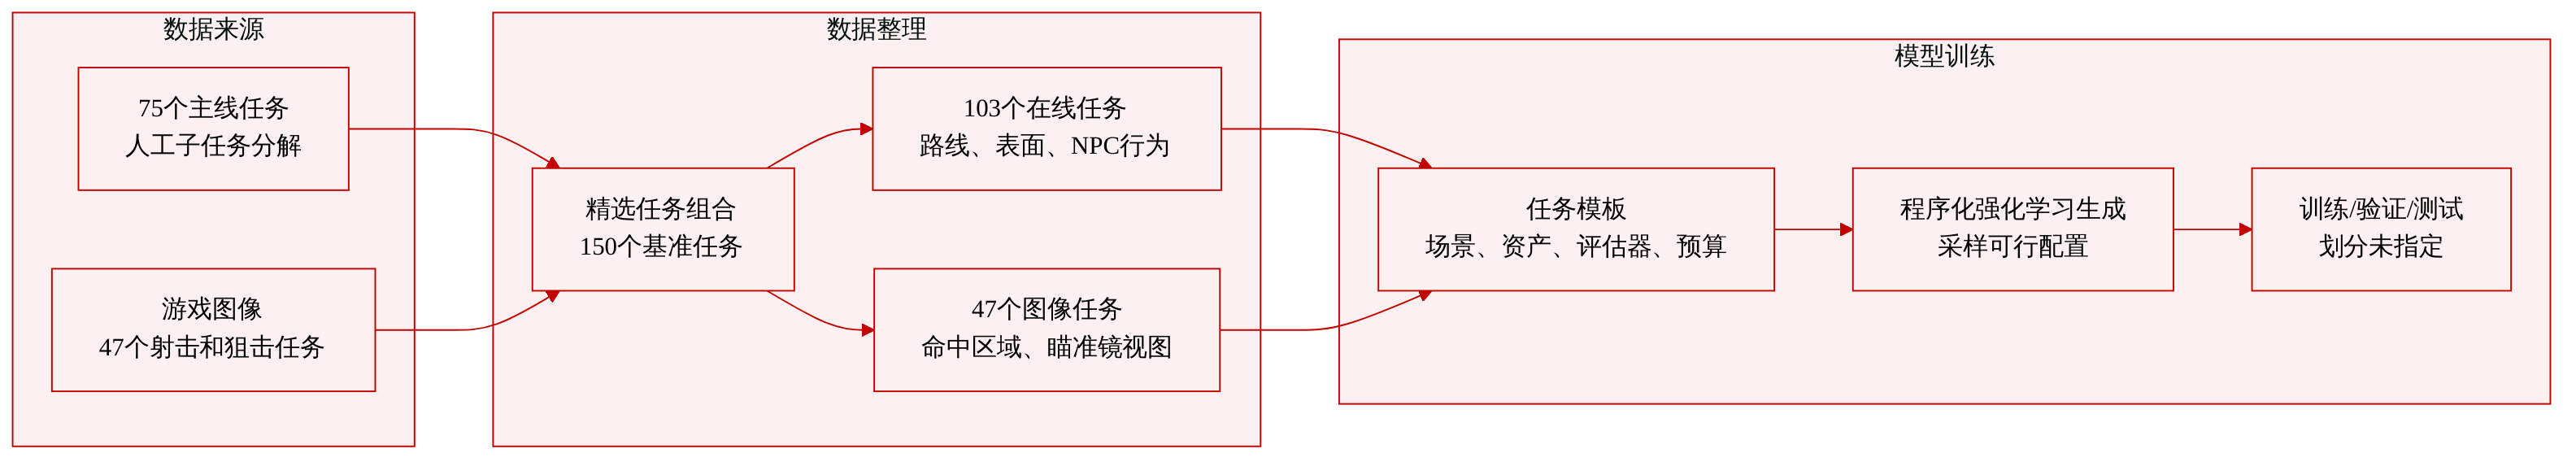
作者将 GTAVBench 构建为一个源自 GTA V 游戏过程的 150 任务基准。它与 GTAVBench-AGI 分支共享任务套件,并通过 GTAGym 进行评估,后者提供用于任务初始化、交互和结果验证的 3D 环境。
-
总体构成与来源
- 75 个 GTA V 主线任务根据收集的通关视频被人工分解为子任务。
- 所得标注和源游戏图像支持跨 11 个类别的 150 个基准任务。
- 11 个类别分为导航、交互和枪械使用。
- 基准包含两个赛道:在线 3D 赛道和基于图像赛道。
-
在线 3D 赛道
- 包含跨九个维度的 103 个任务。
- 在 GTAGym 中使用 Babylon.js 重建。
- 覆盖城市、室内、水域和航空场景。
- 使用原生引擎状态自动验证在线任务结果。
-
基于图像赛道
- 包含 47 个射击和狙击任务。
- 基于源游戏画面构建,用于视觉目标定位和瞄准。
- 射击任务选择游戏帧,并将目标与标注的命中区域关联。
- 狙击任务使用直接在 GTA V 中捕获的图像,创建无瞄准镜和有瞄准镜视图,并具有依赖放大倍率的渲染。
-
任务构建与处理
- 每个子任务指定目标、所需交互顺序、完成约束和实体行为。
- 对于 3D 导航任务,路线在源小地图上人工描绘,并适配到可用城市几何,具有相近的转弯次数。
- 在任务需要的地方添加攀爬表面和降落区域。
- 动态交互任务使用预定义的 NPC 行为和碰撞减速等机制。
- 每个子任务被实例化为场景模板,包含初始状态、指令、任务预算以及可执行的成功与失败谓词。
- 完成谓词检查移动模式、高度或深度、目标距离和交互事件。
- 跟随和追逐任务使用预定义目标路线;逃避任务使用追捕者控制器,更新检测和捕获状态。
- 对于基于图像的任务,所提供的文本未描述除帧选择和目标区域标注之外的单独裁剪专用流程。
-
模型训练与评估中的使用
- 任务模板用于程序化 RL 环境生成。
- 每个模板固定场景、可用资产、交互逻辑、评估器和回合预算。
- 用户通过数值区间或有限候选集控制变化,例如路线长度范围和转弯次数候选。
- 生成器采样可行配置,拒绝不兼容配置,并保存已解析配置和种子以供复用。
- 环境共享截图与动作接口,并使用任务结果作为稀疏奖励。
- 成功和失败会结束回合;预算耗尽记录为截断。
- 评估器对 3D 任务使用引擎状态谓词,对基于图像任务使用目标命中检查。
- 所提供的文本未指定固定的训练、验证或测试划分比例或混合比例。
方法
作者提出 GTAGym,一个综合评估与训练环境,旨在评估 agents 在 GTA 风格游戏中的 11 个维度,包括导航、车辆控制、动态交互和视觉瞄准。该框架分为两个主要赛道:在线 3D 赛道和基于图像赛道,共包含 150 个任务。
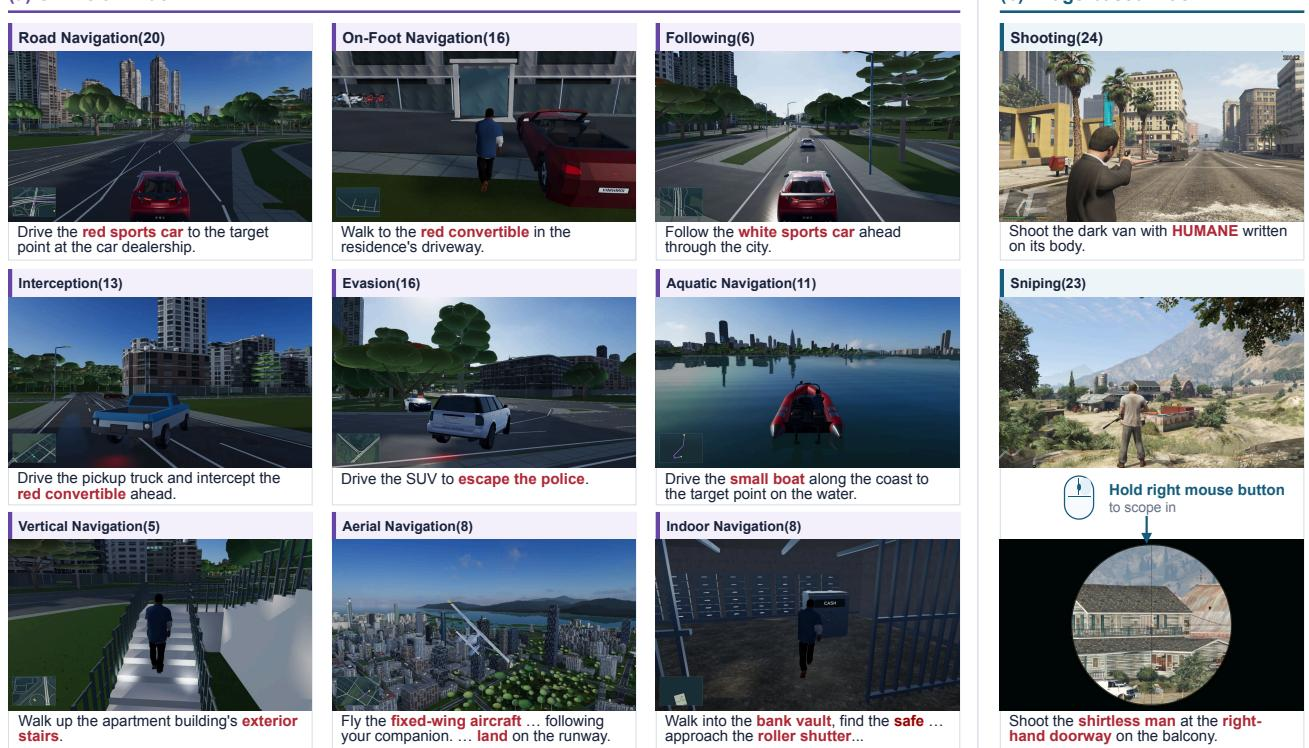
在线 3D 赛道包含跨九个类别的 103 个任务,评估城市、室内、水域和航空场景中的导航、车辆控制和动态交互。基于图像赛道增加 47 个射击和狙击任务,利用源游戏画面进行视觉目标定位和瞄准。
任务构建首先根据通关视频将主线任务人工分解为不同的子任务。作者为每个子任务指定目标、所需交互顺序、完成约束和实体行为。在线场景重建使用 Babylon.js 实现,其中任务控制器公开任务特定状态。对于导航任务,路径在源小地图上人工描绘,以在可用城市几何中找到具有相近转弯次数的路线。动态交互任务使用预定义的 NPC 行为和机制。基于图像任务通过选择游戏帧并将目标与标注命中区域关联,或通过为狙击捕获不同的无瞄准镜和有瞄准镜视图来构建。
每个子任务描述被实例化为场景模板,包含初始状态、指令、任务预算以及可执行的成功与失败谓词。评估框架为两个基准分支采用共享交互接口,遵循带键鼠控制的闭环截图-动作协议。agent 为每个按键指定持续按住时间 d∈(0,dmax],其中 dmax=1 秒。按键并发执行,回合时长由计划的按住时间最长者决定。
为了支持强化学习,作者实现了程序化环境生成。系统围绕任务模板组织环境生成,用户通过数值区间或有限候选集控制变化:
θ∼PT(⋅∣C),E=G(T,θ;ξ),其中 θ 包含采样得到的参数值,ξ 是生成种子。基于规则的生成器在用户定义边界和模板可行性约束下采样配置,并拒绝不兼容配置。该过程批量生成 RL 环境,实例共享截图与动作接口,并使用任务结果作为稀疏奖励;成功和失败会结束回合,预算耗尽记录为截断。
实验
实验在 GTAVBench 和 GTAVBench-AGI 上评估六种模型,这是闭环截图-动作基准,通过键鼠控制导航、交互和枪械使用任务;其中 AGI 分支仅在第一个截图中呈现目标并压缩上下文。GPT 类模型总体领先,但仍低于人类表现,主要瓶颈是动态控制、校准和调节,GPT 类模型具有更好的错误恢复能力;在生成的步行路线上使用 LoRA 进行强化学习可改善留出步行任务和部分分布外导航,但对道路驾驶、航空导航或拦截没有改善。Harness 上下文有助于记忆,但也可能导致目标漂移;评估设置很重要,因为较短动作时长通过更频繁的反馈提高表现,而取消推理时暂停会严重降低动态任务表现。
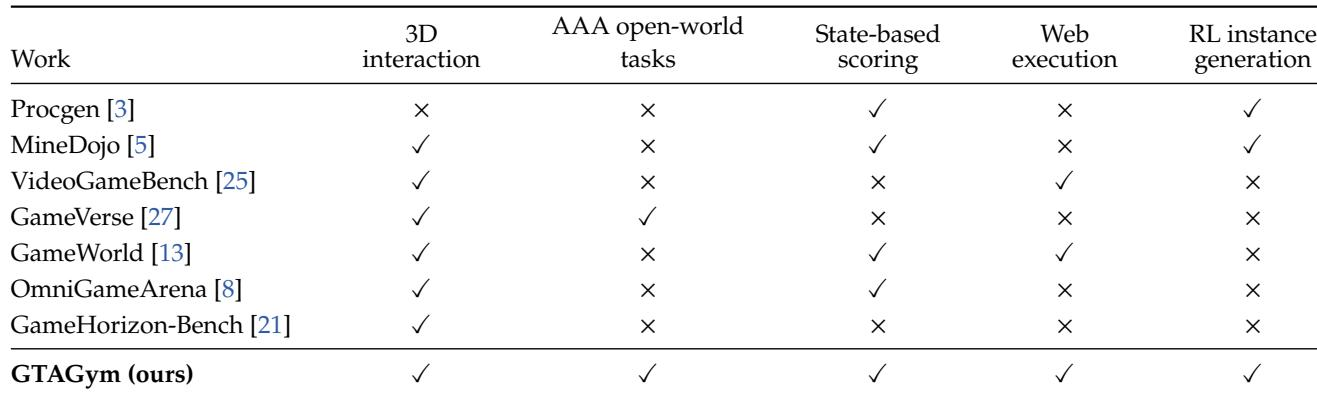
比较显示,先前游戏基准专注于评估能力的子集:许多支持 3D 交互和基于状态的评分,但只有 GameVerse 面向 AAA 开放世界任务,且缺少基于状态的评分、Web 执行和 RL 实例生成。GTAGym 被提出为结合全部五个列出特征的环境,覆盖 AAA 开放世界任务、基于状态的评分、Web 执行和 RL 实例生成。GameVerse 是先前唯一支持 AAA 开放世界任务的基准,但未报告基于状态的评分、Web 执行或 RL 实例生成。基于状态的评分和 RL 生成在 Procgen 和 MineDojo 中同时出现,而基于状态的评分和 Web 执行在 GameWorld 中同时出现;没有先前基准同时结合全部五个特征。
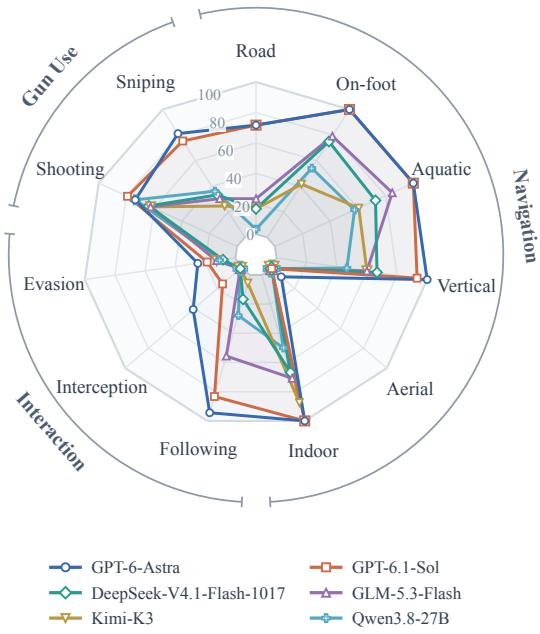
GPT 类模型相比其他评估模型表现出显著的准确率优势,但最佳配置仍远低于人类表现。导航任务,尤其是步行、室内和垂直导航,是这些模型的强项,而航空导航、逃避和动态控制仍然困难。AGI 协议提高了全部六个模型的总体准确率,其中导航提升最为一致,枪械使用任务变化不一。在两种协议下,GPT 模型均大幅优于 DeepSeek 和 GLM。最佳设置在总体准确率上达到 70.9%,比人类平均准确率低 18.9 个百分点。GTAVBench-AGI 将全部六个模型的总体准确率提高 0.9 到 10.0 个百分点,其中导航提升最为一致。GPT 模型能够可靠处理步行、室内和垂直导航,但在航空导航和逃避方面表现挣扎。动态控制仍是瓶颈,拦截表现将 Astra 与其他模型区分开。
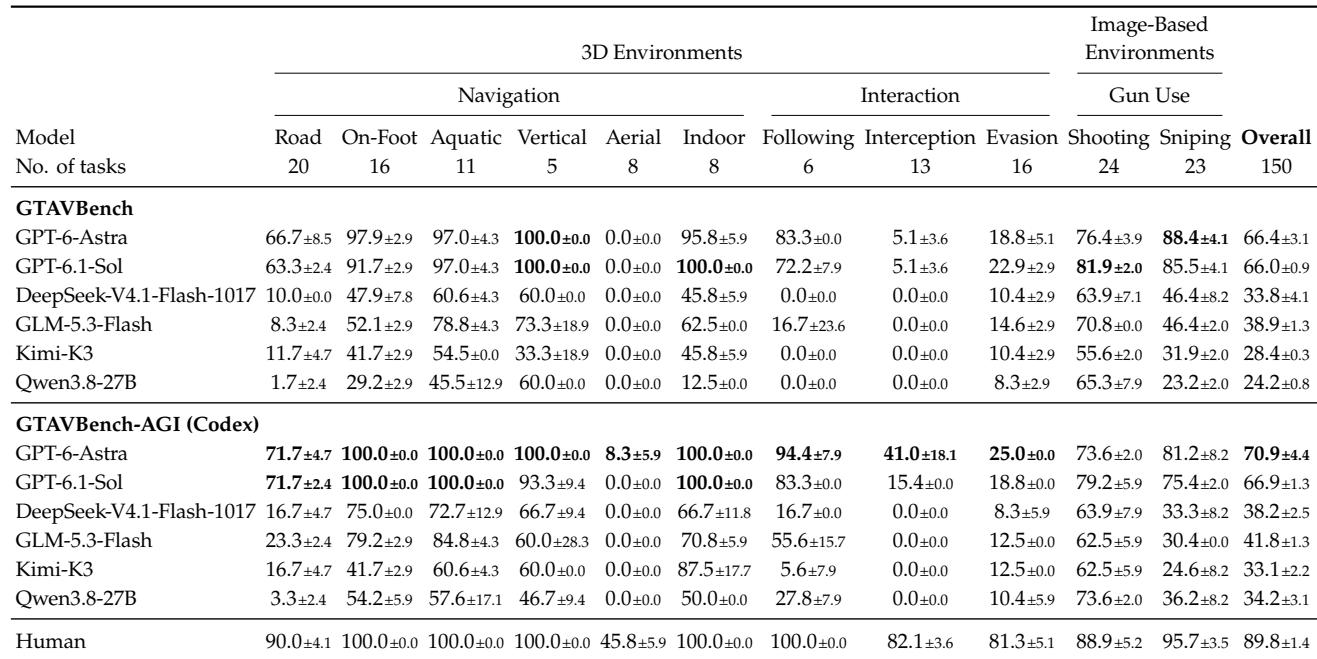
第一个实验将 GTAGym 与先前游戏基准比较,表明 GTAGym 是唯一结合 AAA 开放世界任务、基于状态的评分、Web 执行和 RL 实例生成的环境,而 GameVerse 等替代方案只覆盖其中部分能力。第二个实验在标准和 AGI 协议下评估 GTAVBench 上的六个模型,发现 GPT 类模型领先,但仍低于人类表现,其优势在步行、室内和垂直导航,持续弱项在航空导航、逃避和动态控制。AGI 协议提高所有模型的总体准确率,主要是在导航方面,而拦截仍然是具有挑战性的任务。