Command Palette
Search for a command to run...
G-STAR:面向深度压缩自回归生成的分组缩放令牌容量
G-STAR:面向深度压缩自回归生成的分组缩放令牌容量
摘要
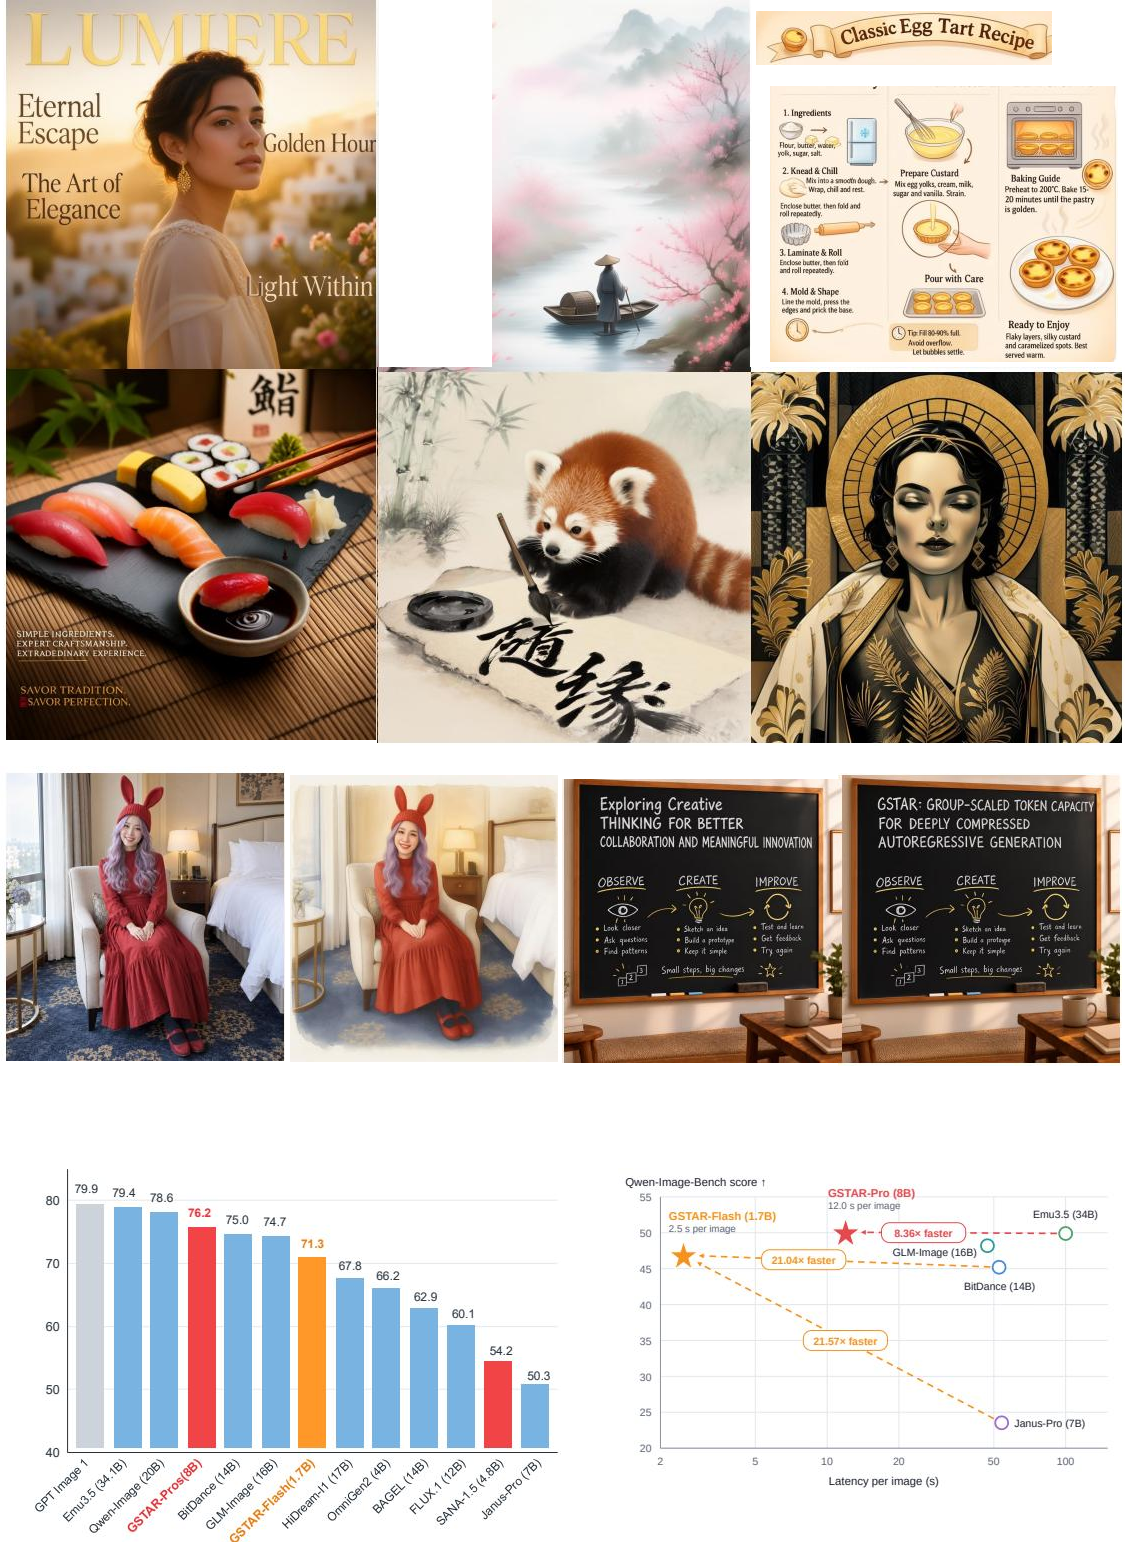
离散自回归模型为图像生成提供了可扩展的框架,但它们面临一个根本性权衡:长令牌序列能保持表示质量但会减慢生成速度,而激进的空间压缩则会降低表示容量。基于乘积量化,我们证明在固定标称信息预算下,分组大小应与每轴空间压缩因子的平方成正比。基于这一原理,我们提出 G-STAR,一种空间—分组协同缩放框架,在保持较强重建、理解和生成性能的同时,实现 32 倍乃至有效的 64 倍压缩。由于更大的分组会引入必须被高效建模的组内依赖,我们分析了它们对推理延迟和生成质量的影响,并提出一种半自回归解码器,将并行特征计算与轻量级因果建模相结合。凭借这些设计,我们的高压缩模型在五个代表性文生图基准(GenEval、DPG-Bench、PRISM、LongText-Bench 和 Qwen-Image-Bench)上取得了与领先模型相当的性能。在 1024 × 1024 分辨率下,我们的模型相比此前的离散自回归模型实现了 20 倍加速,在单个 NVIDIA H200 上每张图像生成仅需 2.5 秒。这些结果共同表明,高压缩离散表示能够在低延迟下实现高质量的自回归生成。
一句话总结
北京大学、美团龙猫、上海交通大学等机构的研究人员提出 G-STAR,一种空间分组协同缩放框架,使组大小随每轴空间压缩呈二次方增长,并使用半自回归解码器在 32× 和等效 64× 压缩下保持生成质量,在文本到图像基准上取得有竞争力的性能,并通过在单块 NVIDIA H200 上以 2.5 秒生成 1024×1024 图像实现 20× 加速。
核心贡献
- 本文提出 GSTAR,一种基于乘积量化的空间分组协同缩放框架,表明在固定名义信息预算下,组大小随每轴空间压缩呈二次方增长;这实现了 32× 和等效 64× 压缩,同时保持较强的重建、理解和生成性能。
- 本文提出一种轻量级半自回归深度解码器,并行计算所有分组槽的表示,并使用单层因果 Transformer 建模组内依赖,同时具有优化后的推理实现;该解码器在单块 NVIDIA H200 上以 2.5 秒生成 1024×1024 图像,并相比先前离散自回归模型实现 20× 加速。
- 本文通过在 32× 和等效 64× 压缩下训练 GSTAR-Pro-8B 和 GSTAR-Flash-1.7B 验证该方法,在 GenEval、DPG-Bench、PRISM、LongText-Bench 和 Qwen-Image-Bench 上取得与领先模型相当的性能。
引言
作者研究了面向自回归图像生成的离散视觉 token 化,将图像表示为离散符号并用 next-token 预测建模,为统一视觉生成和多模态理解提供可扩展路径。先前离散自回归模型面临有限码本带来的量化误差和高分辨率下的缓慢顺序推理;增加空间压缩虽然减少全局步数,但会加剧信息损失,而现有多码解码器要么增加串行延迟,要么存在多模态冲突风险。作者提出将多码本量化与轻量级半自回归深度解码器结合,以在 32x 和 64x 空间压缩下保持表示容量。作者提出的 GSTAR-Pro-8B 和 GSTAR-Flash-1.7B 模型实现了有竞争力的大规模文本到图像生成,并相比先前离散自回归模型实现 20 倍推理加速,在单块 NVIDIA H200 上以 2.5 秒生成 1024x1024 图像。
方法
作者提出一个将深度压缩离散 tokenizer 与分层自回归生成器相结合的框架。为了在缩短全局序列的同时增加每个空间 token 的容量并保持名义信息预算,作者提出空间分组协同缩放原则。
首先,作者训练一个离散 tokenizer,将输入图像映射为紧凑的分组码网格并重建图像。如框架图所示,语义编码器由 Qwen-ViT 初始化,以生成空间压缩的潜在网格。随后,分组量化用 G 个离散码表示每个位置。为在量化后保持预训练表示的语义结构,量化特征与对应的 Qwen-ViT 特征对齐。此外,采用 Gram 损失匹配输入与重建之间的二阶特征相关性。整体训练目标表示为:
Ltok=Lrec+λvqLvq+λsemLsem+λgramLgram+λcommitLcommit其中 Lrec 汇总标准像素、感知和对抗重建项,Lvq 是量化目标,Lsem 是语义对齐目标,Lcommit 促使编码器特征保持接近其分配的码本嵌入。
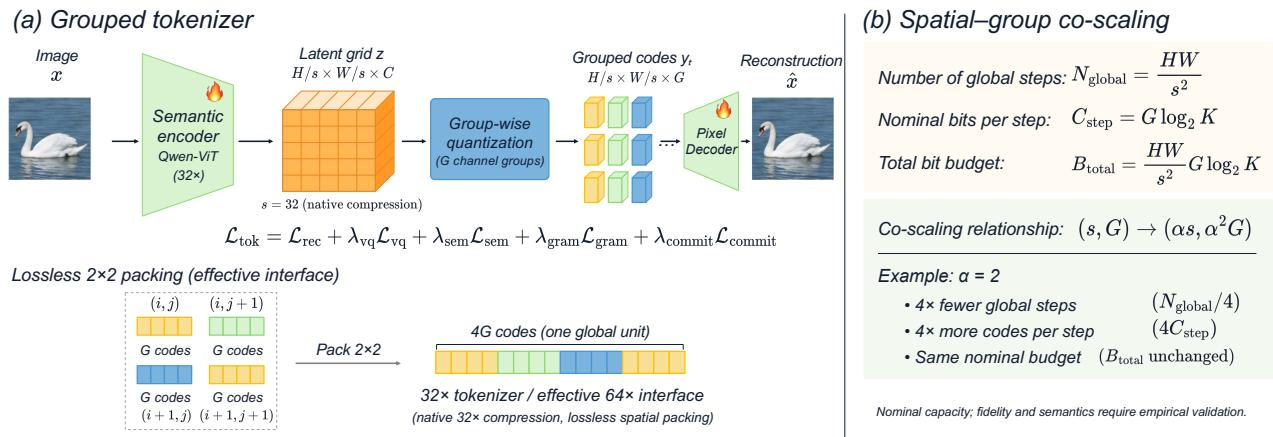
为了在不丢失信息的情况下进一步压缩序列,作者引入空间分组协同缩放原则。分组量化允许增加分配给每个空间 token 的离散容量,而无需延长全局序列。设 s 表示每轴有效空间压缩因子,G 表示每个全局位置生成的码数量。在码本大小 K 固定时,全局步数为 Nglobal(s)=s2HW,每步名义比特数为 Cstep(G,K)=Glog2K,总比特预算为 Btotal(s,G,K)=s2HWGlog2K。通过将 s 乘以 α、将 G 乘以 α2,总比特预算 Btotal 保持不变,同时全局步数减少为原来的 1/α2。根据这一关系,作者通过无损 2×2 空间打包从原生 32× tokenizer 构造等效 64× tokenizer。每四个量化位置的邻域被打包为一个全局单元,使每步码数从 Gq 增加到 4Gq,同时全局序列缩短为原来的四分之一。打包后的码在图像解码前恢复为原生网格。
最后,为高效建模每个全局步骤内相关的码,作者设计了一个半自回归深度解码器。使用完全因果的自回归头在每个步骤生成一组相关离散码会带来较高推理延迟,而完全并行头忽略组内依赖,牺牲生成质量。为协调这两个目标,半自回归头将并行主干与轻量级因果模块相结合。并行主干首先在一次前向中计算所有分组槽的表示:
bt,1:G=Pψ([MASK]1:G;ht)随后,轻量级单层因果 Transformer 基于其并行表示和先前采样的组内码生成每个码:
pSAR(yt∣ht)=g=1∏Gp(yt,g∣ht,bt,g,yt,<g)该设计在每个全局位置只计算一次并行主干,使大部分计算保持并行,同时通过单层、带 KV 缓存的因果 Transformer 保留因果条件建模。
实验
实验在文本到图像生成和图像编辑基准上评估 GSTAR-Pro-8B 和 GSTAR-Flash-1.7B 两个模型,并进一步考察组缩放、组内预测头和推理效率。较大组大小改善重建和语义表示,但会减慢早期收敛;经过充分训练后,较大组可赶上或超过较小组。Semi-AR 预测头显著降低推理延迟,同时保持与因果 AR 头相当的生成质量,并优于并行预测。效率分析表明,结合压缩视觉表示、Semi-AR 头和系统级优化可带来显著的端到端解码加速。
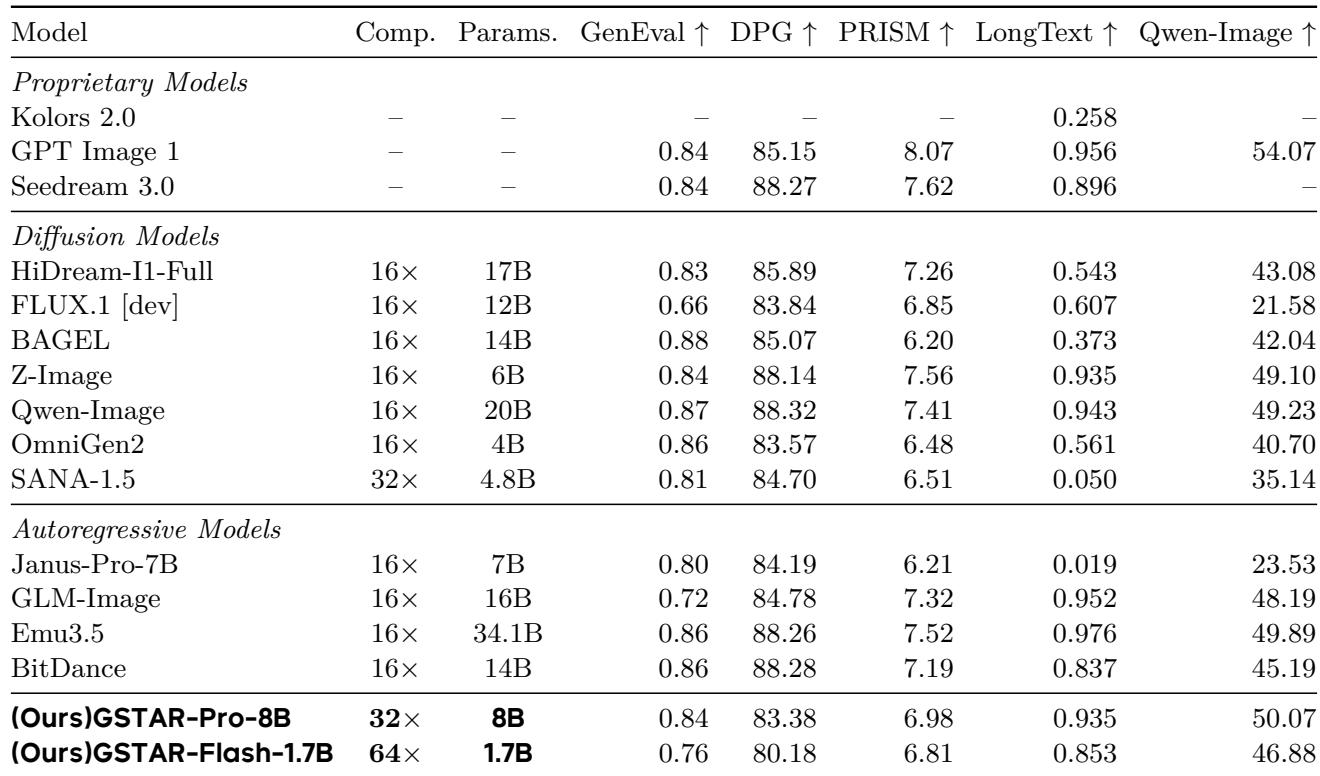
部分闭源模型,尤其是 GPT Image 1 和 Seedream 3.0,在多数文本到图像指标上领先,并在长文本和提示遵循基准上尤为突出。在扩散模型中,HiDream-I1-Full 在 GenEval、DPG-Bench、PRISM 和 Qwen-Image-Bench 上优于 FLUX.1 [dev],而 FLUX.1 [dev] 在 LongText 英文子集上保持优势。Kolors 2.0 仅报告了较低的 LongText 结果,限制了更广泛比较。GPT Image 1 和 Seedream 3.0 整体表现最强,Seedream 在 DPG-Bench 领先,GPT Image 在 PRISM 和 LongText 领先。HiDream-I1-Full 在多数质量和提示遵循指标上超过 FLUX.1 [dev],但 FLUX.1 [dev] 取得更高的 LongText 分数。
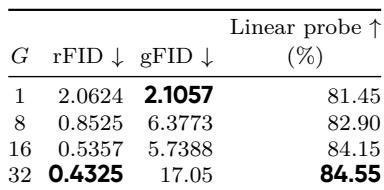
在码本大小固定时,将组大小从 1 增加到 32 持续改善重建和语义表示,表现为重建 FID 降低和线性探针准确率提高。生成建模质量是非单调的:生成 FID 在组大小从 1 到 8 时变差,在组大小 16 时改善,并在组大小 32 时明显下降。因此,较大组似乎提供更丰富的表示容量,但由此形成的空间可能更难建模。较大组大小持续改善重建 FID 和线性探针准确率。生成 FID 不呈单调趋势:组大小 16 优于组大小 8,而组大小 32 明显更差。测试的最大组大小取得最佳重建和语义分数,但生成 FID 最差。
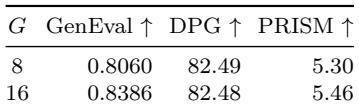
在固定码本和空间压缩下的文本到图像生成中,将组大小从 8 增加到 16 可获得相当或略优的整体质量。较大组改善 GenEval 和 PRISM 分数,而 DPG 几乎不变。这支持以下观点:较大组提供更丰富的表示空间,在训练充分时有利于生成。将组大小从 8 增加到 16 改善 GenEval 和 PRISM,而 DPG 基本持平。较大组设置取得相当或略优的文本到图像性能,与后期生成趋势一致。
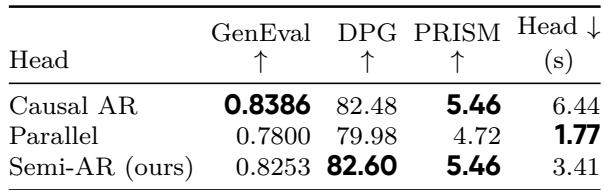
与 Causal AR 头相比,Semi-AR 预测头大幅降低每张图像的延迟,同时保持大致相当的生成质量。它在 PRISM 上持平,在 DPG 上略有改善,相对 Causal AR 仅出现小幅 GenEval 下降。Parallel 预测头更快,但在所有质量指标上持续较低。Semi-AR 头与 Causal AR 的 PRISM 分数持平,并取得略高的 DPG,仅小幅降低 GenEval。Parallel 头最快,但在 GenEval、DPG 和 PRISM 上均落后于其他两个头。
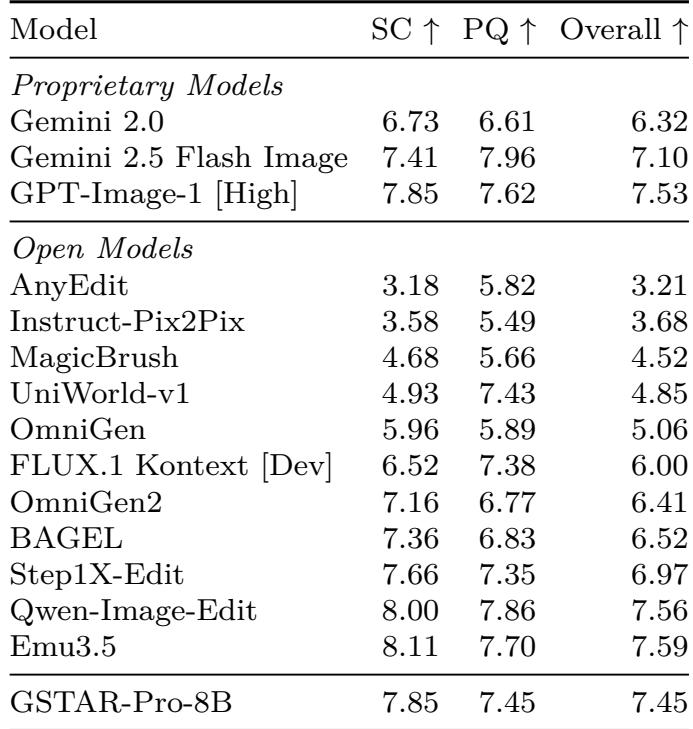
在 GEdit-Bench 英文全集上,闭源图像编辑模型在语义一致性、感知质量和整体分数上均高于所列开放模型。GPT-Image-1 在语义一致性和整体分数上领先,Gemini 2.5 Flash Image 在感知质量上领先。开放模型在所有三项报告指标上均落后。闭源模型在语义一致性、感知质量和整体分数上优于所列开放模型。GPT-Image-1 具有最高的语义一致性和整体分数,Gemini 2.5 Flash Image 具有最高的感知质量。
实验涵盖文本到图像生成、码本设计、预测头和图像编辑。GPT Image 1 和 Seedream 3.0 等闭源模型在多数文本到图像指标上领先,而 HiDream-I1-Full 在多数质量和提示遵循基准上优于 FLUX.1 [dev],FLUX 保持长文本优势;较大的码本组大小持续改善重建和语义分数,但生成质量是非单调的,组大小 16 带来更好的文本到图像结果。Semi-AR 预测头降低延迟同时保持相当质量,闭源编辑模型在语义一致性、感知质量和整体分数上优于开放模型。