Command Palette
Search for a command to run...
在脉冲中反思:利用步长感知解码缓解多模态扩散语言模型中的幻觉
在脉冲中反思:利用步长感知解码缓解多模态扩散语言模型中的幻觉
摘要
多模态扩散语言模型(MDLM)的最新进展通过迭代精炼展现出强大的全局建模能力。我们观察到,在迭代去噪过程中,掩码不确定性整体呈下降趋势,而少数去噪步骤会出现与幻觉密切相关的局部熵脉冲。我们认为,可以通过测量每个去噪步骤相对于其邻近时间窗口的熵偏差来识别异常步骤。我们假设,离散令牌承诺丢弃了掩码位置上的分布信息,限制了熵脉冲期间候选语义与上下文之间的持续交互。基于这一目标,我们提出了 StepRefine,这是一种即插即用的解码策略,利用语义上下文实现可靠的去噪。我们方法的核心在于离散去噪与潜在精炼之间的步长感知切换。该模型在熵脉冲步骤采用概率加权嵌入以保留多样化的推理假设,并进行多轮连续精炼。同时,一个精炼控制器监测分布稳定性,以减少不必要的循环,并将模型切换回标准离散去噪。通过大量实验,StepRefine 在多模态基准上展示了在不同 MDLM 上显著的幻觉缓解效果。
一句话总结
莫纳什大学、康奈尔大学、加州大学圣克鲁兹分校、美国东北大学和明尼苏达大学的研究人员提出了 StepRefine,这是一种即插即用的多模态扩散语言模型解码策略,它在离散去噪和概率加权潜在细化之间进行步骤感知切换,以保留多样的推理假设,同时由细化控制器监测分布稳定性,从而减少不必要的循环,并在多模态基准上缓解幻觉。
核心贡献
- 论文指出,多模态扩散语言模型中的掩码不确定性在去噪过程中通常逐渐下降,但特定步骤上的局部熵尖峰与幻觉 tokens 密切相关。
- StepRefine 作为一种即插即用、无需训练的解码策略被提出;它通过局部趋势偏差检测熵尖峰步骤,切换到基于概率加权嵌入的潜在细化以保留多样的推理假设,并使用细化控制器监测分布稳定性,减少不必要的细化循环。
- 在四个多模态扩散语言模型骨干以及覆盖通用推理、幻觉、数学和科学推理的多个基准上的实验表明,StepRefine 提高了准确率,显著缓解了幻觉,并且可以与现有加速方法结合。
引言
扩散语言模型通过迭代去噪而非从左到右解码生成文本;被称为 MDLM 的多模态变体在视觉和文本输入上使用双向注意力,以支持感知和推理。然而,MDLM 仍会产生幻觉,现有解码策略大多通过缓存重用或调度优化推理效率,而面向质量的方法会调整 token 提交,但在去噪步骤中均匀对待不确定性。作者分析了逐步不确定性动态,发现罕见的熵尖峰步骤(掩码序列熵在这些步骤局部急剧上升)与最终幻觉 tokens 密切相关。他们提出了 StepRefine,这是一种即插即用的解码方法,该方法从局部时间趋势中检测这些熵尖峰,并在离散解码之前切换到潜在概率细化,从而在多个 MDLM 骨干和推理基准上提升可靠性。
方法
作者提出了 StepRefine,这是一种步骤感知解码策略,旨在缓解掩码离散语言模型中的幻觉。该框架通过检测迭代去噪过程中的特定不稳定点,并应用有针对性的细化来稳定 token 提交。
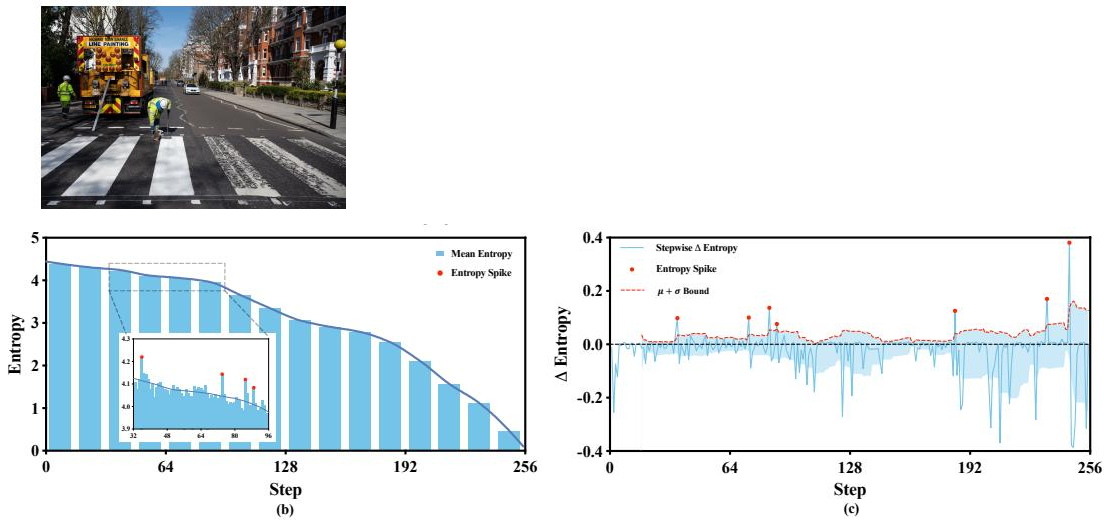
第一个核心模块是熵尖峰检测。在迭代去噪过程中,掩码位置上的平均掩码熵通常随着模型逐步提交 tokens 而下降。但这种下降并非严格单调。少数步骤会出现打破整体趋势的局部急剧上升,作者将其定义为熵尖峰。每个去噪步骤 t 的平均掩码熵定义为掩码位置上预测分布的期望香农熵:
Hˉt=Ei∼U(Mt)[−v∈V∑pti(v)logpti(v)]其中 U(Mt) 表示掩码位置 Mt 上的均匀分布。如果某步骤的熵变化超过局部上界,则将其分类为熵尖峰:
ΔHˉt≜Hˉt−Hˉt+1,Tspike≜{t∣ΔHˉt>μt+σt}其中 μt 和 σt 分别表示沿去噪轨迹的 w 个先前逐步熵变化的均值和标准差。
有关这些熵尖峰在解码步骤中的详细特征,请参见下图。
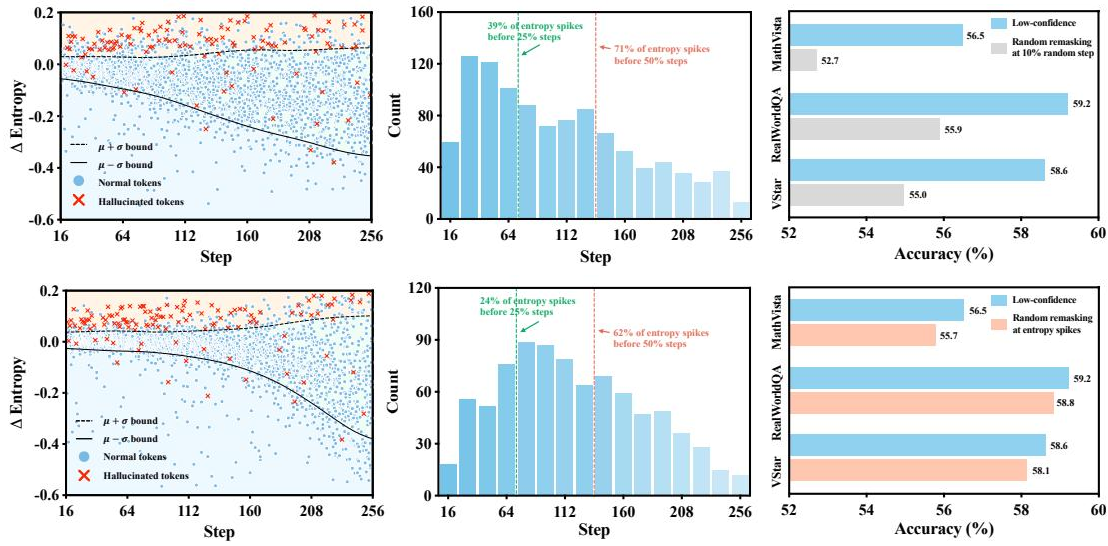
分析表明,尽管熵尖峰步骤相对罕见,但约 80% 的幻觉 tokens 位于这些尖峰区域内。此外,这些尖峰并非均匀分布,主要集中在去噪过程的早中期阶段,此时许多位置仍被掩码且可用上下文不足。在这些特定步骤中,置信度信号变得不那么具有区分性,使得离散提交决策无法可靠地基于当前上下文信息,也使标准的低置信度重新掩码效果较差。
为了解决这一脆弱性,作者引入了一种具有自适应终止的步骤感知模式切换。该策略在标准离散解码和潜在细化之间交替,并由前面定义的尖峰检测准则进行门控。在每个去噪步骤 t,模型首先执行标准前向传播以获得预测分布和相应的尖峰指示符。对于 t∈/Tspike 的普通步骤,过程遵循标准离散解码路径。
相反,在 t∈Tspike 的熵尖峰步骤中,StepRefine 激活潜在细化。这需要在离散解码之前,在同一个去噪步骤内执行迭代前向传播。令 p~t,0i≜pti 表示来自标准前向传播的初始分布。在每个细化迭代 k≥1,框架从前一个分布构造概率加权嵌入,并用它替换掩码嵌入,作为下一次前向传播的输入:
e~t,ki=Ev∼p~t,k−1i[e(v)],i∈Mt,k=1,2,…结合前向传播,该方程形成递归细化循环。它将候选 tokens 的分布信息传递到后续前向传播中,使软嵌入能够在离散解码之前与视觉文本上下文交互。
为了防止不必要的计算开销,细化控制器监测连续预测分布之间的变化。在迭代 k≥1 时,该变化计算为掩码位置上的平均 Kullback-Leibler 散度:
DKL(k)=Ei∼U(Mt)[DKL(p~t,ki∥p~t,k−1i)]一旦 DKL(k)<ϵ,迭代细化终止,其中 ϵ>0 是预定义的稳定性阈值。最终的细化分布随后用于标准离散解码和重新掩码以提交 tokens。为了保持固定的推理预算,细化所需的额外前向传播计入总去噪预算 T。如果在步骤 t 使用了 k 次细化传播,则后续迭代从索引 t−1−k 开始,而不是 t−1,从而确保总前向传播次数保持不变。
实验
作者在四个多模态扩散语言模型上评估 StepRefine,覆盖多种推理、幻觉、数学和科学基准。主要结果表明,熵尖峰感知细化在多个骨干上优于基线和现有无需训练的解码策略,同时保持加速方法带来的速度提升。定性分析和消融实验证实,细化在不稳定步骤上锐化了预测,并且具有自适应调度和终止的适中校准窗口比固定替代方案更有效。该方法在重新掩码策略、生成长度和步骤预算方面也保持稳健。
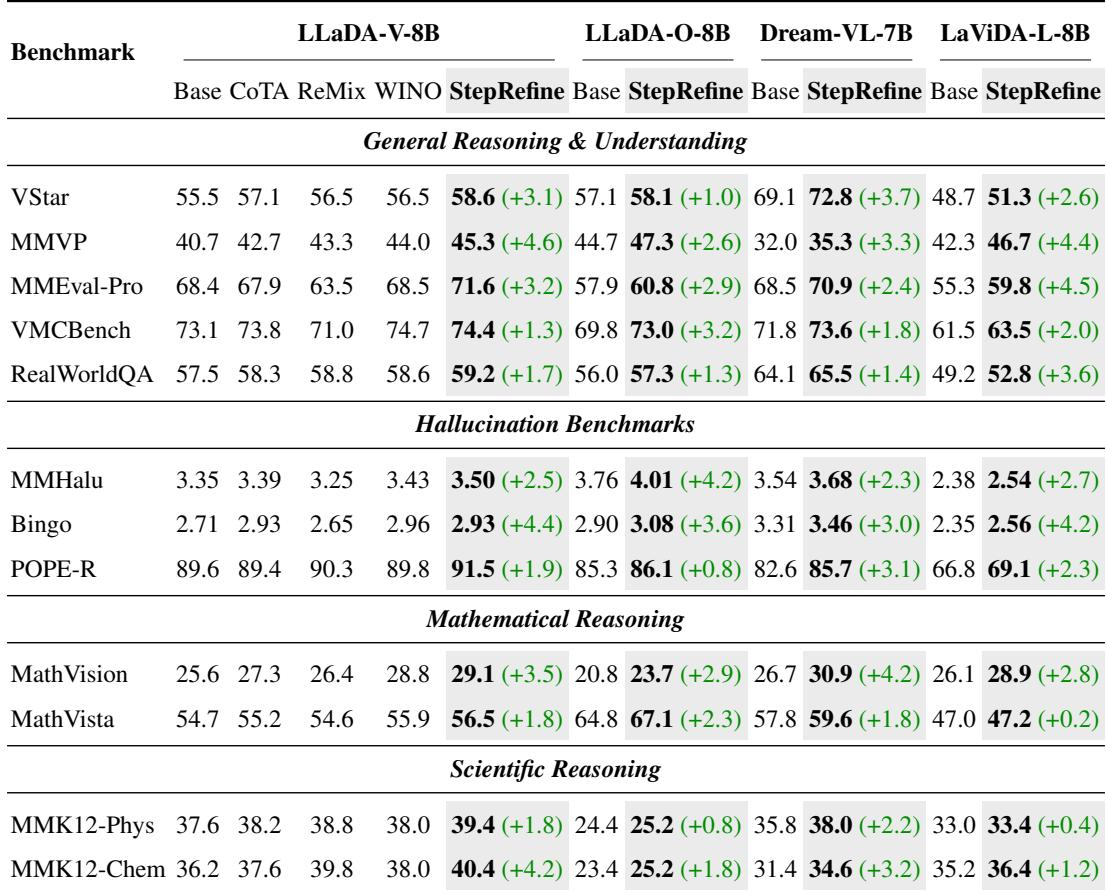
StepRefine 在多个 MDLM 骨干上相比基线和竞争性的无需训练解码策略一致提升了基准性能。它在通用推理基准上与 CoTA、ReMix 和 WINO 持平或更优,并在幻觉基准上也带来正向收益。不同骨干上相似的平均提升表明,熵尖峰感知细化在多个 MDLM 上具有稳健性,并非针对某个单一模型。StepRefine 在通用推理平均准确率上优于基线,并在每个已评估的通用推理基准上与 CoTA、ReMix 和 WINO 持平或更优。幻觉基准同样受益,在 MMHalu 和 Bingo 上有所提升,每个骨干均显示出 2.3 至 2.8 个百分点的正向平均提升。
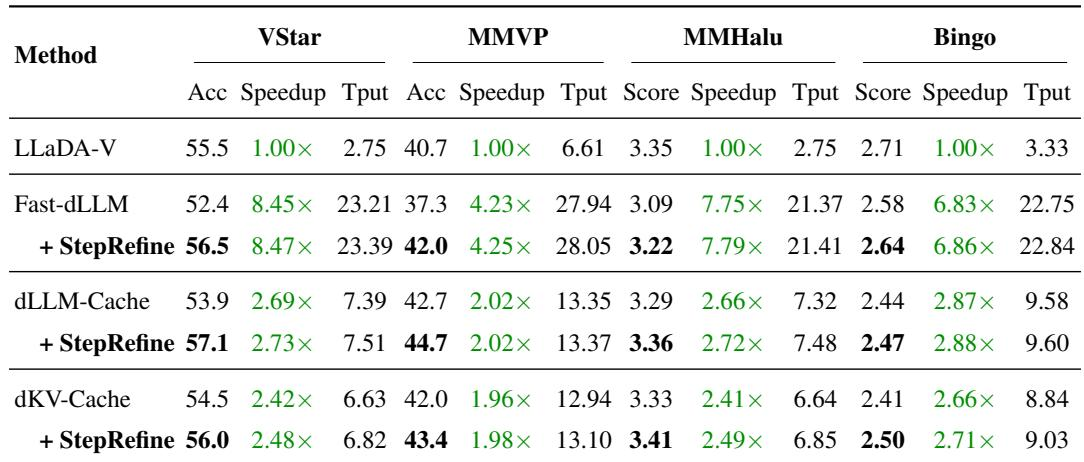
StepRefine 可与现有扩散语言模型加速方法结合,同时保持其速度提升。在所报告的加速器上,添加 StepRefine 提高了基准准确率和幻觉分数,吞吐量保持不变或略高。结果表明,细化与激进式和基于缓存的解码策略广泛兼容。将 StepRefine 添加到 Fast-dLLM 后,VStar 和 MMVP 准确率及幻觉分数得以提高,同时加速比接近其加速基线,吞吐量略高。对于 dLLM-Cache,StepRefine 改善了所有报告的准确率和分数指标,加速比和吞吐量几乎不变。在多种加速方法中,StepRefine 保持或略微提高吞吐量,并在 VStar 和 MMHalu 上取得提升,说明其兼容性且没有隐藏延迟。
在所有三种评估的重新掩码策略下,StepRefine 在 MMHalu 上相比基线持续提升,其中 Low Confidence 设置获得最高的 StepRefine 分数。在两种生成长度和三种步骤预算上的结果也显示一致提升,支持对解码设置的稳健性,无需按设置调优。StepRefine 在 Random、Low Confidence 和 Top-k Margin 重新掩码策略下均优于基线。Low Confidence 重新掩码在所报告的策略行中产生了最高的 StepRefine 分数。在生成长度和步骤预算上报告的 MMHalu 提升在全部六种配置中均为正向,范围从 +1.8% 到 +4.8%。
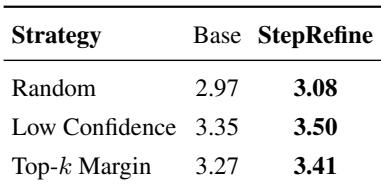
StepRefine 在多个掩码扩散语言模型骨干上进行了评估,在这些骨干上它一致改善了通用推理和幻觉基准,优于基线和竞争性的无需训练解码策略,表明其稳健性不限于任何单一模型。额外实验显示,StepRefine 可与现有加速和基于缓存的解码方法集成,在保持准确率提升的同时保持或略微提高吞吐量。关于重新掩码策略、生成长度和步骤预算的消融进一步证实了无需按设置调优的一致改进。