Command Palette
Search for a command to run...
Reframe:面向智能体视觉推理的观测对齐多教师同策略蒸馏
Reframe:面向智能体视觉推理的观测对齐多教师同策略蒸馏
Haozhi Yuan Handong Li Yifan Zhang Qianshan Wei
摘要
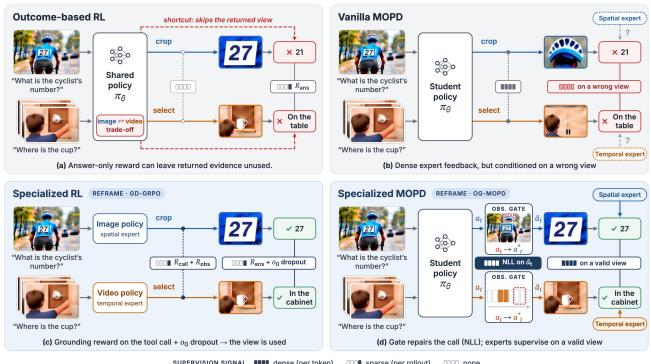
智能体强化学习(RL)与多教师同策略蒸馏(MOPD)为后训练提供了互补路径。然而,对视觉智能体而言,工具使用带来两个相关挑战:模型可能忽略有用的工具返回观测,而依据不足的动作会限制后续蒸馏可用的证据。我们提出 Reframe,一个将观测状态而非仅输出分布视为对齐对象的后训练框架。首先,Ground-Drop GRPO(GD-GRPO)使用证据感知奖励和随机移除原始视觉输入来训练空间专家与时间专家,鼓励其获取有依据的证据并利用返回的观测。其次,Observation-Gated-MOPD(OG-MOPD)在 rollout 中途将有缺陷的工具动作替换为规范动作,并从修复后的观测继续蒸馏。两个阶段相互补充:学会依赖工具返回的观测有助于策略从观测修复中获益。两个阶段均不需要任务特定的 SFT 冷启动。在 14 个图像和视频基准上的大量实验表明,Reframe 优于 Mix-RL 和原始 MOPD。消融实验结果表明,与基于结果的 GRPO 相比,GD-GRPO 提高了观测依赖性和工具增益。
一句话总结
南京大学与中国科学院自动化研究所的研究人员提出了 Reframe,一个用于 agentic 视觉推理的后训练框架。该框架通过将 Ground-Drop GRPO 与证据感知奖励以及 Observation-Gated MOPD 相结合来对齐观察状态,并在 rollout 过程中修复有缺陷的工具动作,在 14 个图像和视频基准上优于 Mix-RL 和 vanilla MOPD。
核心贡献
- 本文提出了 Reframe,这是首个工具使用的多教师在线策略蒸馏(MOPD)框架,将对齐对象从仅输出分布扩展到观察状态,并统一了图像和视频的 agentic 推理。
- 为解决观察忽视问题,Reframe 结合了 Ground-Drop GRPO(GD-GRPO)和 Observation-Gated MOPD(OG-MOPD)。前者通过证据感知奖励和随机移除原始视觉输入来训练空间和时间专家,以加强对工具返回观察的依赖;后者在 rollout 过程中修复有缺陷的工具动作,并从修正后的观察继续蒸馏。
- 在 14 个图像和视频基准上的实验表明,Reframe 优于 Mix-RL 和 vanilla MOPD,平均超过专用专家,并且相比基于结果的 GRPO 提高了观察依赖度和工具增益。Reframe-100K 数据集、代码和模型已开源。
引言
Agentic 视觉推理为视觉语言模型配备图像或视频工具,以在感知密集型任务中收集细粒度证据,但工具使用可能受到观察忽视的影响:模型调用工具却没有真正使用其返回的内容。先前工作通常聚焦于单一模态,而基于混合数据 SFT 后接 RL 的统一图像视频训练往往因 off-policy 模式冲突和 RL 监督稀疏而落后于单模态专家。OPD 和 MOPD 等在线策略蒸馏方法提供了更密集的反馈,但它们大多改进监督沿现有学生 rollout 的传递方式,而不是纠正决定可获得哪些观察的工具调用。作者提出了 Reframe,一个结合 Ground-Drop-GRPO 和 Observation-Gated-MOPD 的两阶段训练框架。GD-GRPO 通过奖励增强和随机丢弃原始视觉输入来强化观察必要性,而 OG-MOPD 在整合前修复偏离的工具动作。在 14 个图像和视频基准上,Reframe 优于 Mix-RL 和 vanilla MOPD,并表现出对工具返回证据更强的因果依赖。
数据集
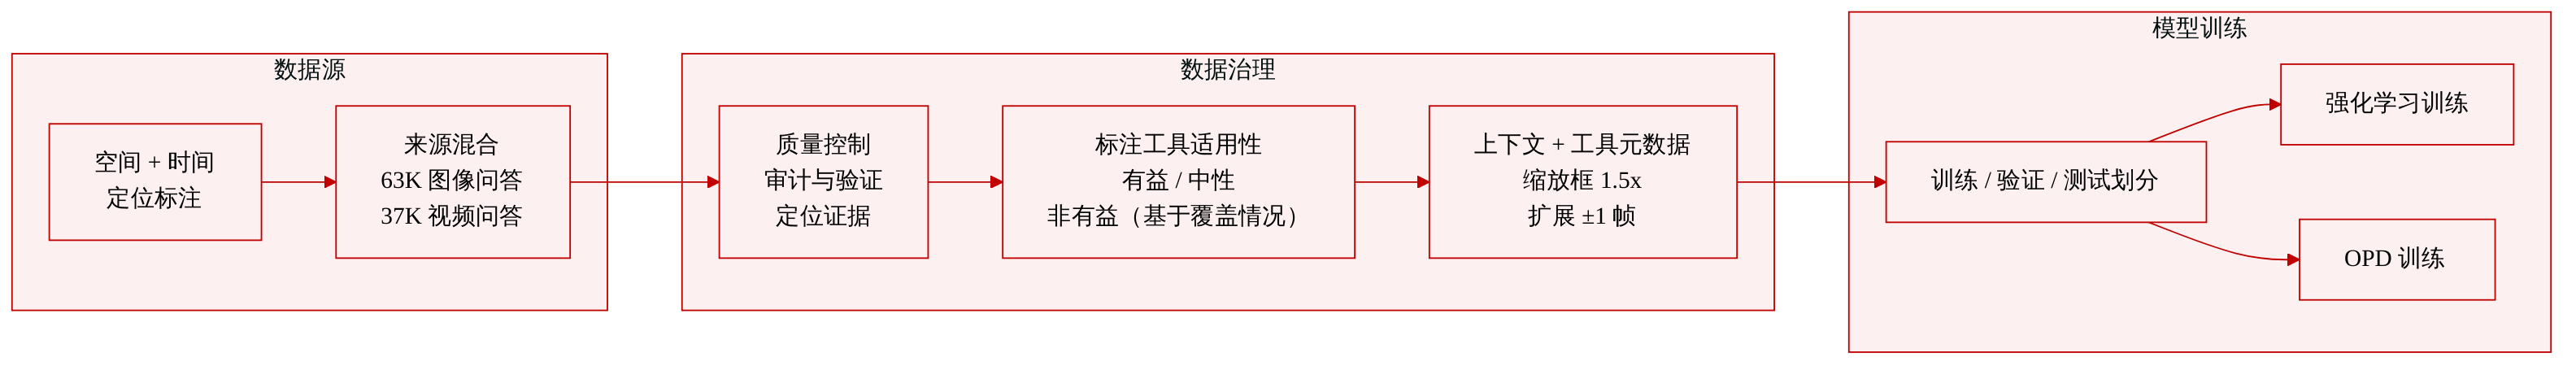
作者从异构的空间和时间 grounding 标注中构建了 Reframe-100K。它包含 100K 个视觉问答对:
- 63K 个图像问答对
- 37K 个视频问答对
该数据集通过一个五步级联数据构建流水线构建,并包含若干处理规则:
- 质量控制:对 grounding 标注进行多轮审核和验证,使保留的证据能够为视觉工具使用提供可靠监督。
- 工具适用性标签:根据标注覆盖率将样本标记为有益、中性或无益。作者避免使用基础模型的 rollout 准确率或更强模型的判断,从而防止标签中的模型预测偏差。
- 上下文感知的证据扩展:空间边界框围绕其中心在宽度和高度上放大 1.5 倍,并裁剪到图像边界内。时间片段在两端各扩展一帧。此操作在计算证据覆盖率和构建工具监督之前执行一次。
- 统一工具元数据:将空间和时间标注转换为统一格式下的可执行工具元数据。
在使用方面,Reframe-100K 同时支持 RL 和 OPD。生成的标注、工具元数据和适用性标签用于监督视觉工具使用。样本不会仅因为基础模型可以在不使用工具的情况下回答而被丢弃,因为即使回答正确的问题也能提供有用的空间或时间工具使用监督。
方法
作者提出了 Reframe,这是一个旨在通过两阶段训练流程增强视觉工具使用的框架,包括 Grounding-aware Decoupled Group Relative Policy Optimization(GD-GRPO)和 Observation-Gated Mixture of Policy Distillation(OG-MOPD)。该方法依赖三个核心设计选择:将工具集限制为两种基础视觉工具(CropImage 和 SelectFrames),采用 Qwen3.5-9B 作为基础模型,并在两个训练阶段使用统一的数据语料。
为支持这一训练流程,作者建立了一个严格的五步级联数据构建过程来生成 Reframe-100K 数据集。该流水线优先考虑 grounding 标注质量、以数据为中心的工具适用性以及上下文感知证据。
如下图所示:
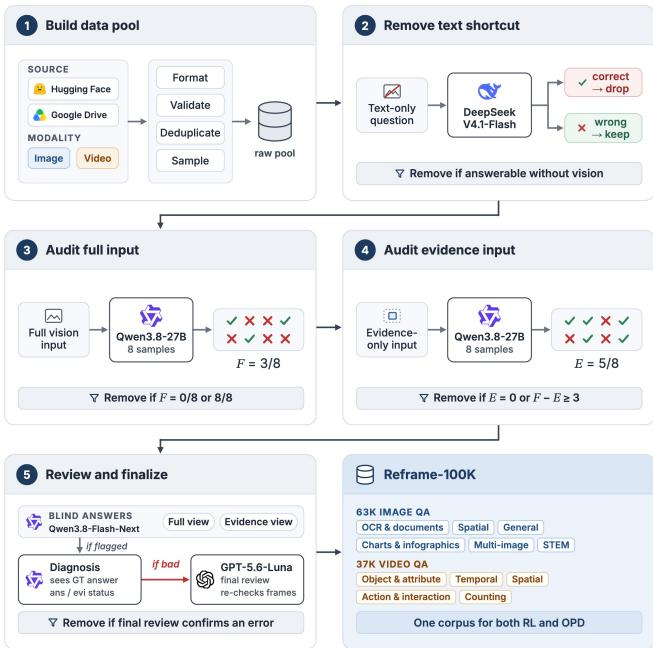
数据构建流水线首先将异构来源聚合到一个原始池中,并移除无需视觉输入即可回答的文本捷径。随后的审核阶段使用强验证器分别评估完整视觉输入和仅证据输入,以丢弃过于简单或证据支持不足的样本。最后,诊断和复查阶段消除剩余错误。在整个过程中,空间边界框被放大 1.5 倍,时间片段在两端各扩展一帧,以保留必要上下文而不引入过多噪声。生成的标注被转换为统一的、可执行的工具元数据格式。
数据构建完成后,作者使用 GD-GRPO 分别训练空间专家和时间专家。这一阶段通过三个关键机制将观察获取与观察依赖耦合。首先,奖励设计根据答案正确性、工具调用行为、grounding 质量和输出有效性来评估轨迹。奖励函数定义为:
R(τ;x,p)=Rans(τ;x)+f(p)Rcall(τ;x)+λobsRobs(τ;x)−Rpen(τ;x)其中工具调用激励 f(p) 随训练进度 p 衰减,满足 f(p)=1−exp(−κ)exp(−κp)−exp(−κ)。Grounding 奖励 Robs 在整个训练过程中保持激活,对图像使用全局一对一 IoU 匹配,对视频使用帧 IoU,以鼓励互补覆盖和高效获取。
第二,为防止模型绕过工具返回的观察,作者实现了原始观察丢弃。在训练期间,原始视觉输入 o0 在第一次成功工具调用后以 0.5 的概率被随机丢弃,迫使模型在后续推理中依赖已获取的观察。
第三,为防止丢弃条件混淆动作质量评估,作者在受丢弃条件约束的子组内计算相对优势。对于共享同一预采样丢弃指示变量 di∈{0,1} 的 rollout,优势计算方式为:
Ai={σx,di+ϵRi−μx,di,0,∣Gx,di∣>1,otherwise.第二阶段 OG-MOPD 解决有缺陷的工具动作使学生处于无信息视觉状态、从而限制教师反馈的问题。作者在工具动作边界进行干预,以在保留学生生成的同时提高观察有效性。在观察门控的 rollout 中,如果学生提出的工具动作 at 无效,或者其与标注证据 et⋆ 的 IoU 低于阈值 δ,则将其选择性替换为规范动作 at⋆:
a~t={at⋆,at,at is invalid or IoU(at,et⋆)<δ,otherwise.这种选择性干预在在线策略探索与观察有效性之间取得平衡。
最后,作者引入了分支感知蒸馏,以处理观察修复引入的不同 token 来源。该目标将学生采样的 token S 与注入的动作 token I 分开:
LOG−MOPD=LMOPD(S)+λbrLNLL(I)其中 LNLL(I)=−∣I∣1∑k∈Ilogπθ(yk∣hk)。这种分离确保负对数似然项教会学生如何到达有信息的观察状态,而标准 MOPD 损失则沿后续学生采样的轨迹传递专家行为。
实验
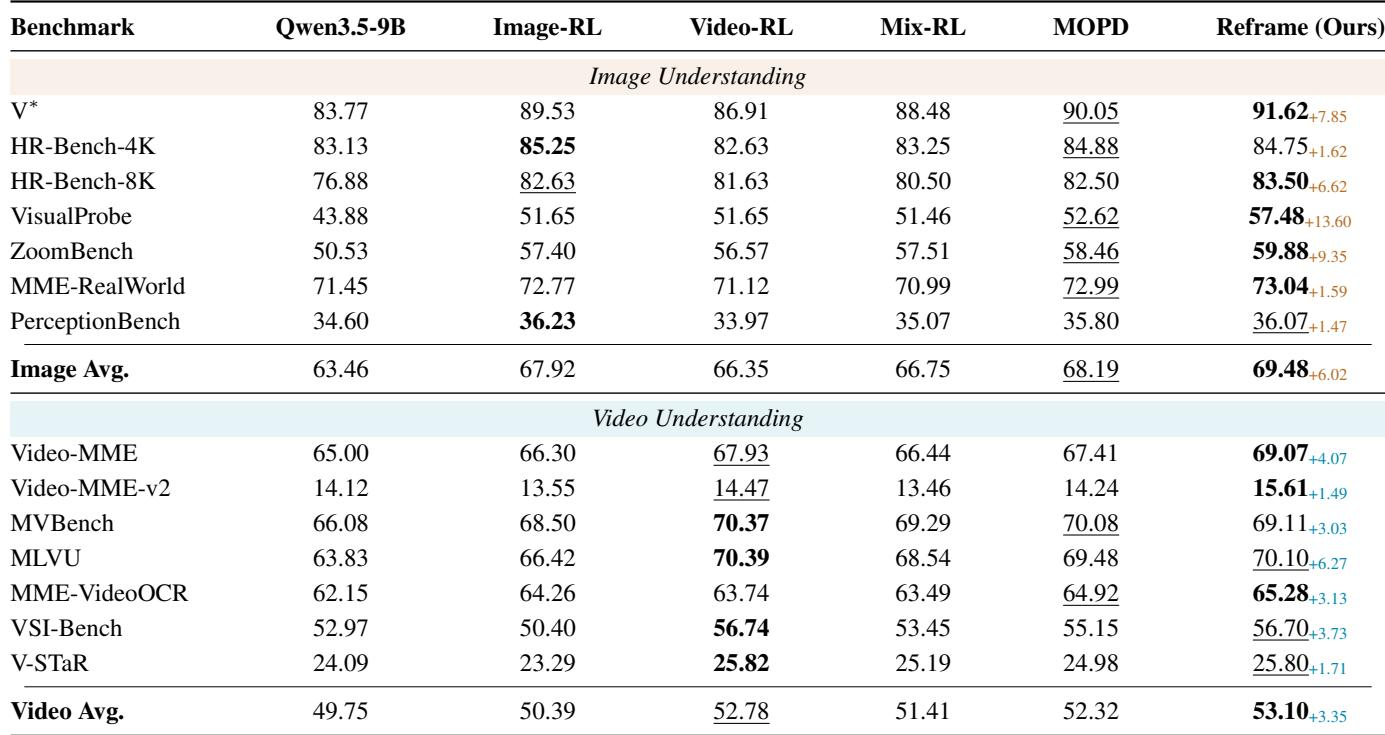
该工作在 7 个图像基准和 7 个视频基准上评估 Reframe,对比对象包括针对特定模态的 RL 专家、混合与合并训练基线,以及共享视觉 token 预算下的现有 agentic 视觉推理模型。结果表明 Reframe 优于所有对比方法,所提出的 GD-GRPO 主要改善工具使用和观察依赖,而非通用视觉能力;观察修复在专家整合的基础上带来进一步增益。消融实验表明,密集的 token 级监督对于合并专家很重要,视觉推理可在模态间部分迁移,并且 Reframe 的优势主要来自自主获取和使用工具返回的证据。
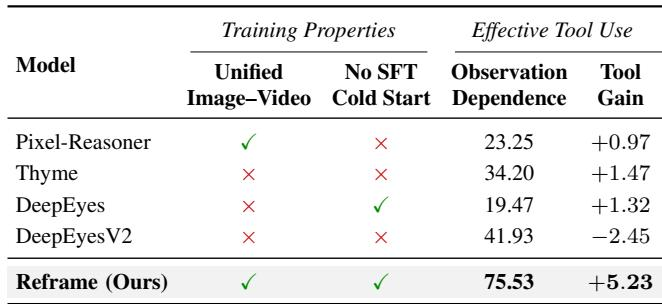
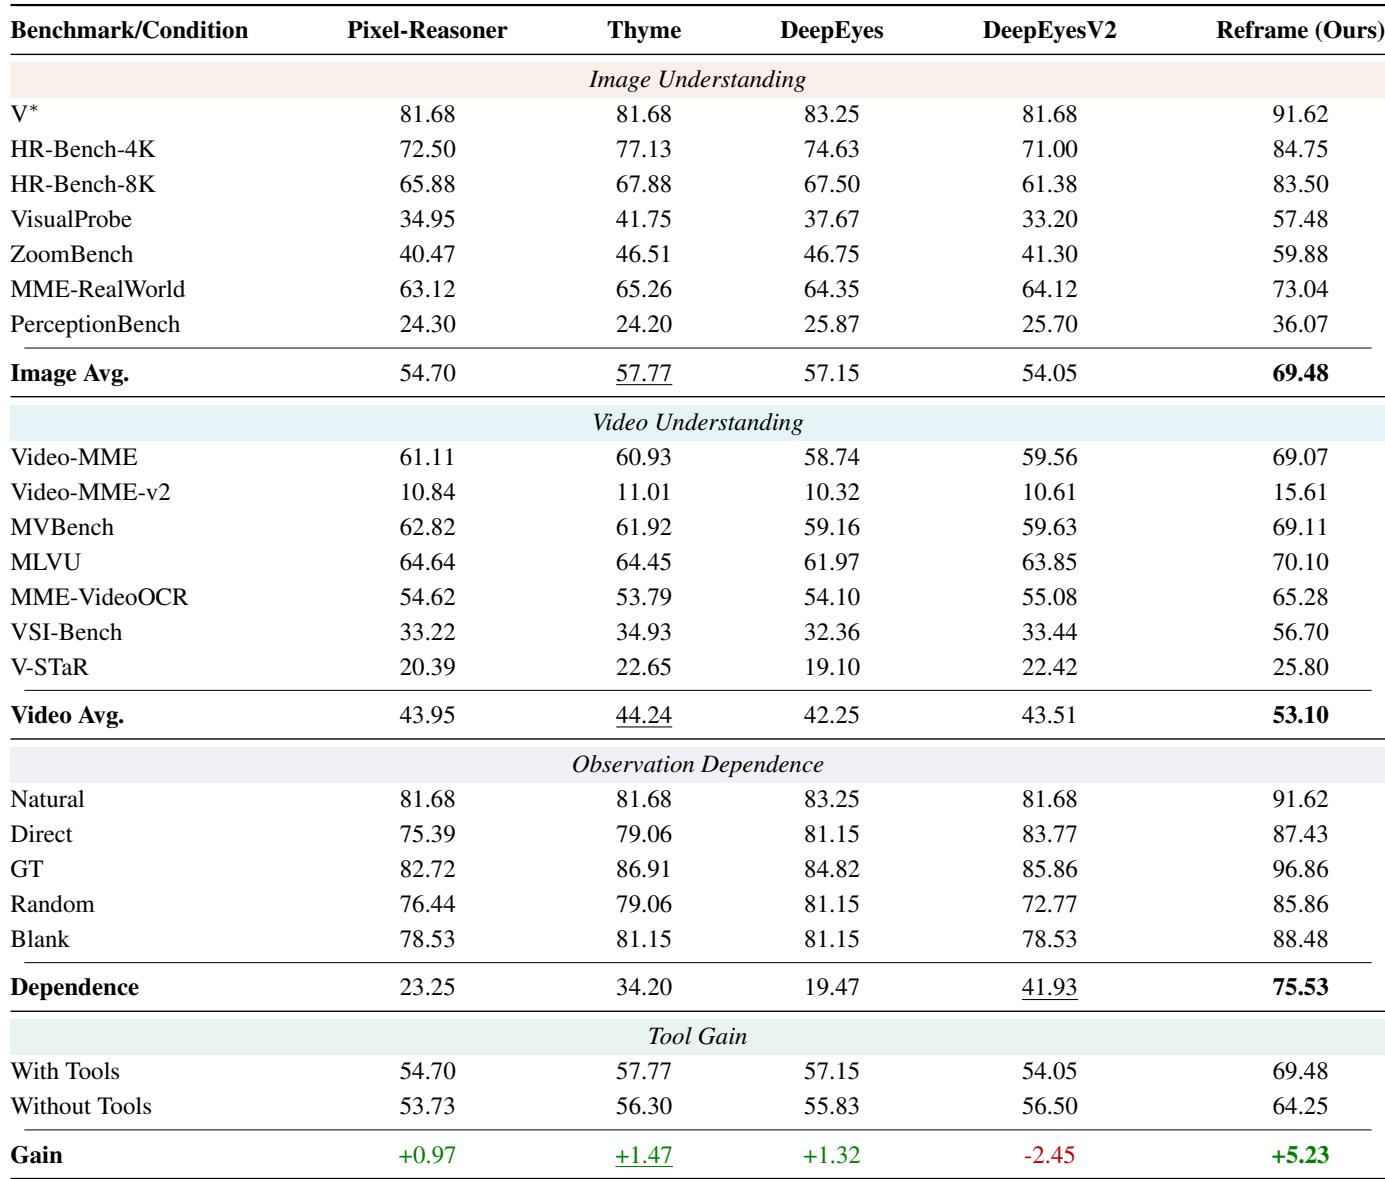
Reframe 是所比较模型中唯一同时具备统一图像视频训练且无 SFT 冷启动的模型。在代表性视觉 agent 中,它实现了最高的观察依赖度和最大的工具增益。这表明 Reframe 既会寻找视觉证据,也能有效利用这些证据改进推理。Reframe 是对比中唯一同时具备统一图像视频训练且无 SFT 冷启动的模型。其观察依赖度大幅领先次优模型。其工具增益明显为正,且远超其他对比模型中的最佳增益,而一个观察依赖度相对较高的替代模型则表现出负的工具增益。
Reframe 在所评估的图像和视频基准上取得了最强的平均结果,同时优于基础模型和 vanilla MOPD。Mix-RL 不如其特定模态专家,而 MOPD 通过更密集的 token 级监督恢复了大部分差距,并在多个基准上可以超过专家教师。Reframe 中的观察修复带来了额外增益,其中在 VisualProbe 上的提升最大。Mix-RL 保留的专家增益少于 MOPD,并在各自模态中落后于 Image-RL 和 Video-RL。MOPD 在多个基准上接近或超过专家性能,而 Reframe 在 MOPD 基础上进一步提高了平均结果,尤其是在 VisualProbe 上。
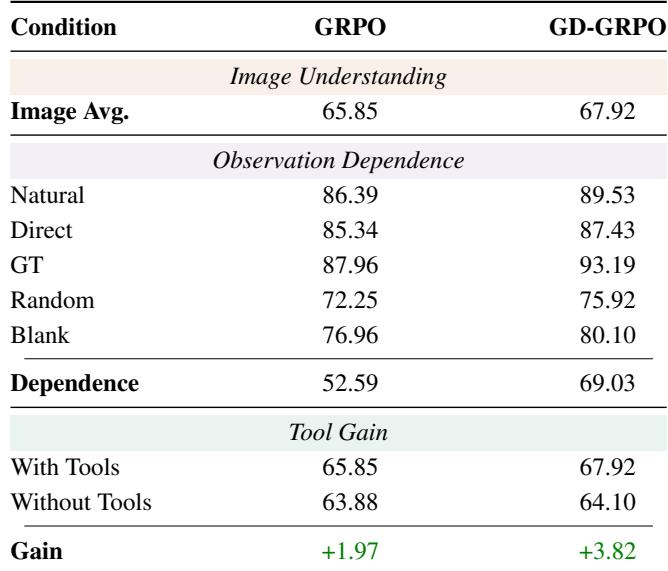
与基于结果的 GRPO 相比,使用 GD-GRPO 训练可以提高图像专家的基准平均分和观察依赖度。改进集中在工具辅助推理上:GD-GRPO 下的工具增益更大,而无工具准确率仅略有变化。GD-GRPO 还提高了在真值、随机和空白观察下的准确率,其中在真值观察下收益最大。GD-GRPO 相比基于结果的 GRPO 提高了平均图像理解能力,而其无工具准确率增益仍然较小。与基于结果的 GRPO 相比,工具使用在 GD-GRPO 下带来明显更大的准确率增益。GD-GRPO 提高了真值、随机和空白观察下的准确率,其中在真值观察下提升最大。观察依赖度增加,表明模型更有力地使用有信息的观察,而不是更容易受到误导性观察的影响。
Reframe 在所比较的视觉 agent 中取得了最佳性能,在所有评估基准上领先,并取得了最高的图像和视频平均分。它还表现出对工具返回观察的最强依赖,以及自主工具使用带来的最大增益,这表明其优势来自有效的证据获取和使用。受控观察进一步显示,其在真值工具证据下性能最强,而在随机或空白观察下较弱。Reframe 在每个报告的基准上都优于所有其他列出的 agent,在图像和视频平均分上的优势尤其明显。Reframe 在对比模型中表现出对工具返回观察的最高依赖度和最大工具增益,表明其对已获取视觉证据的使用更强。
实验在图像和视频基准上比较了视觉 agent,并考察了多种训练选择,包括无 SFT 冷启动的统一图像视频训练、更密集的 token 级监督、观察修复和 GD-GRPO。Reframe 在所有评估基准上持续领先,并表现出最高的观察依赖度和最大的工具增益,表明它比替代方案更有效地获取和使用视觉证据。MOPD 通过更密集的 token 级监督恢复了大部分专家差距,观察修复进一步带来增益,尤其是在 VisualProbe 上。GD-GRPO 相比基于结果的 GRPO 提高了平均性能和观察依赖度,其收益集中在工具辅助推理和真值观察条件下。