Command Palette
Search for a command to run...
面向智能体机器人操作的世界上下文学习
面向智能体机器人操作的世界上下文学习
Heng Fang Zehui Guo Yuehan Zhang Mingyang Du Dingkang Liang Xiang Bai
摘要
训练得到的动作策略将操作技能写入网络权重,从而将所学内容与其来源分布绑定在一起。上下文学习(ICL)避免了这种耦合,但尚未匹敌训练得到的策略,因为记录于另一场景的演示不携带来自机器人当前所面对世界的反馈。我们观察到,智能体在上下文中学到的是语义层面的信息,它记录任务步骤和物体角色,而非视觉外观;因此,在一个世界中积累的经验可以迁移到另一个世界。基于这一洞见,我们提出了世界上下文学习(WICL),在该范式中,一个冻结模型从一段演示开始,在模拟器等世界中演练任务,并将反馈写入其上下文而非其权重。我们构建了 RoboScript,一个实现面向智能体操作的 WICL 的模块化基础设施。仅凭一段演示,RoboScript 便通过在仿真中演练学习每项任务,将所学知识冻结为任务记忆(Task Memory),并将冻结后的记忆部署到新场景中,同时通过数据隔离确保每个部署输入在真实机器人上都可获得。在 RoboTwin 2.0 的全部 50 项任务上,RoboScript 在干净与随机化设置下、每项任务仅使用一段演示且不做梯度更新的情况下,平均成功率达到 83.4%,超过最强训练动作策略 20 个百分点以上。该方法能跨视觉分布泛化,通过反思改进,可随基础模型扩展,并通过跨具身记忆适配迁移到实体双臂机器人。当世界处于回路中时,机器人可以在其上下文中学习操作任务,效果不亚于在其权重中学习。
一句话总结
华中科技大学和 ArcheOne AI 的研究人员提出了 World In-Context Learning (WICL) 和 RoboScript 基础设施。在该基础设施中,冻结模型在仿真环境中根据单次演示排练每个操作任务,将产生的反馈作为 Task Memory 存储在上下文中而不是权重中,并将该记忆部署到新场景中,在全部 50 个 RoboTwin 2.0 任务上达到 83.4% 的平均成功率,比最强的已训练动作策略高出 20 个百分点以上。
核心贡献
- 这项工作提出了 World In-Context Learning (WICL) 范式:冻结模型从一次演示出发,在仿真器等世界中排练任务,并将反馈写入上下文而不是权重。RoboScript 将 WICL 实现为用于 Agent 操作的模块化基础设施,将所学知识存储为 Task Memory,并强制实现部署数据隔离。
- 在上下文中学习的知识是语义性的,编码任务步骤和物体角色,而不是视觉外观,因此能够跨视觉分布迁移,与三种不同的基础模型配合使用,并通过反思不断改进。
- 在全部 50 个 RoboTwin 2.0 任务上,RoboScript 在干净设置和随机化设置下、每个任务仅使用一次演示且不做梯度更新的情况下,达到 83.4% 的平均成功率,比最强的已训练动作策略高出 20 个百分点以上。所学记忆通过跨具身记忆适配迁移到实体双臂机器人,无需重新录制演示或重复排练。
引言
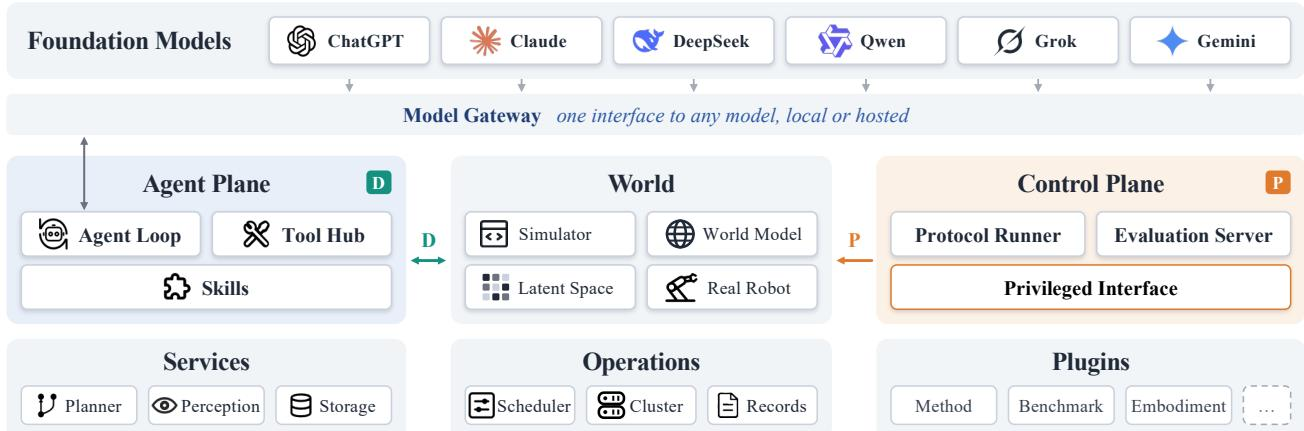
机器人操作传统上依赖已训练的动作策略,例如视觉-语言-动作模型或世界动作模型,这些模型将技能存储在网络权重中。这些策略在其训练分布内表现良好,但在分布偏移下会急剧退化,并且每个新任务或新领域都需要新数据和梯度更新。上下文学习避免了重新训练,但以往的上下文操作方法缺乏来自世界的反馈,因此来自其他场景的演示可能无法迁移,错误也可能在缺少纠正的情况下累积。作者形式化了 World In-Context Learning (WICL):冻结模型通过在可信世界中排练学习操作任务,将结果提炼为可复用的语义上下文,并在不更新权重的情况下进行部署。他们在 RoboScript 中实现了这一方法,这是一个以 Agent 为中心的模块化操作平台,具有严格的数据隔离,支持单次演示学习、递归自我改进和跨具身迁移。
方法
作者介绍了 RoboScript,一种用于机器人操作的 World In-Context Learning (WICL) 实现。WICL 通过引入来自世界的反馈扩展上下文学习,在排练和修订之间交替以更新上下文 C,同时保持基础模型权重 θ 冻结。学习到的上下文被称为 Task Memory C⋆,捕获关于物体角色、工作流程和相对几何的语义知识,从而支持在不同环境之间迁移。
参考框架图:
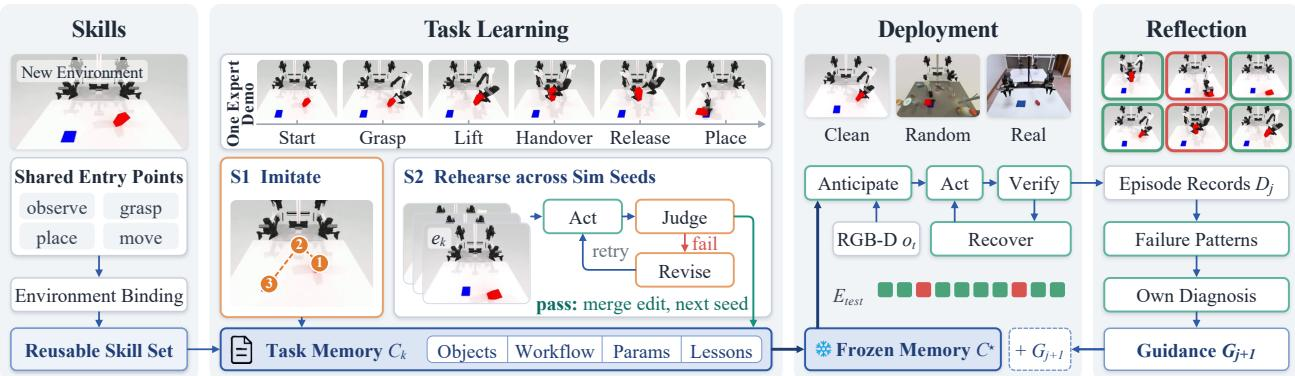
RoboScript 流水线由四个主要阶段组成:技能构建、任务学习、部署和反思。
首先,agent 构建可复用的技能集以建立其动作接口。它通过 RGB-D 图像和本体感知来感知环境,并使用几何优先感知来检测和跟踪物体。agent 通过三层 API 执行动作,该 API 包括共享入口点、环境绑定和环境特定技能。通过将演示分割为动作原语,agent 识别缺口,并通过 coding agent 生成新技能,反复验证直到覆盖范围稳定。每个动作都会返回一个回执,详细说明命令姿态和实际达到的姿态,从而将反馈 r 建立在具体观测之上。
接下来,agent 通过两个阶段从单次专家演示中学习 Task Memory:模仿(S1)和排练(S2)。在 S1 中,读取角色初始化记忆 C0=Tθ(d),执行角色在演示实例上练习,审查角色在失败时修订记忆。在 S2 中,agent 在新的仿真随机种子上排练,通过 Ck+1=Uθ(Ck,τk,rk) 更新记忆。只有当修订带来成功时才会合并,memory linter 确保 Task Memory 保持严格的语义性,拒绝绝对坐标或仿真器特定事实。这种严格的数据隔离保证执行 agent 仅依赖可部署数据。
在部署期间,agent 使用冻结的 Task Memory C⋆ 在未见实例上运行,不接收世界反馈,执行 at∼πθ(⋅∣ot,C⋆)。在操作之前,它会进行场景预判,将语义蓝图映射到当前布局并验证可达性。如果某个动作失败,agent 会移动到安全姿态并继续,而不会重置环境,仅受步数限制约束。
最后,系统通过反思循环实现递归自我改进。在不重叠的实例块上评估后,reflection agent 分析 episode 记录 Dj,这些记录仅包含可部署观测和成功指示。它诊断失败模式,并为下一块生成指导文档 Gj+1=Vθ(Gj,Dj)。这一过程使 agent 能够在多轮中提升泛化能力,而无需梯度更新或特权数据。
实验
实验在干净设置和随机化设置下,对 50 个双臂 RoboTwin 2.0 任务评估 RoboScript。agent 通过每个任务的一次干净演示加上在干净场景上的排练学习任务,并在两种条件下进行测试。主要结果表明,单次演示加排练在干净场景中与已训练策略相当,在域随机化下则大幅优于它们,增益来自上下文中的语义知识、演示锚定、世界交互、排练和部署恢复,而非特权监督。额外实验证明了 agent 根据自身评估进行递归自我改进,报告了学习和推理成本,并表明学习到的 Task Memory 通过参数重映射迁移到具有不同具身的实体双臂机器人。
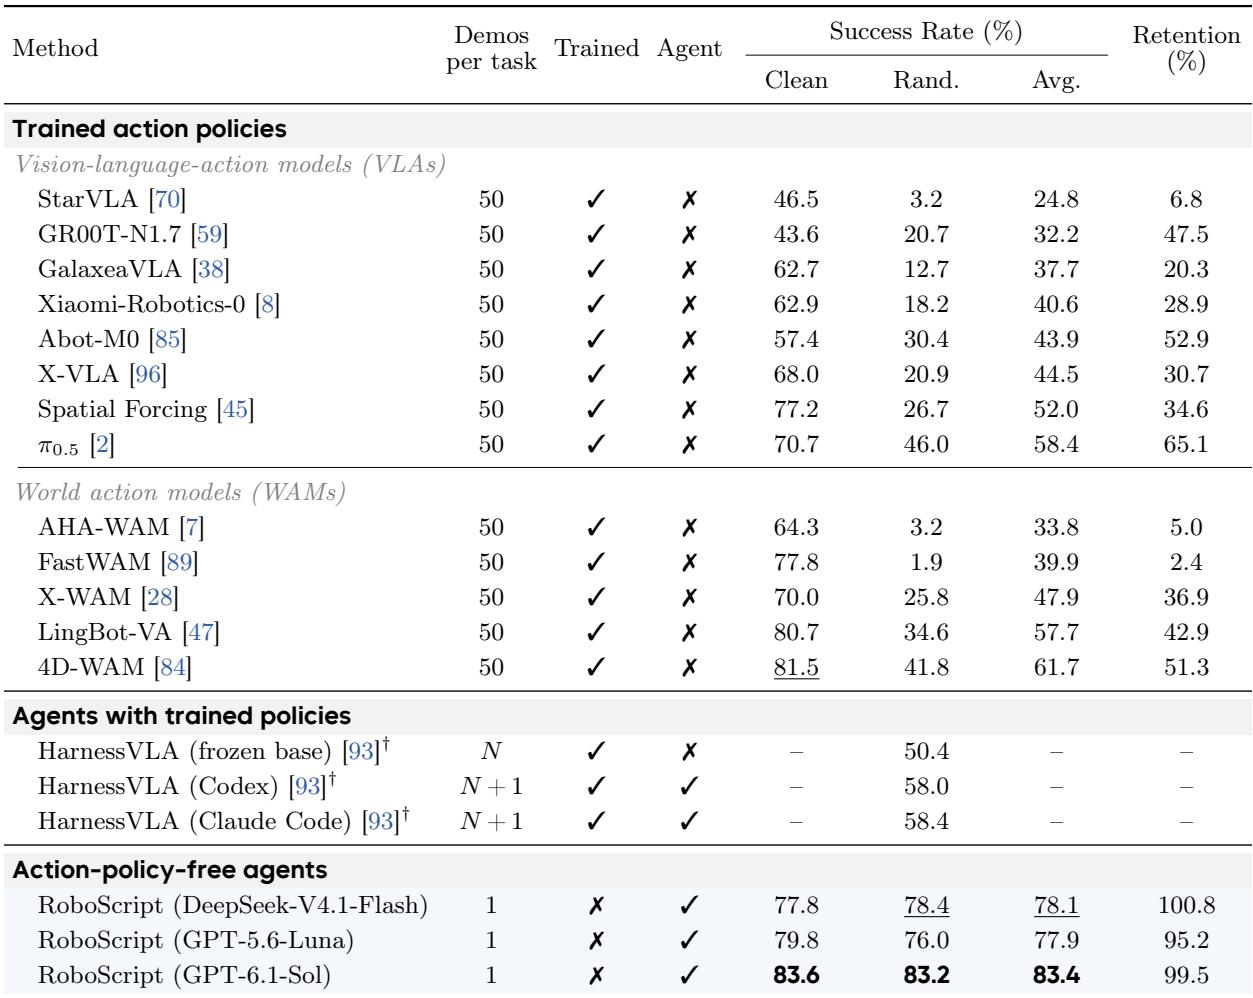
使用基础模型 agent 且每个任务仅用一次演示的 RoboScript,优于每个任务使用 50 次干净演示的已训练动作策略。其干净设置和随机化设置下的成功率几乎持平,而已训练策略在随机化下会丧失大部分成功表现。这一优势在不同基础模型上均成立,来源于基于上下文的记忆,而非梯度更新或随机化训练数据。单次演示加排练且不进行梯度更新,比每个任务使用 50 次演示的已训练策略获得更高的总体成功率。基础模型 agent 在随机化下保留了干净成功率的 95.2% 至 100.8%,而已训练策略最多仅保留 65.1%。最强的已训练策略在干净设置中与基础模型 agent 相当,但在随机化下急剧下降。基础模型之间的表现随模型能力扩展,最强模型领先其他模型约 5 个百分点。
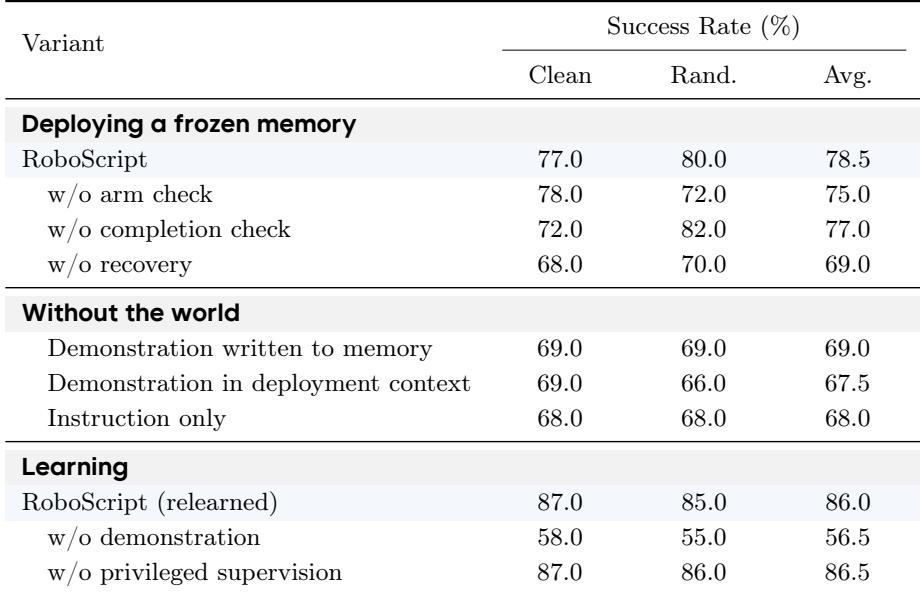
这组消融实验隔离了世界交互、演示和部署组件的作用。世界和演示都必不可少:移除其中任何一个都会导致大幅下降,而没有演示的排练可能比不排练更差。部署时恢复也很重要,而排练在场景变化更大的更困难任务上带来的提升最大。在演示之后进行世界交互,比仅从演示构建记忆带来更大增益;没有世界交互的仅演示记忆和仅指令记忆之间的差异小于 1.5 个百分点。在排练前移除演示会导致该研究中的最大下降,仅根据指令进行排练的表现比不排练直接部署同一仅指令记忆低 11.5 个百分点。部署时恢复是最重要的被移除部署组件;移除它会比移除手臂或完成检查更降低成功率。在本组排除的更困难任务上,排练带来更大的平均增益,在随机化下增益更大,因为这些场景与演示差异最大。
在三个基础模型中,GPT-6.1-Sol 达到最高平均成功率,但总成本也最高;GPT-5.6-Luna 最便宜,DeepSeek-V4.1-Flash 居中。GPT-5.6-Luna 在最少任务上通过演示退出规则,而 DeepSeek-V4.1-Flash 在所有任务上通过。评估成本在总开销中占主导地位,冻结的 Task Memory 可以在不增加学习成本的情况下重复使用。GPT-6.1-Sol 平均成功率最高,但最昂贵;GPT-5.6-Luna 最便宜。DeepSeek-V4.1-Flash 在所有任务上通过演示退出规则,但每次调用生成的输出 token 远多于 GPT-6.1-Sol。
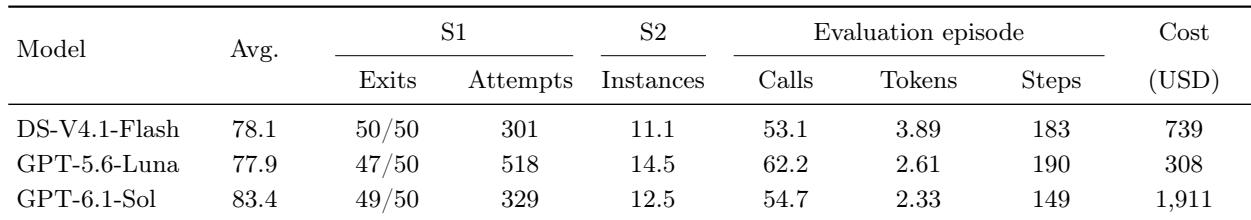
这些实验评估了 RoboScript,即一个获得单次演示和排练的基础模型 agent,与使用大量干净演示的已训练动作策略进行对比,并隔离了世界交互、演示和部署组件的贡献。RoboScript 在随机化场景下几乎保留了全部干净成功率,而已训练策略大幅下降;增益来自基于上下文的记忆而非梯度更新,并随基础模型能力扩展。消融实验表明,演示和世界交互都必不可少,部署时恢复和排练在更困难的多样化任务上贡献最大;成本结果表明,最强模型获得最高成功率,但最昂贵,而冻结的 Task Memory 可以重复使用。