Command Palette
Search for a command to run...
面向通用灵巧操作学习异构触觉表示
面向通用灵巧操作学习异构触觉表示
摘要
触觉感知是接触密集型灵巧操作不可或缺的模态,这种能力指向具身智能的终极前沿之一。然而,目前商用触觉传感器仍处于相对早期的发展阶段,每种传感器都有不可替代的优势,也各有其不足。因此,一个关键挑战在于使触觉理解摆脱对特定传感器物理特性的依赖,从而使具身模型能够有效利用异构触觉数据。为此,我们开发了 LingBot-Touch,一个具备以下特性的触觉基础模型。(i)我们的模型能够在不同触觉传感器(即压阻式、磁式和视触觉传感器)上产生统一表示,并且易于扩展到新的传感器类型。(ii)所得到的触觉 token 具有即插即用特性:它们可以无缝集成到不同范式的策略模型中,从扩散策略到视觉-语言-动作(VLA)模型(如 π 和 LingBot-VLA),持续提升操作灵巧性。(iii)大量实验涵盖仿真以及在多个硬件平台上的真实机器人部署,结果表明我们的触觉表示能够显著提升复杂操作任务的表现,同时保持较高的计算效率。我们认为,本研究的发现展示了利用跨传感器数据扩展触觉学习的潜力,并为未来硬件与具身模型的设计提供了令人鼓舞的启示。
一句话总结
Robbyant 的研究人员开发了 LingBot-Touch,这是一种触觉基础模型,能够在压阻式、磁性和视觉触觉传感器之间学习统一表征,并为扩散策略和视觉-语言-动作策略(如 π 和 LingBot-VLA)提供即插即用的触觉 token,从而在仿真和真实机器人任务中提高操作灵巧性。
核心贡献
- LingBot-Touch 将多分支 tokenizer 与共享的 Haptic Transformer 结合,在压阻式、磁性和视觉触觉传感器之间学习统一的接触表征。
- 规范指尖空间和 Tactile-JEPA 目标通过在潜空间中预测接触来训练共享编码器,为扩散策略和视觉-语言-动作模型(如 π 和 LingBot-VLA)提供即插即用的触觉 token。
- 在 5,000 小时触觉记录上预训练后冻结,该模型在 26 个真实世界任务和 12 个仿真任务中改进了模仿学习、VLA 和强化学习策略,迁移到未见过的磁性手,优于带传感器特定适配器的 FTP-1,并保持强大的计算效率。
引言
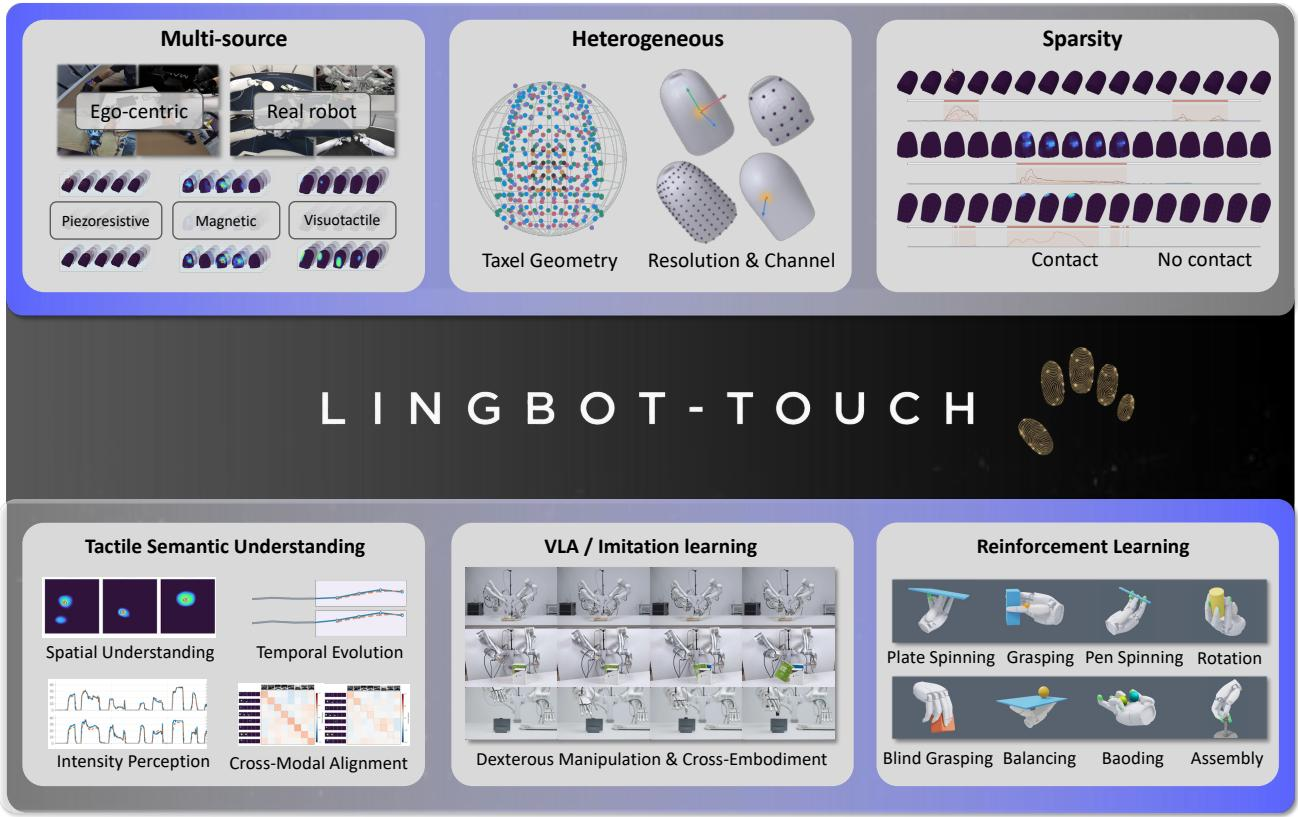
人类依靠触觉进行灵巧操作,而机器人仍然主要依靠视觉进行操作,尽管视觉无法揭示接触力、滑动或遮挡手指下方发生的情况。触觉尚未像视觉或语言那样规模化,原因在于压阻式、磁性和光学传感器之间缺乏通用输入格式,缺乏大型汇总语料库,也缺乏共享表征或成熟的学习方法。先前触觉学习仍分散在传感器特定研究和单个任务中。作者提出了 LingBot-Touch,这是一种触觉基础模型,通过一个编码器从所有三种主要传感原理中学习共享接触表征,并且无需重新训练即可扩展到新传感器。其实现方式是:将传感器触点映射到规范指尖空间,使用适合稀疏无标注触觉信号的潜空间预测目标,并在来自人类触觉手套和遥操作机器人手的 5,000 小时语料库上进行训练。
数据集
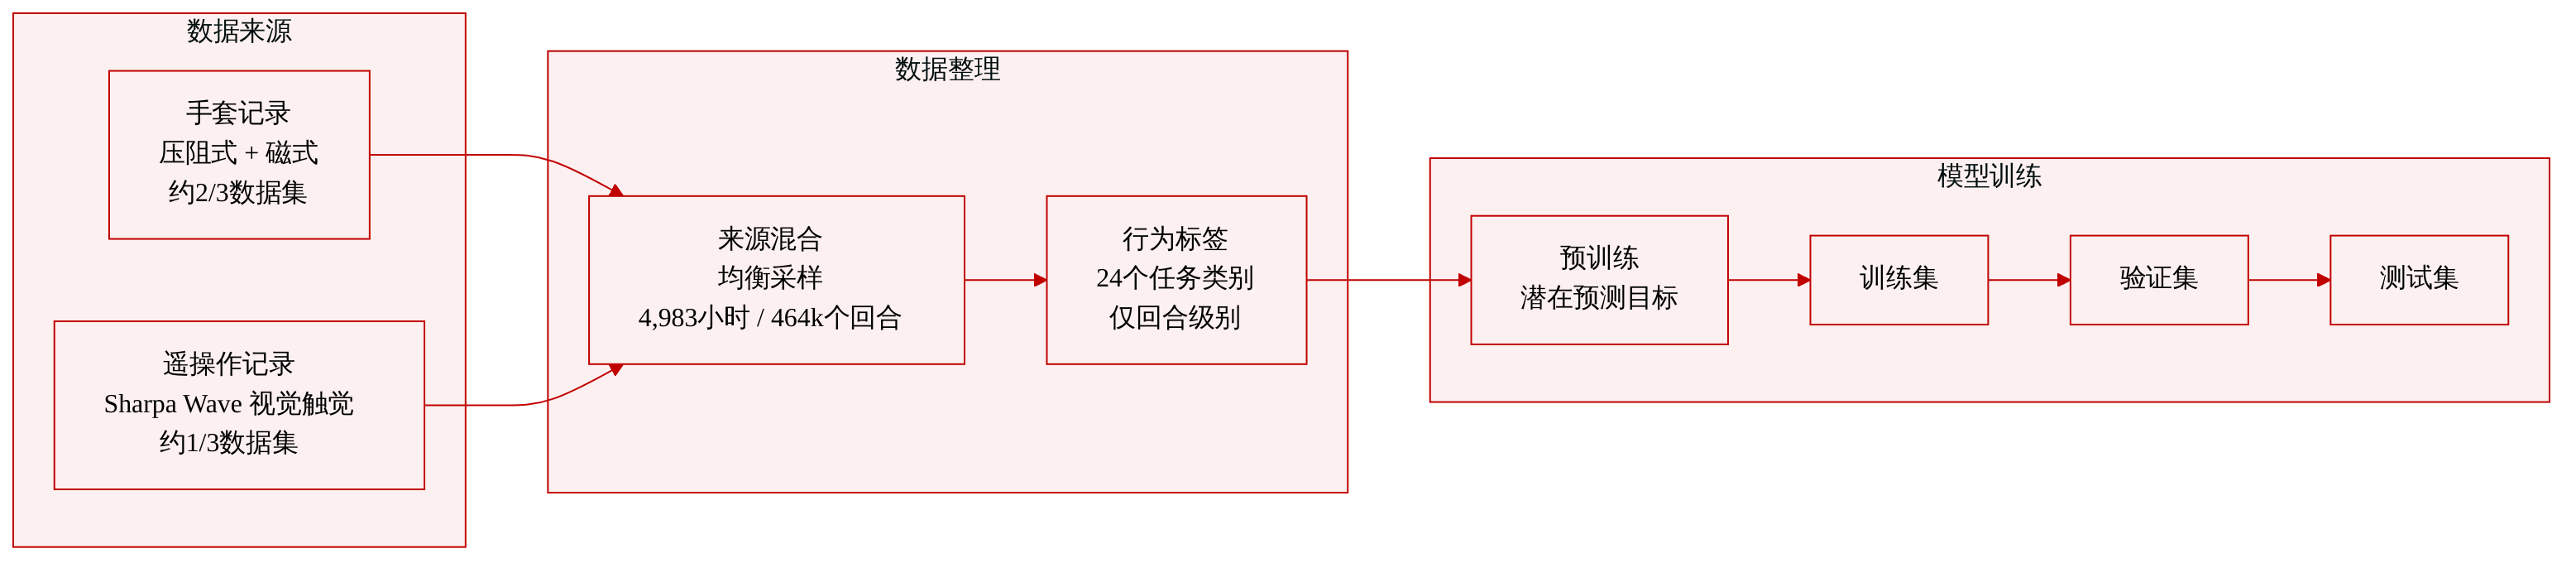
作者构建了一个多源触觉数据集,包含 4,983 小时记录、464,431 次交互片段和约 13.3 亿帧。
-
来源与构成:
- 佩戴触觉手套的人类操作员提供了语料库的主要部分。这些记录使用压阻式和磁性手套,涵盖普通环境中的日常操作。
- 遥操作提供其余部分,使用配备 Sharpa Wave 灵巧手的双臂系统,其指尖装有视觉触觉传感器。该来源记录与部署所用机器人手相同的任务系列。
- 手套记录约占语料库的三分之二;遥操作约占三分之一。
-
子集详情:
- 压阻式手套子集:来自人类操作员记录,属于语料库的手套部分。
- 磁手套子集:来自人类操作员记录,同样属于手套部分。
- 视觉触觉遥操作子集:来自 Sharpa Wave 指尖记录,属于遥操作部分。
- 三种传感器来源在传感原理、每指触点数、采样率和指尖几何形状上均不同。
-
行为标注与元数据:
- 每个片段被分配到 24 个任务类别之一,例如打开、关闭、组装、擦拭、倾倒和工具使用。
- 大多数任务类别由不止一个来源覆盖。
- 标注仅到片段级类别为止。没有力、接触位置或接触时机的标签。
-
处理与使用:
- 来源在行为上匹配,而不是在硬件上匹配。
- 预训练期间,以相等的采样概率从压阻式、磁性和视觉触觉来源采样片段。
- 所有监督均来自潜空间预测目标。
- 除片段采样和片段级类别分配外,所提供的文本未指定明确的裁剪或过滤规则。
方法
作者提出了 LingBot-Touch,这是一种基础触觉编码器,旨在从异构时空触觉信号中学习统一、可操作的表征。为应对触觉数据的稀缺性和多样性,该框架将来自磁性、压阻式和视觉触觉传感器的输入映射到规范球形空间。这种归一化将指尖对齐到共享的手指局部坐标系,确保来自不同传感器布局的测量结果可以被统一处理。
如下图所示,该架构依赖一种为触觉数据定制的自监督联合嵌入预测架构(JEPA),称为 Tactile-JEPA。
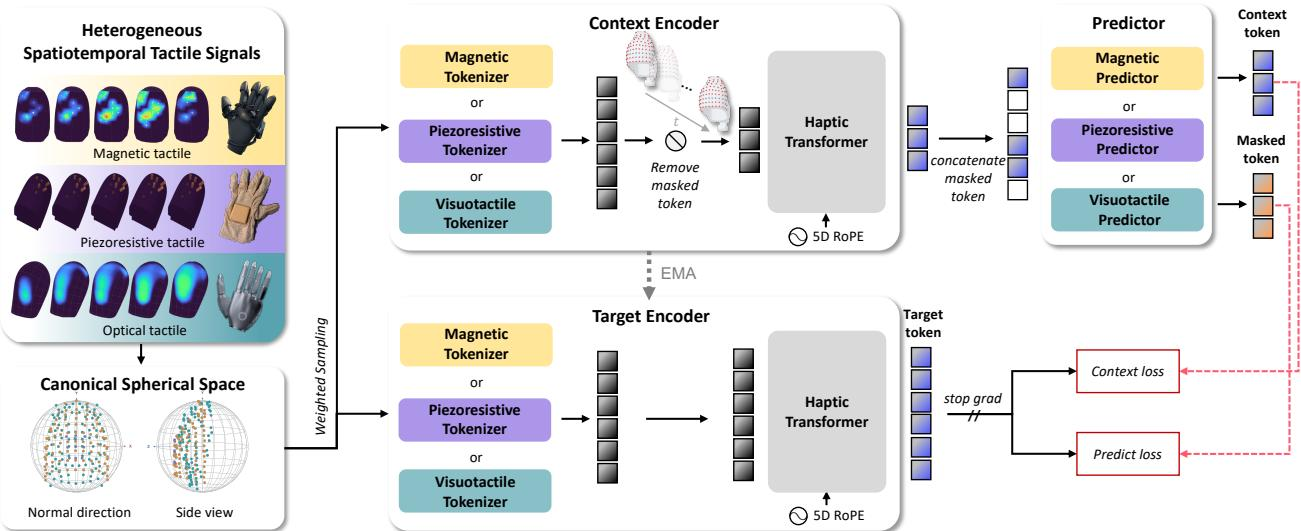
模型处理归一化触觉片段 X∈RT×N×3,其中 T 是帧数,N 是有效触点总数。每个触点被分配一个五维地址 ai=(ti,fi,pi),包括时间窗口索引、手指身份和连续 3D 规范位置。该地址通过五轴旋转位置嵌入(RoPE)集成到模型中,使骨干网络能够处理不同的传感器布局,而无需传感器特定的位置表。
在输入阶段,模态特定的 tokenizer 将异构信号转换为统一的 token 空间。作者为磁性、压阻式和视觉触觉传感采用了三种不同的两层 MLP tokenizer,每个 tokenizer 将单个触点的两个连续帧嵌入为一个 token。这些 token 随后被输入共享的 Haptic Transformer(HaT)骨干网络,该网络在逐渐升高的抽象层级上学习共享的触觉表征。
训练由潜空间预测目标驱动。输入片段被划分为可见集 C 和掩码集 M。上下文编码器仅处理可见 token,而目标编码器处理完整的未掩码片段。目标编码器参数通过上下文编码器的指数移动平均(EMA)更新,梯度在目标分支中停止。模态特定的预测器接收上下文编码器输出,与可学习的掩码 token 拼接,并预测目标编码器在掩码和可见位置上的表征。目标表征通过拼接目标编码器四个深度的特征构建。模型使用组合损失函数进行优化:
L=∣M∣D1i∈M∑∥z^i−sg(zˉi)∥1+∣C∣Dλi∈C∑∥z^i−sg(zˉi)∥1其中 D 是特征维度,sg 表示停止梯度,λ=0.5。该目标鼓励模型从可见上下文中推断缺失的接触信息,同时保留观察到的接触细节。
由于触觉信号本身稀疏,从训练开始就使用高掩码比例可能会消除所有接触证据,导致梯度爆炸。为缓解这一问题,作者实施了空间掩码比例预热策略。
如下图所示,掩码比例在前 300 个优化步骤中从 40% 线性增加到 80%,此后保持不变。
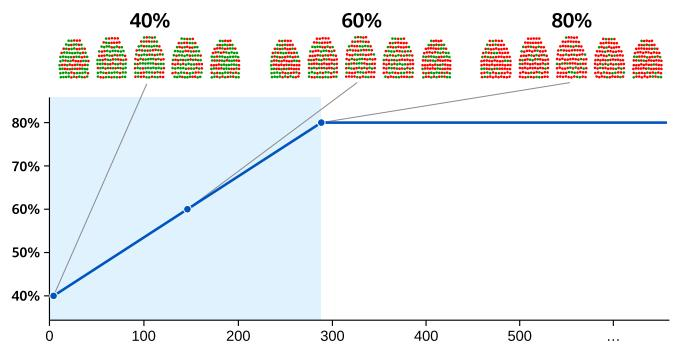
该预热仅占总 200,000 次训练更新中可忽略的一小部分,但在初始未训练阶段显著稳定了优化过程。
为进一步确保编码器能够泛化到未见过的传感器布局,而不是记忆特定点集,作者在预训练期间应用了与布局无关的数据增强。这包括通过在不同空间分辨率下重采样原生布局来让模型接触多种采样密度,以及扰动规范触点位置。位置扰动添加受局部间距约束的偏移量,pi′=pi+δi,其中 ∥δi∥2≤0.5di,di 是到最近有效触点的距离。这些增强后的坐标替换 token 地址中的原始位置,迫使模型依赖底层交互几何而不是精确坐标模板。
实验
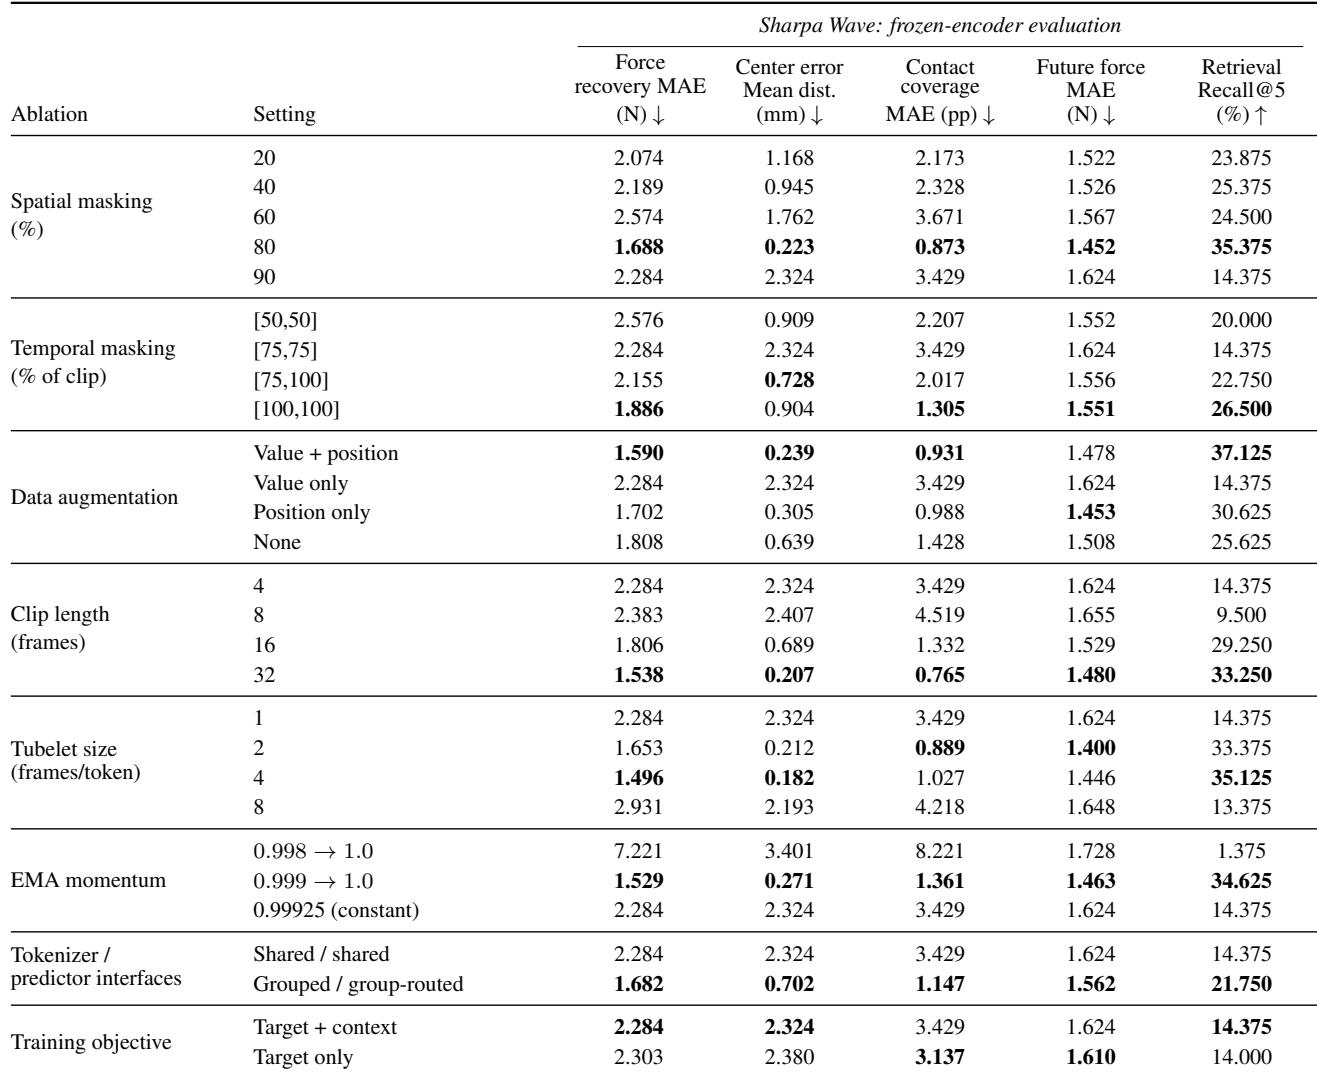
实验在两个灵巧手上评估冻结的触觉编码器,并配合轻量探针,一个在预训练期间可见,一个不可见,评估内容包括接触力、空间定位、时间动态以及触觉到视频检索,然后在真实和仿真机器人策略中测试相同的冻结 token。探针实验表明,该表征能够捕捉接触物理特性,迁移到未见过的传感器,随着预训练时长和模型容量的增加而改进,并依赖于潜空间预测、掩码和数据增强选择。机器人实验表明,加入冻结触觉 token 比原始触觉输入更能改进模仿学习、VLA 和强化学习,特别是在视觉无法分辨的接触丰富时刻,更好的探针性能也会延续到下游策略成功率。
消融实验表明,默认配置对于 Sharpa Wave 冻结编码器任务并非最优。将空间掩码从 90% 降低到 80% 可以改善全部五项指标,而全片段时间掩码以及数值加位置组合增强改善了大多数指标。对于 30 Hz 的视觉触觉信号,每个 token 包含两帧或四帧的 32 帧片段表现最佳。80% 空间掩码在 Sharpa Wave 的全部五项指标上均为最佳,检索召回率和中心误差明显优于 90% 默认值。将时间掩码扩展到整个片段在五项指标中有四项优于较短时间跨度。数值加位置组合增强在五项指标中有四项表现最佳;仅位置增强在预测未来力方面略优。对于 30 Hz 视觉触觉数据,每个 token 包含两帧或四帧的 32 帧片段最佳,而单帧 token 和 8 帧管片段明显更差。
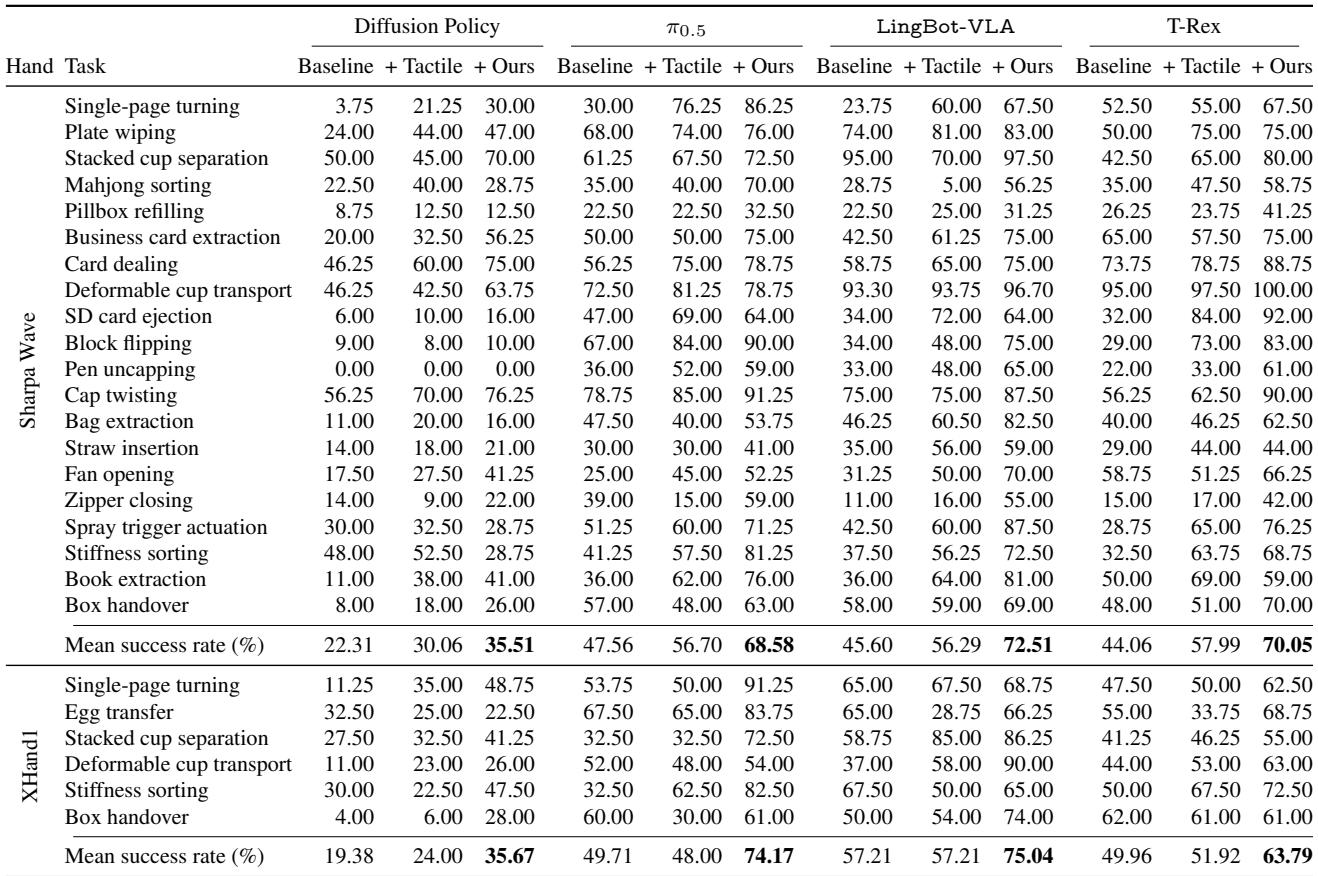
在 26 个真实机器人任务中,用冻结的 LingBot-Touch 触觉 token 增强策略,相较于原始策略和原始触觉信号,一致地提高了成功率,平均提升约 14 到 25 个百分点,具体取决于策略。原始触觉信号带来的平均收益较小,并且可能严重损害单个任务,而 token 表征即使在像 XHand1 这样陌生的手上也能提供帮助。该表征并非在所有情况下都更好,但在大多数任务-策略组合中表现最佳,并且在几乎所有情况下都达到或超过原始策略。冻结的 LingBot-Touch token 改善了全部四种策略的平均成功率,提升幅度约为原始触觉信号的两倍,而原始触觉输入可能损害麻将分类和鸡蛋转移等单个任务的表现。该收益可以迁移到陌生的手:在 XHand1 上,原始触觉信号对所有策略几乎无用,但从相同信号计算出的 LingBot-Touch token 在没有传感器特定训练的情况下产生了明显收益。
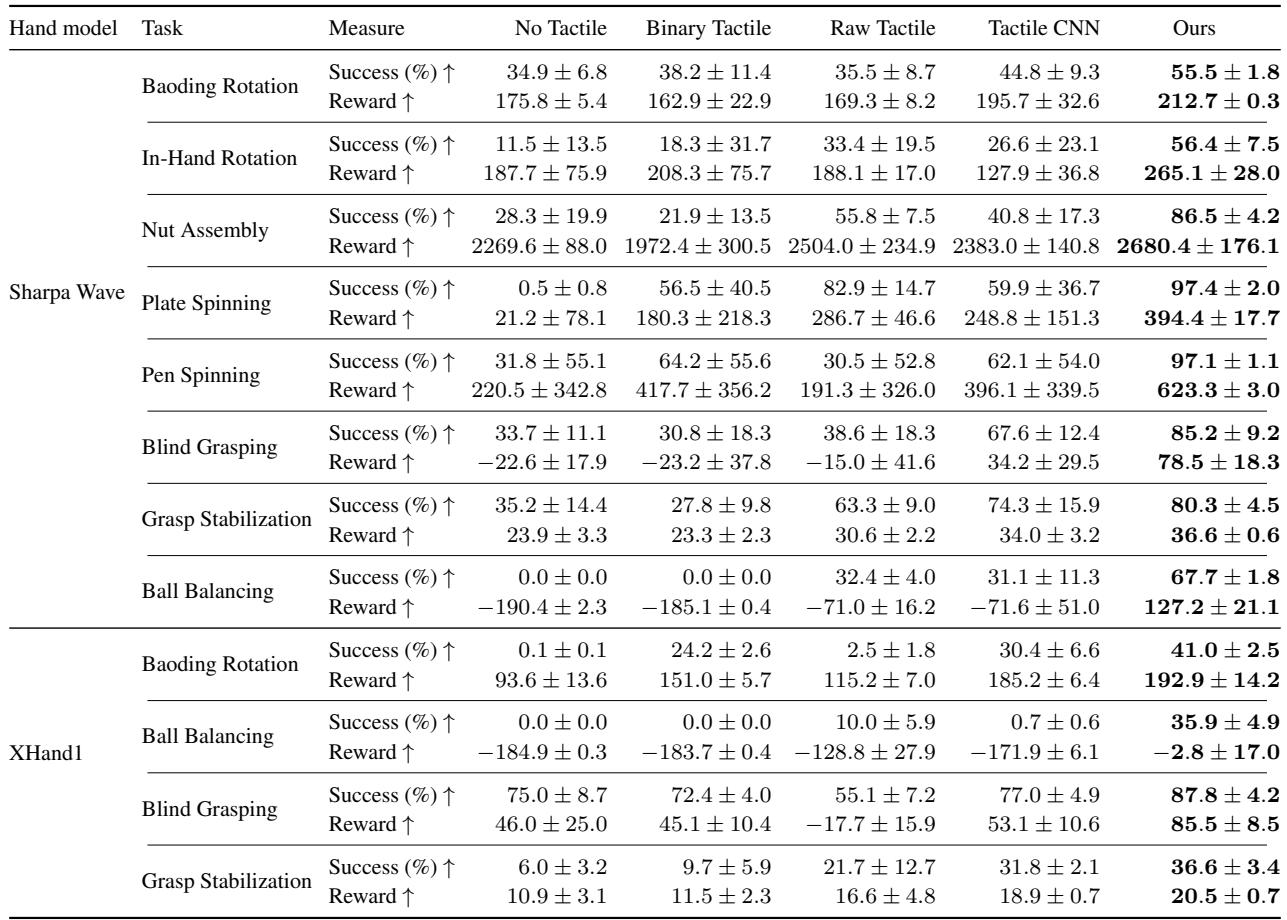
集成 LingBot-Touch 在仿真接触丰富操作任务中提高了成功率和奖励,在两种手模型上均优于无触觉、二值接触、原始信号和 CNN 基线。优势在接触持续变化的任务中最大,训练在随机种子间更稳定。冻结的预训练触觉表征似乎减轻了探索负担,并带来更快、更可靠的收敛,螺母组装是一个启动较慢的例外。LingBot-Touch 在所有评估任务中取得了最高的成功率和回报,明显超过学习的 CNN、原始信号、二值接触和无触觉基线。使用 LingBot-Touch 后训练稳定性显著提高,而其他方案在盘子和笔旋转等接触丰富任务上可能差异很大。最大收益出现在接触持续变化之处,反映了预训练触觉表征对动态操作的价值。
第一项消融实验验证了冻结触觉编码器的设计选择,表明降低空间掩码、使用全片段时间掩码以及数值加位置组合增强改善了大多数指标,而每个 token 包含两帧或四帧的 32 帧片段适合视觉触觉数据。在真实机器人基准上,冻结的 LingBot-Touch token 在各任务中一致地比原始触觉信号和原始策略提高成功率,并有效迁移到陌生的手,尽管收益并非均匀。仿真实验进一步证实,LingBot-Touch 优于无触觉、二值接触、原始信号和 CNN 基线,在接触持续变化的任务中收益最大,训练收敛更稳定。