Command Palette
Search for a command to run...
dNaViT:离散编码是通用视觉表征
dNaViT:离散编码是通用视觉表征
摘要
离散自回归建模,尤其是通过下一 token 预测,已成为现代语言模型的基石。将这一范式拓展至视觉,使视觉与语言模型得以汇聚于统一框架,从而促进方法学与基础设施的共享。本文研究了一个核心问题:有限的离散词汇表能够在多大程度上表示视觉世界的丰富性?我们提出了 dNaViT,一种离散原生分辨率 Vision Transformer,它生成类似于语言 token 的离散视觉基元。dNaViT 基于冻结的预训练编码器,采用轻量级残差调制与双分支目标,将重建感知线索注入语义特征。通过利用分组乘积量化,它能在不增加空间序列长度的情况下扩展离散容量,同时采用均衡的训练方案保持语义和像素级信息。因此,dNaViT 可作为一个通用的离散视觉 tokenizer,支持下游任务的统一编码和高保真图像解码。广泛评估表明,dNaViT 在 12 个视觉理解基准、4 个生成基准和 1 个图像编辑基准上达到或超越特定任务基线。这些发现表明,紧凑的离散词汇表可以作为通用视觉货币,并释放完全统一的原生多模态方法的全部潜力。
一句话总结
美团 LongCat 团队提出 dNaViT,一种离散原生分辨率 Vision Transformer,它结合冻结的预训练编码器、轻量残差调制和分组乘积量化,生成紧凑的离散视觉 token,用于统一编码和高保真解码,在 12 个视觉理解基准、4 个生成基准和 1 个图像编辑基准上达到或超过基线。
核心贡献
- dNaViT 被提出为一种原生分辨率离散视觉 tokenizer,构建在冻结的预训练编码器之上,应用具有双分支目标的轻量残差调制,以在共享词汇表内保留语义结构和细粒度像素信息。
- 该方法使用分组乘积量化来扩展离散容量而不增加空间序列长度,渐进式训练平衡语义重建和像素级重建;基于 code 条件的细化步骤进一步提升感知保真度,而不改变统一表示。
- 评估表明,dNaViT 在 12 个视觉理解基准、4 个生成基准和 1 个图像编辑基准上达到或超过任务特定基线,同时使用远少得多的训练数据预算。
引言
语言模型通过将文本视为离散 token 成功实现规模化,这些 token 作为表示学习和自回归建模的统一基础。相比之下,现代多模态系统通常使用模态特定的连续表示和异构目标,难以将语言模型技术和基础设施复用于视觉。关键挑战在于,将密集视觉信号离散化为有限词汇表会造成严重的信息瓶颈,先前方法难以在单一离散 code 中同时保留高层语义和细粒度像素细节。作者提出 dNaViT,一种离散原生分辨率 Vision Transformer,它基于冻结的预训练编码器,加入用于像素级细节的 Residual Modulator,并应用 Grouped Product Quantization 和渐进式双分支优化。该设计产生共享的离散视觉词汇表,以比现有模型更少的数据预算支持重建、分类、多模态理解、生成和编辑。
数据集
作者从多种图像来源构建 tokenization 和 de-tokenization 训练语料,分为三个互补的视觉内容类别:
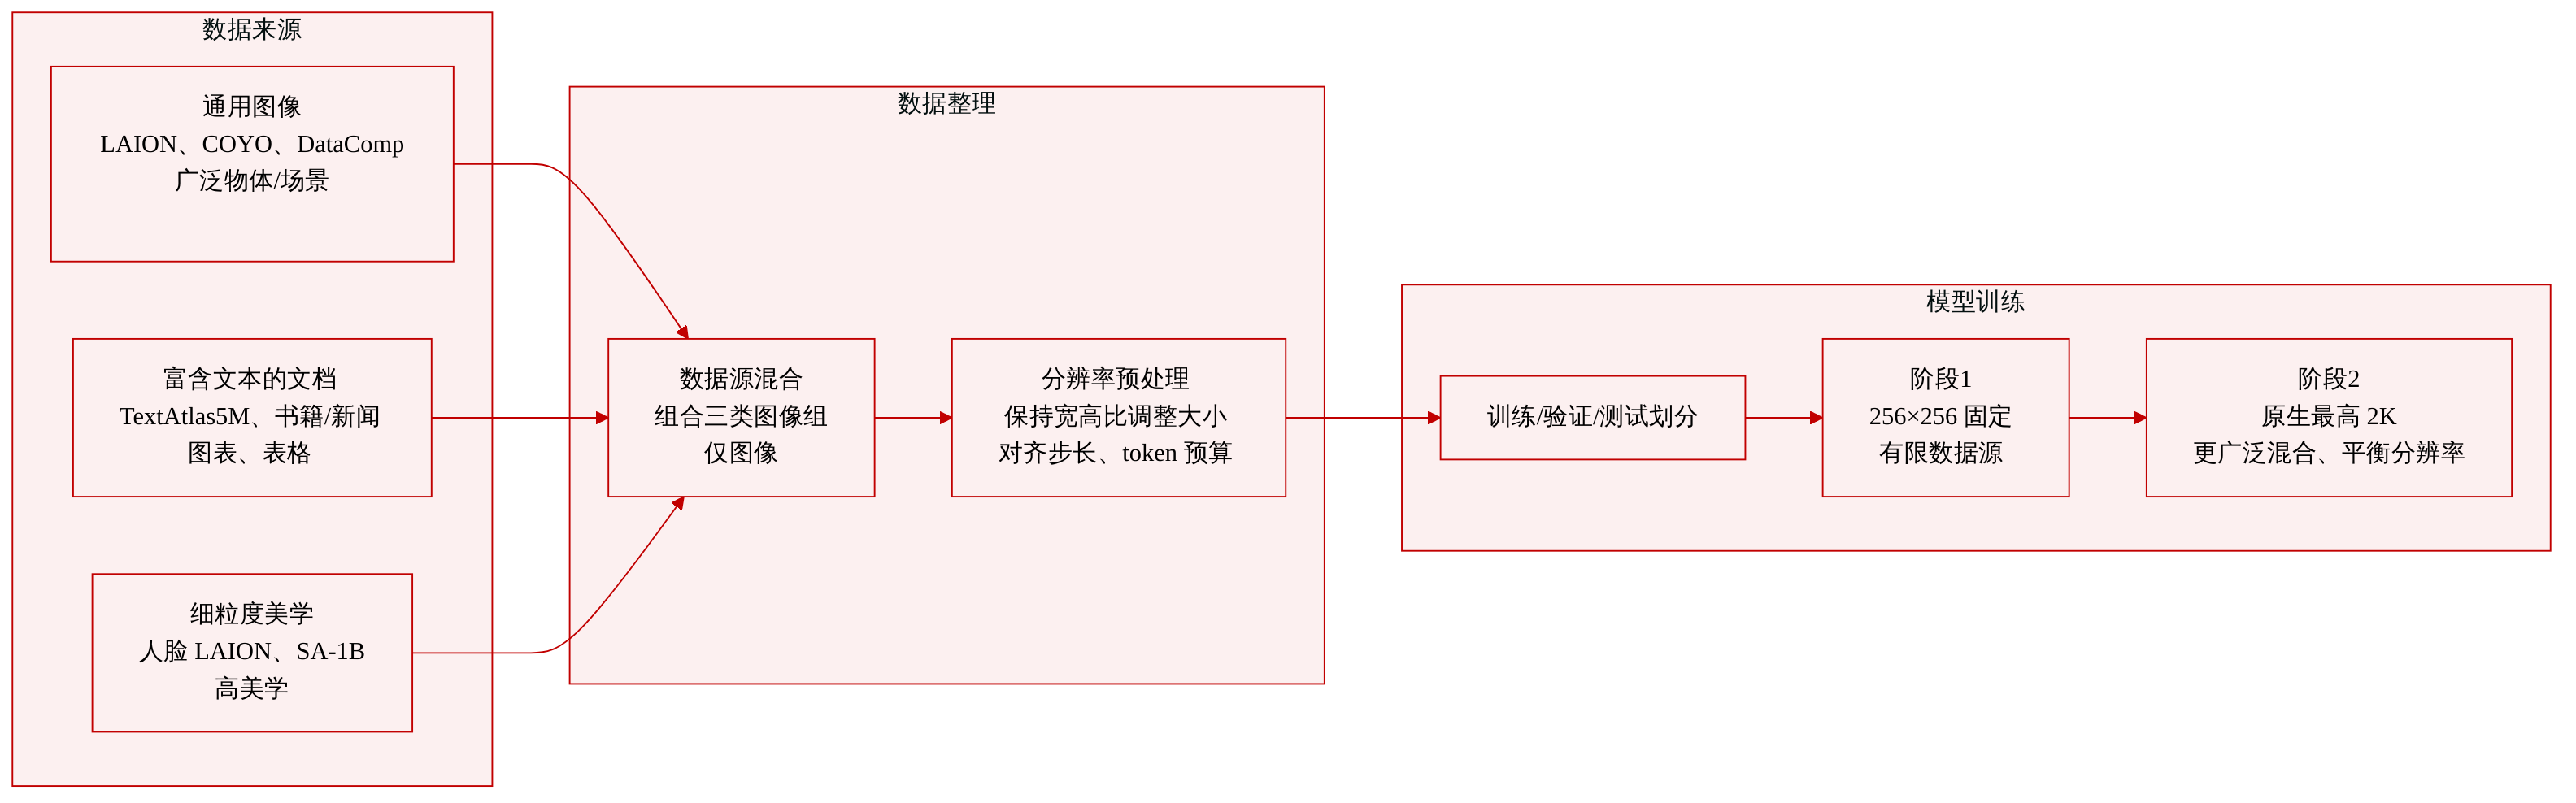
- 通用域图像: LAION、COYO、DataComp、Recap-DataComp-1B、CapsFusion 以及一个内部图像语料。这些数据提供对物体、场景和视觉风格的广泛覆盖。
- 富文本图像和文档: 选定的 TextAtlas5M 子集,包括书籍封面、长词图像、学术论文和演示幻灯片;中英文书籍/新闻页面;额外的面向 OCR 的集合;信息图集合;以及 ChartGalaxy。这些数据涵盖密集文本、小字符、复杂文档布局、图表和表格。
- 细粒度和高美学图像: 面向人脸的 LAION 子集、SA-1B 派生图像,以及内部高美学集合。这些数据增加精细的面部结构、局部纹理和多样的图像构图。
本节未报告每个子集的样本数量或显式过滤规则。数据仅使用图像,用于 tokenizer 训练并采用双分支监督。处理遵循分辨率课程:训练先在有限来源上以固定 256 × 256 分辨率开始,以便快速收敛,然后转换到更广泛数据混合上的原生分辨率训练,最高到 2K。转换期间,采样保持不同分辨率范围的均衡分布。图像被调整大小以近似保持宽高比、使空间维度与编码器步长对齐,并将序列长度保持在 token 预算内。所有阶段中,模型在数千亿 token 上训练。
方法
作者提出 dNaViT,一种视觉 tokenizer,旨在学习共享离散 code 作为多样下游任务的统一接口。该架构通过调和面向理解的表观不变性与面向重建的细节敏感性,取代分离的任务特定特征表示。为实现这一点,框架利用冻结的原生分辨率视觉编码器,并引入 Residual Modulator (ResMod) 来聚合互补线索。ResMod 融合来自多个编码器深度的中间特征,并学习对最终表示的空间变化校正。通过将残差更新初始化为零,预训练特征在训练开始时得以保留,使模块能够逐步重加权语义基础并注入与重建相关的细节。
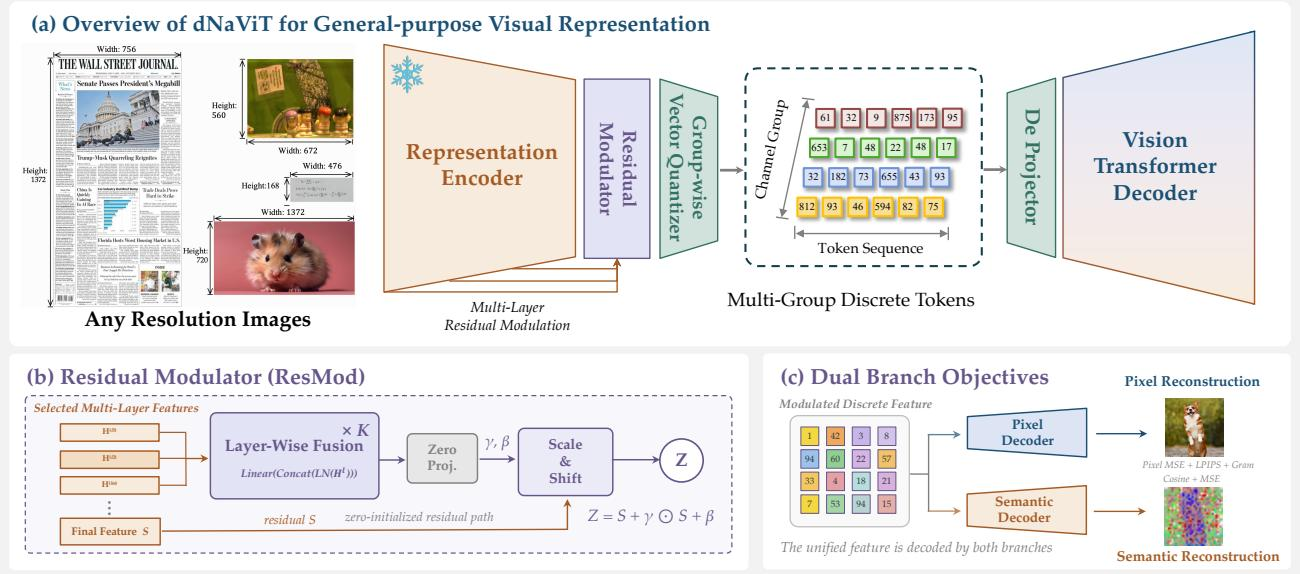
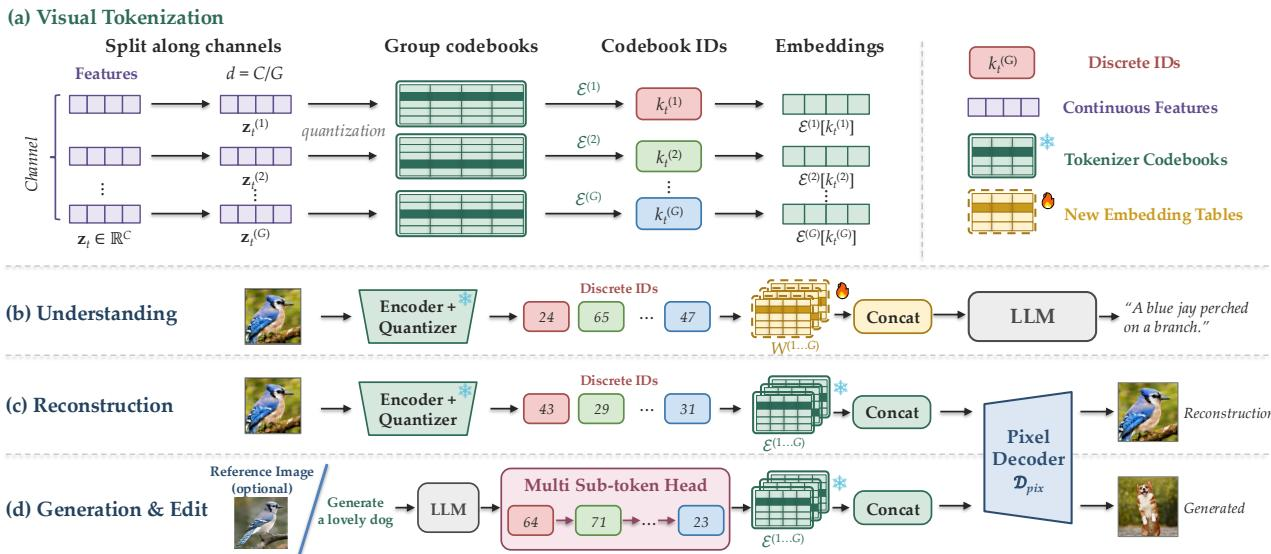
为了在共享离散瓶颈中保留暴露的语义区分和空间细节,增强特征通过分组乘积量化器处理。作者没有使用大到不可行的单一词汇表,而是沿通道维度将特征分解为 G 个不相交的组。每个组分配自己的可学习 codebook,量化在每个组内选择最近的条目。所得的离散索引元组被拼接以形成最终 codebook 嵌入。这种方法将量化容量以组合方式扩展到 KG 个组合,而无需显式存储庞大词汇表,同时保持空间 token 网格不变,以支持不同图像分辨率下的可变长度网格。
共享离散 code 通过两个专用解码器进行监督。语义分支使用余弦对齐和均方误差损失的组合将 code 与连续视觉特征对齐,确保保留预训练语义结构。像素分支通过 token 解合并和空间扩展将嵌入解码为像素,并使用包括 L1、MSE、LPIPS、感知损失和 Gram 矩阵目标在内的复合损失进行优化。两个分支共同约束共享词汇表,以同时保留高层语义和细粒度视觉保真度。
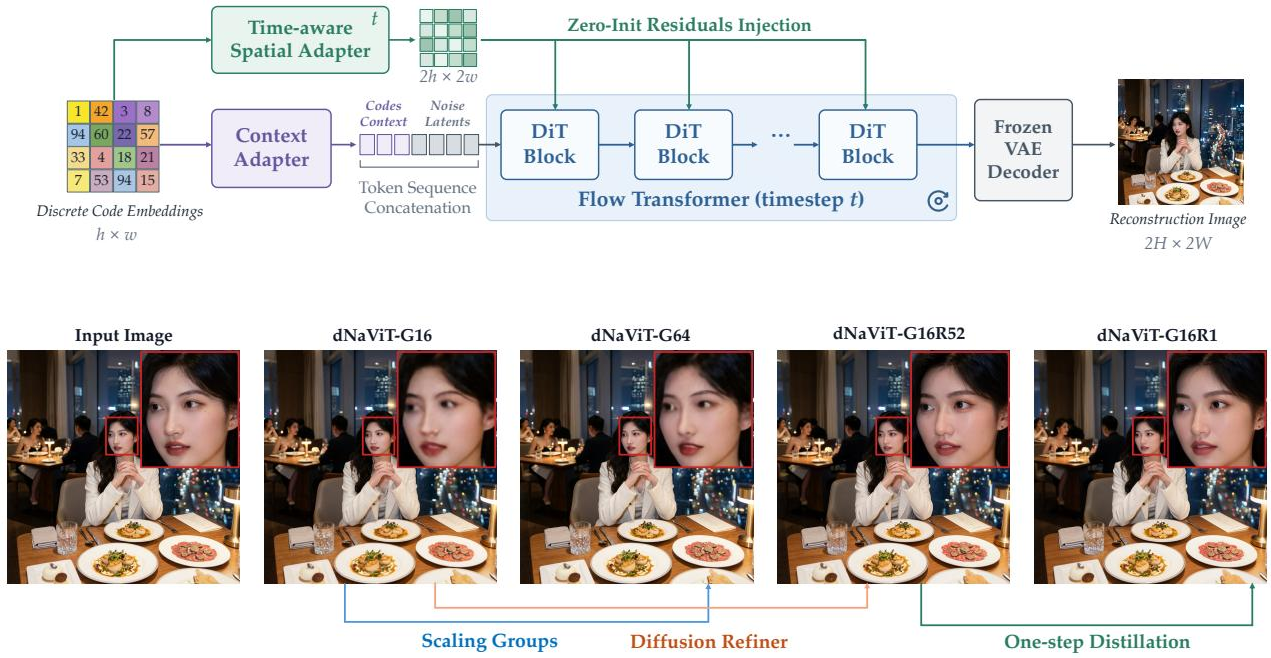
为进一步提升感知质量,作者引入以 code 为条件的 Refiner。与常规超分辨率模型不同,该模块直接以离散视觉 code 为条件控制流解码器,避免中间像素解码造成的信息损失。Refiner 使用上下文适配器获取全局场景级上下文,并使用时间条件空间适配器将对齐残差注入潜在输入。多步教师模型通过 flow matching 训练,随后使用对抗监督蒸馏为高效的一步学生模型。
优化策略将互补视觉细节的学习与增强表示向离散瓶颈的适应分开。训练分为三个不同阶段,以缓解目标之间的干扰。在第一阶段,即连续像素预训练中,训练 ResMod 和像素解码器来恢复原始视觉信号,同时视觉编码器保持冻结。这初始化残差通路,以暴露与重建相关的信息。
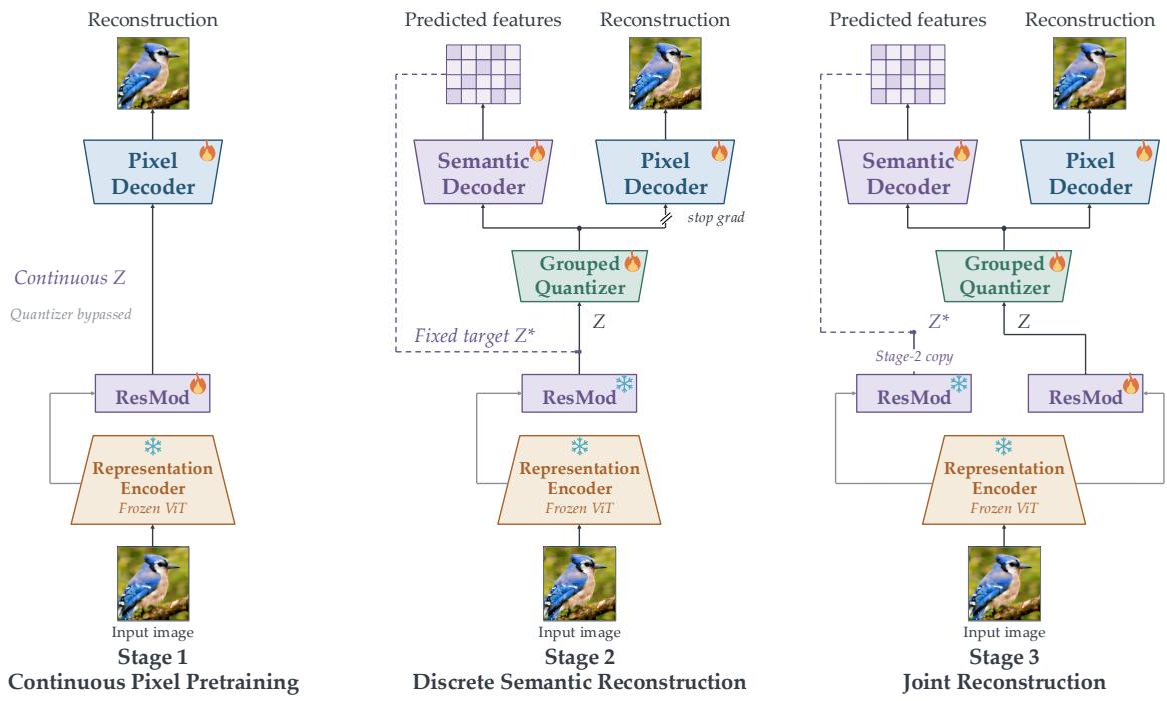
在第二阶段,即离散语义重建中,视觉编码器和 ResMod 均被冻结。训练量化器和语义解码器来重建细节增强表示,同时像素解码器在停止梯度的 code 上训练,以建立从离散 code 到像素的初始映射,而不干扰语义学习。最后,在联合重建阶段,编码 ResMod 解冻,并与冻结的教师副本一起训练,以防止目标漂移。语义分支从教师重建固定目标,而像素分支允许梯度回传以更新量化器和学生 ResMod,共同细化用于语义和像素重建的离散表示。
实验
评估涵盖重建、冻结特征分类、多模态理解、文本到图像生成和指令引导编辑,并对 ResMod、离散表示与连续表示以及像素解码进行额外分析。重建和分类结果表明,共享离散 code 保留了全局保真度、细粒度文本和人脸细节以及可线性读取的语义信息,但小文本仍然具有挑战性,迁移性能因分布而异。多模态和生成实验表明,离散视觉 token 可以支持有竞争力的推理、OCR、文档和图表理解、组合生成和编辑。分析进一步表明,ResMod 在添加像素细节的同时保持语义质量,基于 flow 的 refiner 比直接像素解码更有效地恢复高频信息,定性示例展示了细粒度识别和推理。
在固定评估协议下,dNaViT 的重建质量随分辨率提高,64 组变体在 1024x1024 下取得比 16 组变体更高的 PSNR 和 SSIM。这表明共享离散表示在不同分辨率下保留了与重建相关的信息,但训练差异使得无法单独考察量化组数的影响。连续基线在来源特定协议下报告,不可直接比较。随着分辨率从 256x256 提升到 512x512 再到 1024x1024,dNaViT-G64 在 PSNR 和 SSIM 上持续提升。在 1024x1024 下,dNaViT-G64 在两个重建指标上均高于 dNaViT-G16,但两个变体之间的训练配置和时长不同。
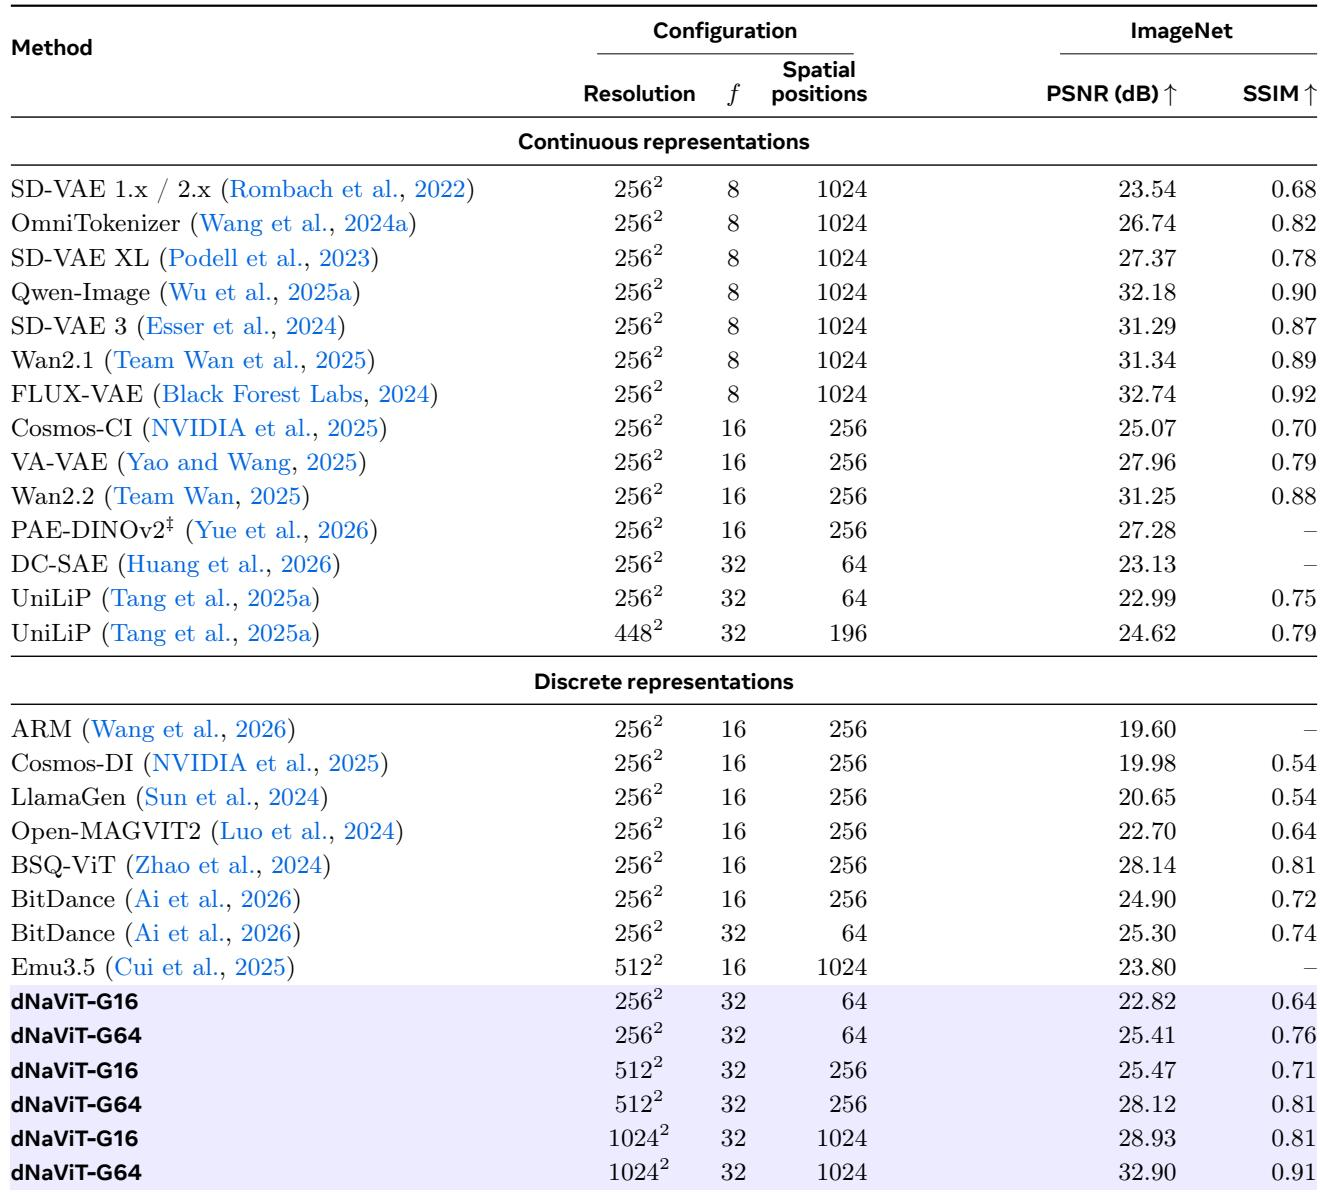
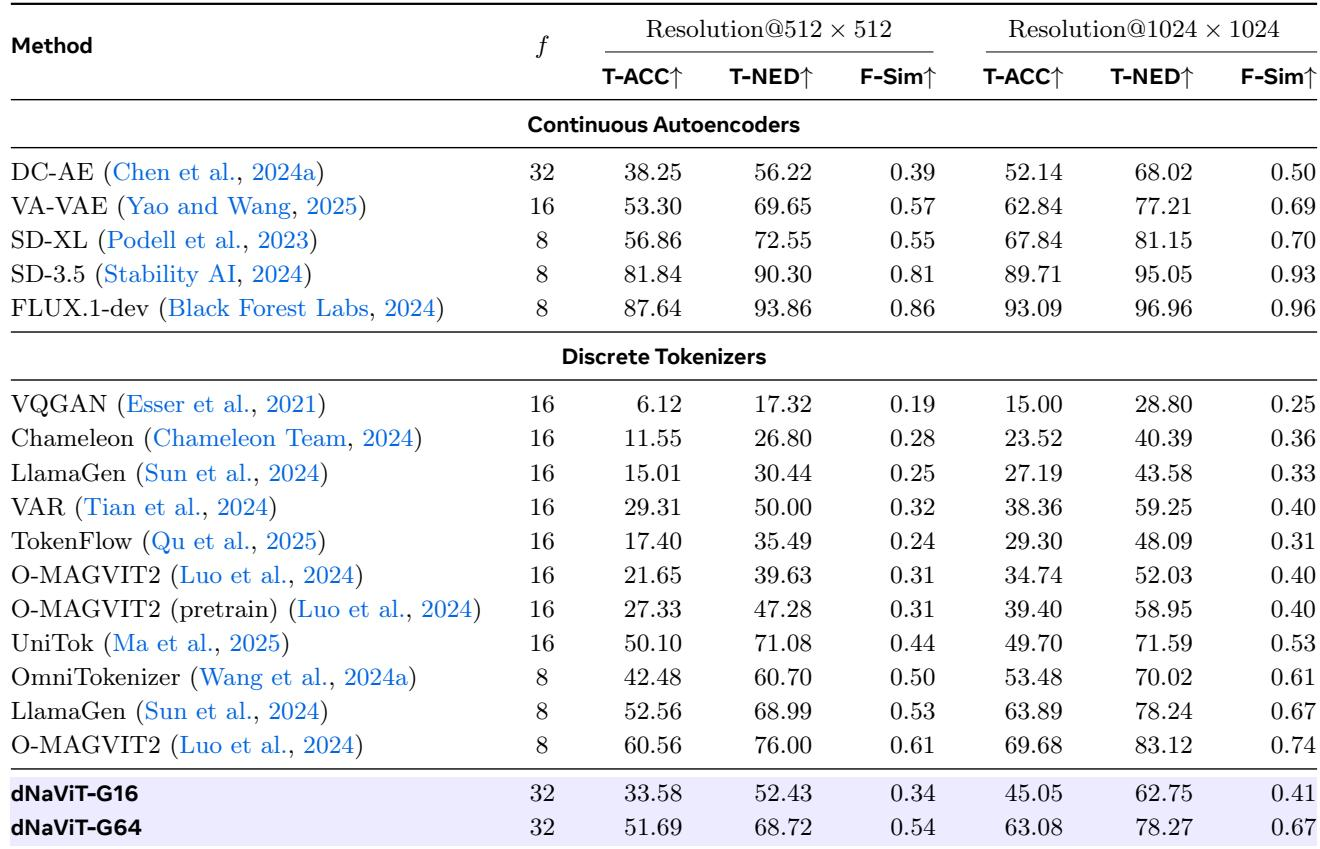
在 TokBench 上,dNaViT-G64 在 512×512 和 1024×1024 两种分辨率下,文本准确率、文本相似度和人脸相似度上的细粒度重建结果均高于 DC-AE-f32,并与 LlamaGen-f8 相当。所有评估方法在分辨率从 512 提升到 1024 时均有改善。更强的连续模型如 SD-3.5 和 FLUX.1-dev 仍然领先,小文本方面仍存在性能差距。在这两种评估分辨率下,dNaViT-G64 在所有三个细粒度指标上均高于 DC-AE-f32。所列连续基线在文本准确率、文本相似度和人脸相似度上从 512×512 到 1024×1024 一致改善。FLUX.1-dev 在所列连续基线中取得最高的细粒度重建分数,其次是 SD-3.5。
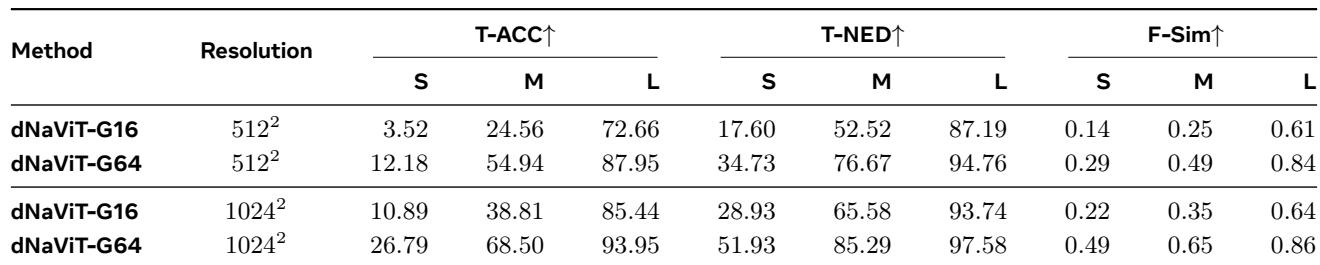
在两种测试分辨率下,dNaViT-G64 在小、中、大 TokBench 实例桶上均一致优于 dNaViT-G16。小、中实例的提升最大,大实例的提升较温和。小实例仍然是最具挑战性的类别,即使对于更强的变体,其文本识别、编辑相似度和人脸相似度也低于更大实例。dNaViT-G64 在两种分辨率下所有实例大小和指标上均优于 dNaViT-G16。相对提升在小、中桶中最明显,大桶的提升较小。小实例仍然是最弱类别,文本相关指标的性能差距最大。
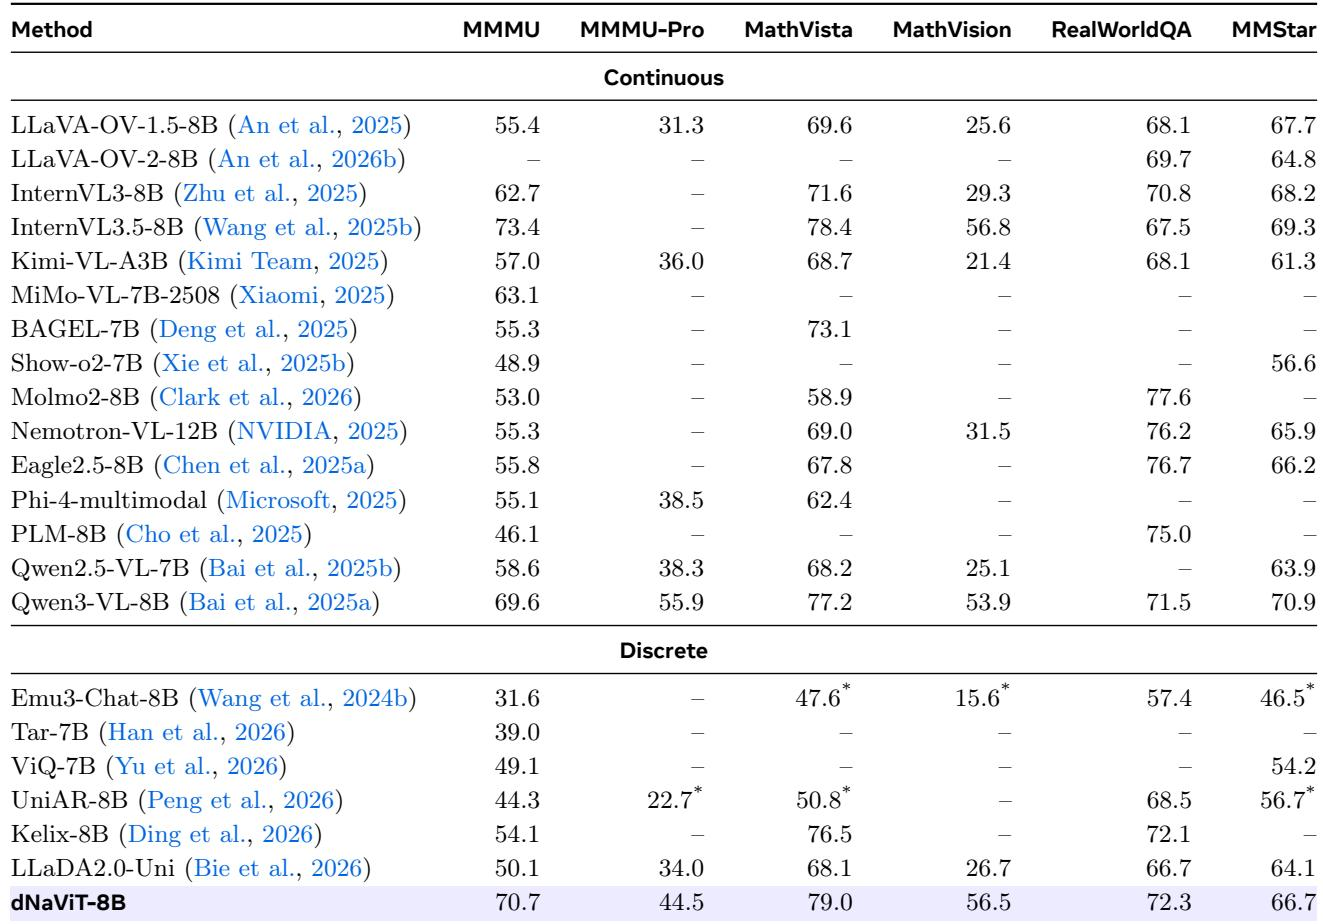
在所列出连续视觉语言模型中,InternVL3.5-8B 在 MMMU、MathVista、MathVision 和 MMStar 上取得最强可用结果,尤其在 MathVision 上优势更大。大多数评估模型的 RealWorldQA 分数非常接近,而 LLaVA-OV-2-8B 和 MiMo-VL-7B-2508 的基准覆盖不完整。随附分析指出,模型级比较在训练数据、提示和评分上存在差异,并表明在训练数据充足时离散视觉表示可以匹配连续特征。InternVL3.5-8B 在大多数 STEM 和通用理解基准上领先所列连续模型,其中 MathVision 差距最大。根据随附分析,随着训练数据规模增加,离散视觉表示在多模态理解中可以匹配连续特征。
冻结视觉表示通过 ImageNet-1K 上的线性探测和五个分布偏移基准上的直接迁移进行评估。连续 dNaViT 在所有报告的基准上与 QwenViT 非常接近,而离散 dNaViT 在 ImageNet-1K 上仅略低于其连续形式,并在所评估的离散表示中领先。连续 dNaViT 在 ImageNet-1K 和所有五个分布偏移基准上与 QwenViT 表现相当。离散 dNaViT 在 ImageNet-1K 上落后其连续形式不到一个百分点,并且是所评估离散表示中最强的。
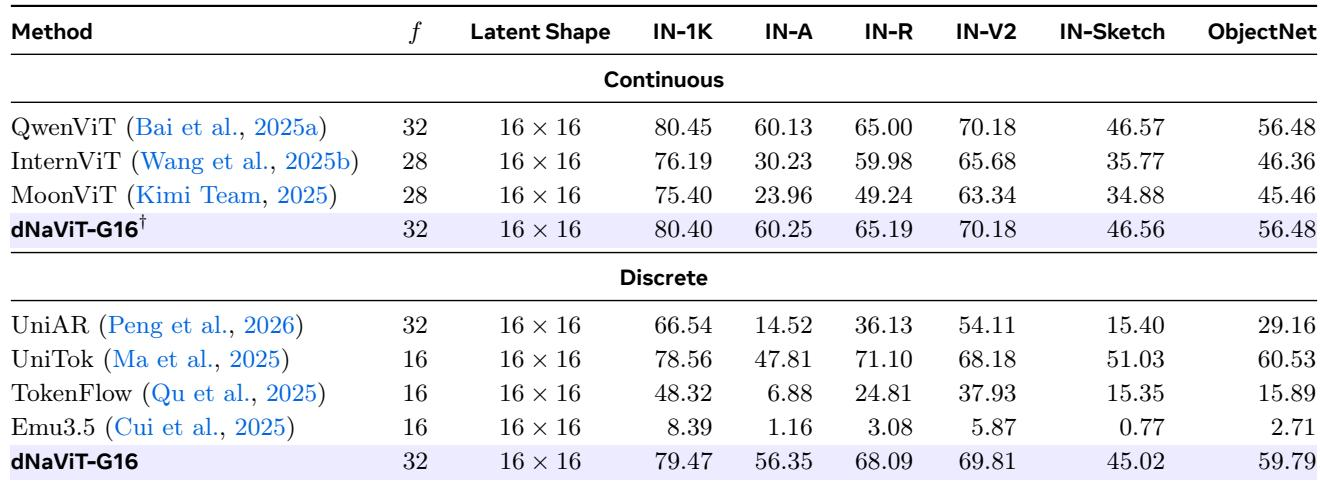
实验评估了 dNaViT 的离散和连续表示在重建质量、细粒度 TokBench 指标、多模态理解和冻结特征迁移上的表现。重建质量随分辨率提高,64 组离散变体一致优于 16 组变体,尤其是在小型和中型文本实例上,但在细粒度文本方面仍落后于 FLUX.1-dev 和 SD-3.5 等强连续基线。在多模态和迁移基准中,随着训练数据规模增加,离散表示接近连续特征,连续 dNaViT 与 QwenViT 相当,离散 dNaViT 在评估的离散模型中领先。