Command Palette
Search for a command to run...
MIRIX-2.0:多智能体记忆系统
MIRIX-2.0:多智能体记忆系统
Wei-Chieh Huang Weizhi Zhang Jiayan Nan Peng Xia Yu Wang
摘要
长期记忆使 LLM 智能体能够实现个性化、保持一致性并复用既往有效经验。参数化记忆需要训练,记忆巩固可能永久丢失细节,而保留全部记录则会导致待检索的存储规模持续增长。我们提出 MIRIX-2.0,一个旨在同时兼顾实用性、准确性与效率的多智能体记忆系统。在五个问答基准中的四个上,它是所比较系统中准确率最高的。它在 LoCoMo 上达到 91.4%,在 LongMemEval-S 上达到 72.6%,领先最强基线 14.3 个百分点;在禁用 AutoDream 的情况下,它在单跳和多跳文档问答上分别比 HyperMem 高出 31.0 和 22.0 个百分点。作为程序性记忆,它在 ALFWorld 和 WebShop 上取得了所比较记忆方法中最高的平均成功率,并在 MetaClaw-Bench 上达到 49.2%,而 MetaClaw 技能库为 44.0%。六个类型化记忆智能体作为记录系统保存完整记录,一个溯源超图以引用其数据行的 n 元框架为情节性记录和语义性记录建立索引。检索在显式预算下运行,因此问题所考察的证据不会随历史增长而增加。AutoDream 在写入路径之外合并重复锚点而不重写任何记录,并将任务会话蒸馏为技能。在禁用 AutoDream 的情况下,MIRIX-2.0 在全部五个计时基准上的回答速度均快于 HyperMem。它无需微调,可与闭源和开源模型配合运行,且代码已公开。
一句话总结
MIRIX AI 研究人员提出 MIRIX-2.0,一个实用的 multi-agent 记忆系统,其六个类型化 agents、具有 n 元帧的溯源超图、预算化检索和 AutoDream 整合在 LoCoMo 上达到 91.4%,在 LongMemEval-S 上达到 72.6%,领先最强基线 14.3 个百分点;在 ALFWorld 和 WebShop 上取得所比较记忆方法中最高的平均成功率;在 MetaClaw-Bench 上达到 49.2%,所有这一切都无需微调。
核心贡献
- MIRIX-2.0 是一个 multi-agent 记忆系统,其中六个类型化 memory agents 将完整记录作为记录系统;溯源超图用 n 元帧为情景记忆和语义记忆记录建立索引,并引用其源行;检索在显式预算下运行,因此问题所检查的证据不会随历史增长。
- AutoDream 在写入路径之外整合记忆:合并重复锚点而不重写任何记录,并将任务会话蒸馏为程序性技能。
- MIRIX-2.0 在五个问答基准中的四个上在所比较系统中准确率最高,在 LoCoMo 上达到 91.4%,在 LongMemEval-S 上达到 72.6%,并在 LongMemEval-S 上领先最强基线 14.3 个百分点。其程序性记忆在 ALFWorld 和 WebShop 上取得最高的平均成功率,并在 MetaClaw-Bench 上达到 49.2%;在禁用 AutoDream 时,它在全部五个计时基准上回答速度快于 HyperMem。
引言
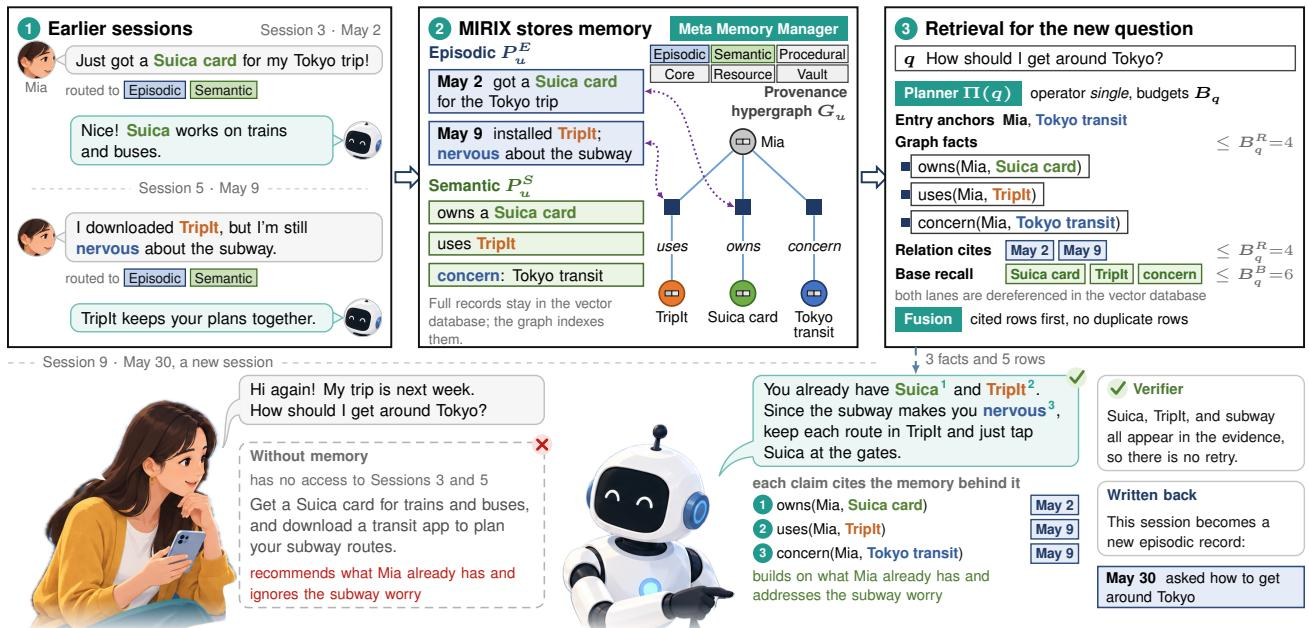
大语言模型 agents 现在跨长会话运行,因此记忆系统必须保留细节,以支持个性化、一致性和重用。先前方法往往在相互冲突的需求之间权衡:基于整合的记忆紧凑但会丢弃细节;检索一切的记忆变得昂贵且有噪声;图记忆和超图记忆常常削弱 n 元关系或依赖自顶向下的摘要;参数化记忆需要训练并排除闭源模型。作者提出 MIRIX-2.0,一个 multi-agent 记忆系统,将完整的类型化记录作为记录系统,并仅将溯源超图用作有界索引;具有确定性检索预算和离线整合,可合并重复锚点或蒸馏技能,而无需重写已存储的证据。
方法
作者设计 MIRIX-2.0,将存储与索引分离,以确保可实际部署、高准确率和有界效率。系统在两个不同层上运行。类型化证据平面存储完整记忆,并作为不可变的记录系统。溯源超图为这些记忆中的实体、事件、关系、角色和时间建立索引,每个事实都明确引用其源记录。三条不同路径在这些层上运行,分别处理记忆形成、检索和整合。
如下图所示:
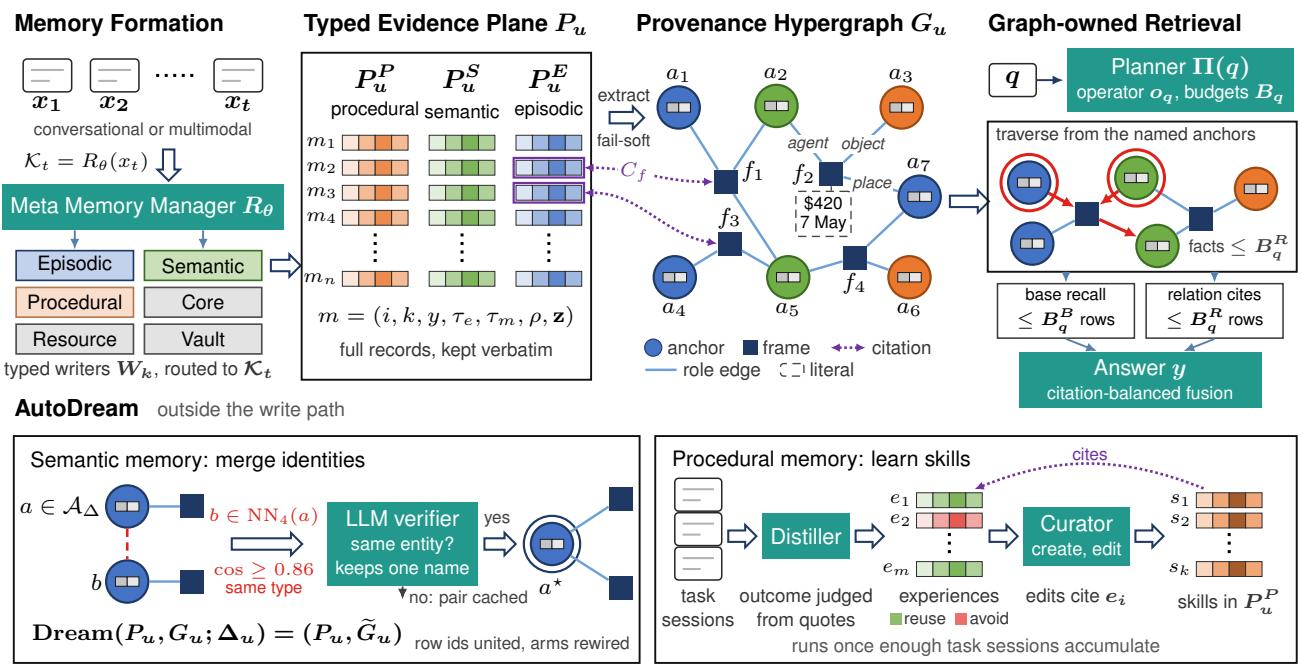
写入路径从 Meta Memory Manager 开始,它将每个对话或多模态输入路由到一部分记忆类型,包括 Core、Episodic、Semantic、Procedural、Resource 和 Knowledge Vault。每种类型都有一个专用 writer,生成结构化记录。证据记录形式化表示为:
m=(i,k,y,τe,τm,ρ,z)其中 i 是不可变行标识符,k 是记忆类型,y 是存储文本,τe 和 τm 是事件时间和提及时间,ρ 记录来源溯源,z 保存搜索嵌入。系统在开始图构建之前将记录提交到向量数据库,确保图写入失败绝不会回滚已存储的记忆。
写入路径的后半部分将情景记忆和语义记忆记录转换为图结构。对于每个用户,系统维护一个超图,定义如下:
Gu=(Au,Fu,Eu)该结构由实体锚点 Au、具体化事实帧 Fu 和角色类型化关联边 Eu 组成。锚点存储规范名称、实体类型、名称嵌入以及提及它的情景记忆行和语义记忆行的标识符。为解决实体身份,系统使用注册表引导的规范化:先通过近似最近邻搜索检索现有锚点,再由语言模型做出保守的同实体判断。
对于每条记录,提取器生成 n 元帧:
f=(p,{(rj,aj)}j=1df,ℓf,τe,τm,Cf)其中 p 是规范谓词,rj 是锚点 aj 的开放词汇角色,ℓf 将字面属性映射到其值,Cf 是被引用向量数据库记录的集合。语义记忆和情景记忆的帧身份规则不同。语义帧由用户、谓词及排序后的角色-锚点键的哈希来标识,这使得同一持久声明被重复支持时可以累积引用。情景帧则增加一个发生键,确保不同事件不会仅因措辞相似而被合并。
读取路径将检索视为构建有界证据集,而不是开放式相似性搜索。情景记忆和语义记忆候选必须通过图进入,向量数据库仅解引用由图遍历选出的标识符。
参见框架图:
确定性 planner 将查询映射为结构化计划:
Π(q)=(oq,Pq,Cq,Yq,Tq,BqB,BqR)其中 oq 是查询操作符,Pq 保存关系族,Cq 保存非关系约束,Yq 保存期望答案类型,Tq 保存时间约束,BqB 和 BqR 分别限制基础召回行数和关系引用行数。查询嵌入按名称召回锚点,选中的锚点打开两条有界证据通道。基础召回通道产生与锚点直接关联的标识符,而关系引用通道在关联帧上启动索引化邻接查找。关系通道中的每个帧获得一个加性事实分数,评估关系、实体、约束、类型、时间和角色兼容性。最后,引用平衡融合对两条通道中的行重新排序,答题时验证步骤根据证据账本核对草拟答案。
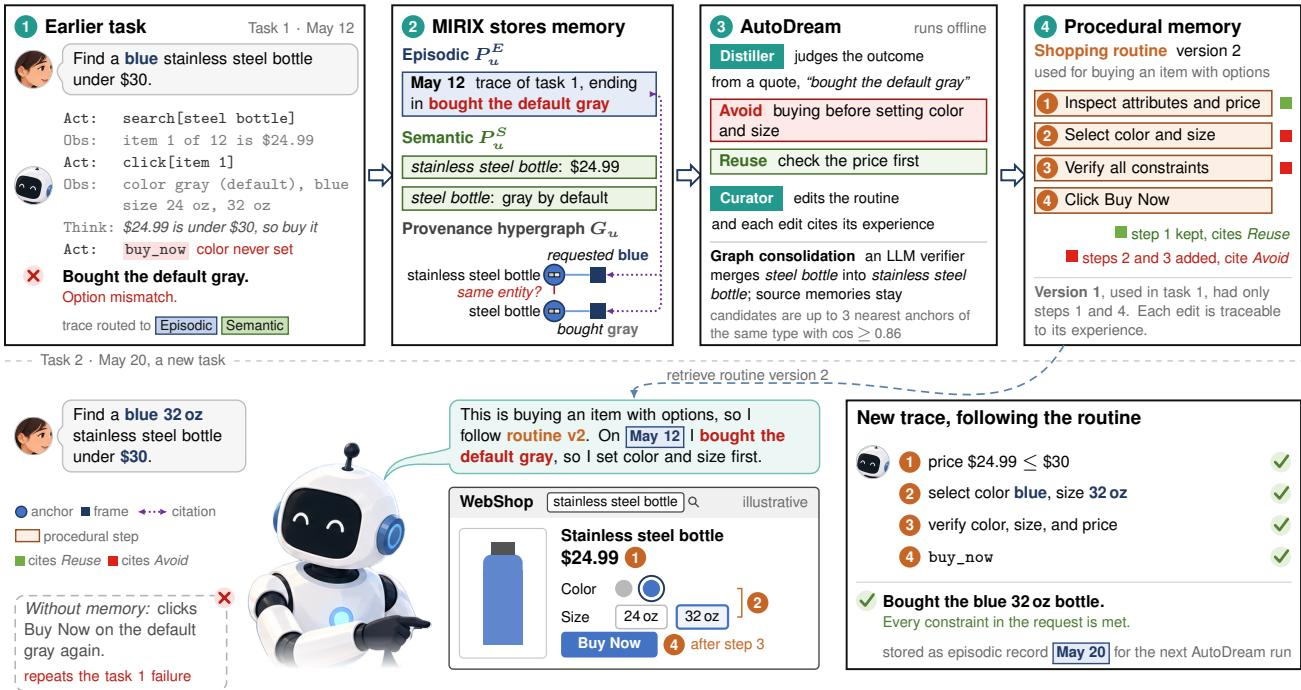
第三条路径 AutoDream 在关键写入路径之外运行,在不改变底层证据存储的情况下整合记忆。它以相反方式处理语义记忆和程序性记忆。
如下图所示:
对于语义记忆,AutoDream 在以下约束下细化身份:
Dream(Pu,Gu;Δu)=(Pu,G~u)其中 Δu 是新写入的语义前沿。系统基于嵌入相似度和类型匹配生成候选锚点对,并由语言模型验证它们是否表示同一实体。确认合并后,系统会合并行标识符、累加提及次数并重新连接角色类型化帧臂,同时原始证据记录完全不变。
对于程序性记忆,AutoDream 将任务会话蒸馏为可复用技能。distiller 根据会话引用中的原文判断待处理会话的结果,将经验标记为可复用的经验教训或应避免的错误。curator 随后将这些经验转化为程序性存储中的技能。curator 可以创建、编辑或删除技能,任何编辑都必须引用其背后的具体经验。这确保技能中被引用的步骤可以通过其经验追溯到原始引用会话,在优化 agent 操作策略的同时保持严格的来源保真度。
实验
评估将 MIRIX-2.0 变体(flat M0、graph-only M1 和 full M2)在用户记忆任务(对话召回、文档问答和个性化生成)以及 agent 记忆任务(包括 ALFWorld、WebShop 和 MetaClaw-Bench)上进行比较。图索引和 AutoDream 一致地改善对话召回,尤其是多跳和时间问题;MIRIX-2.0 在大多数文档问答和个性化基准上领先,但在 DetectiveQA 上落后于基线。对于 agent 记忆,学习到的程序提高了留出交互任务的成功率,并在多个 backbone 上改善了 MetaClaw-Bench 分数,但提升因任务类型和 backbone 而异,检索到的程序有时会产生干扰。效率结果显示,使用图索引时回答速度快于 HyperMem,但摄入速度慢于 flat memory;程序性记忆可以减少步骤,但未必可靠降低 token 成本。
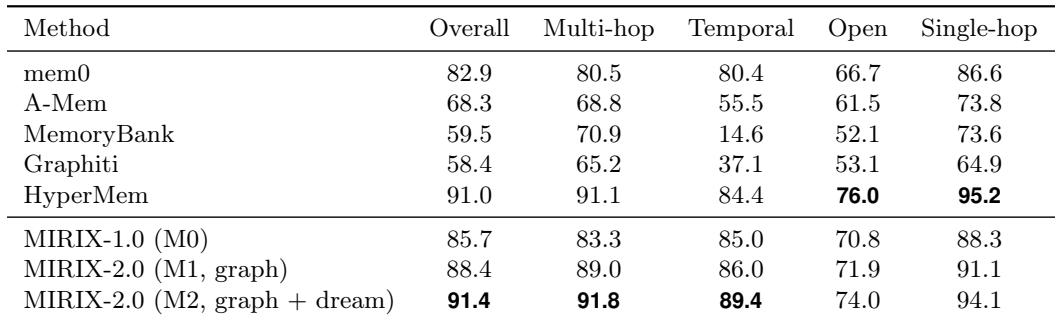
LoCoMo 结果显示系统变体的一致排序:flat vector memory 得分最低,图检索提高整体准确率,语义 AutoDream 产生最强配置。改进因问题类型而异;图检索对多跳问题帮助最大,而 AutoDream 在包括时间召回在内的多个类别上带来增益。完整配置在整体以及时间召回和多跳召回上领先,而 HyperMem 在开放域和单跳问题上仍然更强。在 LoCoMo 整体准确率上,flat vector memory、图检索以及图加 AutoDream 配置按递增顺序排列。图检索在多跳问题上贡献最大收益,而语义 AutoDream 在包括时间召回在内的多个类别上带来进一步增益。完整系统在整体上超过 HyperMem,其优势集中在时间召回和多跳召回上,而 HyperMem 保持更高的开放域和单跳分数。在外部基线中,HyperMem 最强,其他若干基线在时间问题上表现尤其差。
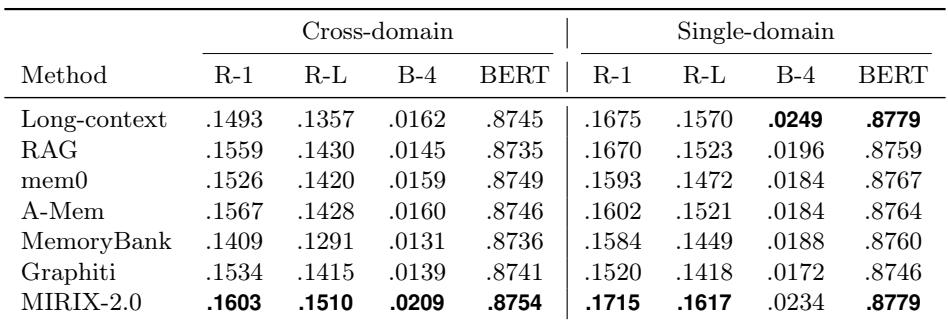
在 MemoryCD 评论摘要上,没有单一方法在所有指标上领先。Long-context 在单域评估中表现最好,并且在跨域 BLEU-4 上领先;跨域 ROUGE-1、ROUGE-L 和 BERTScore 在 A-Mem、RAG 和 mem0 之间分布,差异很小。MemoryBank 和 Graphiti 通常较弱,Graphiti 在所有单域指标上最低。Long-context 在所有单域指标上排名第一:ROUGE-1、ROUGE-L、BLEU-4 和 BERTScore。跨域表现更加混杂:A-Mem 在 ROUGE-1 上领先,RAG 在 ROUGE-L 上领先,Long-context 在 BLEU-4 上领先,mem0 在 BERTScore 上领先。
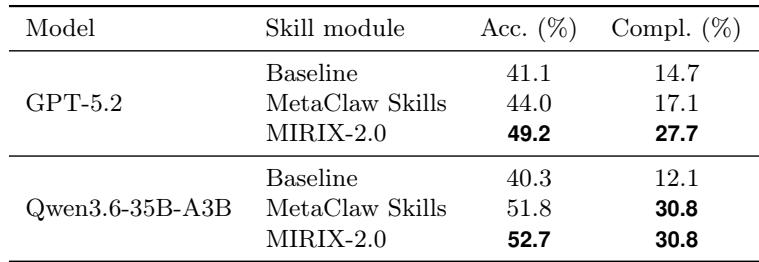
在 MetaClaw-Bench Part I 上,对两个测试 backbone,agent 记忆相比无记忆基线提高了准确率和完成度。MIRIX-2.0 在两个 backbone 上都取得了最高准确率,而完成度提升在 GPT-5.2 上与 MIRIX-2.0 配时最大。仅 MetaClaw Skills 就已经占 Qwen3.6-35B-A3B 上增益的很大一部分。MIRIX-2.0 在两个 backbone 上准确率领先,将 GPT-5.2 从百分之四十出头提升到略低于百分之五十,将 Qwen3.6-35B-A3B 从百分之四十出头提升到略高于百分之五十。完成度在 GPT-5.2 上使用 MIRIX-2.0 时提升最明显,而 Qwen3.6-35B-A3B 在 MetaClaw Skills 和 MIRIX-2.0 下达到相同的完成度水平。
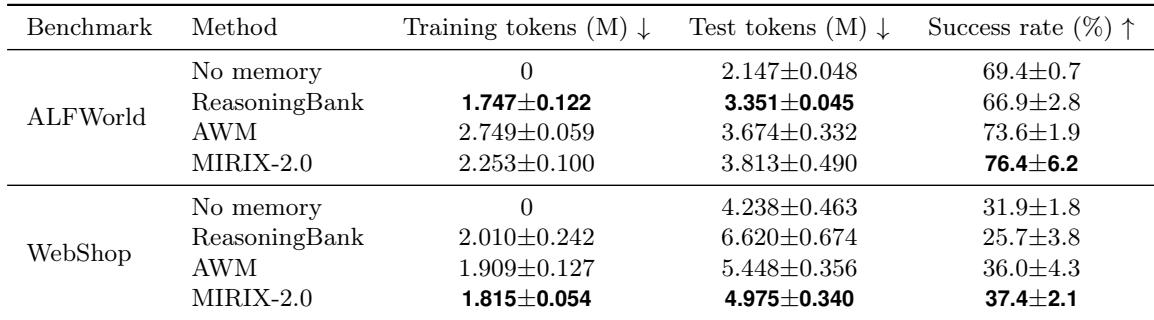
在 ALFWorld 和 WebShop 上,与无记忆相比,程序性记忆方法增加了测试 token 使用量。在 WebShop 上,MIRIX-2.0 在记忆方法中使用最少的训练和测试 token,同时取得最高的平均成功率。在 ALFWorld 上,尽管 MIRIX-2.0 的平均步骤数更低,但它在记忆方法中的测试 token 使用量最高。在 WebShop 上,MIRIX-2.0 在记忆方法中拥有最低的训练和测试 token 使用量以及最高的平均成功率。在 ALFWorld 上,MIRIX-2.0 使用的测试 token 比任何其他记忆方法都多,尽管平均交互步骤更少。与无记忆相比,ALFWorld 和 WebShop 上的测试 token 使用量都上升,因此程序性记忆并不会自动降低 token 成本。
在四项评估中,记忆组件分别在长文本记忆问答(LoCoMo)、评论摘要(MemoryCD)、agent 任务执行(MetaClaw-Bench)和交互式决策(ALFWorld/WebShop)上接受评估。实验验证了图检索和语义整合能提高 LoCoMo 准确率,尤其是时间问题和多跳问题;而 MemoryCD 摘要没有单一方法占优,long-context 在单域评估中最强。Agent 记忆可靠地提高了任务准确率和完成度,MIRIX-2.0 在大多数设置中领先,但程序性记忆增加 token 使用量而不是降低成本。