Command Palette
Search for a command to run...
DexForesight:用隐式空间前瞻为灵巧操作策略奠定基础
DexForesight:用隐式空间前瞻为灵巧操作策略奠定基础
Zhongxi Chen Yi Yang Xinyi Chen Mingzhe Ye Yaping Li Zhihong Liu Congsheng Xu Haonan Wang Zhijie Deng
摘要
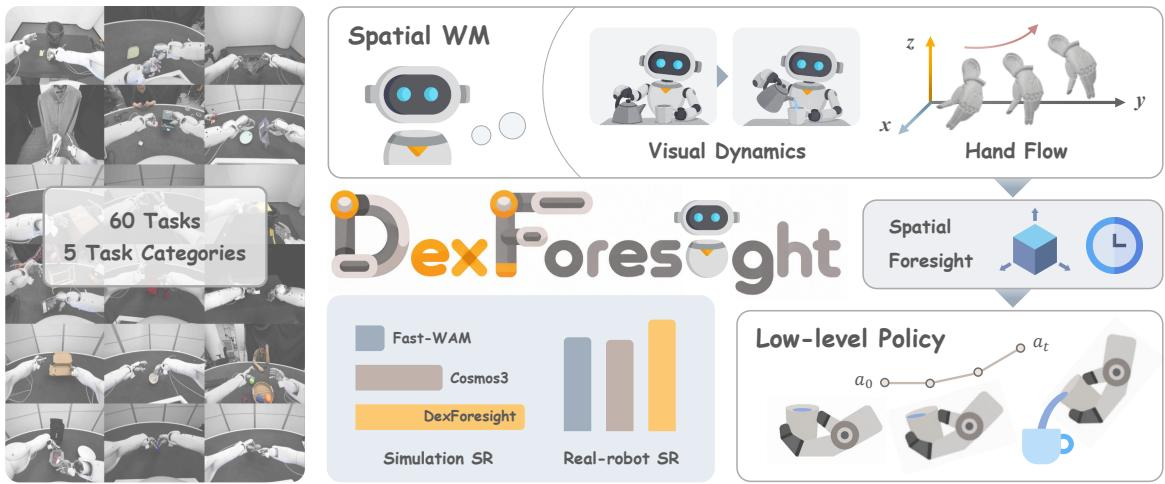
灵巧操作需要对周围场景与机器人手部均具备丰富的空间前瞻能力。现有的世界-动作模型通常通过显式的未来预测来获取此类预测性知识。我们提出了 DexForesight,一个通过将动态感知的世界表征注入灵巧操作策略的潜在空间来隐式学习空间前瞻能力的框架。在训练阶段,DexForesight 从离线场景深度、运动学手部几何信息和演示轨迹中学习动作条件化的空间世界模型。该世界模型预测 3D 手部点运动和视觉特征变化,捕获在演示动作下的关节式手部动力学与场景变化,包括被摄像头遮挡的手指运动。随后,我们冻结该世界模型,并将策略查询与其预测性世界查询对齐,从而将学习到的空间动力学迁移到策略潜在变量中,并用其条件化动作生成。在部署时,仅保留策略,其基于 RGB 观测、语言和机器人状态运行,无需深度输入或显式未来预测。在 11 个 DexJoCo 仿真任务上,DexForesight 将基础策略的整体成功率从 49.4% 提升至 60.5%。在三个真实机器人灵巧操作任务上,DexForesight 取得了 58.3% 的成功率,而最强基线为 50.0%。项目主页:https://dexforesight.github.io/
一句话总结
Sharpa Robotics、SJTU-Sharpa Joint Lab for Embodied AI、上海交通大学、香港中文大学和复旦大学的研究人员提出了 DexForesight,该框架通过将策略查询与一个冻结的动作条件空间世界模型对齐来学习隐式空间前瞻,该模型在离线场景深度、运动学手部几何和演示轨迹上训练,避免显式未来预测;部署时仅保留策略,基于 RGB 观测、语言和机器人状态运行,将 DexJoCo 仿真成功率从 49.4% 提高到 60.5%,真实机器人成功率达到 58.3%,而最强基线为 50.0%。
核心贡献
- DexForesight 将灵巧手策略隐变量与冻结的动作条件空间世界模型中的预测表征对齐,并利用对齐后的特征来条件动作生成,从而在部署时无需世界模型执行、在线深度重建或显式未来生成,即可实现隐式空间前瞻。
- 该动作条件空间世界模型使用离线场景深度、运动学手部几何以及约 370 小时、覆盖 60 个任务和五个类别的演示轨迹,联合预测 3D 手部运动和视觉动态,包括被遮挡的手指运动。
- 在 11 个 DexJoCo 仿真任务和三个真实机器人任务 Close Box、Insert Battery 和 Screw On Lid 上,DexForesight 将基础策略成功率从 49.4% 提高到 60.5%,真实机器人成功率达到 58.3%,最强基线为 50.0%。
引言
控制灵巧手需要预判手指相对于物体和场景的运动方式,包括相机不可见的被遮挡部分。世界动作模型可以学习这种预测性空间前瞻,但将其用于灵巧操作具有挑战性,因为这类模型通常依赖部署时的在线深度重建或显式未来生成,而且仅基于可见场景表面的预测目标会遗漏被遮挡的手指运动。先前的空间引导策略也往往改进场景几何,而不是建模动作条件的关节化手部动态。作者提出了 DexForesight,将动作条件空间世界模型与策略解耦,并把其预测表征迁移到策略隐变量中。该世界模型使用场景深度、运动学手部几何和未来状态进行离线训练,联合预测 3D 手部运动和视觉变化。冻结世界模型后,查询对齐使策略能够在动作生成过程中复用这些特征,因此部署时仅需要当前 RGB 观测、语言和机器人状态,无需世界模型执行、在线深度重建或显式未来生成。
数据集
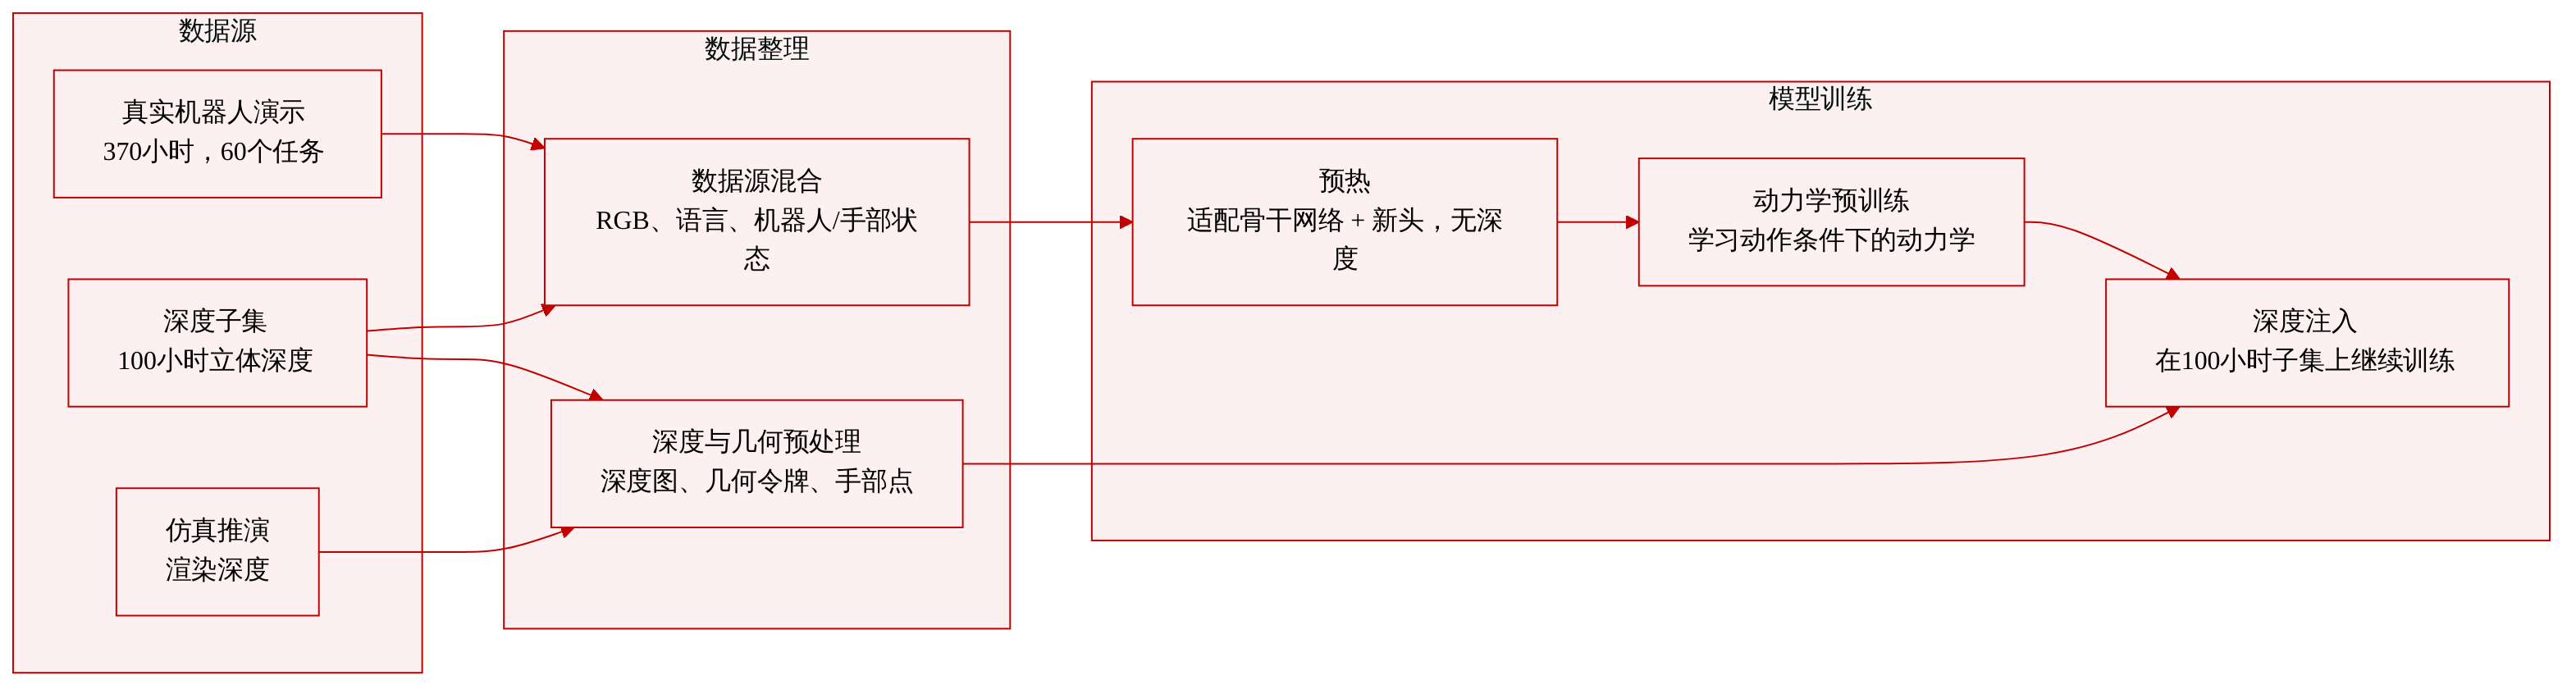
作者使用真实机器人演示语料库和一个较小的深度标注子集进行世界模型训练。
数据集组成与来源
- 约 370 小时演示,覆盖 60 个真实机器人任务。
- 任务分为五个类别:
- 空间排列
- 装配与接触
- 旋转与关节运动
- 可变形物体
- 工具使用
- 数据涵盖多样化的物体摆放变化、精确对齐、关节旋转、物体形状变化和持续接触。
- 一个 100 小时子集用于深度注入训练,涵盖空间排列、装配与接触、旋转与关节运动,与三个真实机器人评测类别一致。
深度处理
- 对于真实机器人演示,场景深度使用 StereoAnyVideo 从录制的双目 RGB 序列中离线估计。
- 对于仿真,深度直接从 MuJoCo rollout 渲染。
- OmniVGGT 将 RGB 帧与相应深度图配对编码为几何 tokens。
- 深度仅用于当前场景几何,不需要未来时间戳的深度。
手部几何与目标
- 手部几何由在手部 URDF 链接上采样的固定点表示。
- 这些点利用记录到的机器人状态通过前向运动学变换到机器人基座坐标系。
- 每个点在帧间保持其链接归属和局部坐标,从而在手部关节运动时保持对应关系。
- 当前和历史手部点云使用 Point-BERT 编码。
- 未来手部点位移提供手部运动流预测目标。
- 视觉预测目标使用从 RGB 中提取的冻结 DINOv3 特征。
- 未来控制条件使用 K = 4 个槽,从 16 帧未来窗口中的四个帧区间采样。
- 未描述显式的图像裁剪策略。
数据使用方式
- 训练分为三个阶段:
- 预热:在无深度输入的情况下联合优化预训练骨干网络和新增预测模块。
- 动态预训练:从整个演示语料库中的 RGB 观测、语言指令以及手部和机器人状态历史中学习动作条件的交互动态。
- 深度注入:仅在 100 小时深度子集上继续训练,加入深度条件,同时保持相同的手部运动和视觉预测目标。
- 未指定显式的训练/验证/测试划分或混合比例。早期阶段使用完整语料库,最后阶段使用深度估计子集。
方法
作者提出了 DexForesight,该框架将动作条件空间世界模型与策略解耦,以使灵巧操作基于隐式空间前瞻。整体架构和查询对齐过程如下所示。
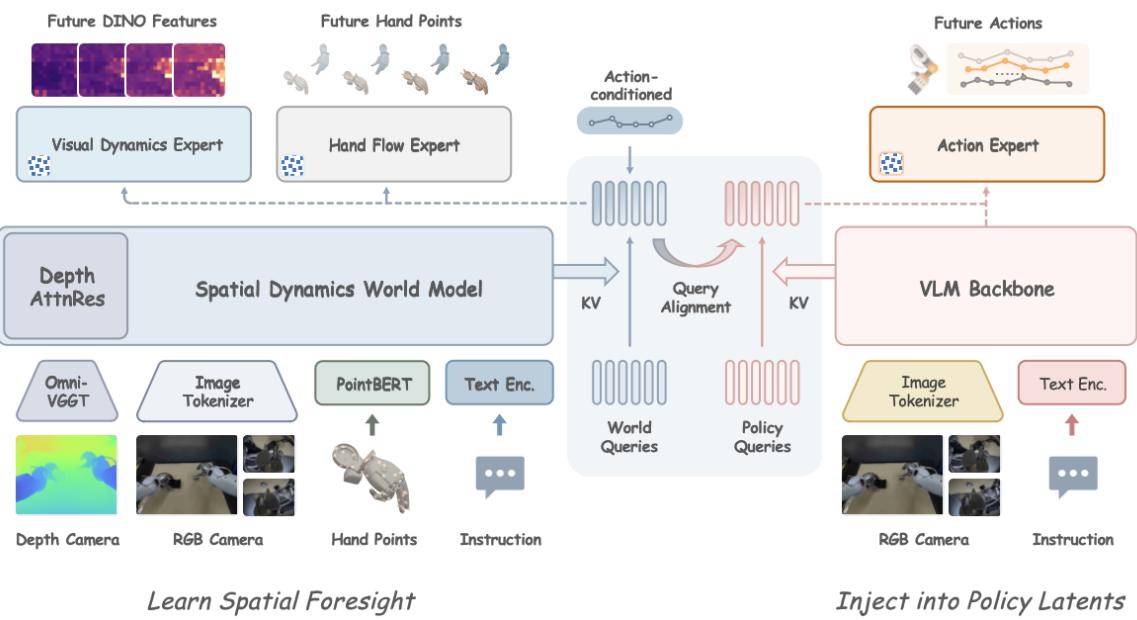
在任意时间步 t,策略接收多视角 RGB 图像、语言指令和机器人状态,记作 ot=(It,ℓ,st),并输出动作块 At。空间世界模型还额外输入离线场景深度和短期手部几何与机器人状态历史,记作 ct。训练期间,它还接收与未来预测时间戳对齐的演示控制序列 Ut。两个模型生成查询特征如下:
Ztw=fϕ(ct,Ut),Ztπ=qθ(Mθ(ot)).其中,fϕ 包含世界模型骨干网络、查询读取器和动作条件查询适配器,而策略查询读取器 qθ 关注从 Mθ 中收集的选定视觉语言模型(VLM)隐藏层。两者输出都包含 N 个查询 tokens。演示控制 Ut 仅作为训练阶段的动态条件变量,用于确定建模哪个依赖控制的未来,部署时不会提供给策略。
为了学习空间前瞻,空间世界模型在以 RynnBrain 初始化的骨干网络中编码场景观测和手部几何。手部几何通过在手部 URDF 链接上采样固定点,并利用记录到的机器人状态通过前向运动学变换到机器人基座坐标系得到。这保持了手部关节运动时的对应关系,并指定了被遮挡表面的位置。Point-BERT 编码器处理当前点云和短期手部运动历史,将这些特征与 RGB、语言和机器人状态历史一起输入骨干网络。
在深度融合方面,对于真实机器人演示,场景深度使用 StereoAnyVideo 从双目 RGB 序列离线估计;对于仿真,则直接从 MuJoCo rollout 渲染。OmniVGGT 编码器将 RGB 帧与相应深度图配对,生成几何 tokens Et。这些 tokens 在特定层之后通过交叉注意力注入骨干网络。遵循 Attention Residuals 的跨层聚合原则,逐 token 路由器将传入的隐藏状态与所有先前注入层的输出相结合,使模型能够学习要纳入多少几何信息以及如何组合来自不同融合层的特征。
动作条件世界查询由一组 N 个可学习查询形成,这些查询关注特定骨干层的隐藏状态。为了预测未来状态,模型使用 K=4 个带偏移 δk 的槽,从 16 帧未来窗口中的每个四帧区间采样一个偏移。每个偏移处的演示控制与其时间偏移一起编码,查询适配器关注这些动作 tokens 以生成 Ztw。这些查询条件两个预测专家:手部运动流专家预测对应手部点的位移 Ft,k=Pt+δk−Pt;视觉动态专家预测冻结 DINOv3 图像特征的变化 ΔVt,k=Φ(It+δk)−Φ(It)。两个专家都预测添加到其目标上的噪声,并辅以对恢复后的干净目标的 Smooth L1 损失。联合训练目标为:
Lworld=Lhand+λvLvisual+λcLcontext,其中辅助上下文损失在动作条件化之前从查询中重建当前特征。
训练世界模型后,作者冻结其参数,并使用动作条件查询 Ztw 监督策略查询 Ztπ。可学习策略查询关注策略 VLM 的选定隐藏层,学习到的投影将其输出映射到世界查询特征空间。这些策略查询被投影到动作上下文维度,并与动作专家原始上下文 Ct 拼接以生成动作。对齐过程使用 token 损失和关系损失匹配对应查询特征及其成对相似性。最终策略目标为:
Lpolicy=Laction+λalign(Ltoken+βLrelation).推理时,策略对每个观测计算一次查询,并在动作采样期间复用增强后的上下文,完全去除了世界模型、深度编码器和未来专家。
训练流程利用约 370 小时演示,覆盖 60 个任务,分为空间排列、装配与接触、旋转与关节运动、可变形物体和工具使用。数据分布和训练阶段总结如下。
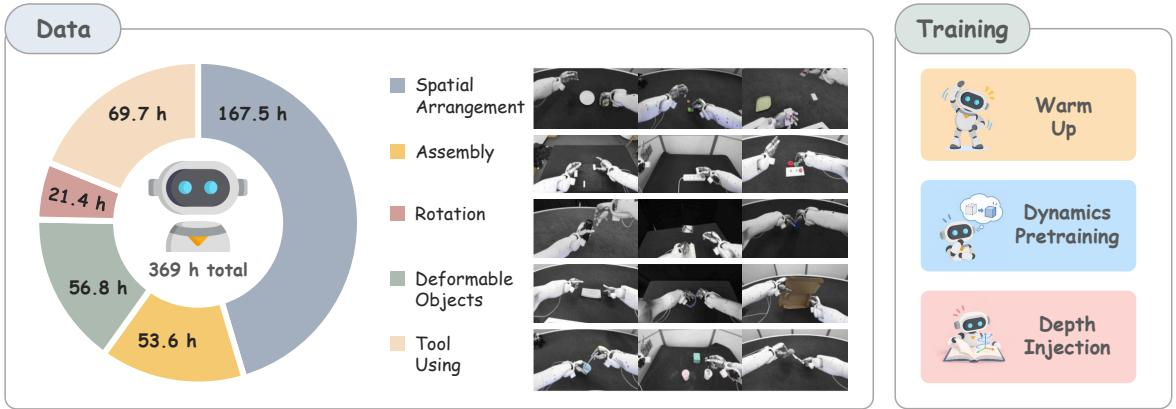
训练分三个不同阶段进行。预热阶段,作者联合优化预训练骨干网络和新增预测模块,使骨干表征适应手部运动和视觉预测目标。接下来,在完整演示语料库上进行动态预训练,模型从 RGB 观测、语言指令以及手部和机器人状态历史中学习动作条件的交互动态,不输入深度。在最后的深度注入阶段,引入深度条件,并在覆盖空间排列、装配与接触、旋转与关节运动的 100 小时子集上继续训练。几何特征由冻结编码器提取,通过可训练融合模块注入骨干网络,骨干网络和预测模块在一致的预测监督下保持联合优化。
实验
实验在 11 个 DexJoCo 仿真任务和一个真实机器人上的三个高难度操作任务 Close Box、Insert Battery 和 Screw On Lid 上评估 DexForesight,并与 VLA 和世界动作基线进行比较。DexForesight 在两种设置下均优于这些基线,同时直接从策略查询生成动作,推理开销可忽略,并且部署时无需未来预测。结果还表明,预测性 3D 手部运动信息在部署后的策略特征中仍然可用;迁移这种表征比附加直接预测头更有效;离线深度、跨层深度融合和 3D 手部运动目标都对性能有显著贡献。
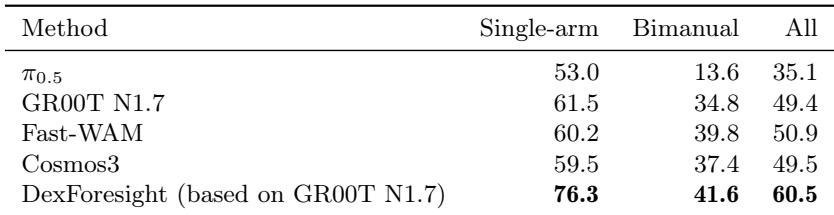
在仿真 DexJoCo 任务中,DexForesight 在比较的策略和世界动作模型中取得了最高的整体成功率,比其 GR00T N1.7 骨干网络和最强基线高出约 10 到 11 个百分点。单臂任务的提升最明显,而双臂任务性能也是最高,但与最佳基线更接近。这些结果表明,该方法在部署时无需未来解码即可保留有用的预测结构。DexForesight 在整体仿真成功率上领先,超过 Fast-WAM 及其 GR00T N1.7 骨干网络。它在单臂和双臂任务组中都取得最高成功率,其中单臂任务优势更大。
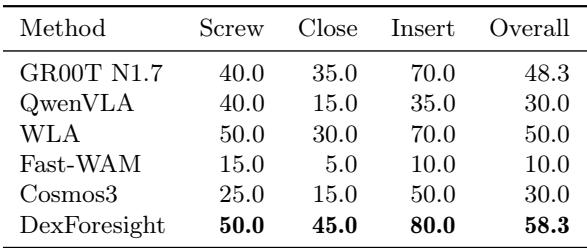
在真实机器人留出位置上,DexForesight 在所有比较方法中达到最高整体成功率,超过次优的 WLA 及其自身的 GR00T 骨干网络。它在每个操作任务上领先或并列,尤其在 Close 和 Insert 上表现突出。其推理延迟与 QwenVLA 策略基线几乎相同。DexForesight 取得最高整体真实机器人成功率,优于 WLA 和 GR00T N1.7,而 Fast-WAM 和 Cosmos3 明显落后。它在 Close 和 Insert 上领先,在 Screw 上并列,展现出全面的最强任务级性能。失败集中在空间挑战上,如手指遮挡、物体部分遮挡和盖盒几何结构。尽管增加了预测训练目标,推理时间相对于 QwenVLA 仅增加几毫秒。
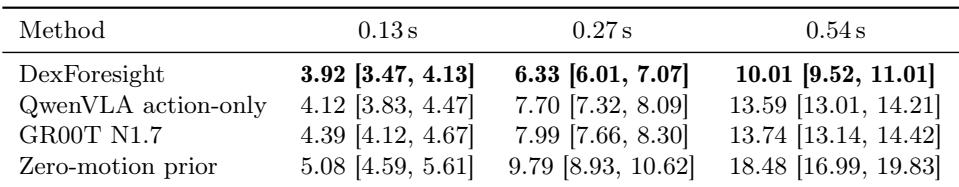
冻结的部署策略隐变量中保留了比参与比较的仅动作和零运动基线更多可线性读取的未来手部运动信息。这种优势在短预测期出现,并随着预测期变长而增大。这表明即使去除了世界模型和未来解码器,预测性手部运动结构仍然保留在策略查询中。DexForesight 在每个测试预测期上都取得低于 QwenVLA 仅动作和 GR00T N1.7 的线性探针 3D 位移误差。DexForesight 与零运动先验之间的差距从最短到最长预测期显著扩大。未来手部运动信息可以从冻结的 DexForesight 策略隐变量中线性读取,部署时无需世界模型或未来解码器。
在比较的变体中,DexForesight 取得最高整体仿真成功率,并在单臂和双臂设置下优于直接添加到 GR00T 的预测模块。最强的直接预测对照是手部运动流头,但 DexForesight 仍以明显优势领先。消融实验显示,移除离线深度、替换跨层深度融合、或将手部运动监督替换为未来动作目标都会一致降低成功率。DexForesight 达到 60.5% 的整体成功率,比最强的直接预测基线手部运动流头 53.1% 高 7.4 个百分点。双臂性能有利于 DexForesight:41.6%,手部运动流头为 37.6%,DINO 未来残差头为 23.8%。直接组合 DINO 和手部运动流头得到 49.5% 的整体成功率,低于单独手部运动流头,说明添加预测头并不等同于查询对齐。查询目标消融显示,使用动作前查询、未来动作目标或打乱的条件动作时,成功率低于以演示动作作为条件。
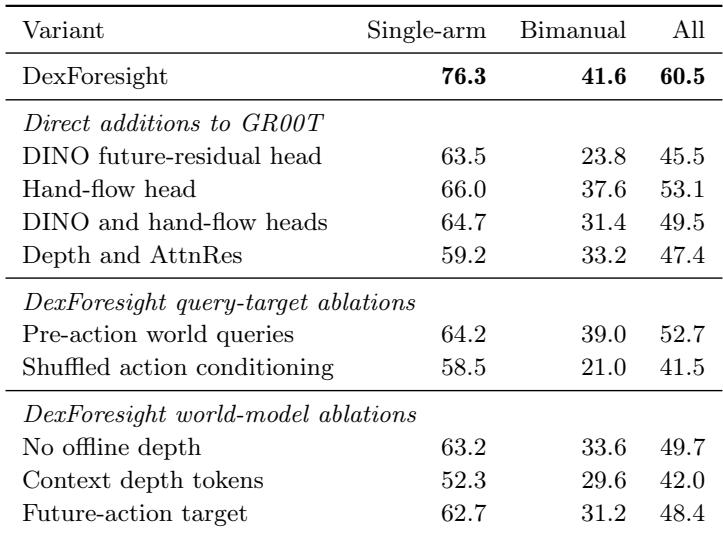
评测涵盖仿真 DexJoCo 操作、真实机器人留出位置、冻结隐变量探测和消融实验。仿真和真实机器人结果表明,DexForesight 相对于其 GR00T N1.7 骨干网络和其他基线提高了整体成功率,在单臂任务以及 Close 和 Insert 上提升最大,同时只增加可忽略的推理延迟。探测实验表明,部署后的策略隐变量保留了可线性读取的未来手部运动信息,无需世界模型或未来解码器。消融实验确认,以演示动作进行查询对齐、离线深度、跨层深度融合和手部运动监督都有贡献,而直接添加预测头效果较差。