Command Palette
Search for a command to run...
WorldFoundry:迈向统一的世界智能基础设施
WorldFoundry:迈向统一的世界智能基础设施
摘要
视觉生成模型日益模糊了合成观测与模拟环境之间的界限。然而,仅凭视觉逼真性并不构成成功的世界建模:令人信服的输出可能缺乏持久状态、物理动力学,或对交互缺乏因果一致的响应。由于缺少共享的操作基础,加上以感知为中心的基准和碎片化的工作流,生成式基础模型与生成式世界模型之间的区别变得模糊,也阻碍了对动力学、可控性和交互效用的可复现评估。我们将生成式世界模型定义为一类预测性动力系统,它维护环境的一种持久、以历史为条件的表示,根据动作或干预更新该表示,并生成时间上连贯的轨迹,以反映已观测干预和反事实干预下的结果。从这一定义出发,我们提出一个面向智能的框架,涵盖感知锚定、持久状态建模、可控变换、动力学感知预测和闭环交互。我们进一步提出 WorldFoundry,一个开源基础设施,用于跨视频、3D 与 4D、具身动作和交互式世界系统进行可复现的推理与评估。WorldFoundry 统一了模型与基准发现、运行时与资产准备、执行编排、制品管理以及交互式可视化,同时模态特定的适配器保留原生输入、执行语义、输出表示和评估协议。显式清单、持久的制品契约和证据感知评分卡将执行就绪性与评价性声明分离,使每项声明都可追溯到其支撑制品。当前目录包含 270 个模型条目、74 个基准和 62 个已注册指标条目,每个条目的集成就绪性与执行证据分别记录。通过将世界建模与基于证据的可执行基础设施相结合,WorldFoundry 能够在异构系统之间对持久、可控的动力学进行可复现比较,推动该领域从感知合成走向可度量的世界智能。
一句话总结
OpenEnvision、NTU、Princeton 等机构的研究人员提出了 WorldFoundry,一个开源基础设施,将生成式世界模型定义为预测性动力系统,并通过显式清单、产物契约和证据感知记分卡,在视频、3D/4D、具身动作和交互式系统之间统一可复现的推理与评估,从而推进可度量的世界智能。
核心贡献
- 论文将生成式世界模型定义为一个预测性动力系统,该系统维护持久的、以历史为条件的状态,在动作或干预下更新该状态,并生成反映观测干预和反事实干预的时间一致轨迹,并利用这一定义区分生成式世界模型与生成式基础模型。
- 论文推导出面向智能的评估框架,涵盖感知接地、持久状态建模、可控变换、动力学感知预测和闭环交互,将评估从单个输出质量转向完整世界建模回路的行为。
- WorldFoundry 被作为开源基础设施引入,用于在视频、3D 与 4D、具身动作和交互式系统之间进行可复现推理与评估,提供模态特定适配器、显式清单、产物契约和证据感知记分卡;它记录了 270 个模型条目、74 个基准和 62 个已注册指标条目,并分别跟踪集成就绪度与执行证据。
引言
近期的生成式建模已从合成单个物体或场景,转向对随时间演化并响应干预的世界进行建模,这要求系统能够感知观测、推断结构化状态、预测动态并支持交互式输出。视频生成器、3D 与 4D 场景表示以及具身策略各自处理该问题的互补部分,但互不兼容的表示、运行时、接口和评估协议使这些能力难以组合、复现和度量;此前的底层设施努力仍然不完整。因此,作者将生成式世界模型定义为一个学习的、以历史和控制为条件的动力系统,它维护持久的环境状态,在干预下演化该状态,并吸收观测反馈,以闭环而非视觉逼真度作为合格标准。他们贡献了 WorldFoundry,一个用于集成、执行与评估视频、3D、4D、交互式世界以及具身动作模型的开放源代码系统,包含 270 个已集成模型,以及通过文档化工作流验证的 100 多个基准和指标实现。
方法
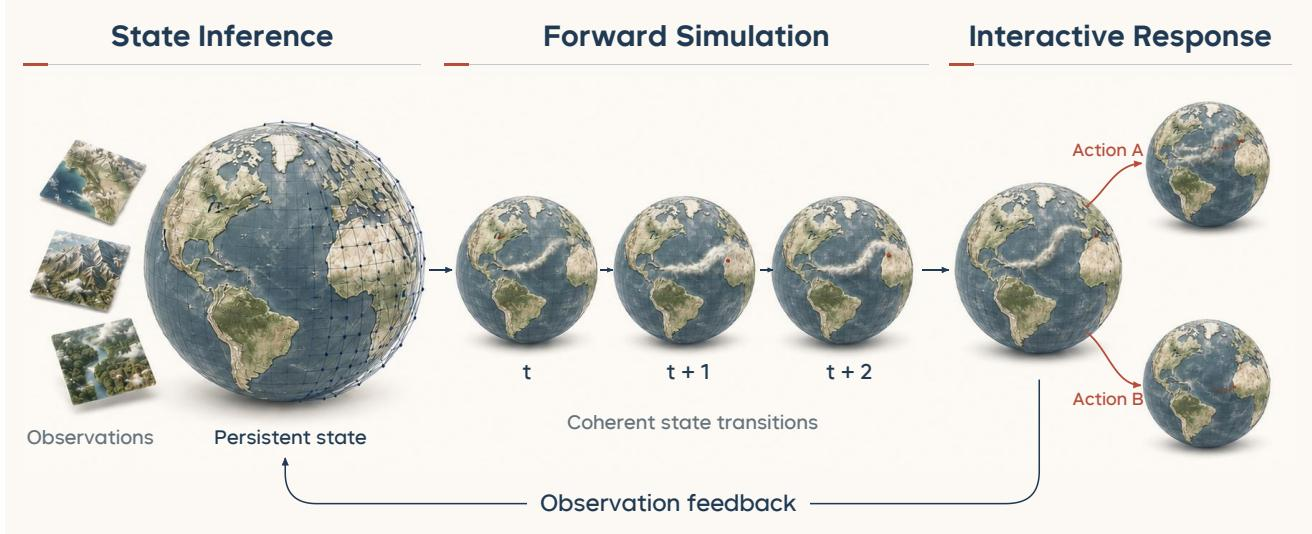
作者通过三个紧密耦合的操作来刻画世界建模:状态推断、前向模拟和交互响应。生成式世界模型被定义为一个学习的、以历史和控制为条件的潜变量动力系统,它推断并维护持久的环境状态,在内生动力学和外部干预下演化该状态,并吸收反馈以生成一致的未来轨迹。为了可复现地评估这些能力,作者引入了 WorldFoundry,一个开源基础设施,围绕发现、运行时准备、执行、检查和评估的通用生命周期组织。
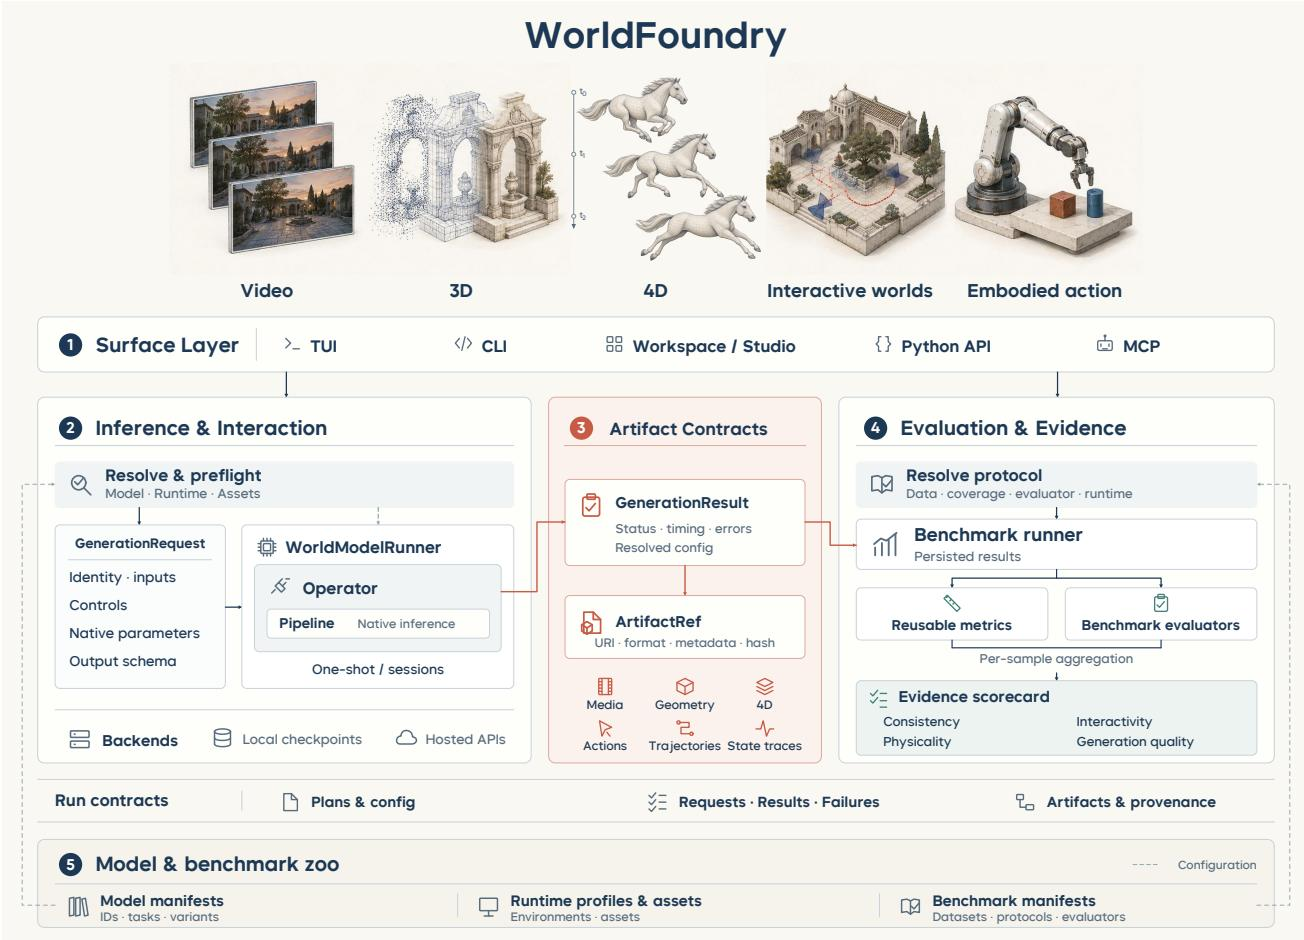
如框架图所示,WorldFoundry 由五个主要组件组成,将异构的视觉生成和世界建模系统纳入一致的操作框架。
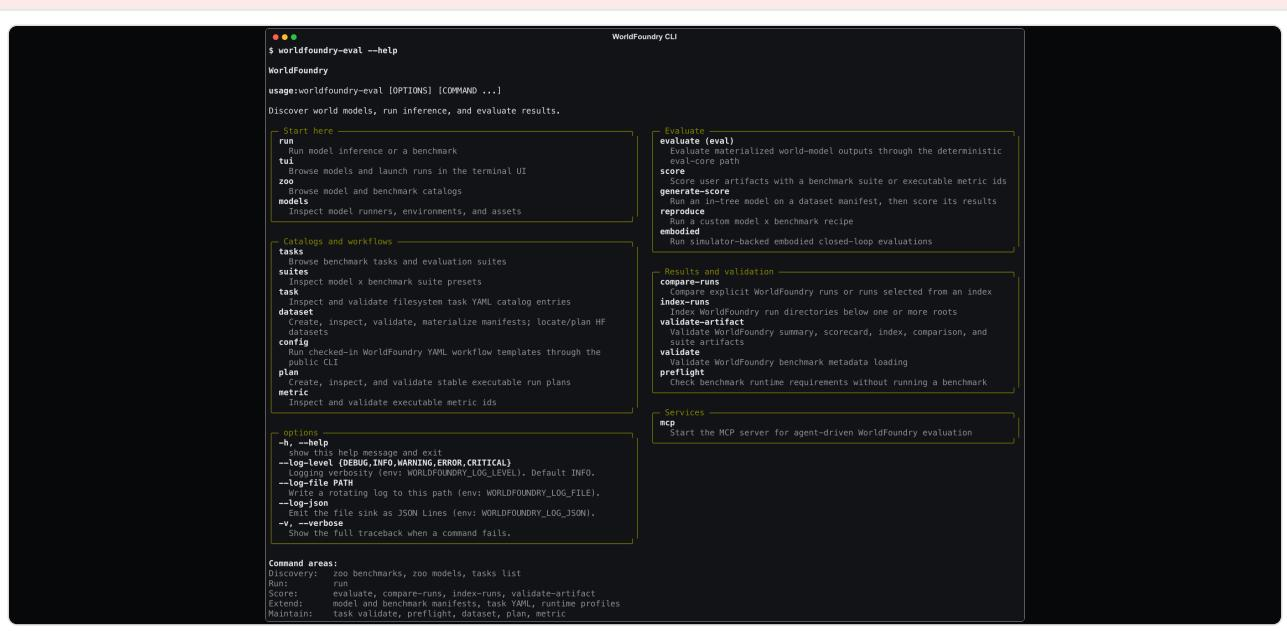
表面层通过多个共享单一编排路径的接口提供一致的用户访问。命令行接口覆盖发现、准备、推理、评估、验证和报告,并面向自动化实验和可复现基准测试设计。
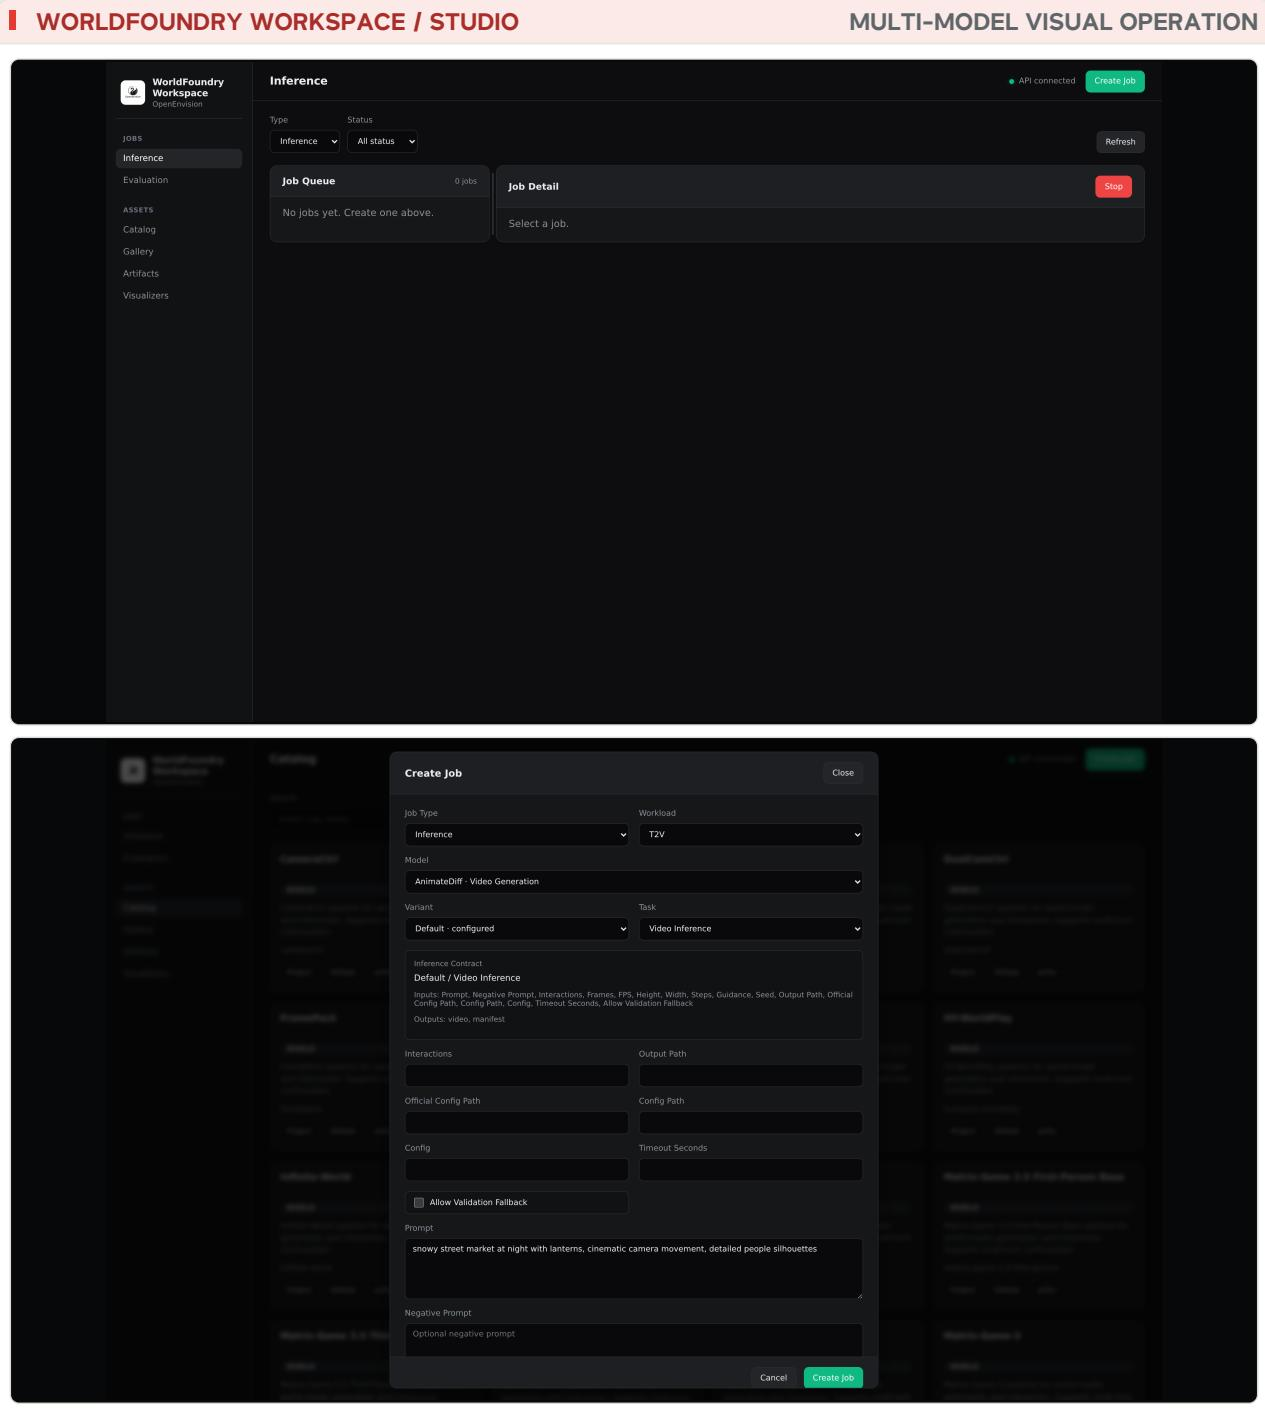
基于浏览器的 Workspace 支持多模型任务配置、模型特定输入规格、运行时选择、执行监控、产物检查和跨运行比较,而单模型 Studio 则为交互使用和详细检查提供定制控制。Studio 还提供模态感知的可视化与交互,显示生成的视频、渲染点云和网格,并展示高斯泼溅。
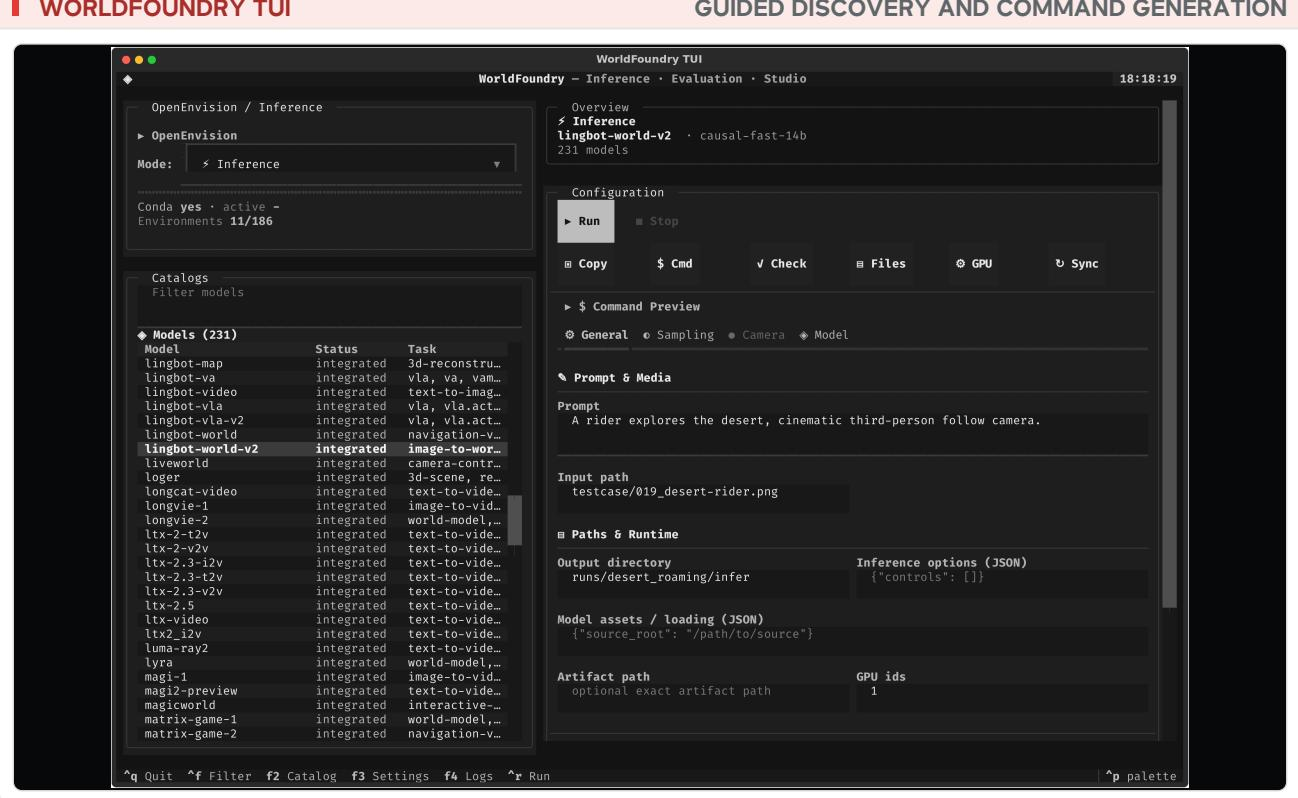
终端用户界面通过查询模型和基准目录、检查需求与就绪度,并在资源分配前解析可执行命令来引导发现。
统一推理与交互通过清单驱动的执行序列来解析请求。每个模型标识符被映射到一个规范目录条目,指定来源、支持的任务、输入与输出模态、所需资产和运行时配置。输入被编码为 GenerationRequest,定义样本身份、任务上下文、条件输入、控制信号和输出规格的通用字段,同时保留模型特定载荷。WorldModelRunner 通过两个互补抽象来协调执行:Operator 和 Pipeline。Operator 处理任务特定适配,包括输入验证、预处理、转换为模型原生参数以及后处理。Pipeline 管理模型生命周期和推理运行时,包括模型构建、检查点加载、设备放置和分布式执行。
产物与表示契约定义了一个两级契约系统,将样本级执行与运行级组织分离。GenerationRequest 表示单个执行单元,而相应的 GenerationResult 记录稳定的样本和模型标识符、执行状态、错误、计时和输出引用。每个物化输出由 ArtifactRef 描述,它通过语义角色和 URI 标识外部存储的内容。在运行级,execution_plan.json、requests.jsonl、results.jsonl 和 run_manifest.json 等文件跟踪每个阶段的状态、物化输出和已解析的运行身份。这种持久化记录结构将产物检查和评估与模型执行解耦。
评估与证据将评估视为以产物为中心的过程,一旦输出被物化,评分即可独立于原始模型运行时进行。评估流水线解析模型、基准、指标、数据源和运行时配置。指标计算逐样本测量值和聚合统计量,而基准规定数据、样本覆盖范围、预处理和聚合规则。证据层记录评估结果及其支持科学比较的条件,生成 scorecard.json,作为得分有效性、来源和协议保真度的权威机器可读记录。
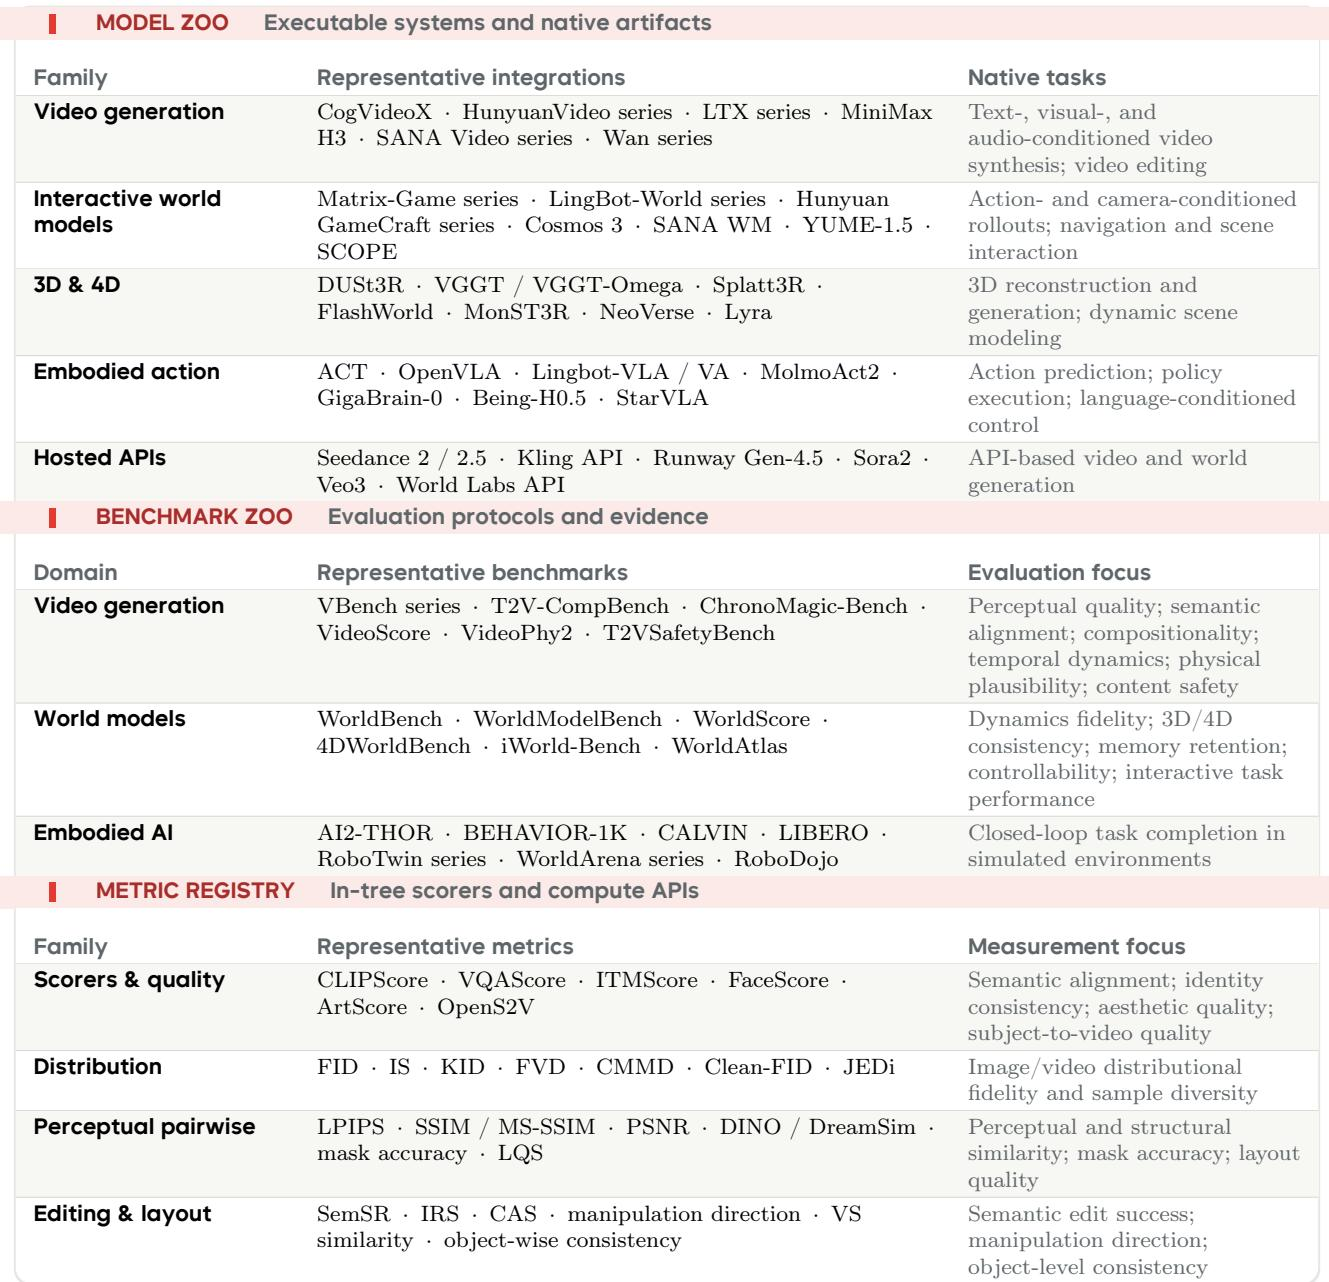
模型与基准 Zoo 维护清单驱动的注册表,将模型和基准发现与明确、可审计的集成状态相链接。条目按操作需求分类,例如视频模型、生成式世界模型、3D 与 4D 模型以及具身预测模型。每个条目记录官方来源、许可、任务、检查点引用和运行时绑定。目录收录确立了可发现性,而源可用性、实现状态、资产就绪度和执行证据则被单独跟踪,以区分结构一致性与完整基准复现。
实验
实证验证在 128 个 NVIDIA A100/H100 GPU 上评估 WorldFoundry,覆盖四个模型家族:视频生成、交互式世界建模、3D/4D 生成和具身动作生成。它评估该框架是否保留原生输入与输出语义,是否在 CLI、Python API 和 Web 接口之间提供一致行为,以及是否为报告结果产生可追踪证据。定性结果表明,视频模型改善了视觉保真度和条件化,但仍面临事件级一致性问题;交互式世界模型必须将场景外观回忆与持续的、依赖动作的状态变化分开;3D/4D 方法需要区分观测重建与合理的空间补全及时间对应。对于具身动作,闭环任务完成与在可比数据、具身和延迟约束下的恢复,比单纯的离线动作准确率或预测视觉质量更重要。
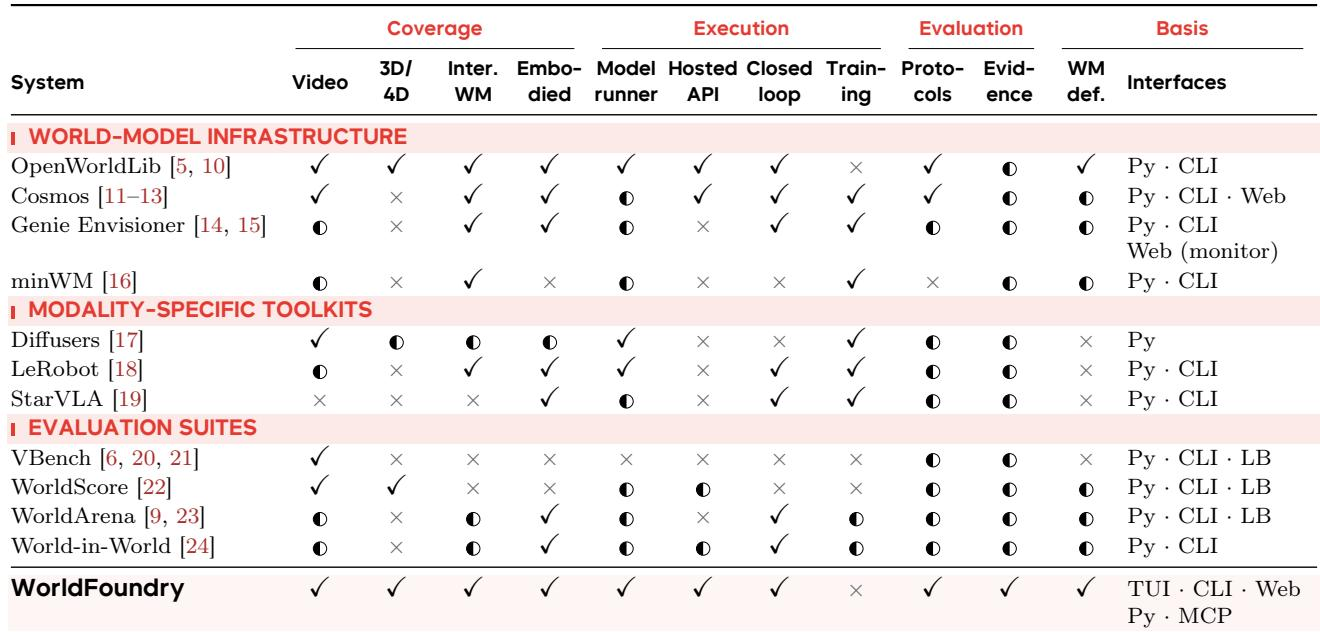
世界模型基础设施主要在执行、闭环就绪度和接口广度上存在差异。OpenWorldLib 是所列系统中唯一具有文档化执行与训练工作流的系统,而 Cosmos 提供更广泛的接口和模型运行器支持,但缺少执行。Genie Envisioner 和 minWM 更受限制,且没有条目将闭环标记为完全支持。OpenWorldLib 是唯一具有文档化执行与训练工作流的比较系统,但缺少模型运行器支持。没有比较基础设施将闭环标记为完全支持;可用条目将其标记为专用或受限。Cosmos 提供最广泛的接口支持并包含模型运行器支持,而 Genie Envisioner 和 minWM 缺少执行和交互式世界模型支持。
该目录涵盖视频生成、交互式世界模型、3D 与 4D 建模、具身动作策略以及托管 API,并在每个领域都有代表性集成。评估将离线动作预测与闭环执行结合在 LIBERO 和 RoboTwin 等兼容操作环境中,度量任务完成度、指令遵循度、控制准确率、轨迹平滑度、执行延迟和恢复能力。已发表的结果表明,世界建模在支持可执行动作和及时纠正时最有用,使闭环完成成为核心证据。具身动作覆盖包括 ACT、OpenVLA、Lingbot-VLA / VA、MolmoAct2、GigaBrain-0、Being-H0.5 和 StarVLA 等代表。比起离线动作准确率,更强调闭环评估;在一个 LIBERO-10 示例中,OpenVLA 完成了单物体抓取放置,但在多阶段任务上达到步数限制。世界模型的贡献通过预测进入控制流水线的位置来区分,包括训练数据增强、表示监督和在线动作生成。
实验比较了世界模型基础设施和具身动作策略,发现它们主要在执行、闭环就绪度和接口广度上不同:OpenWorldLib 是唯一具有文档化执行与训练工作流的系统,但缺少模型运行器支持;Cosmos 提供最广泛的接口和模型运行器支持但没有执行;没有系统完全支持闭环操作。评估覆盖视频生成、交互式世界模型、3D 与 4D 建模以及具身策略,将离线动作预测与 LIBERO 和 RoboTwin 中的闭环执行结合。主要结论是,世界建模在支持可执行动作和及时纠正时最有用,使闭环完成而非离线准确率成为核心证据,正如 OpenVLA 只完成单物体抓取放置、却在多阶段任务上达到步数限制所显示的那样。世界模型的贡献进一步通过预测是作为训练数据增强、表示监督还是在线动作生成进入来区分。