Command Palette
Search for a command to run...
面向提示自适应且成本感知的大语言模型推理的集成路由
面向提示自适应且成本感知的大语言模型推理的集成路由
Saul Urso Emanuele Carlini Patrizio Dazzi Matteo Mordacchini
摘要
大语言模型(LLM)越来越多地支撑着需要在异构请求之间平衡响应质量与推理成本的 Web 服务。传统路由为每个提示选择一个模型,而固定集成无法根据单个请求调整其组成和成本。我们提出了 PISA,一种提示自适应、成本感知的单模型路由器,以及 PISA-E,其向集成路由的扩展。作为两种方法的核心,PISA 将软聚类隶属度与模型特定预测器相结合,以估计单个模型的能力。基于这些估计,PISA-E 在显式的成本-质量偏好下联合选择集成组成和基数,该偏好可在推理时调整而无需重新训练。一个易于处理的集成成功代理和高效的候选选择使得这一扩展无需针对集成进行专门训练。在分布内(ID)和分布外(OOD)条件下的四个 LLM 路由基准上,PISA 在两种设置下均在所评估的单模型路由器中取得了最高的宏平均成本-性能超体积。同时,在优先考虑响应质量时,PISA-E 在所评估的集成方法中取得了最高的宏平均任务性能,在 ID 和 OOD 条件下分别比最强竞争对手高出 2.09 和 2.87 个百分点。在选定的低成本工作点上,它同样超过了最强集成竞争对手的宏平均任务性能,同时分别将平均推理成本降低了约 36% 和 25%。这些结果证明了提示自适应能力估计对于单模型路由和选择性集成的有效性。
一句话总结
来自 CNR 研究机构与比萨大学的研究人员提出了 PISA,一种提示自适应、成本感知的单模型 LLM 路由器,以及其集成扩展 PISA-E;两者均使用软聚类隶属度和模型特定预测器来估计单个模型的能力。PISA-E 在可调节的成本-质量偏好下联合选择集成组成与基数,在分布内和分布外条件下分别比最强竞争对手高出 2.09 和 2.87 个百分点,并在所选较低成本运行点将平均推理成本降低约 36% 和 25%。
核心贡献
- 本文提出了 PISA,一种提示自适应、成本感知的单模型路由器,它结合软聚类隶属度与模型特定预测器,估计单个模型随提示变化的能力。
- 本文提出了 PISA-E,一种集成路由扩展,在推理时可调整且无需重新训练的成本-质量偏好下,联合选择集成组成与基数;它使用可处理的集成成功替代指标和高效候选选择,无需面向特定集成的训练。
- 在分布内和分布外条件下的四个 LLM 路由基准上,PISA 在所评估的单模型路由器中取得了最高的宏观平均成本-性能超体积。在优先考虑响应质量时,PISA-E 在所评估的集成方法中取得了最高的宏观平均任务性能,在 ID 和 OOD 条件下分别比最强竞争对手高出 2.09 和 2.87 个百分点;在所选较低成本运行点,其宏观平均任务性能超过最强集成竞争对手,同时平均推理成本分别降低约 36% 和 25%。
引言
大语言模型越来越多地部署在搜索、推荐和智能 Agent 等基于 Web 的服务中,提供商必须在异构用户请求之间平衡响应质量与推理成本。此前的路由方法为每个提示选择单个模型,无法利用多个 LLM 的互补优势;现有集成方法通常固定集成基数、只优化成本-质量权衡的一部分,或依赖面向分类的聚合或串行执行。作者提出了 PISA,一种提示自适应、成本感知的单模型路由器,以及 PISA-E,一种集成路由扩展,复用单个模型能力估计来选择每个提示应调用哪些模型以及调用多少模型。一个关键优势是,成本-质量偏好可以在推理时调整,无需重新训练或额外的超参数优化。
方法
作者提出了一个共享的能力估计框架,同时支持单模型路由和集成路由,分别称为 PISA 和 PISA-E。该统一流水线估计单个大语言模型随提示变化的能力,并利用这些估计进行成本感知选择。
如下图所示:
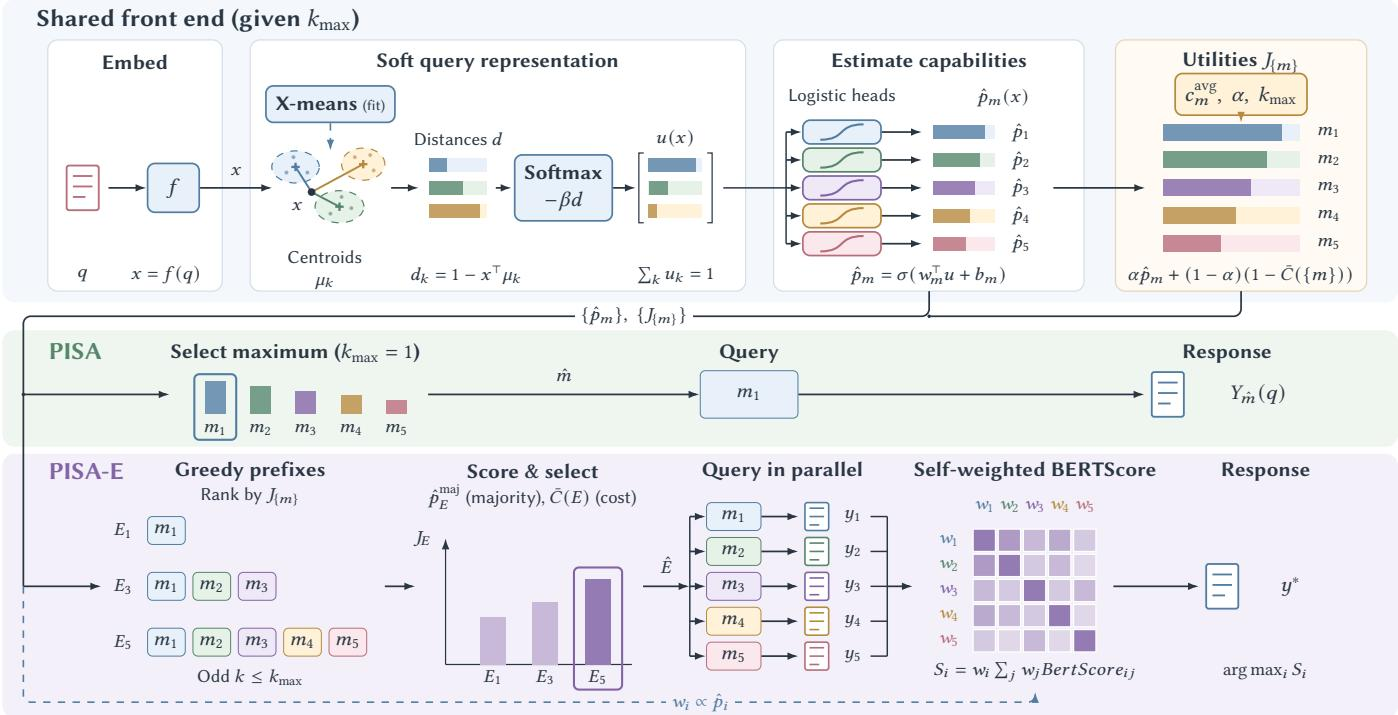
共享前端与能力估计
流水线首先将输入提示 q 映射为嵌入 x=f(q)。为了捕捉提示之间的语义相似性,作者使用 X-means 聚类对训练嵌入进行划分,以确定聚类数量 K 及其中心 μk。该框架不依赖硬分配,而是通过查询对学习中心的软隶属度来表示每个查询。在对嵌入和中心进行 L2 归一化后,这些隶属度由余弦距离计算如下:
uk(x)=∑j=1Kexp(−βdj(x))exp(−βdk(x)),dk(x)=1−x⊤μk其中 β>0 控制分配的集中程度。这种表示使模型能够利用多个邻近区域的信息,而不是只依赖单个簇。
利用隶属度向量 u(x),该框架为每个候选模型 m∈M 学习一个独立的逻辑回归预测器。对给定提示,模型 m 的估计能力为:
p^m(x)=σ(wm⊤u(x)+bm)其中 σ(⋅) 是逻辑斯蒂 sigmoid,参数使用 L2 正则化逻辑回归拟合。每个模型的推理成本根据其在训练集上的平均观测成本估计,并归一化到 [0,1] 范围。
成本感知单模型路由(PISA)
对于单模型路由,作者将决策形式化为选择使成本感知效用函数最大化的模型:
m^(q)=argm∈Mmax[αp^m(q)+(1−α)(1−cˉm(q))]其中 α 控制预测响应质量与推理成本之间的权衡。
提示自适应成本感知集成(PISA-E)
为了将路由扩展到模型子集,PISA-E 评估候选集成 E⊆M,规模最大为 kmax。直接估计每种组合的性能难以处理,因此作者从单个模型能力出发构造集成级别的效用估计。作者使用所选模型产生正确响应的严格多数概率作为可处理的替代指标。在条件独立假设下,该严格多数成功概率通过泊松-二项动态规划计算。
集成成本通过 kmax 个最大平均模型成本之和归一化,以便在不同基数之间进行公平比较。为避免组合搜索,PISA-E 采用贪心候选构造过程。模型首先按其个体效用排序,然后将该排序的逐步增大前缀构造为候选集成,并限制为最大 kmax 的奇数基数。这一限制是合理的,因为偶数基数集成总可以通过移除一个模型来改进,这会提高严格多数成功概率,同时降低成本。
一旦选定了最优集成 E^,其中的模型将被并行查询。最终响应使用自加权 BERTScore 确定,这是最小贝叶斯风险解码的一种能力感知扩展。该框架对所选集成上的能力估计进行归一化以计算权重:
wi(x,E)=∑j∈Ep^j(x)p^i(x)每个候选响应 yi 的评分方式为,将其与集成中所有其他响应之间的 BERTScore 相似度按权重相加:
Si(x,E)=wi(x,E)j∈E∑wj(x,E)BERTScore(yi,yj)得分最高的响应被选为最终输出。
实验
实验在四个 LLM 路由基准上评估 PISA 和 PISA-E,覆盖分布内和分布外条件,并使用任务性能和推理成本与单模型路由器及集成方法进行比较。PISA 在单模型路由器中取得了最佳的综合成本-性能权衡,而 PISA-E 在推理成本低于竞争集成方法的同时取得更高的宏观平均任务性能,并且按提示自适应集成基数;自适应基数在分布外设置下尤其有帮助。组件分析表明,与自加权 BERTScore 搭配的泊松-二项估计器是最有效配置,消融实验确认提示相关模型排序独立改善了成本-性能权衡。
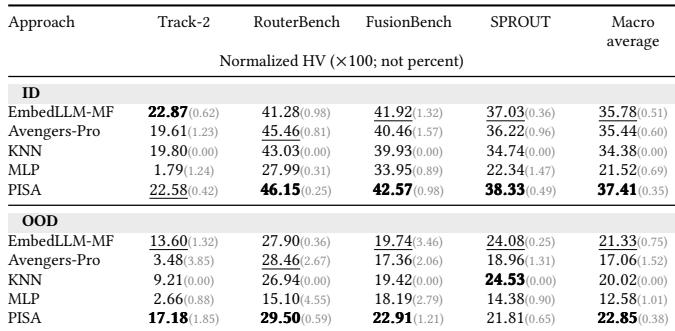
该评估在 ID 和 OOD 设置下、四个基准上比较单模型路由器的归一化超体积。PISA 在两种设置下均取得最高的宏观平均归一化超体积,领先于 EmbedLLM-MF 和其他基线。其优势较为广泛,在大多数基准-设置组合中取得最佳结果,但并非在每个单独基准上都领先。PISA 在 ID 和 OOD 设置下的单模型路由器中记录了最高的宏观平均归一化超体积。PISA 在八个基准-设置组合中的六个上排名第一,并在所示 ID 结果中领先 RouterBench、FusionBench 和 SPROUT。EmbedLLM-MF 是综合表现最强的竞争路由器,并在 ID 下领先 Track-2 基准,而 MLP 始终大幅落后。
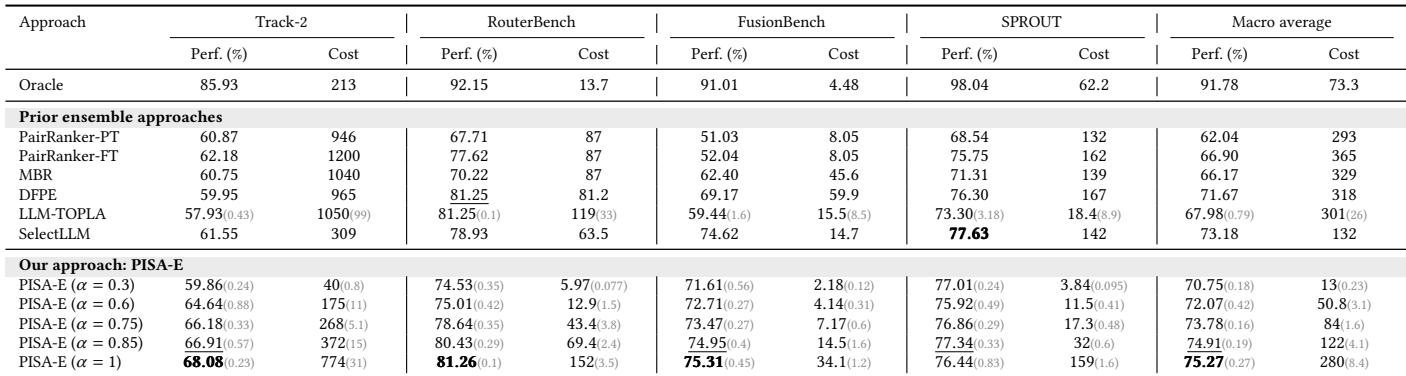
在 ID 基准上,PISA-E 相比最强竞争集成方法取得了更高的宏观平均任务性能,同时所需的推理成本更低。在 OOD 条件下,它也在成本更低的情况下相对最佳竞争对手提高了性能。改变成本-性能权衡参数可大幅降低推理成本,同时性能下降幅度适中。PISA-E 在 ID 宏观平均性能上比 SelectLLM 高 0.60 个百分点,同时将推理成本降低约 36%。在优先考虑质量时,PISA-E 在 ID 和 OOD 设置下均达到可部署方法中最高的宏观平均性能,分别超过最强竞争对手 2.09 和 2.87 个百分点。
在留出的 OOD 任务组上,PISA-E 相比此前最强的集成方法 DFPE 取得了更高的宏观平均性能,同时降低了推理成本。最高质量的 PISA-E 配置达到最佳可部署宏观性能,而低成本配置仍略微优于 DFPE。在其权衡范围内,PISA-E 覆盖了较大的成本-性能曲线,而 Oracle 仍远高于可部署方法。PISA-E 在 OOD 宏观平均值上比 DFPE 高 0.48 个百分点,查询成本约低 25%。将 PISA-E 的权衡参数从最高质量设置下调,推理成本约降低 106 倍,而宏观平均值从 63.24% 降至 50.54%。
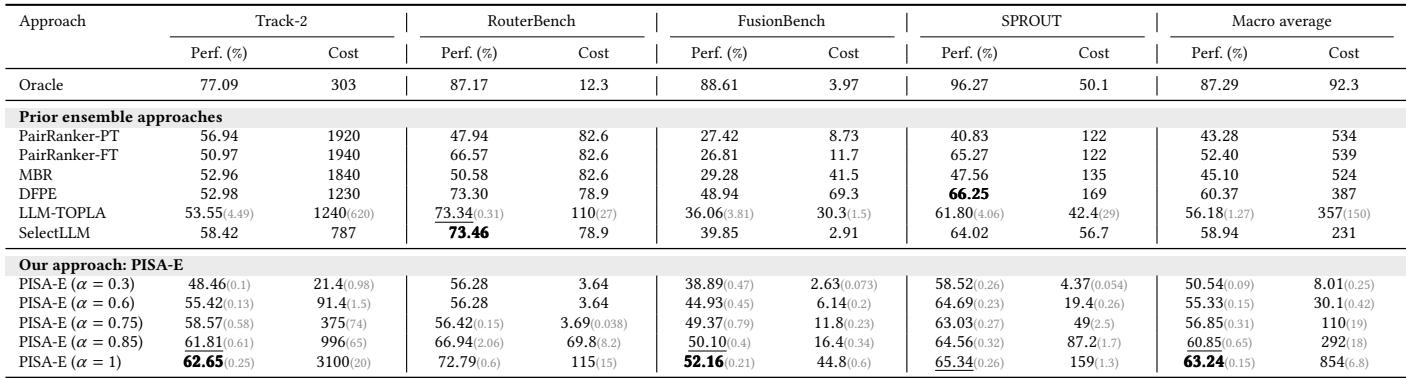
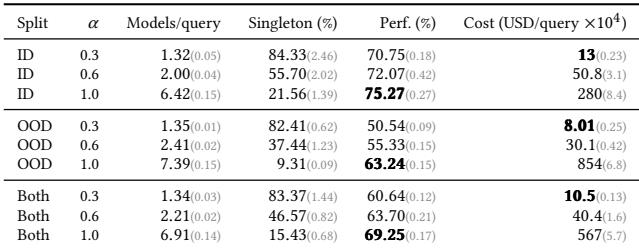
PISA-E 通过其 alpha 参数表现出可控的成本-性能权衡。较低的 alpha 设置会减少每次查询使用的模型数量并增加单模型使用率,从而降低推理成本,但也会降低任务性能。将 alpha 提高到 1.0 可在 ID 和 OOD 设置下取得报告的最高性能,但成本显著更高,尤其是在 OOD 条件下。在 alpha=0.3 时,PISA-E 每次查询使用约 1.3 个模型,单模型率约为 82% 至 84%,在所评估的 PISA-E 设置中取得最低报告成本和最低报告性能。从 alpha=0.3 到 1.0,ID 性能从 70.75% 提高到 75.27%,OOD 性能从 50.54% 提高到 63.24%,而 ID 成本约上升 21 倍,OOD 成本约上升 106 倍。
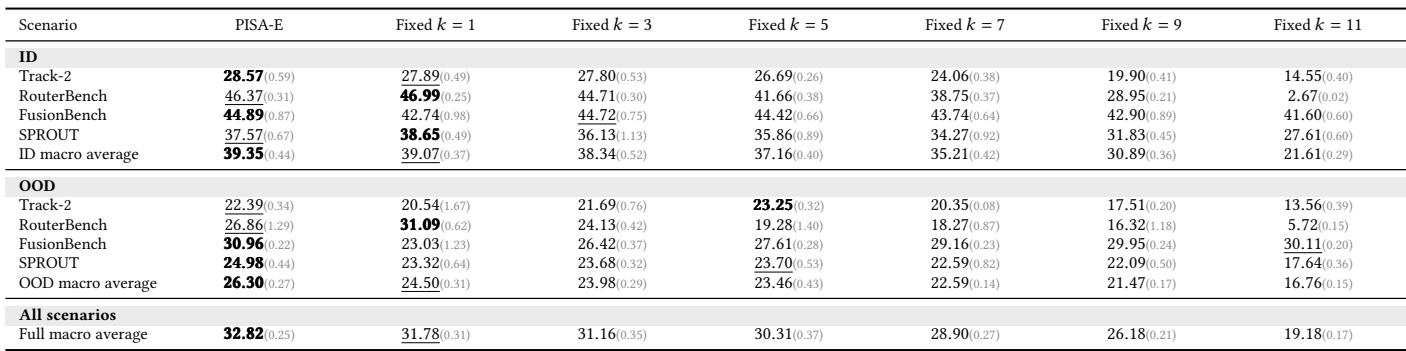
提示自适应集成路由在 ID 和 OOD 条件下均取得最高的宏观平均超体积,并且在 OOD 基准上相对最佳固定基数替代方案的改进更大。固定基数在特定基准上仍可保持竞争力甚至更好,例如在 RouterBench 上单模型选择记录了更高的超体积。随着固定选择模型数量增加,超体积通常下降,表明基数更适合作为提示相关决策。自适应路由在 ID 和 OOD 设置下均取得最高的宏观平均超体积。自适应路由相对固定基数替代方案的优势在 OOD 条件下更大。固定单模型选择在 RouterBench 上优于自适应路由,因此增加模型并不总是有益。较大的固定基数往往产生较低的超体积,并且在最大集成规模下急剧下降。
实验在分布内和分布外路由基准上评估了 PISA 和 PISA-E,包括单模型路由器比较、集成成本-性能权衡以及提示自适应路由。PISA 在单模型路由器中总体排名最高,而 PISA-E 以更低的推理成本优于此前的集成方法,并通过其 alpha 参数提供成本与任务性能之间的可控权衡。提示自适应路由取得了最佳综合性能,尤其是在分布外设置下,尽管固定单模型选择在特定基准上可能更好,而较大的固定集成通常会降低超体积。