Command Palette
Search for a command to run...
ReproBridge:将可复现性构建到 ML 研究工件中
ReproBridge:将可复现性构建到 ML 研究工件中
Yubo Wang Rui Meng Jaehyun Nam Tomas Pfister Jinsung Yoon
摘要
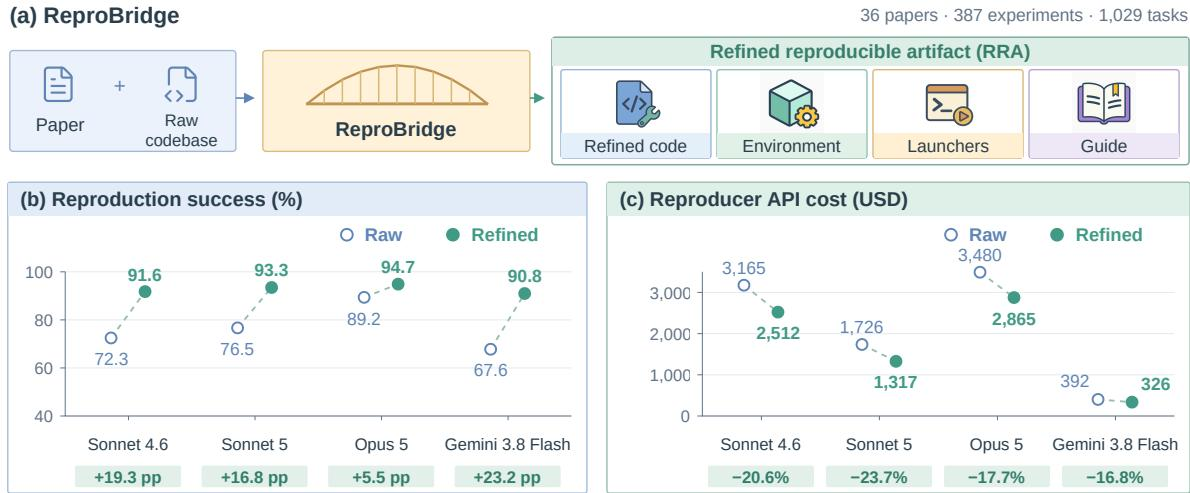
复现机器学习实验需要从分散在论文、已发布代码和支持工件中的信息重建实验流程。因此,对于编码智能体而言,复现成功可能取决于它们填补缺失细节的能力,而不仅仅取决于已发布的工件本身。我们探究保留恢复出的流程和决策是否能够改善后续的独立复现。我们定义了一种标准化工件设计,包含精化后的代码库、环境配置、实验启动器和复现指南,并引入了 ReproBridge,一个用于构建这些精化可复现工件的智能体工作流。ReproBridge-Bench 提供了来自 36 篇论文、387 个实验的 1,029 个任务,每个任务由五个人工验证的参考分数进行锚定。智能体在全新会话中使用原始代码或精化工件尝试任务,并由独立的 Auditor 检查执行证据。在四个被评估模型上,精化工件将平均复现成功率从 76.4% 提升到 92.6%,并将下游 API 支出平均降低 19.7%。跨模型的成功率差距从 21.6 个百分点缩小到 3.9 个百分点,且四个模型的平均成功率均超过 90%。消融研究表明,移除任何组件都会降低复现成功率,其中移除代码和环境带来的损失最大。这些结果表明,保存执行知识有助于即使在原始代码上成功率较低的模型也能更可靠地复现实验,并以更低的 API 成本完成复现。
一句话总结
滑铁卢大学和 Google 的研究人员提出了 ReproBridge,这是一个 agent 工作流,用于构建可复现的机器学习工件,包括精化代码库、环境配置、实验启动器和复现指南;并提出了 ReproBridge-Bench,一个包含 36 篇论文、387 个实验、1,029 个任务的基准。在四个被评估模型上,该工作流将平均复现成功率从 76.4% 提高到 92.6%,将跨模型差距从 21.6 个百分点缩小到 3.9 个百分点,并将 API 开销降低 19.7%。
核心贡献
- 本文提出 ReproBridge,一个 agent 工作流,将恢复出的复现流程打包为四个标准化可复用组件:精化代码库、环境配置、实验启动器和复现指南。
- ReproBridge-Bench 提供来自 36 篇论文、387 个实验的 1,029 个复现任务,每个任务包含五个人工验证的参考分数,并提供独立的 Auditor 检查执行证据。
- 在四个模型上的实验表明,精化工件将平均复现成功率从 76.4% 提高到 92.6%,将下游 API 开销降低 19.7%,并将跨模型成功率差距从 21.6 个百分点缩小到 3.9 个百分点;消融结果表明,代码和环境移除是最大的损失来源。
引言
复现机器学习实验很困难,因为论文和发布代码往往隐含关键执行细节,例如兼容依赖、预期配置、数据加载修复,以及从运行输出到报告分数的映射。coding agent 基准通过未解决的依赖、缺失的实现细节和不完整的计划暴露了这一负担,而查阅论文只能恢复所需信息的一部分。作者认为,保存复现过程中恢复的流程和决策与发布代码同样重要。他们提出 ReproBridge,将四个组件打包:精化代码库、环境配置、实验启动器和复现指南。他们还贡献了 ReproBridge-Bench,覆盖来自 36 篇论文、387 个实验的 1,029 个任务,每个任务包含五个人工验证的参考分数,并表明精化工件将 coding agent 的复现成功率提高 5.5 到 23.2 个百分点,同时将下游 API 开销降低 16.8% 到 23.7%。
数据集

作者从报告主要实验结果且具有可访问官方实现的机器学习论文中构建了一个精选复现基准。
-
来源与论文选择
- 收集工作从 742 篇 ICML 2026 Spotlight 论文开始。
- 作者识别出 241 篇带代码且非纯理论内容的论文,然后随机抽样 50 篇。
- 他们排除了 6 篇因工件或代码可用性问题、4 篇因计算资源要求、4 篇因闭源模型访问问题,最终保留 36 篇测试论文。
- 他们还使用了 10 篇开发论文,其中 5 篇来自 NeurIPS 2026,5 篇来自 ICLR 2026,用于开发 ReproBridge 和评估工作流。
-
任务定义与筛选
- 任务是主表中的一个自身方法测量,由数据集、指标、报告统计量和位置确定。
- 仅保留选定的主表变体。
- 基线、独立消融、图表和仅出现在附录中的结果被排除。
- 一个实验可以产生多个任务分数。
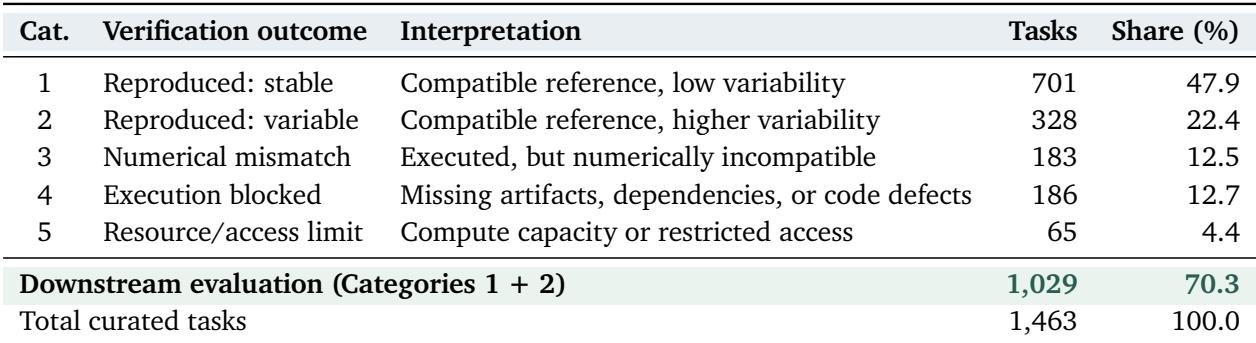
- 36 篇论文从 502 个实验中产生 1,463 个筛选任务。
-
参考收集
- 五名人工复现者在不同服务器上工作,从同一个固定的原始 commit 开始,使用独立的执行目录和 coding agent 会话。
- 他们不能复用其他参与者生成的脚本、测量结果、精化工件或下游复现轨迹。
- 允许使用 coding agent 辅助,但人工会检查实际使用的脚本、配置、编辑和测量提取。
- 在汇总之前,五名复现者的执行环境会与论文指定的设置和共同任务定义进行交叉验证。
- 验证者在查看分数前会固定未指定的重复次数和随机种子选择,并且不得调整流程以接近已发布值。
-
数值兼容性与过滤
- 每个参考观测都测量指定的任务统计量。
- 五个观测值用于估计参考均值和变异。
- 报告的范围由其区间中点表示。
- 兼容区间是围绕参考均值的 95% 预测式区间,并设置 1% 的容差下限。
- 如果已发布分数落在该区间内,则视为兼容。
- 在 1,463 个任务中,有 1,029 个任务(70.3%)具有数值兼容的参考结果,并构成下游评估集,覆盖 387 个实验。
- 其余 434 个任务用于区分数值不一致与执行和资源障碍。
- 参考范围不超过已发布分数绝对值 10% 的任务被视为稳定;变异较高的任务超过该阈值。两类任务都进入下游评估,并合并用于主要比较。
-
规模与使用
- 评估集包含 631 个完整流程任务和 398 个仅评估任务。
- 硬件使用包括 730 个 GPU 任务和 299 个仅 CPU 任务。
- 评估明确允许使用的官方 checkpoint 无需重复其训练。
- 仅评估不能证明训练任务已完成。
- 基准中包含 586 个越低越好和 443 个越高越好的测量,全部采用同一套双边兼容规则评估。
- 超出任一边界的分数仍然在数值上不兼容,包括优于已发布值的分数。
-
元数据与可追溯性
- 参考提交必须将每个分数关联到起始代码 commit、执行的脚本和编辑、环境与硬件、配置与随机种子、原始输出,以及分数提取或汇总流程。
- 已发布目标在论文和任务规范中仍然可见,但 Auditor 会检查提交值是否来自新的执行。
- 允许使用的 checkpoint 可以作为输入,但随附的分数文件永远不能算作测量。
方法
作者提出 ReproBridge,一个将实验结果复现过程转化为可供未来研究人员或 agent 使用的可复用工件的框架。该系统旨在同时保存可执行步骤和执行选择背后的证据,确保复现工作无需访问原始构建对话即可被利用。
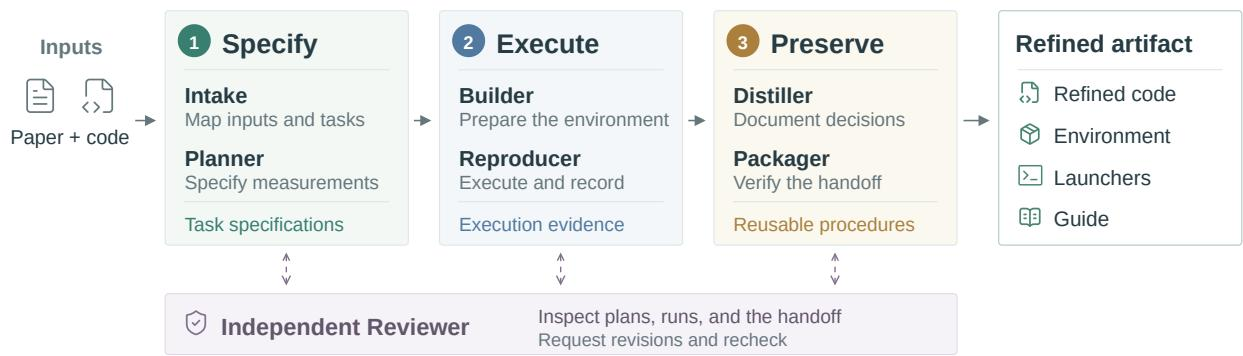
构建工作流分为三个不同阶段:Specify、Execute 和 Preserve。在 Specify 阶段,Intake 角色映射输入和任务,Planner 角色指定测量,生成详细的任务规范。Execute 阶段由 Builder 准备环境,由 Reproducer 执行并记录过程以生成执行证据。最后,Preserve 阶段由 Distiller 记录决策,由 Packager 验证交接,从而生成可复用流程。在整个过程中,Independent Reviewer 检查计划、运行和最终交接,要求修订并重新检查,从而确保工件的完整性。
为确保后续复现者知道要运行哪些代码、如何准备环境、如何获取测量结果,以及为什么做出特定选择,作者设计了一个四组件精化可复现工件(RRA)。第一个组件是精化代码库,用于修复执行缺陷并补齐缺失的实验支持。第二个组件是环境配置,用于指定兼容依赖以及数据或 checkpoint 获取方式。第三个组件由实验启动器组成,将任务连接到配置、执行范围、输出和测量提取,并区分计分运行与冒烟测试。第四个组件是复现指南,其中包括变更记录,说明设置、论文与代码之间的差异、报告统计量以及资源或数值敏感性。
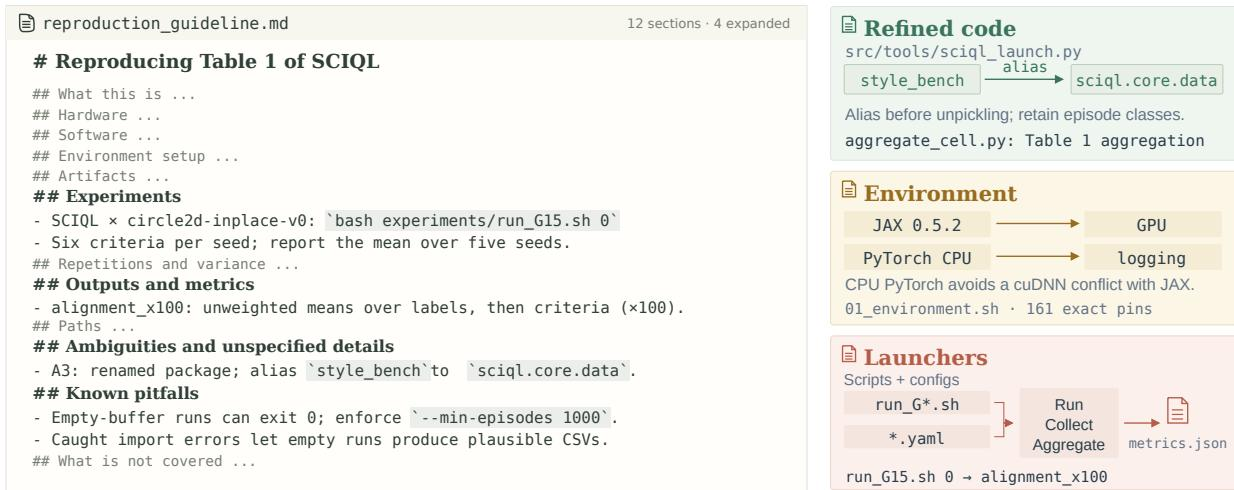
指南通过记录每个歧义的来源位置、差距、采用的解决方案、敏感性和受影响任务,将指令与其理由连接起来。变更记录区分执行修复、正确性修复和便利性更改,同时保留陷阱和开放选择。这种结构化方法确保交付的环境与构建测量所用的环境一致,并确保所有执行决策在结果已知之前就明确记录。当论文与代码冲突时,agent 遵循论文的设置并标记差异,使指南和变更记录建立在已存储规范和合理修复的基础上。
实验
评估在来自 36 篇论文的 1,029 个任务上,对四个模型比较原始发布代码与精化工件,并独立审计执行证据。精化工件持续提高复现成功率,降低 token 和 API 成本,并且在论文层面、更严格数值标准和不同审计器下收益仍然保持。定性分析表明,工件通过澄清测量规范、保存可执行流程和修复后的环境、修复错误来提供帮助,从而减少下游重建;消融表明代码和环境组件贡献最大,而指南和启动器也很重要。重复复用最终可以抵消构建 API 成本,支持在共享、重复复现场景中使用该方法。
在 1,463 个筛选任务中,大多数任务产生了与已发布分数兼容的参考测量,其中稳定复现是最大的单一类别。较小部分因数值不一致、执行阻塞或资源与访问限制而无法直接使用。兼容结果构成下游评估集。稳定复现占筛选任务的近一半,与可变复现一起提供了约十分之七的可用下游任务。数值不匹配和执行阻塞各自影响比例相近的少数任务,而资源或访问限制较少出现。
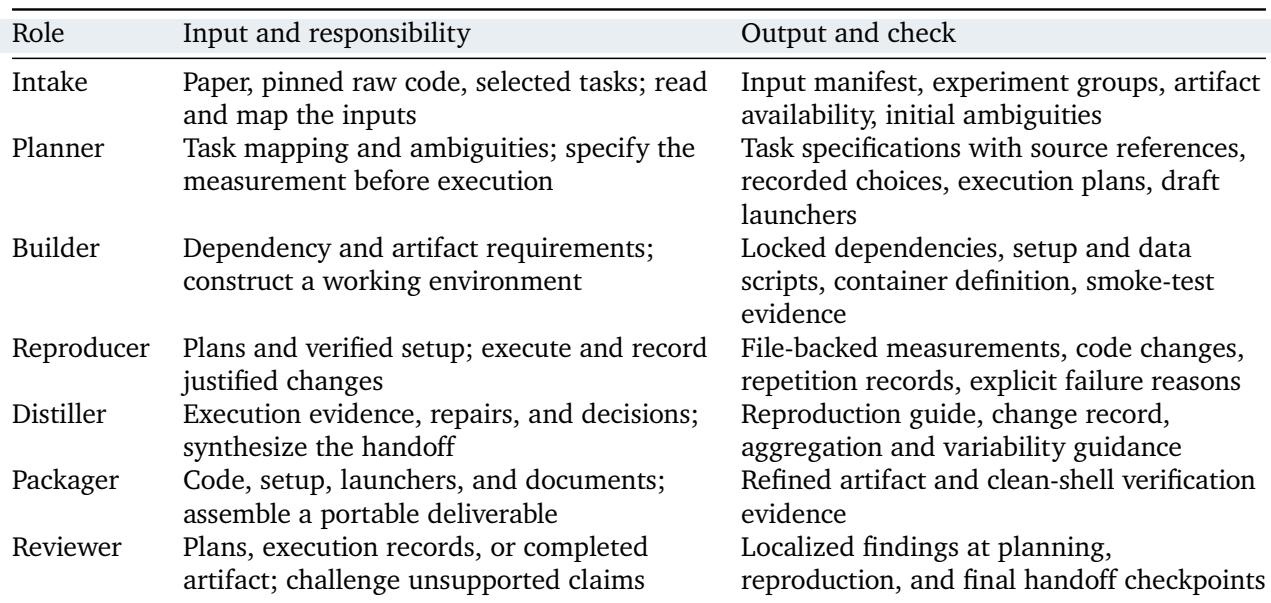
构建工作流分配不同角色,分别映射输入、规划测量、构建环境、执行、提炼指导、打包工件和审查证据。持久化输出连接各阶段,阶段门检查所需证据,独立审查在规划、复现和最终交接时质疑没有依据的声明。执行要求有文件支持的测量和明确的失败原因,交付则包括干净 shell 验证。持久化输出连接从输入清单和任务规范到执行记录、复现指南和变更记录的各个阶段。checkpoint 审查器在与被审查角色相隔离的上下文中运行,并返回局部发现以供修订和重新检查。
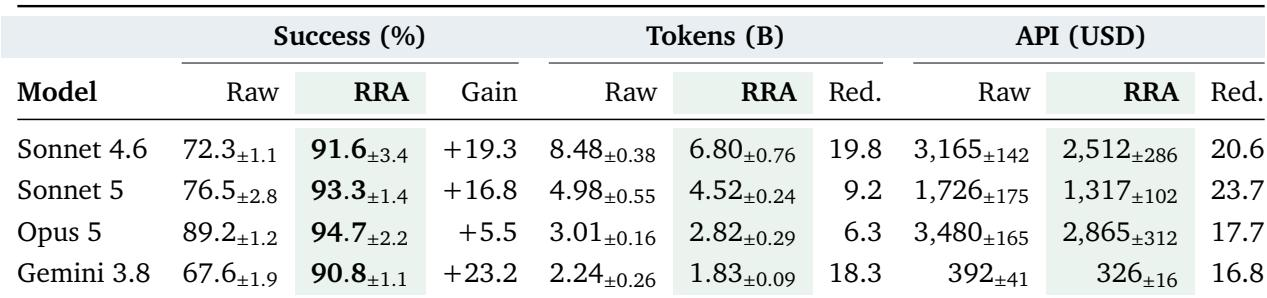
精化可复现工件提高了每个被测试模型的成功率,对原始成功率较低的模型提升更大。它们还降低了 token 消耗和 API 支出,包括失败尝试的消耗。跨模型成功率差距大幅缩小,并且在论文等权处理和更严格数值兼容条件下收益仍然保持。精化工件将成功率提高 5.5 到 23.2 个百分点,同时跨模型差距从 21.6 个百分点缩小到 3.9 个百分点。token 使用量下降 6.3% 到 19.8%,API 支出下降 16.8% 到 23.7%,节省包括失败尝试。
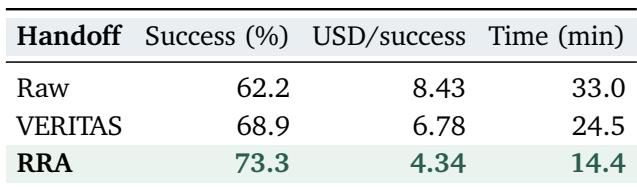
在一个高难度复现基准上,精化工件取得了最高的成功率,以及每个成功 capsule 的最低中位时间和支出。经过 VERITAS 修补的工件表现介于原始代码和精化工件之间。精化工件在每个评估领域都达到或超过原始代码的成功率。精化工件带来最高的成功率,并将中位复现时间相比原始代码减少一半以上。每个成功 capsule 的支出以精化工件为最低,VERITAS 介于原始和精化表现之间。
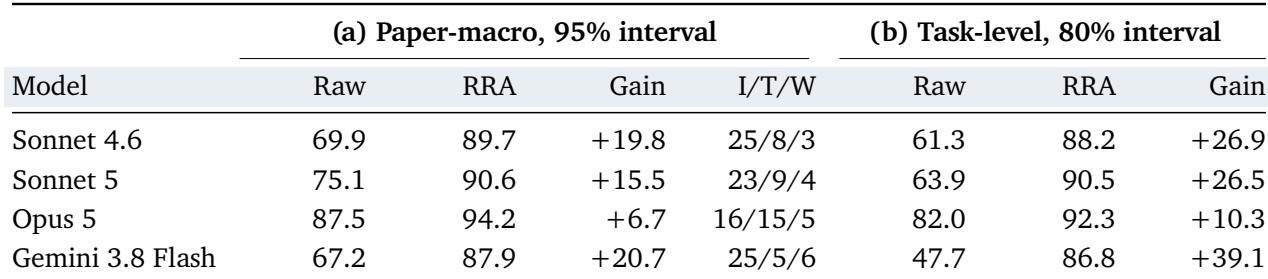
在主要 Codex 评分下,精化工件在论文宏平均和任务级评估中,对每个列出的模型都提高了相较于原始输出的成功率。在论文等权处理和更严格任务级区间下,这些收益仍然保持,且各模型中改进的论文数量多于恶化的论文。这支持了协议引导构建和执行复用超越原始代码表现的价值。任务级评估显示,Gemini 3.8 Flash 的原始到 RRA 增益最大,Opus 5 的增益最小。论文宏平均的改进/持平/恶化计数对所有模型都有利于 RRA,改进论文数量远多于恶化论文。
使用 1,463 个筛选论文任务,该工作流首先识别兼容测量,其中稳定复现构成最大组别,稳定加可变复现提供约十分之七的可用任务。构建过程强制角色分离、阶段门、文件支持的执行、干净 shell 验证和独立 checkpoint 审查。精化可复现工件提高了每个被测试模型的成功率,缩小了跨模型差距,并降低了 token 使用和 API 支出,包括失败尝试。在高难度复现基准上,它们取得最高成功率和每个成功 capsule 的最低中位时间与支出;在 Codex 评分下,这些收益在论文级和任务级评估中都保持,改进论文始终多于恶化论文。