Command Palette
Search for a command to run...
VFlash:通过 Flash Primitive Decoding 实现快速、准确的视觉规划
VFlash:通过 Flash Primitive Decoding 实现快速、准确的视觉规划
摘要
用于机器人技术、自动驾驶等物理 AI 任务的模型不必仅以语言进行推理。它们可以利用视觉规划——点、边界框和轨迹——来表示空间目标并预判运动。然而,自回归视觉语言模型逐个坐标 token 生成这些规划,使得更丰富的预测成本越来越高。我们提出 VFlash,一种通过 Flash Primitive Decoding 实现快速、准确视觉规划的方法。VFlash 利用视觉基元的已知结构,通过一个轻量级 drafter 在单次前向传播中生成整个基元,从而联合预测其坐标。该布局会根据基元的类型、维度和长度进行调整,支持紧凑的边界框以及长且可变长度的轨迹。关键在于,空间准确性并不要求复现自回归模型的确切 token 序列。因此,VFlash 在标注的基元上进行训练,并直接接受结构有效的预测,而无需目标 token 一致性。在所评估的 2D 和 3D 机器人轨迹任务中,与自回归解码相比,VFlash 一致降低了预测误差。初步单次 rollout 测量表明,3D 点运动预测的生成速度约提升 25 倍。以 VFlash 规划为条件的世界动作模型在四个 MolmoSpaces 任务套件中取得了 70.2% 的平均成功率,而基线为 62.6%。
一句话总结
作者提出 VFlash,一种快速且准确的视觉规划方法。该方法使用 Flash Primitive Decoding,通过轻量级 drafter 在一次前向传播中生成完整原语,以联合预测原语坐标;它接受结构有效的预测而无需 target-token 一致;在 2D 和 3D 机器人轨迹任务上降低预测误差;并实现约 25× 更快的 3D 点运动预测,使世界动作模型在四个 MolmoSpaces 任务套件上达到 70.2% 的平均成功率,而基线为 62.6%。
核心贡献
- VFlash 是一种基于 Flash Primitive Decoding 的快速视觉规划方法,使用轻量级 drafter 在一次前向传播中联合预测完整视觉原语,并支持紧凑边界框和长度可变的长期轨迹。
- 该方法在带标注的原语上训练,并直接接受结构有效的原语预测,无需与自回归模型在 token 序列上完全一致。
- 在所评估的 2D 和 3D 机器人轨迹任务中,VFlash 相对于自回归解码降低了预测误差。初步单次 rollout 测量表明 3D 点运动预测约快 25×,并且以 VFlash 计划为条件的世界动作模型在四个 MolmoSpaces 任务套件上达到 70.2% 的平均成功率,而基线为 62.6%。
引言
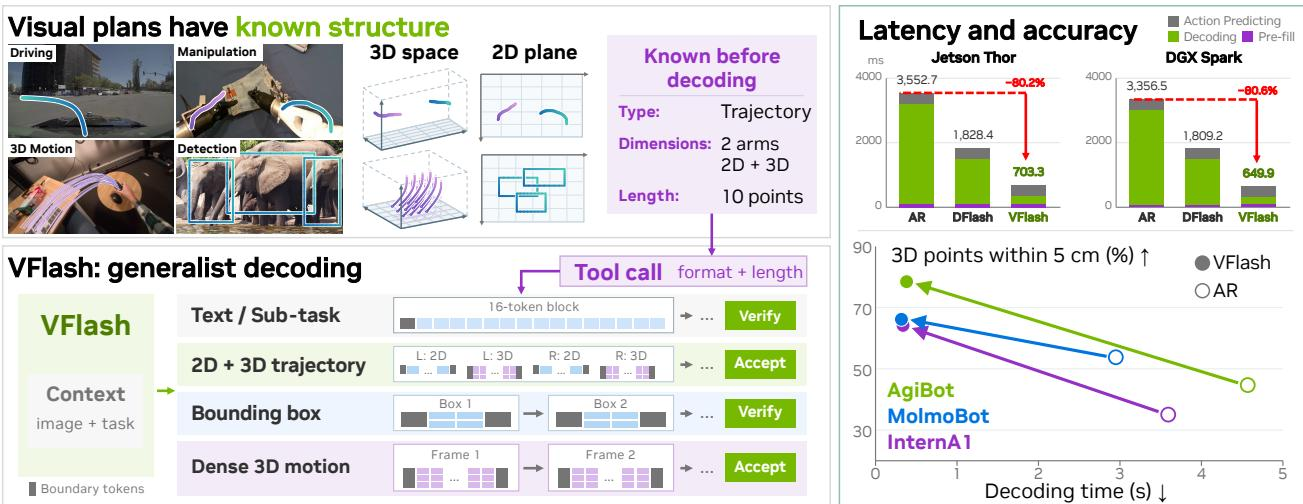
视觉语言模型越来越多地被用作物理 AI 系统的高层规划器,生成边界框、轨迹和稠密 3D 运动预测等视觉计划,使空间目标在动作前变得明确。这对机器人和自动驾驶很重要,因为这些视觉计划可以为下游动作模型提供条件,并且必须在延迟预算下快速更新。然而,自回归 VLM 顺序解码坐标 token,因此更长的轨迹、更多对象以及联合 2D/3D 输出需要更多解码步数;此前的并行方法要么在速度与质量之间取舍,要么仅限于固定尺寸的 2D 原语和 token 级验证。作者提出 VFlash,一个基于 Flash Primitive Decoding 的通用解码框架。该方法将 drafter 的训练和推理与完整视觉原语边界对齐,使用以冻结目标 VLM 特征为条件的轻量级扩散 drafter,在一次前向传播中预测整个原语,并在文本上保留经验证的推测解码的同时,接受结构有效的视觉草稿而无需 target-token 一致。
方法
作者提出了 VFlash,一个面向物理 AI 的通用解码框架,用于加速空间预测生成。该方法建立在 DFlash 的推测解码范式之上,引入 Flash Primitive Decoding,以直接接受结构有效的视觉原语取代 token 级验证。
在传统推测解码中,草稿模型提出一个 token 序列,目标模型并行验证该序列。然而,token 级一致并不一定反映空间准确性。VFlash 保留草稿架构,但将并行预测单元从任意文本 token 转变为完整视觉原语,例如边界框、机器人轨迹或未来点位置。每个原语由 schema 管理,schema 指定其类型、坐标维度和范围。
如下图所示:
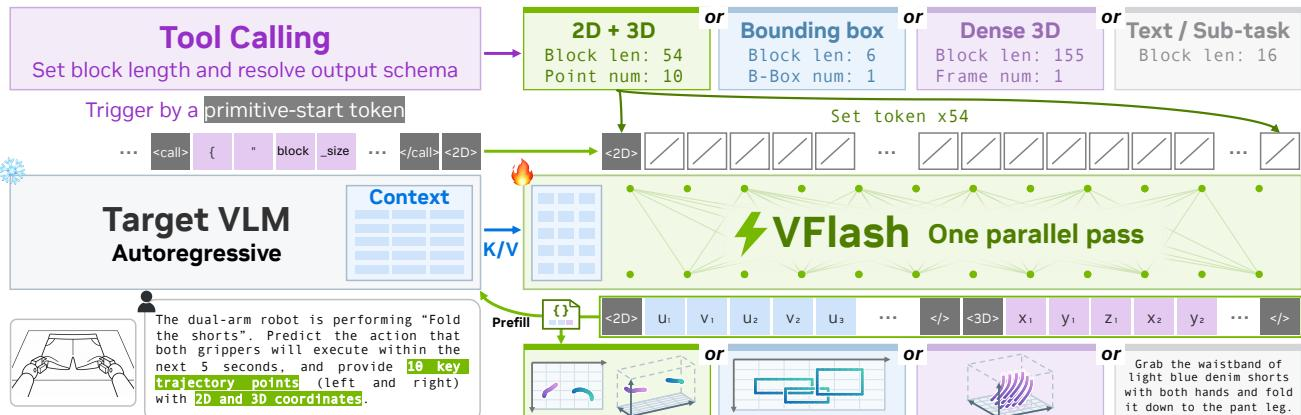
该框架依赖 token 表示的两个核心设计原则:边界对齐和位置对齐。边界对齐确保每个草稿块覆盖一个完整原语,避免固定长度窗口造成的碎片化。工具调用声明块长度和布局,使整个原语能够在一次双向前向传播中完成草稿。位置对齐在解码开始前为每个槽位分配已知角色,例如特定航点、轴或分隔符。为保持固定宽度布局,作者同时支持特殊坐标 token 和文本分词目标。对于基于文本的目标,每个坐标分配固定数量的位置,未使用的高阶位置用 mask tokens 填充。该固定宽度网格保留位置角色,并无缝渲染回目标文本格式。
在训练过程中,作者使用 next-token 监督将自回归视觉语言模型适配到空间响应格式。随后冻结目标模型,并在其提取的特征上训练一个浅层非因果 drafter。给定带标注块,训练目标最小化加权交叉熵损失:
Lprim=−j=1∑B(s)−1wjlogqϕ,j(aj∣Hθ(x),a0,MASKB(s)−1)其中 B(s) 是由 schema 定义的块长度。所有 logits 在单次前向传播中联合计算。关键在于,标签直接来自带标注坐标或渲染网格,而不是自回归续写。这使 drafter 针对空间准确性进行优化,而非仅仅追求 token 级一致。对原语位置应用均匀权重,并使用打包注意力保持独立块相互分离,同时保留块内注意力。
在推理期间,解码过程运行标准 DFlash 块,直到 primitive-start token 被接受。随后解码器解析已声明的 schema,并在一次并行传递中草拟长度为 B(s) 的完整块。逐位置约束将坐标和分隔符限制在其合法词表中,跨位置规则将画面外坐标配对。这些约束直接作用于计算出的 logits,无需额外神经评估。接受测试被 schema 验证器替换,对于边界框还包含空间置信度守卫。若原语有效,则整体提交,无需 token 级一致,仅需一次目标传递来更新缓存和上下文特征。将该直接接受机制代入延迟方程得到:
Ldir=B(s)tpar+ttarget该设计确保每个 token 的延迟保持不变,而不管原语复杂度如何,因为更详细的计划不会增加顺序解码步数。
实验
实验使用定制的具身 VLM、按任务自回归目标以及单独训练的 drafter 评估 VFlash,动作模型以冻结 VLM 的视觉计划特征为条件。视觉原语评估显示,在 2D 和 3D 轨迹、边界框和稠密运动预测上性能提升或具有竞争力,同时解码速度大幅提高,并在严格或稠密指标上存在一些权衡。下游方面,视觉计划条件化提高了操作成功率和 LIBERO 稳健性,尤其在联合 2D+3D 计划下,并且在不更新规划 VLM 的情况下获得了具有竞争力的自动驾驶结果。吞吐量分析将延迟降低主要归因于解码,并表明 token 级验证限制了子任务文本的收益,而视觉原语的块级草拟速度要快得多。
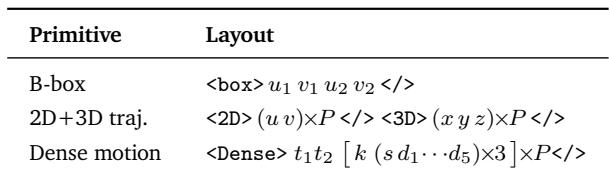
原语布局围绕完整原语组织视觉计划块,并通过共享模板在解码前为每个槽位分配固定角色。它们覆盖边界框、2D 和 3D 轨迹以及稠密运动,使用点数计数和特殊 token 保持坐标位置一致。固定宽度特殊坐标 token 避免了文本分词差异,这支持并行预测和逐位置约束。每个原语块都是边界对齐的,因此一个块覆盖完整原语,而不是固定长度窗口。特殊坐标 token 只占据一个位置,防止长度可变的文本分词偏移后续坐标。
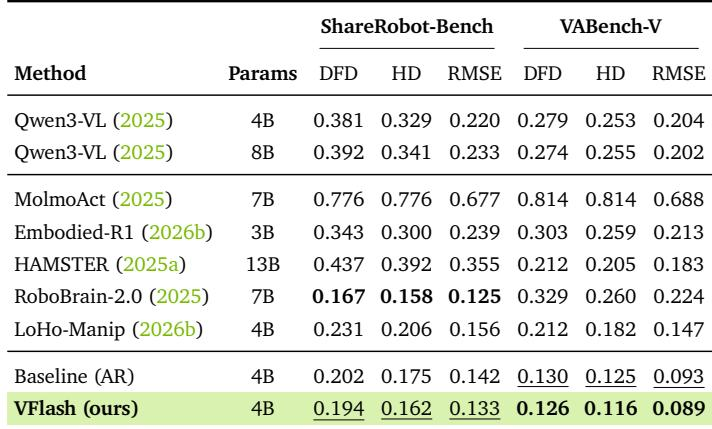
开环 2D 轨迹预测显示,在 ShareRobot-Bench 和 VABench-V 上,VFlash 始终优于其自回归目标。在 DFD、HD 和 RMSE 上提升广泛,VFlash 在 VABench-V 上尤其强,而在 ShareRobot-Bench 上仅次于 RoboBrain-2.0。相对于其 AR 基线,VFlash 降低了全部六项轨迹误差,HD 约改善 7%,DFD 和 RMSE 改善 3-6%。与此前模型相比,VFlash 在 VABench-V 上的误差降低约 40%,在 ShareRobot-Bench 上排名第二,仅次于 RoboBrain-2.0。
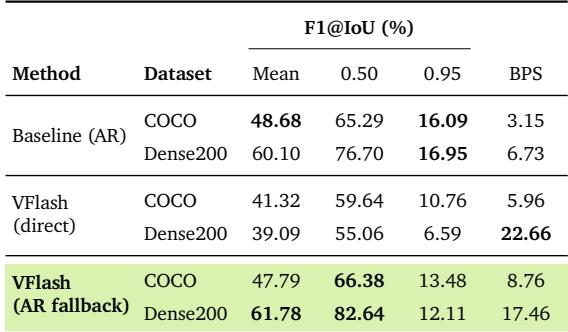
在 COCO 和 Dense200 上,采用 AR 回退的 VFlash 在平均 F1 上接近自回归基线,同时解码边界框速度约快 2.6 到 2.8 倍。回退设置在 IoU 0.50 下提高了 F1,尤其在密集场景中,但在 IoU 0.95 下落后于基线。无验证的直接生成最快,但 F1 最弱,且在 Dense200 上平均 F1 大幅下降。采用 AR 回退的 VFlash 在两个数据集上的平均 F1 大致与基线相当。回退配置解码边界框的速度约比自回归基线快 2.6 到 2.8 倍。回退在 IoU 0.50 下提高 F1,尤其在 Dense200 上,但会降低 IoU 0.95 下的 F1。无验证的直接生成最快,但在 Dense200 上的平均 F1 明显更低。
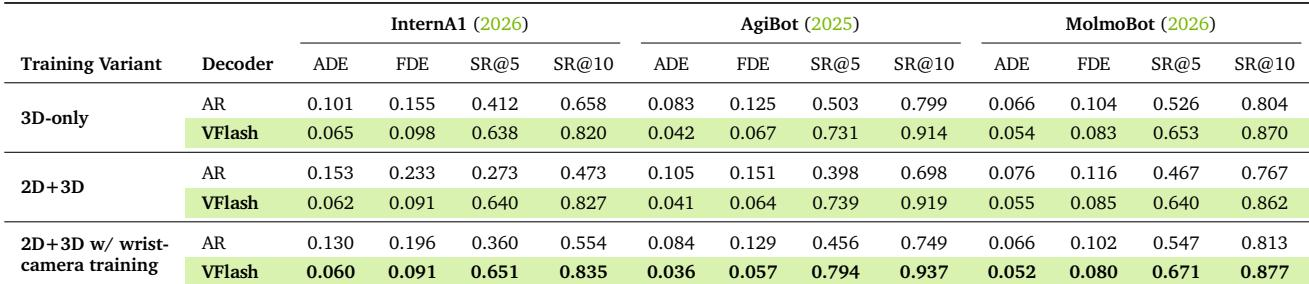
VFlash 在 InternA1、AgiBot 和 MolmoBot 上,相对于 AR 解码,在所有指标和每种目标变体下均改善了开环 3D 轨迹预测。航点精度大幅提高,且 VFlash 在联合预测 2D 和 3D 输出时保持相似的 3D 精度,而 AR 会变差。训练期间添加腕部相机视角进一步降低 VFlash 误差,即使评估仅使用主相机。VFlash 在所有数据集和目标变体上降低了 ADE 和 FDE,并提高了 5 cm 和 10 cm 处的航点精度。在同时输出 2D 和 3D 时,AR 3D ADE 相比仅 3D 输出恶化 15% 到 51%,而 VFlash 保持相似精度。腕部相机训练进一步将 VFlash ADE 降低 3% 到 12%,且无需改变单视角评估输入。
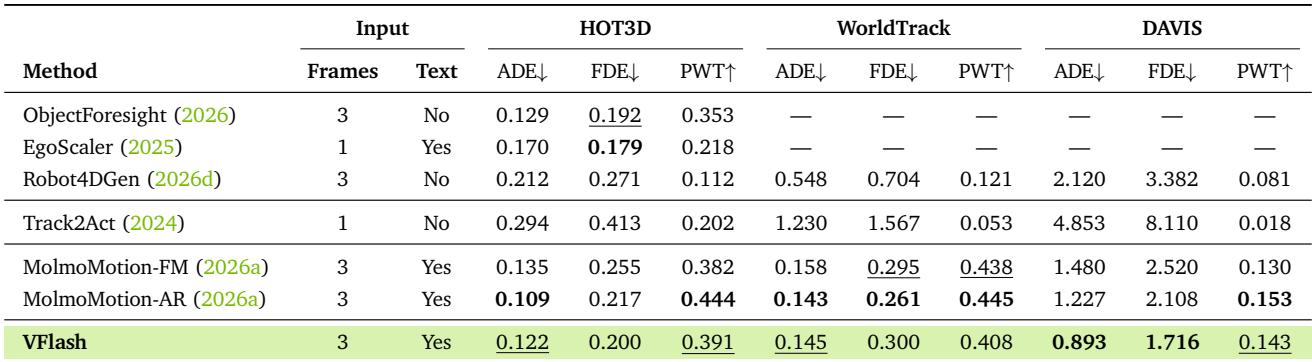
对于稠密 3D 点运动预测,VFlash 使用文本 token 化坐标草拟查询点未来帧,并以 MolmoMotion-AR 作为目标。它将 DAVIS ADE 和 FDE 分别降低 27% 和 19%,将 HOT3D FDE 降低 8%,同时在 HOT3D 和 WorldTrack ADE 上排名第二,仅次于 AR 目标。该方法在单次 rollout 生成中约快 25×,但部分跟踪指标落后。VFlash 相对于其 AR 目标将 DAVIS ADE 和 FDE 改善 27% 和 19%,并将 HOT3D FDE 降低 8%。VFlash 在 HOT3D 和 WorldTrack ADE 上排名第二,领先于 flow-matching 变体但落后于 AR 目标,而一些航点跟踪指标较低。
实验评估了 VFlash 基于原语的布局在开环 2D 和 3D 轨迹预测、边界框生成和稠密点运动预测上的表现。VFlash 在轨迹基准上始终优于其自回归目标,在使用自回归回退时紧密匹配边界框生成 F1,同时解码速度大幅提高,并在联合 2D 和 3D 预测下保持 3D 精度。对于稠密运动,它改善了 DAVIS 和 HOT3D 误差,但在若干跟踪指标上仍落后于自回归目标。