Command Palette
Search for a command to run...
SLA:通过持续预训练扩展空间-语言-动作模型
SLA:通过持续预训练扩展空间-语言-动作模型
Fuhao Li Wenxuan Song Qizhou Huang Ziyang Zhou Jingbo Wang Junwu E Pengwei Wang Yan Wang Shunbo Zhou Haoang Li
摘要
可靠的机器人操作需要语义理解与三维空间中的精确控制。然而,视觉-语言-动作(VLA)基础模型主要从二维视觉-语言预训练中继承视觉表示,而空间监督通常仅在任务特定适配阶段引入。因此,将空间理解发展为可迁移的基础模型能力需要从更广泛的机器人经验中学习。我们提出 SLA,一种空间-语言-动作模型,它将隐式空间对齐扩展到持续预训练阶段,并在下游后训练期间保持该对齐。SLA 从预训练的 π0.5 策略初始化,联合优化动作预测以及中间视觉嵌入与来自冻结三维感知模型的空间表示之间的对齐。我们整理并统一异构机器人数据集,以支持跨不同本体、任务和场景的空间学习。为适应这种多样性,我们引入特征依赖门控,自适应地聚合来自多个 VLA 层的视觉嵌入以进行空间监督。教师模型进一步利用部分可用的深度和相机标定以及 RGB 观测,从而有效利用异构几何标注。概率状态丢弃鼓励对视觉线索的依赖,并减轻对演示轨迹的过拟合。所有辅助组件仅在训练期间使用,从而可以直接复用预训练 VLA 权重,并保持原始推理架构。广泛评估表明,SLA 在 RoboDojo-Real、RoboTwin 2.0(Clean2Random 设置)、RoboCasa-Panda 和 LIBERO-Plus 上取得了最先进性能,凸显其强大的泛化能力和下游数据效率。在八个真实世界部署条件中,SLA 进一步将平均成功率相较于 π0.5 提高了 24.0 个百分点。
一句话总结
来自香港科技大学(广州)、OLA Dimensions、北京智源人工智能研究院和清华大学的研究人员提出 SLA,一种空间语言-动作模型,将隐式空间对齐扩展到从预训练 π0.5 策略进行的持续预训练,利用特征相关门和概率状态 dropout 在 RoboDojo-Real、Clean2Random 设置下的 RoboTwin 2.0、RoboCasa-Panda 和 LIBERO-Plus 上取得最优性能,并在真实世界平均成功率上较 π0.5 提升 24.0 个百分点。
核心贡献
- SLA 是一种空间语言-动作模型,从预训练的 π0.5 策略初始化,并在持续预训练和下游后训练期间联合优化动作预测以及中间视觉嵌入与来自冻结 3D 感知模型的空间表示之间的对齐。
- 统一的异构机器人数据集支持跨多种本体、任务和场景的空间学习,特征相关门自适应聚合来自多个 VLA 层的视觉嵌入以进行空间监督。教师模型利用部分可用的深度和相机标定以及 RGB,概率状态 dropout 鼓励依赖视觉线索并减少对演示轨迹的过拟合。
- 所有辅助组件仅在训练期间使用,可以直接复用预训练 VLA 权重并保持原始推理架构。评估报告在 RoboDojo-Real、Clean2Random 设置下的 RoboTwin 2.0、RoboCasa-Panda 和 LIBERO-Plus 上达到最优性能,且在八个部署条件下真实世界平均成功率较 π0.5 提升 24.0 个百分点。
引言
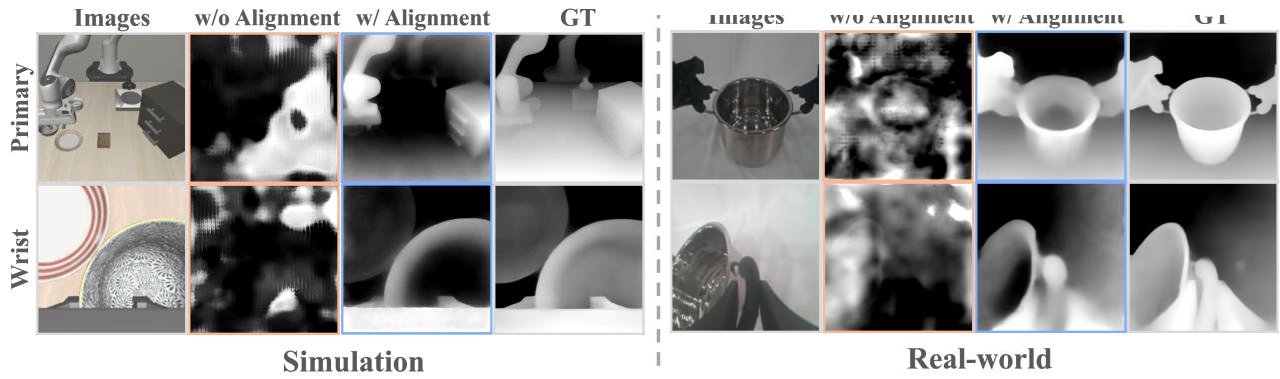
机器人操作需要在 3D 环境中进行精确的空间推理和物理控制,而不仅仅是识别物体和遵循指令。由预训练 2D 视觉-语言模型构建的视觉-语言-动作模型是有前景的通用策略,但其以 2D 为中心的预训练提供的 3D 空间理解有限,此前在后训练期间添加深度或点云输入的尝试面临传感器噪声、异构机器人硬件以及许多数据集缺失深度的问题。即使是 Spatial Forcing 等隐式空间对齐方法也一直只在后训练阶段使用,使空间能力成为任务特定的附加能力,而不是可迁移的基础能力。作者提出 SLA,一种空间语言-动作模型,通过在持续预训练和下游后训练期间将现有 VLA 的中间视觉嵌入与来自冻结 3D 感知基础模型的空间表示对齐,发展出通用的 3D 空间理解能力。该监督保留了原始 VLA 架构和动作头,使模型能够复用预训练的 π0.5 知识,同时学习更丰富的几何表示以实现精确操作。
数据集
数据集概览
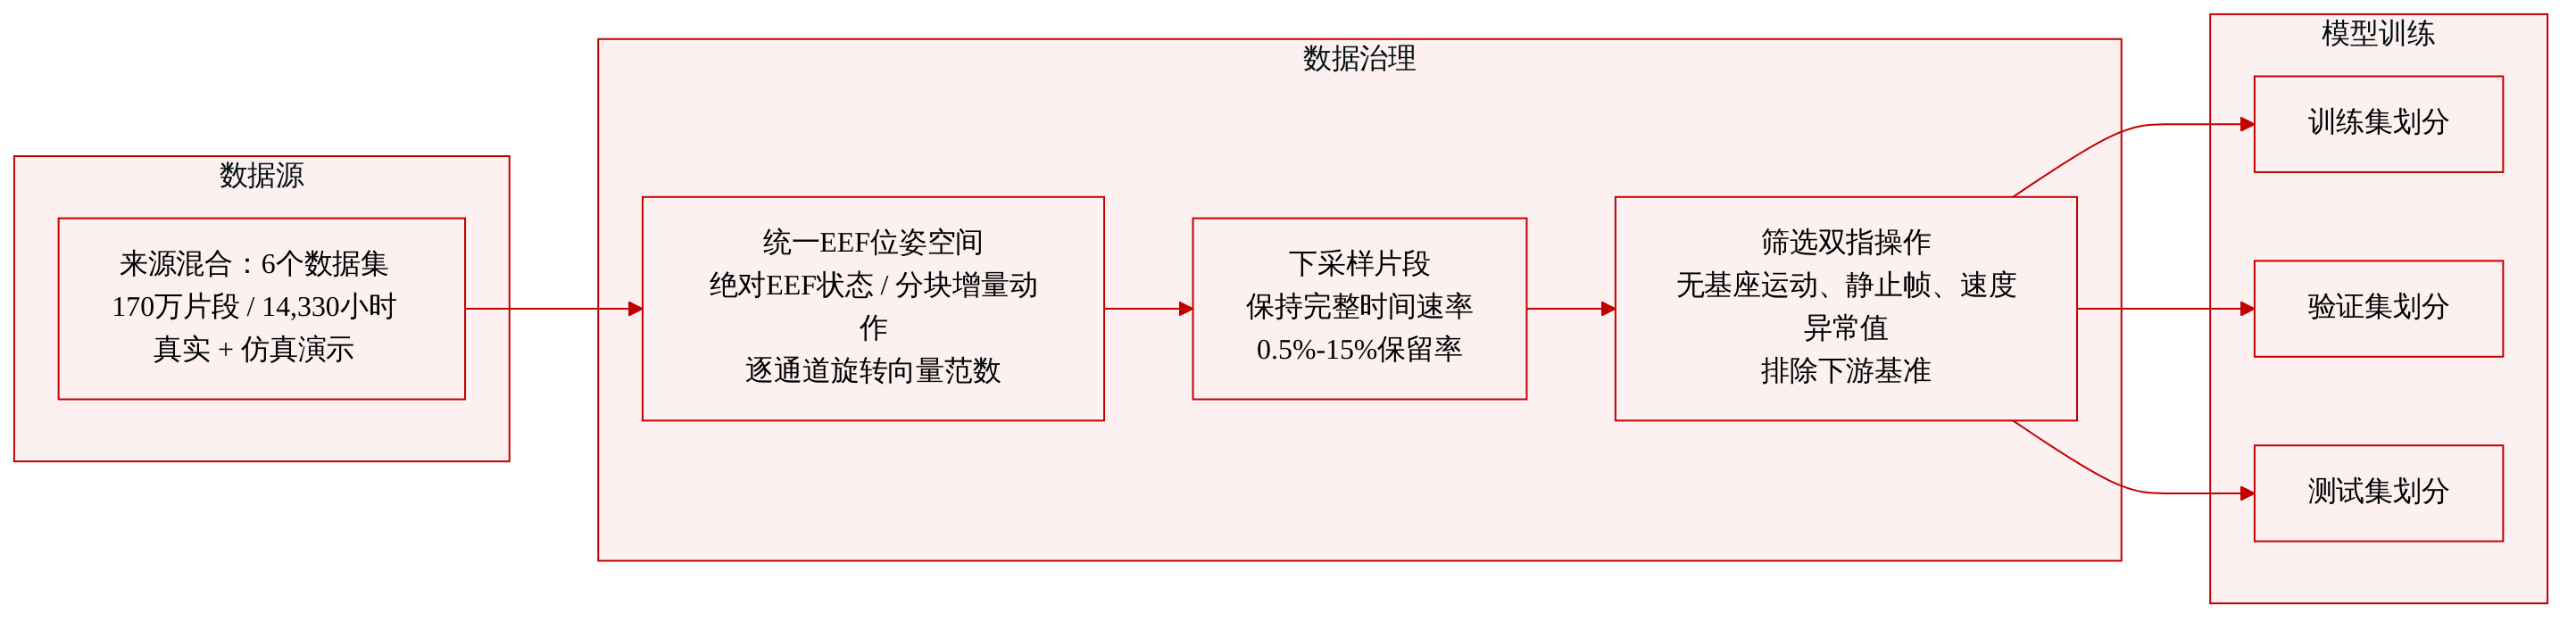
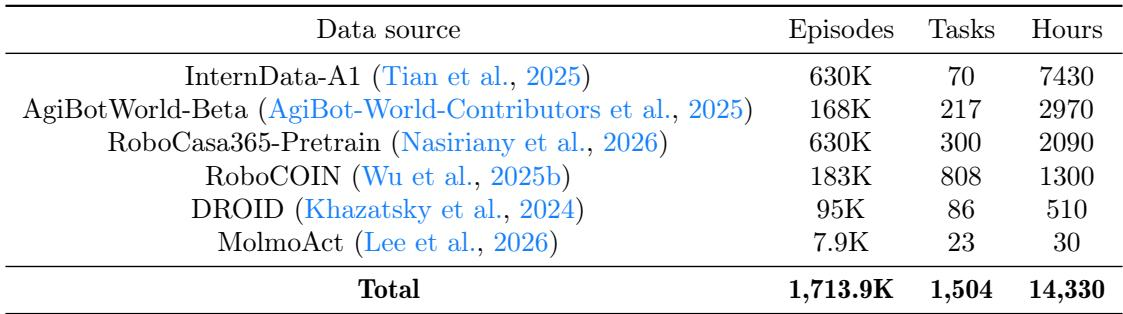
作者构建了一个用于视觉-语言-动作模型持续预训练的大规模语料。它结合了六个来源数据集,总计约 170 万个 episode 和 14,330 小时演示。所有来源都经过统一的数据整理和预处理流水线,使机器人状态和动作标注在不同本体、任务和环境中保持一致。
来源与构成
- RoboCOIN:来自异构机器人的真实世界双手操作演示,增加了本体和观测多样性。
- AgiBot World Beta:大规模真实世界操作集合;作者保留无移动底座运动的二指夹爪演示。
- DROID:Franka 机器人在多样化真实世界环境中的演示;用于补充稀缺的单臂真实机器人经验,质量和标注精度存在一定差异。
- InternData-A1:合成脚本策略轨迹;作者使用 Split ALOHA、Lift2 和 Franka 子集,以覆盖更广泛的仿真场景、资产和纹理。
- MolmoAct:针对特定任务和场景的真实世界 Franka 演示,进一步补充单臂真实机器人经验。
- RoboCasa365:仿真厨房家庭任务;作者移除带底座运动的轨迹后,使用预训练 atomic、composite 和 MimicGen 子集,不使用 post-train 子集。
- 下游基准数据被排除在持续预训练语料之外,以防止评估泄漏。
处理与标注规范
- 作者使用末端执行器位姿表示,而不是原始关节坐标。
- 观测为绝对 EEF 状态。
- 动作为 chunk 级 EEF 增量动作。
- 所有位姿都被映射到一致的机器人中心 EEF 坐标系。单臂机器人的原点为机械臂基座,双手机器人的原点为两个机械臂基座之间的中点。坐标轴为 +x 向前、+y 向左、+z 向上。
- 姿态使用旋转向量。相对旋转通过 SO(3) 复合计算:
- Δp_t = p_t - p_0
- ΔR_t = R_t R_0^T
- Δr_t = Log(ΔR_t)^∨
- 同一 chunk 中的所有动作都使用同一当前位姿作为参考,而不是使用前一动作。
- 旋转向量通道按通道归一化。
降采样与过滤
- 作者通过对任务内完整 episode 进行子采样来减少冗余轨迹,同时保留所保留轨迹的原始时间采样率。
- InternData-A1 保留率:选定的高度重复任务为 3%,其他任务为 10%。
- RoboCasa365 预训练保留率:MimicGen episode 为 0.5%,composite episode 为 15%。
- 这些按来源和按任务变化的保留率使 episode 数量规模更加接近。
- 作者仅保留二指夹爪操作,排除灵巧手数据和带机器人底座运动的轨迹。
- 使用动作统计信息去除异常的手臂运动速度。
- 当可用标注识别出静止帧时,会移除机器人和场景都保持不动的帧。
数据使用方式
处理后的语料用于 VLA 模型的持续预训练。所提供章节未指定六个数据集的固定最终混合比例。相反,作者通过过滤以及按来源、按任务进行降采样来平衡各来源,同时排除下游基准数据以保持评估有效。
方法
作者提出 SLA,这是一个通过持续预训练构建可扩展 3D 视觉-语言-动作基础模型的框架。该方法从预训练的 2D VLA 主干出发,利用外部空间表示监督来塑造模型的视觉表示,同时保留原始主干和动作生成架构。
为了提供丰富的空间信息,作者将一组多视图图像输入冻结的外部 3D 感知基础模型。该模型输出像素级 3D 表示,并为其添加位置嵌入以保留关键的空间位置顺序。最后一层表示被双线性重采样到 VLA token 分辨率,以获得每个视觉 token 位置上的空间目标:
y=R[f3D(I)+E]其中 R[⋅] 表示双线性重采样操作。
为了将 VLA 逐像素视觉 token 与这些外部 3D 信号对齐,作者对每个视觉 token 先进行层归一化,再经过两层 MLP。由于 VLA 包含多个因果注意力层,该方法将所有层的投影特征自适应聚合为统一表示 z:
\mathbf{z} = \sum_ {\ell = 1} ^ {L} ^ {(\ell)} \mathbf {g} \odot \mathrm{MLP} \Big [ \mathrm{LN} \Big (^ {(\ell)} \boldsymbol {x} ^ {\nu} \Big) \Big ]其中 L 是 VLA 注意力层数,⊙ 表示逐元素乘法。然后使用余弦相似度来最大化 VLA 视觉 token 与外部空间表示信号之间的对齐:
Lalign=N1i=1∑N[1−S(zi,yi)]最终训练目标将标准动作生成损失与该 3D 对齐损失结合:
L=Laction+αLalign其中 α 控制空间对齐强度。推理期间丢弃辅助组件,确保不增加额外计算开销。
外部 3D 感知模型被构建为可适应训练语料中不均匀的几何标注。它利用 GeoAdapter 编码可用的相机内参、外参和深度图,在标注缺失时使用占位 token。这种随机多模态融合确保主干特征包含足够丰富的空间信息。
为处理异构预训练语料,作者实现了自适应层选择策略。该方法不是固定单一对齐层,而是为每个 VLA transformer 层上的每个视觉 token 学习一个特征相关门:
(ℓ)gi=σ(Wg(ℓ)xiV+bg)其中 Wg 和 bg 分别是可学习权重矩阵和偏置向量,σ 是逐元素 sigmoid。这些门对投影特征进行加权并在各层上求和,使不同视觉线索能够贡献于统一的空间表示,且不会在部署时增加策略计算。此外,训练期间应用状态 dropout 机制随机省略状态 token 片段,防止策略依赖本体感觉捷径,并强制其编码场景几何。
为确保不同机器人形态下控制表示的一致性,作者通过末端执行器位姿而非关节坐标来表示动作。所有位姿都被映射到统一的机器人中心坐标系。旋转格式的选择对一致的动作目标至关重要。直接相减欧拉角作为增量动作,可能会将跨越角度环绕边界的小物理旋转转换为较大数值位移。如下图所示,这种环绕引起的离群值会在归一化后严重压缩典型动作值的范围,阻碍训练。
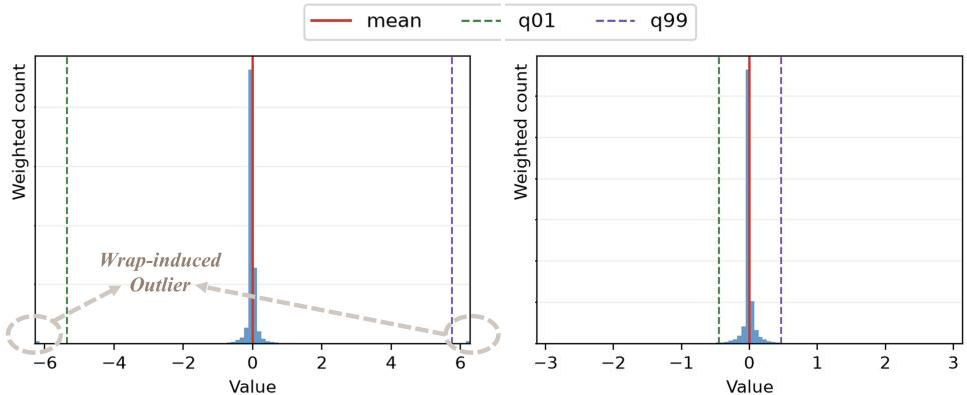
为解决该问题,作者使用旋转向量表示姿态,并通过 SO(3) 复合计算相对旋转。对于给定的当前绝对末端执行器位姿 (p0,R0) 和目标位姿 (pt,Rt),增量位置、相对旋转矩阵和旋转向量计算如下:
Δpt=pt−p0 ΔRt=RtR0⊤ Δrt=Log(ΔRt)∨其中 Log(⋅)∨ 将相对旋转矩阵映射为其旋转向量表示。该方法确保旋转向量通过其方向和大小保持统一的物理含义。数据流水线还结合降采样以减少高度重复的脚本仿真数据中的冗余,同时进行过滤以排除异常手臂运动速度和静止帧。
实验
实验从预训练的 π0.5 策略出发对 SLA 进行持续预训练,并在三个仿真基准、一个真实世界基准和多个真实世界部署上进行后训练,这些场景涵盖视觉和语言扰动、场景变化、双手协调和跨本体操作。在这些设置中,SLA 持续优于 π0.5、Spatial Forcing 和其他最优方法,在 Clean2Random 泛化、多本体适应以及移动目标和未见物体等具有挑战性的真实世界条件下提升尤为明显。消融进一步验证,在持续预训练和后训练期间同时施加空间监督、使用自适应层融合、适度的状态 dropout、旋转向量以及为教师模型使用相机标定,都共同促成了最佳性能。
在选择和处理之前,六个来源数据集总共包含约 170 万个 episode 和 14,330 小时演示。InternData-A1 和 RoboCasa365-Pretrain 是 episode 数量最大的来源,而 RoboCOIN 的任务数最多,MolmoAct 总体规模最小。这些来源涵盖异构真实世界平台,包括双手和单臂操作设置。按 episode 数量计算,InternData-A1 和 RoboCasa365-Pretrain 在处理前是最大的来源,远超其他数据集。RoboCOIN 在来源中贡献了最大的任务多样性,而 MolmoAct 的 episode、任务和小时数都最少。合并来源提供约 14,330 小时演示,大规模操作数据集占其中大部分。与最大的数据集相比,DROID 和 MolmoAct 的演示池小得多。
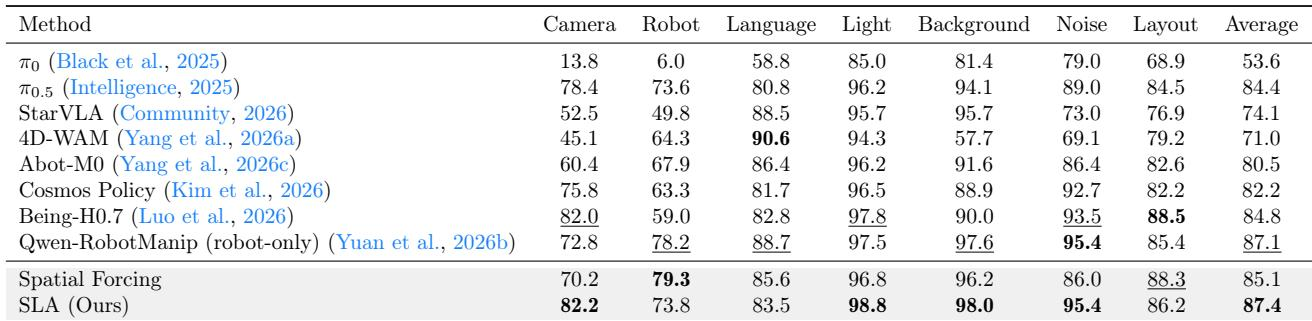
SLA 在相比策略中报告了最高的 LIBERO-Plus 加权成功率,优于所报告的基线和列出的其他模型。其提升是广泛的而非孤立的,出现在基准评估的全部七个扰动维度上。在观测噪声和背景变化等具有挑战性的视觉条件下,改进尤其明显。SLA 以 87.4% 的加权成功率领先对比方法,比主要基线高 3.0 个百分点,比 Spatial Forcing 高 2.3 个百分点。SLA 在每个扰动维度上都较基线有所提升,并在对比方法中取得最高的光照扰动得分,在观测噪声和背景变化上有明显提升。
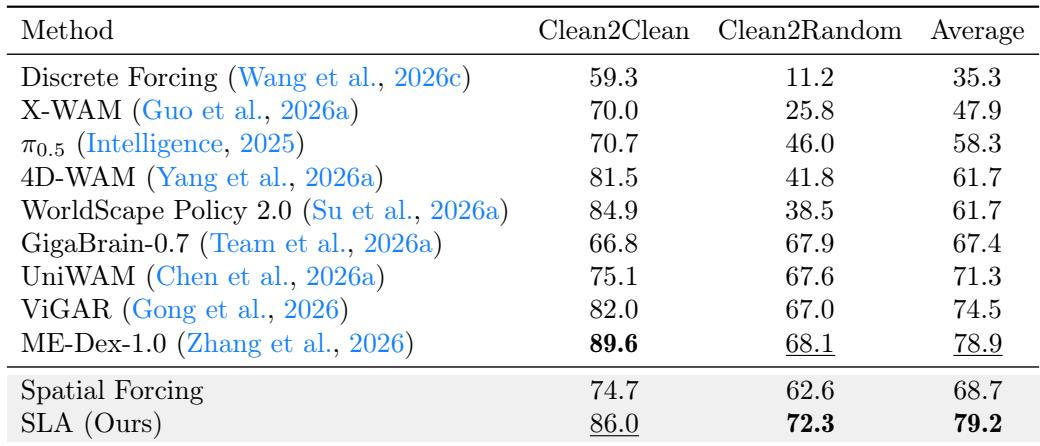
SLA 在 RoboTwin 2.0 基准上报告了 79.2% 的平均成功率。其优势在 Clean2Random 设置中最强,大幅超过 π0.5,并优于平均成绩最强的竞争者,但在 Clean2Clean 上落后于该竞争者。这表明主要收益在于对域随机化的鲁棒性,而不是在与训练相似条件下的性能。Clean2Random 设置被描述为比 Clean2Clean 更严格的场景变化鲁棒性测试。SLA 相对 π0.5 的最大相对提升出现在 Clean2Random,在 Clean2Clean 和平均成功率上的提升较小。与平均成绩最强的竞争者相比,SLA 在 Clean2Random 成功率上有所提升,但在 Clean2Clean 上落后,表明其在泛化能力上有针对性改进。
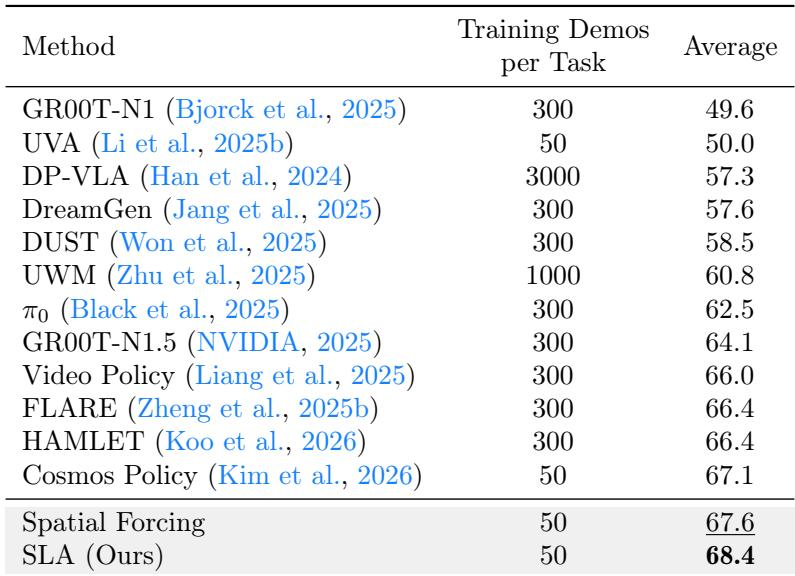
SLA 在 RoboCasa-Panda 基准上的平均成功率在对比方法中最高,在同样有限的后训练演示预算下略微领先 Cosmos Policy 和 Spatial Forcing。一些基线使用更大的演示预算,但平均成功率仍然较低。SLA 在任务级别也表现强劲,在 24 个任务中有 10 个成功率超过 80%。SLA 在各对比方法中平均成功率最高,在相同演示预算下以微弱优势领先 Cosmos Policy 和 Spatial Forcing。SLA 在 24 个任务中有 10 个成功率超过 80%,包括在 TurnOfMicrowave 上取得完全成功。
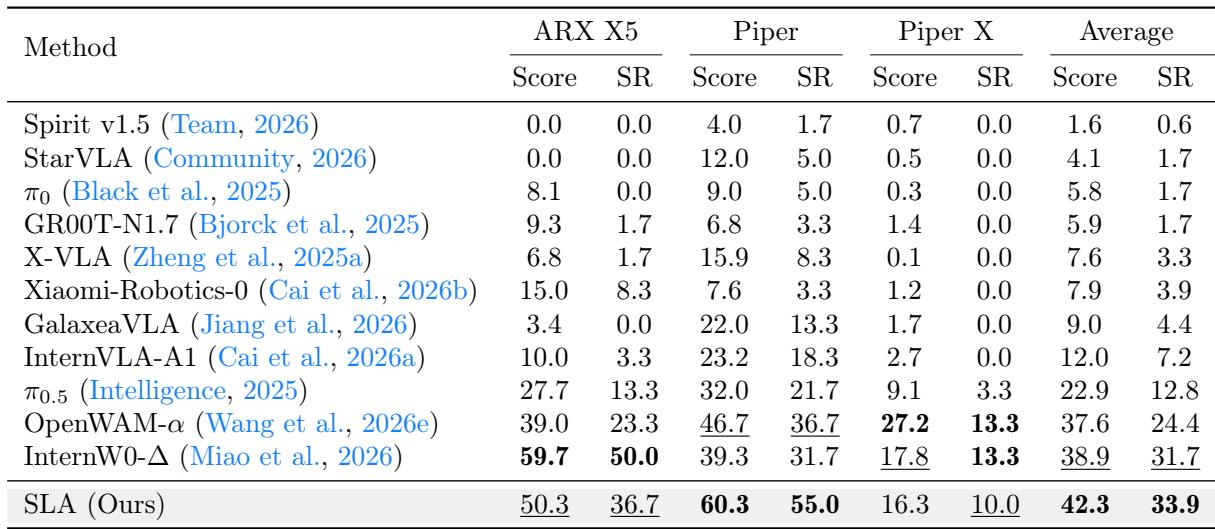
SLA 在 RoboDojo 真实世界基准上取得最高的总体得分和成功率,优于包括 π0 和最强竞争者 InternW0-∆ 在内的此前方法。其优势在 Piper 上尤为明显,在两项指标上均排名第一,而在 ARX X5 上排名第二。这些结果支持所提训练方法在联合多本体适应方面的有效性。SLA 在平均得分和成功率上均领先所有对比方法,比 π0 高 19.4 个得分点和 21.1 个百分点。整体上,它比最强的竞争方法 InternW0-∆ 高 3.4 个得分点和 2.2 个百分点。SLA 在 Piper 的得分和成功率上均排名第一,在 ARX X5 上落后于 InternW0-∆ 排名第二。
评估首先分析了六个异构演示来源,合计约 170 万个 episode 和 14,330 小时,确认大规模操作数据集主导了数据量,而其中一个来源贡献了较高的任务多样性。随后在 LIBERO-Plus、RoboTwin 2.0、RoboCasa-Panda 和 RoboDojo 上测试 SLA,以验证扰动鲁棒性、域随机化下的泛化能力、有限预算下的任务学习以及真实世界多本体适应能力。在这些基准上,SLA 始终取得最佳或接近最佳的结果,在噪声视觉条件下、Clean2Random 设置中以及真实世界 Piper 性能上的提升尤为明显。