Command Palette
Search for a command to run...
表面之下:我们在谈论智能体演化时忽略了什么
表面之下:我们在谈论智能体演化时忽略了什么
摘要
智能体框架演化能够在无需更新模型权重的情况下实现递归自我改进(RSI)。我们考察较高的基准得分是否能带来可靠、高效且可迁移的改进。我们在不同框架、通用任务和编程任务上评估了四种方法。反复评估、受控智能体扩展、组件干预和准入重放揭示了反复出现的模式。所有 16 个演化后的智能体在获得此前未覆盖任务的同时,也丢失了此前已覆盖的任务。在某个通用任务场景中,尽管丢失了 10 个此前已覆盖的任务,可靠性仍提高了 5.2 分。大多数可靠性提升也增加了部署成本。具体改动通常优于通用提醒,但其收益在组合使用时会发生变化。得分最高的智能体在我们的四个候选池中均未带来最大的平均改进,更严格的准入可能会丢弃有用的备选方案。迁移选择性地保留收益:在两类框架和两种范式下,通用任务目标上的覆盖率通常下降,但在仅包含外层的框架中,编程任务目标上的覆盖率上升。这些发现促使我们提出保留感知的评估、经过检验的决策规则以及明确的适用条件。作为一项建设性后续工作,EvoAudit 将这些诊断转化为对选择、分析、变异和门控环节的修正,并取得了最佳性能。
一句话总结
来自中国科学技术大学、加州大学伯克利分校及合作机构的研究人员表明,agent harness 进化可以在提升基准分数的同时牺牲覆盖率、可靠性和可迁移性,并提出了 EvoAudit,将选择、分析、变异和准入阶段修改为保留感知的诊断流程,以获得最佳性能。
核心贡献
- 在四种 harness 进化方法及通用与编程任务中,重复评估、受控 agent 扩展、组件干预和准入回放显示,全部 16 个进化后的 agent 在获得此前未覆盖任务的同时也会失去此前已覆盖任务;在一个通用任务案例中,即使失去 10 个任务,可靠性仍提升 5.2 分,而可靠性提升通常会增加部署成本。
- 迁移具有选择性:在两种 harness 类型和范式下,覆盖率通常在通用任务目标上下降,但在仅外层 harness 下编程目标上上升;更严格的准入可能丢弃有用备选,这促使采用保留感知的评估、经过检验的决策规则和明确的适用条件。
- EvoAudit 将这些诊断转化为 select、analyze、mutate 和 gate 算子的修改,并取得最佳性能;AGE 在全部四种设置下都相对其参考方法提升了可靠性和覆盖率。
引言
语言模型 agent 的递归自我改进通常通过 harness 进化实现,即在保持模型权重固定的同时持续修改提示、技能、工具接口、编排或源代码。近期框架将执行、诊断、变异和评估闭环连接,并报告基准分数提升,但聚合分数可能掩盖退化、部署成本以及对进化中所用任务之外的泛化能力较弱。作者在通用和编程基准上研究了四种进化方法,并表明 harness 进化倾向于重新分配任务成功,而不是均匀地提升任务成功;有效提升取决于有效的起始 agent、兼容的变更以及保留强大变体的准入决策。基于这些发现,作者提出审计引导进化(Audit-Guided Evolution,AGE),通过修改诊断、变异、选择和准入算子来相对其参考方法提高可靠性和覆盖率。
方法
作者定义一个 agent A=(M,H),由冻结的模型 M 和 harness H 组成。进化算法 E 从 seed agent A0=(M,H0) 开始,运行 G 代。在每一代 g,选择一个 Parent 进行修改,产生一组候选 harness Cg。每个 H∈Cg 定义一个 Candidate agent (M,H),规则 Q 从归档版本中选择最终的 Champion harness H⋆:
Cg=E(H<g,Z<g,Devo;Bevo),H⋆=Q({H0}∪g=1⋃GCg)其中 H<g 是 harness 版本历史,Z<g 是其评估证据,Devo 是任务集,Bevo 是搜索预算。
在常见进化过程中,每个配方规定七个算子如何实现:select 选择一个 Parent,rollout 收集执行证据,analyze 诊断证据,mutate 提出一个 Candidate。validate 算子可选地检查提案,gate 决定是否准入,record 归档结果。
如下图所示:
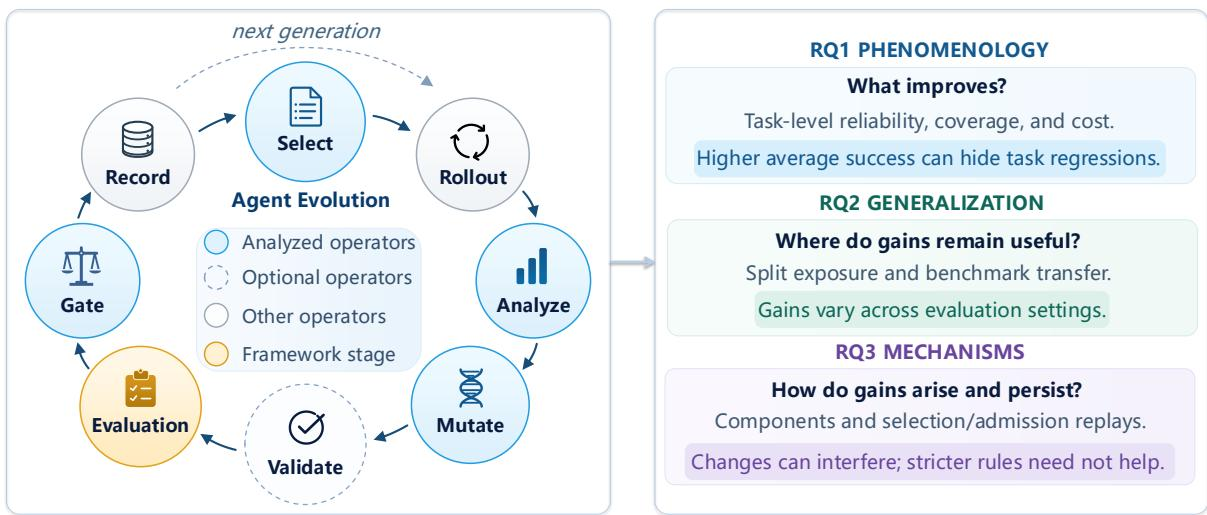
作者提出 EvoAudit,一个 agent 辅助的工作流,对归档产物运行诊断,并返回带有证据和验证记录的算子修改。将其四项修改安装到 A-Evolve 中,即得到 Audit-Guided Evolution (AGE)。EvoAudit 工作流包括若干阶段:Audit-Prepare 冻结输入和契约,Audit-Evaluate 运行诊断实验,Audit-Analyze 将发现和假设整理为证据报告,Audit-Mutate 修改算子实现,Audit-Validate 测试接口和回归,Audit-Gate 准入修改或报告失败。
如下图所示:
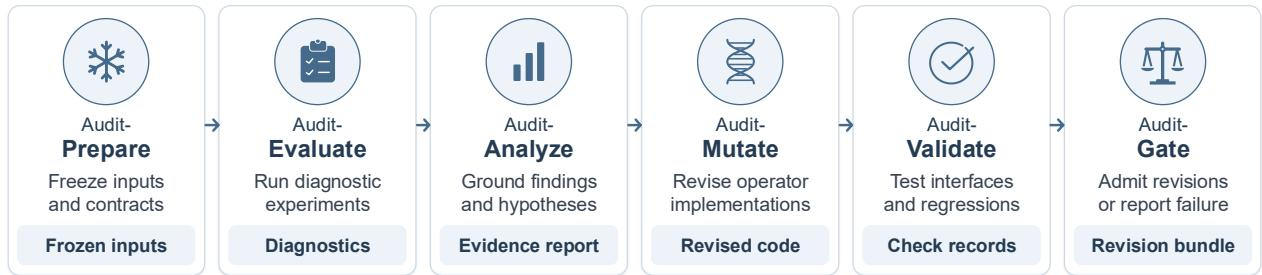
在 AGE 中,算子修改如下:
Select(选择):回归感知的并列打破。AGE 保留最高分目标,仅修改完全并列的情况。令 P 为具有有限已记录 Validation 分数 s(C) 的合格 Parent 集合,并令 T=argmaxC∈Ps(C)。当存在可比较的任务级证据时,选择在 T 中最小化 Seed 相对回归:
R(C)=t∈Dval∑I[rˉt(C)<rˉt(A0)],P∼Uniform(argC∈TminR(C))其中 Dval 是 Validation 任务集,rˉt 是任务 t 的平均已记录奖励。
Analyze(分析):行为基准诊断。分析器收集当前 rollout,并在可用时收集选定谱系上的前一个 rollout,保留最后 30 条记录。每个 judge 输入包含按时间顺序排列的工具调用、成功和失败的工具结果以及完成信号。judge 返回 score、category、outcome 和 failure_reason。分数 0 到 3 表示明显的失败,4 到 6 表示部分或不明确的进展,7 到 10 表示明显完成。
Mutate(变异):机制关联、依赖闭合的变更。变异 agent 接收选定的行为证据、Parent 工作区、提示和技能清单以及编辑契约。在选择文件之前,其指令要求提供观察到的行为、推断出的机制、替代行为、激活条件和预期权衡。该 agent 必须检查受影响的接口,进行一个连贯的干预,保留有用行为,并检查是否存在冲突指导。
Gate(准入):分数优先、成本感知的准入。AGE 保留严格的 Parent 相对分数改进,并加入成本并列打破。对于 Candidate C 及其匹配的 Parent P,在具有有限 Validation 分数的情况下,准入条件为:
accept(C,P)=I[s(C)>s(P)∨(s(C)=s(P)∧Q(C,P)∧c(C)<c(P))]其中 c 是规范 Validation 评估的记录 USD 成本。可比较谓词 Q 要求匹配的任务集哈希、有限且严格为正的成本,以及直接的 Parent 评估。
实验
该研究使用 GPT-5.4 在两种 harness 下评估四种 agent 进化配方,其中两种以实现为中心、两种以反思为中心:源码可编辑的 MiniSWE 和仅外层的 Codex,覆盖通用银行和编程基准。主要发现是:进化重新分配任务成功,而不是带来单调的覆盖率提升;可靠性与覆盖率常常背离;对留出任务或外部任务的泛化能力随 harness 和范式不同而变化。机制分析表明,当前分数不能可靠地识别最佳 parent,特定于轨迹的变更优于通用指导,变异受益于保留依赖关系,准入约束的影响依赖于 harness;专家评审支持证据引导的修改,组合后的 AGE 方法在相对 A-Evolve 提高可靠性和覆盖率的同时,损失的 Seed 已覆盖任务更少。
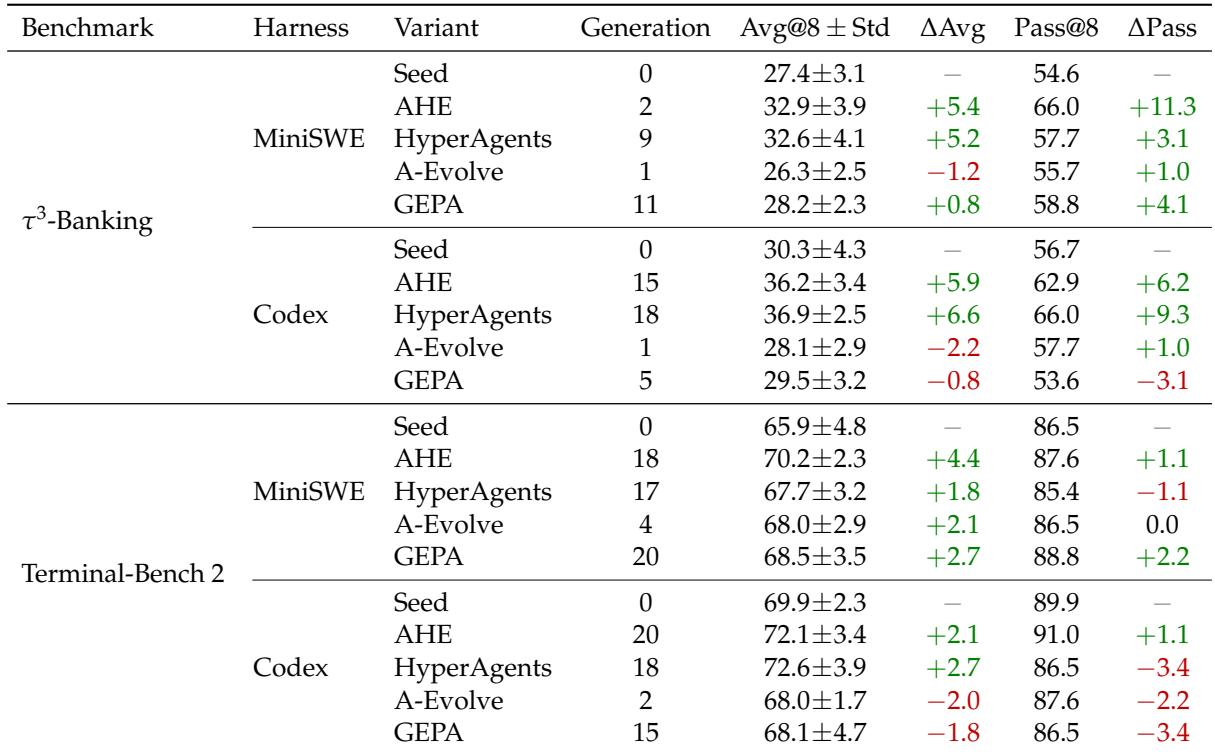
在报告的 MiniSWE harness 结果中,AHE 在 τ3-Banking 上相对 Seed 同时提高了可靠性和经验覆盖率,在所列变体中提升最大,并且在 Codex 上也同时改善了这两个指标。各方法之间提升并不一致:A-Evolve 在 τ3-Banking 上略微降低了平均可靠性但仍改善了覆盖率,而 HyperAgents 在可靠性上的提升大于覆盖率。更大范围的谱系计数同样表明,可靠性提升和覆盖率提升是两种不同的结果,一些谱系使两个指标朝相反方向变化。AHE 在 τ3-Banking 上取得了所列 MiniSWE 变体中最大的可靠性和覆盖率提升,并且在 Codex 上也同时改善了两个指标。A-Evolve 是所列 MiniSWE 变体中唯一在 τ3-Banking 上降低平均可靠性的方法,尽管覆盖率有小幅增加。在所有谱系中,可靠性和覆盖率提升并非总是一致:四个谱系改善了一个指标却降低了另一个指标,另一个谱系仅改善了可靠性。
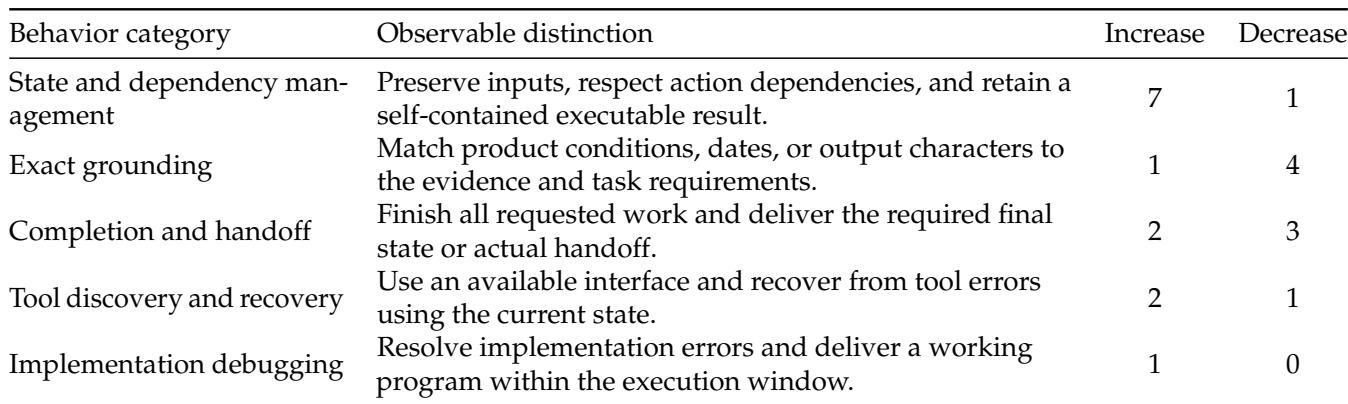
任务级成功变化按行为类别分组,显示出不同的增加和减少模式。状态与依赖管理最常伴随成功增加出现,而精确 grounding 与完成交接往往更多伴随成功减少出现。这些混合变化表明,即使整体指标改善,覆盖率也并非均匀扩展。状态与依赖管理是与重复成功增加最常相关的类别,在成功减少中只占很少一部分。精确 grounding、完成与交接则呈相反趋势,成功减少多于成功增加。所选比较显示任务间同时存在收益和损失,因此聚合改善可能掩盖任务级覆盖率波动。
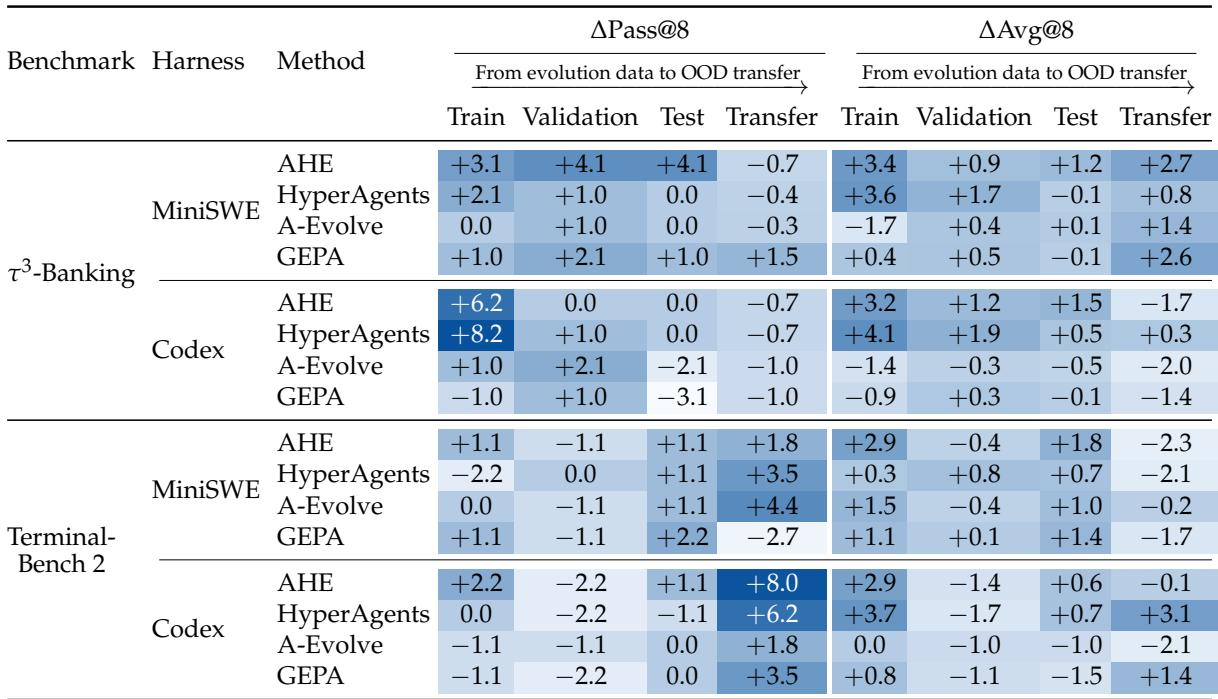
Seed 相对收益在不同方法、划分和迁移目标之间存在差异。迁移平均可靠性对所有列出的 MiniSWE 方法均为正,而迁移覆盖率仅对 GEPA 为正,对其他 MiniSWE 方法为负。所列 Codex AHE 结果显示出较大的训练收益,但在验证或测试覆盖率上没有收益,并且在两个报告结果上迁移均为负。在所列 MiniSWE 通用任务行中,四种方法中有三种迁移覆盖率下降,而四种方法的迁移平均可靠性都改善。GEPA 是唯一具有正迁移覆盖率的所列 MiniSWE 方法,而其他 MiniSWE 方法尽管迁移可靠性为正,迁移覆盖率仍为负。
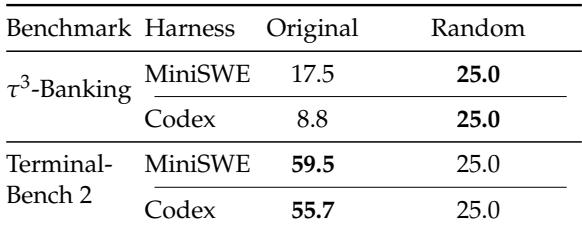
实验报告了在两种 harness 下,通用和编程基准上 Original 规则和 Random 基线的最佳 parent 选择率。在通用任务上,Original 选择低于随机基线,但在编程任务上高于随机基线,且这一模式在两种 harness 下相同。这表明当前分数与改进潜力的一致性在编程领域强于通用领域。在通用任务上,Original 在两种 harness 下选择最佳 parent 的频率都低于随机。在编程任务上,Original 选择最佳 parent 的频率高于随机,在两种 harness 下都超过 55%。
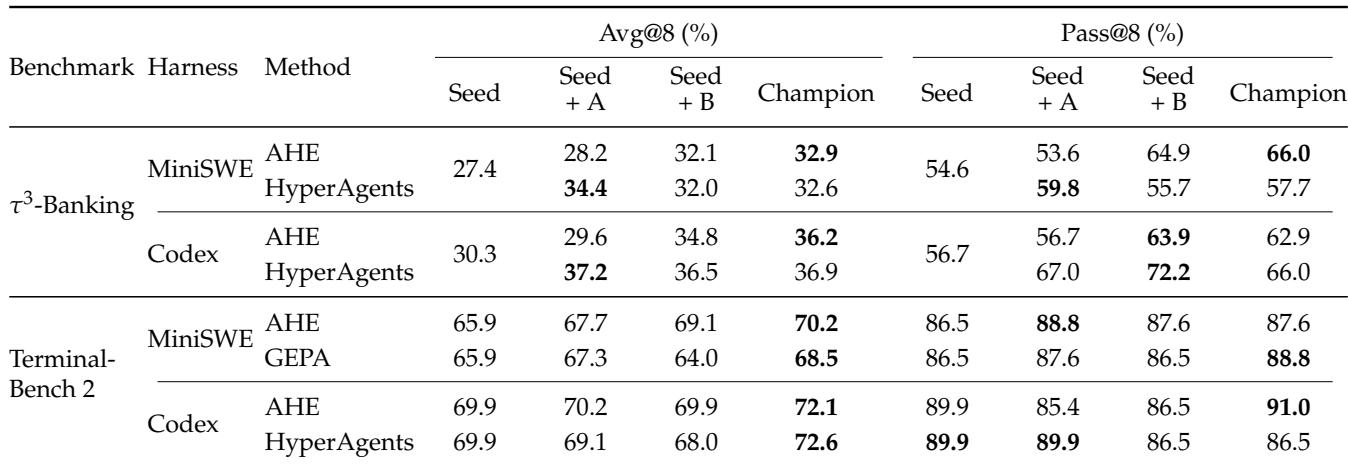
证据比较了跨基准、harness 和评估指标的 seed 性能、单独组件添加和完整 champion。完整 champion 通常获得最高的可靠性和通过率,尤其是在编程任务设置中,而单个组件带来的提升较小或不够一致。少数通用任务案例中,某个子集优于完整 champion。在可靠性方面,16 个具体组件变更中有 15 个优于对应的通用提醒,并且在每个评估案例中至少有一个组件有所改善。8 个完整 champion 中有 6 个优于任一单独组件,涵盖所有编程任务案例;在一个编程案例中,只有完整 champion 相对 seed 有所改善。
实验比较了 MiniSWE 变体在可靠性和覆盖率上的表现,考察了迁移下的任务级行为变化,评估了 parent 选择相对随机基线的效果,并对单独组件与完整 champion 进行了消融。AHE 取得了最大的可靠性和覆盖率提升,而 A-Evolve 降低了可靠性;聚合指标改善常常掩盖任务级波动,状态与依赖管理改善,但精确 grounding 与完成交接下降。迁移通常会改善可靠性,而大多数方法的覆盖率下降;原始 parent 选择仅在编程任务上优于随机;完整 champion 通常提供最佳通过率,尤其是在编程领域。