Command Palette
Search for a command to run...
通往真实世界的最后一公里:智能体原生原语作为求解真实世界任务的可复用构建模块
通往真实世界的最后一公里:智能体原生原语作为求解真实世界任务的可复用构建模块
摘要
智能体如何端到端地处理真实世界任务?尽管 LLM 智能体近来取得进展,但前沿模型与为其构建的执行框架配合,在真实世界任务公开基准上仍然不足:在 Terminal-Bench 4.0 上以最大推理努力运行时,GPT-5.6 Sol 配合 Codex 可解决 37.3% 的任务,Claude Opus 5 配合 Claude Code 可解决 51.8%。这些任务在从触及资源到应用资源的环节上失败,我们称之为通往真实世界的最后一公里:一次工具调用必须将其参数建立在依据之上,而这些依据通常来自先前调用的输出;每个结果必须到达消费它的步骤;一次失败必须回溯到它所牵连的工作。现有方法让资源变得触手可及,却将应用资源的胜任能力留在调用者一侧,因此每个执行框架都要重新构建这种能力。为弥补这一差距,我们提出了智能体原生原语(agent-native primitives)——一种为资源配备常驻 LLM 的可复用单元,由该 LLM 在上下文中应用资源并与其他原语通信;并提出 HEELO(围绕演化式智能体原生原语、面向真实世界任务最后一公里的执行框架工程),即一个从这类原语库中为每个任务构建执行框架的工程框架。HEELO 将任务所需的原语组合成任务特定的图,依据任务环境中的证据验证结果,并修订失败所牵连的原语;在验证通过后,将新的或改进的原语纳入原语库。我们的伴随研究证明:无论原语库多大,激活都受任务需求约束;这些结果还确定了按任务组合优于最佳固定执行框架的时机。然而,每个任务领域都对最后一公里提出了各自的需求,因此我们用八个原语家族实例化 HEELO,每个原语家族都针对一类真实世界任务构建,并在二十多个基准上对其进行了评估。在每个对照方法的骨干上,Dev-Primitives 将 Terminal-Bench 4.0 的解决率从 Codex 下的 37.3% 提升到 55.5%。在 mini-SWE-agent 种子执行框架上,按任务组合的 Harness Primitives 在 100 个 SWE-bench Verified 任务上将 Pass@1 从 73.0% 提升至 80.5%,在 45 个 Terminal-Bench 2.0 任务上将其从 60.0% 提升至 72.2%,高于 Codex 的 79.0% 和 56.7%。Tool Primitives 将 ToolBench 通过率从 55.8% 提升至 75.1%;Code Primitives 将仓库交付从 0.3180 提升至 0.5134;Agent Primitives 将八个数学、代码和 QA 基准上的平均准确率从单个智能体的 58.8% 提升至 75.3%;Navigation Primitives 将 GAIA-Text-103 准确率从 45.6% 提升至 58.3%。在形式化定理证明中,Math Primitives 在 95.0% 的留出 Putnam 问题上将带标注的参考方法排入前五,而最强重排器为 84.2%。进一步分析表明,收益来自在相应原语内部应用每种资源,并且由任务决定运行哪些原语。在这些基准之外,我们构建了 heelo.dev,一个面向真实世界动作的智能体原生原语平台。在其 46 个真实世界任务上,Claude Opus 5.5 配合 Claude Code 和 GPT-6.1 Sol 配合 Codex 各自独立完成 9 个任务;当通过我们的 MCP 服务器连接到 HEELO 后,分别完成 39 个和 35 个,且每个已完成任务的耗时分别减少 1.9 倍和 2.3 倍,成本降低 1.55 倍。HEELO 为构建端到端处理真实世界任务的智能体提供了统一框架。
一句话总结
伊利诺伊大学厄巴纳-香槟分校、佐治亚理工学院和 heelo.dev 的研究人员提出了 agent-native 原语和 HEELO 框架,其中 agent-native 原语是配备 LLM 的可复用单元,可组合为任务特定图,并通过基于证据的验证和库修订进行改进,从而提升了真实任务基准表现,包括 Terminal-Bench 4.0、SWE-bench Verified、ToolBench 和 heelo.dev 任务。
核心贡献
- 提出了 agent-native 原语:一种为资源配备驻留 LLM 的可复用单元,使资源能够结合上下文被应用并与其他原语通信;同时提出了 HEELO 框架,该框架将原语组合为任务特定图,根据环境证据验证结果,修订涉及的原语,并发布经过验证的原语。
- 将 HEELO 实例化为八类原语族,并在二十多个基准上评估;例如,Dev-Primitives 将 Terminal-Bench 4.0 在 Codex 下的解决率从 37.3% 提高到 55.5%,Tool 原语将 ToolBench 通过率从 55.8% 提高到 75.1%,Agent 原语将八个数学、代码和 QA 基准的平均准确率从 58.8% 提高到 75.3%。
- 通过 heelo.dev 和一个 MCP server 在 46 个真实任务上展示真实部署,其中 Claude Opus 5.5 配合 Claude Code、GPT-6.1 Sol 配合 Codex 各自单独完成 9 个任务,使用 HEELO 后分别提升到 39 个和 35 个,完成每个任务的时间分别减少 1.9 倍和 2.3 倍,成本降低 1.55 倍。伴随分析表明,激活受任务需求约束,收益源于在原语内部应用资源。
引言
大型语言模型 agent 旨在通过工具、代码仓库、证明、文档和其他 agent 端到端地完成真实任务。尽管 Codex 和 Claude Code 等 harness 使这些资源可被访问,前沿 agent 在实际基准上仍有不足,失败往往发生在最后一公里:资源必须结合上下文被应用,与其他步骤组合,并根据观察到的证据进行修订。以往工作往往让资源保持被动,而将应用资源的能力留给中心调用方或单体 agent,因此每个任务都需要重建这种能力,并且随着库增长更难以验证。作者通过提出 agent-native 原语解决这一问题,这类可复用资源带有驻留 LLM,用于应用资源并与其他原语通信;作者还提出 HEELO,一个 harness 工程框架,从不断演化的原语库构建任务特定图,仅修订由任务证据涉及的原语,并通过独立的验证路径接纳新的或改进的原语。
方法
作者利用可复用的 agent-native 原语库为真实问题构建任务特定 harness。真实任务 q 带有上下文 cq,包括输入、环境、约束和验收标准。agent 通过 harness H 对任务进行操作,H 是控制程序,决定运行哪些操作、以何种顺序运行以及何时停止执行。与为每个任务依赖固定 harness 不同,该框架从可复用单元库 L 构建任务特定 harness,目标是最大化期望得分 R(q,H)=Eτ[Rq(τ)∣H]。
该系统的核心构建块是 agent-native 原语。一个 agent-native 原语 Pi 为可复用资源 ai(例如工具 schema、代码组件或证明方法)配备驻留 LLM M,并暴露接口 di。当它在上下文 ci 中收到自然语言请求 xi 时,驻留 LLM 应用该资源并返回结果 ri 以及发送给其他原语的消息 mi:
(ri,mi)=Pi(xi;ci)=M([ai;ci;xi])这种设计使原语能在选择前评估自身的相关性,判断它是否适用于请求并提出使用方式。它还执行携带验证,在返回结果前应用资源自身的验证机制,例如测试或 schema。
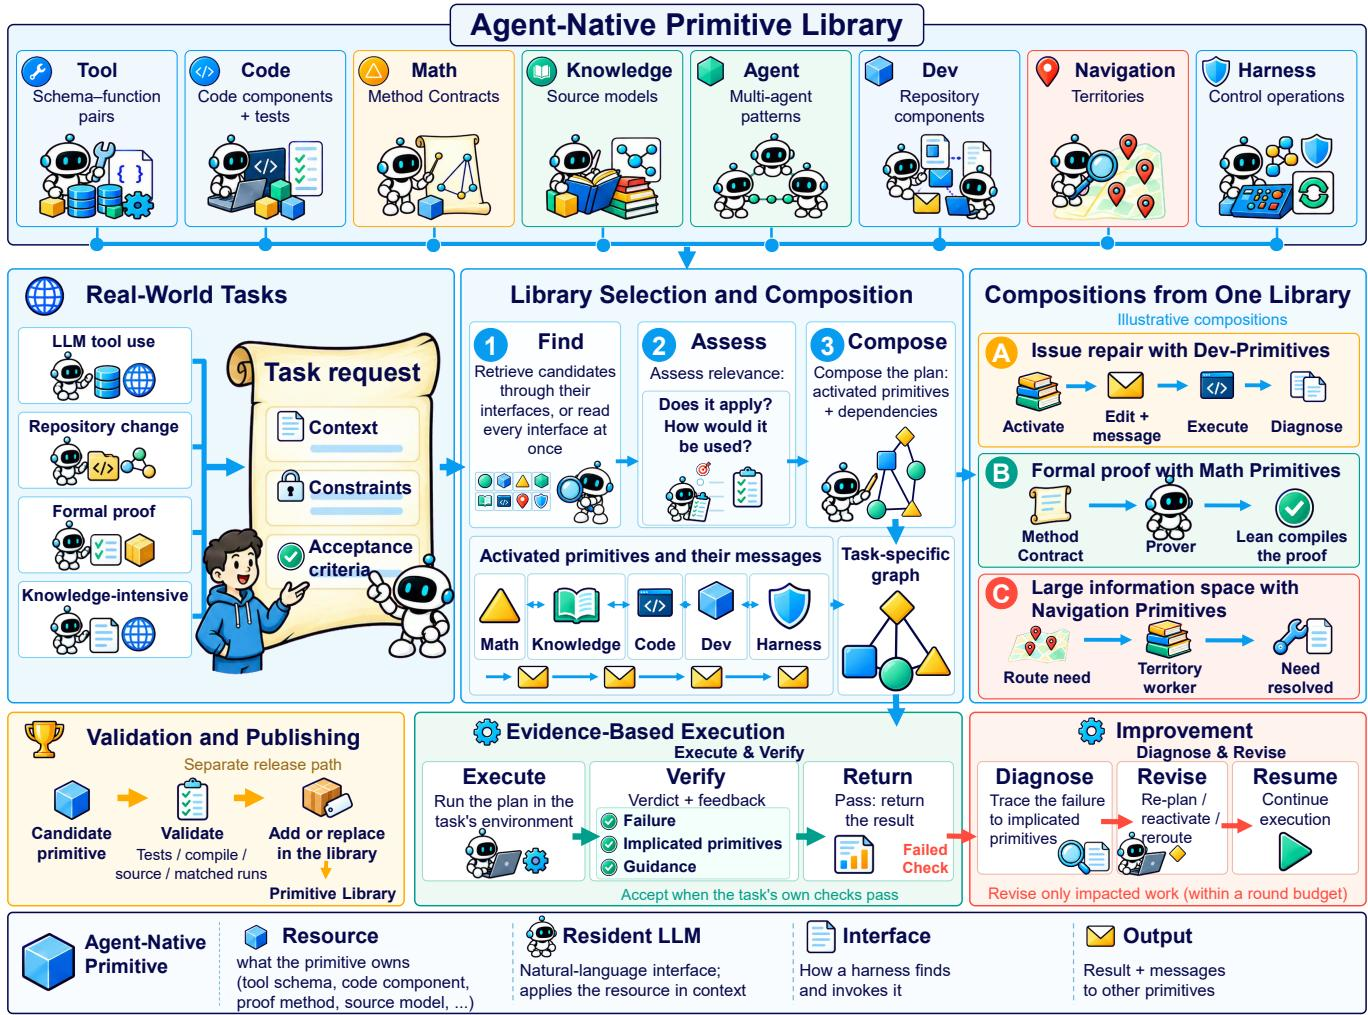
该框架通过三个主要机制实现 harness 构建和执行。第一,库选择与组合(COMPOSE)构建 harness。由于库通常包含的原语多于单个任务所需,COMPOSE 通过原语接口找到候选者,读取它们的相关性评估,并构建任务特定计划 Πt=COMPOSE(q,Ct;L)。该计划定义了激活集合 At 和依赖图 Et,规定结果和消息如何在被激活的原语之间流动。
第二,基于证据的执行与改进负责运行并修订计划。在每一轮 t 中,被激活的原语执行动作,其结果被整合到任务状态 St 中。系统在任务环境中执行计划以收集证据 ot,例如构建状态或测试结果。验证步骤产生裁决 vt∈{PASS,FAIL} 和结构化反馈 ϕt,其中指明观察到的失败、涉及具体原语并提供修订指导。如果任务失败,上下文会加入这些反馈,COMPOSE 会修订计划,仅更改涉及的工作:
Ct+1=Ct∪{ϕt},Πt+1=COMPOSE(q,Ct+1;L,Πt,ϕt)该循环持续到任务通过或修订预算耗尽。
第三,验证与发布在任务之间改进库。新的或改进的原语,可以来自制品挖掘,也可以来自经过验证的运行收集,只有在通过独立的验证路径后才能进入库:
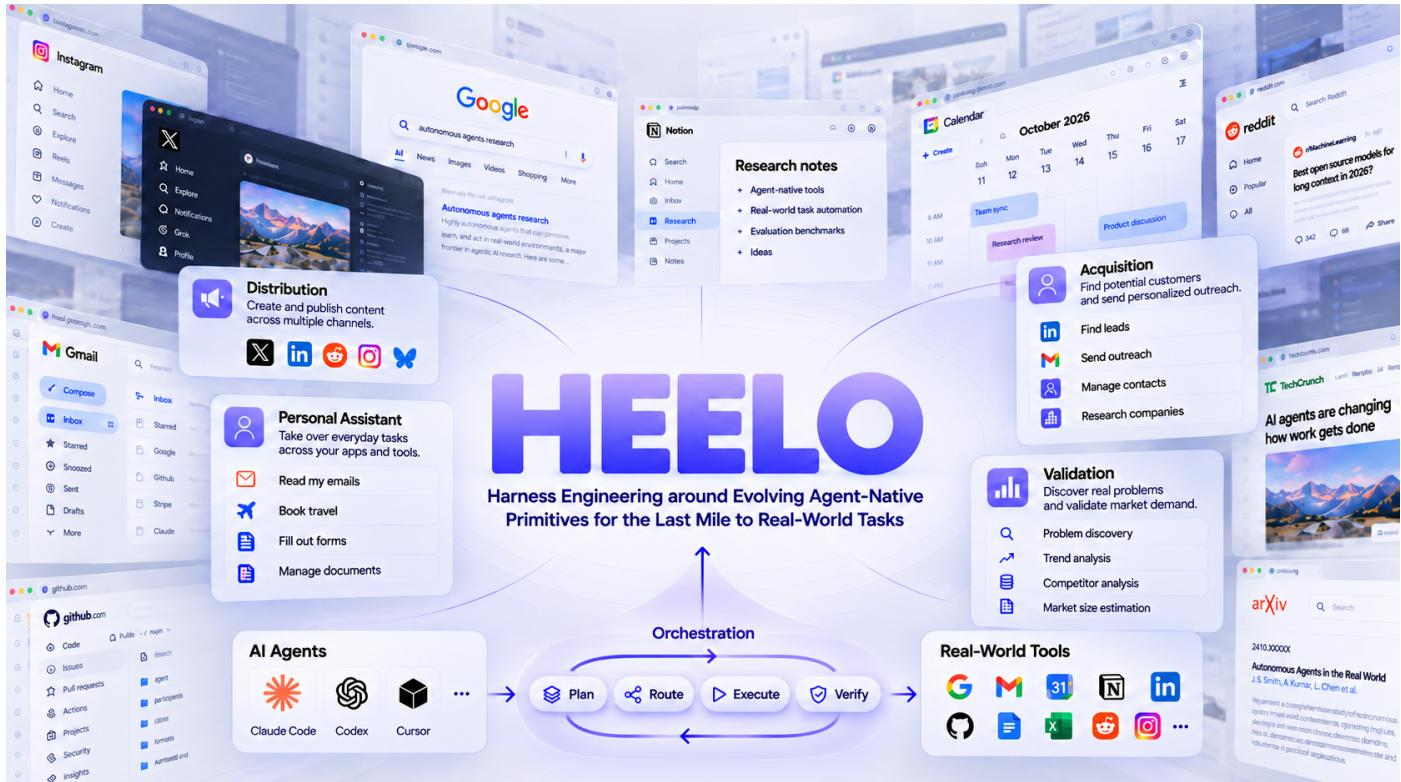
Lk+1=Lk⊕{P~∈P~k:VALIDATE(P~)=PASS}该方法被实例化为八类原语族,包括 Tool、Code、Math、Knowledge、Agent、Dev、Navigation 和 Harness 原语,每类针对特定真实任务领域。为了在真实环境中评估该方法,作者构建了 heelo.dev 平台,该平台将第三方操作暴露为 agent-native 原语,并通过规划、路由、执行和验证循环为内容分发、客户获取和个人助理等任务进行编排。
实验
在八类原语族和一个真实平台上,实验将 HEELO 与任务特定基线和消融进行对比,结果显示,在原语内部应用资源、保留结构化通信通道以及按任务需求激活或修订原语带来了持续收益。结果表明,收益来自原语本身、其携带字段、验证与诊断机制以及按任务条件的组合,而不是来自额外推理或单纯的检索访问。在真实 heelo.dev 评估中,将 Claude Code 和 Codex 接入 HEELO 后,能够完成这些 agent 单独无法完成的基于账户和基于服务的任务,同时降低完成每个任务的时间和成本。
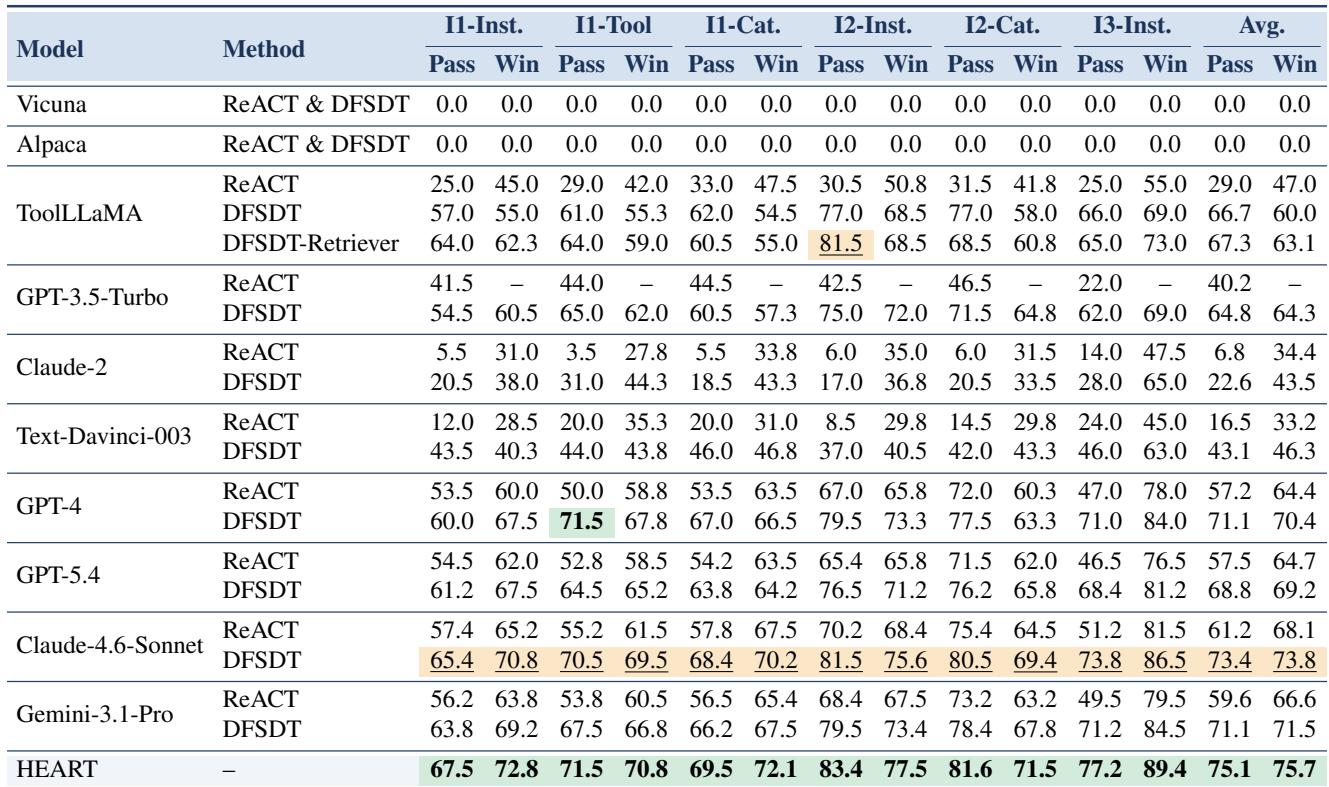
在六个 ToolBench 划分上,使用 Qwen3-8B 的 HEART 在已报告系统中取得了最佳平均通过率和胜率,优于商业参考和微调参考。其领先幅度在最困难、需要跨 API 依赖的多工具指令划分上最大。Vicuna 和 Alpaca 在所有划分上均失败,而 ToolLLaMA 通过 DFSDT 和 retriever 增强有所提升,但仍低于 HEART。HEART 在六个 ToolBench 划分上的平均通过率和胜率领先所有已报告参考系统。最大的性能差距出现在最困难的多工具指令和跨 API 依赖划分上,HEART 在该划分上取得最高胜率。带有 DFSDT 和 retriever 的 ToolLLaMA 是最强的微调参考,但在平均通过率和胜率上仍落后于 HEART。Vicuna 和 Alpaca 在每个划分上的通过率和胜率均为零,突出了该基准的难度。
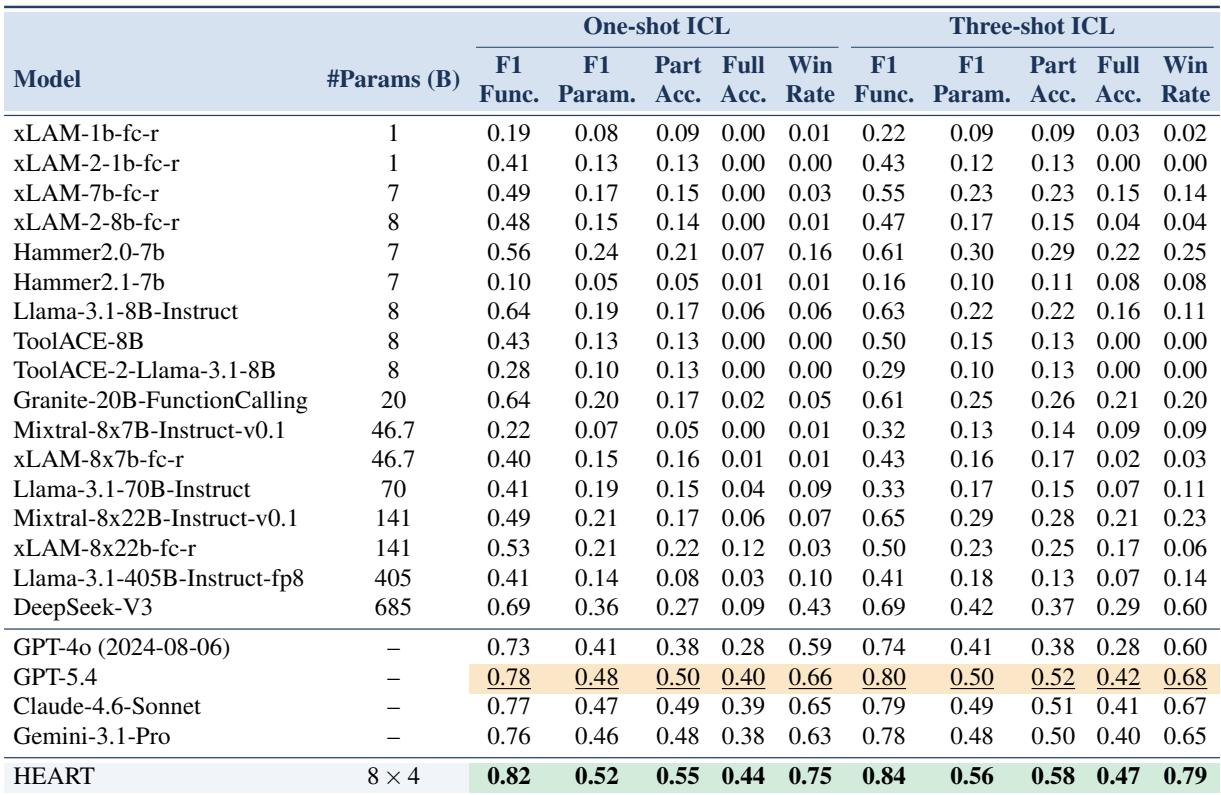
在 NESTFUL 嵌套调用序列上,HEART 在函数与参数 F1、部分和完整序列准确率以及 one-shot 和 three-shot 设置下的胜率方面均领先参考模型。其完整序列准确率在两种设置下均高于最强基线 GPT-5.4。较小的微调函数调用模型(如 xLAM 变体和 Hammer2.0)在嵌套序列上仍然弱得多,完整序列准确率通常接近零。HEART 在 one-shot 和 three-shot 两种演示下,在全部五项 NESTFUL 指标上均最佳。HEART 的完整序列准确率在 one-shot 下达到 0.44,在 three-shot 下达到 0.47,高于 GPT-5.4 的 0.40 和 0.42。HEART 的胜率在 one-shot 下为 0.75,在 three-shot 下为 0.79,而 GPT-5.4 分别为 0.66 和 0.68。微调 xLAM 模型在 one-shot 下完整序列准确率接近零,说明嵌套工具调用的难度。
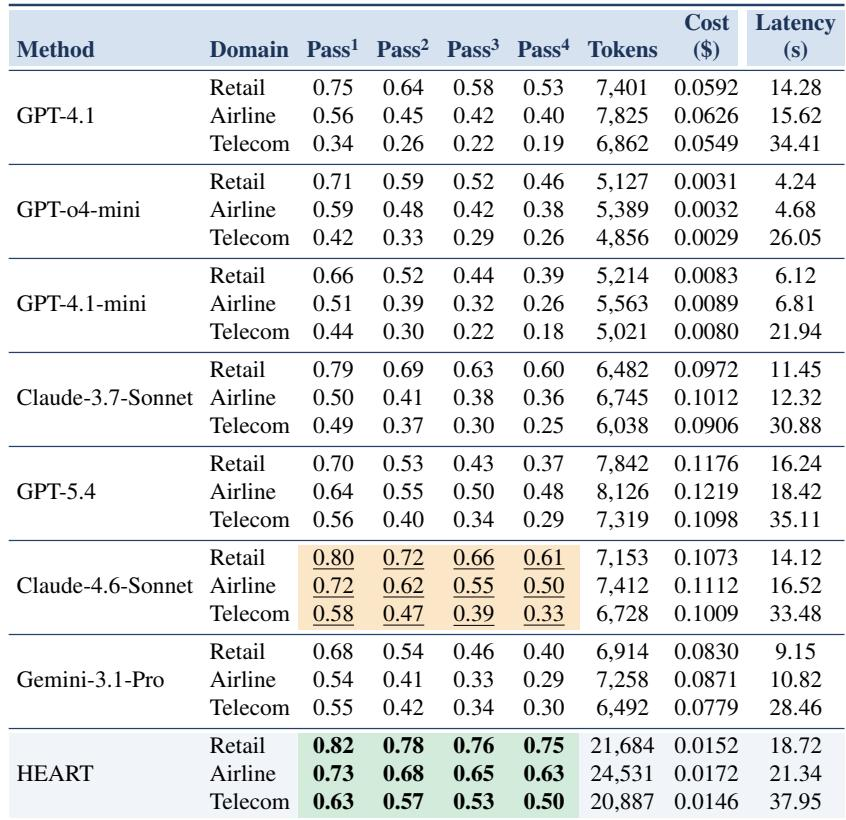
在已报告的参考模型中,成功率在零售领域最高,在电信领域最低,而且当通过标准要求更多次独立成功试验时,所有模型的表现都会下降。GPT-4.1 在零售领域领先,而 GPT-o4-mini 在航空和电信领域更具竞争力,并且 token 使用量、成本和延迟低得多。在每个已报告模型和领域中,通过率从 Pass^1 到 Pass^4 均下降,说明更严格的重复试验成功要求会降低可靠性。GPT-o4-mini 在 token、成本和延迟上低于 GPT-4.1,同时取得已报告的最强电信通过率,不过 GPT-4.1 在零售领域仍最强。
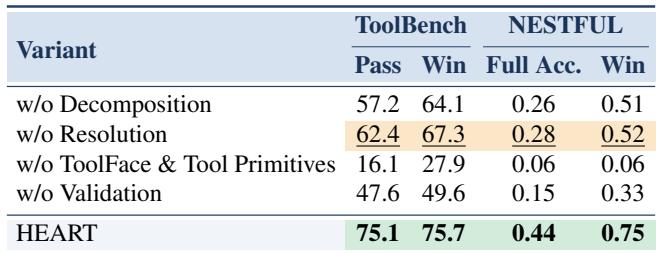
完整 HEART 配置在 ToolBench 和 NESTFUL 上表现最好。移除任何单个 harness 机制都会降低结果,其中最大的下降发生在移除 ToolFace 及其 Tool 原语时。结果验证是第二关键的组件,而移除请求分解或值解析会导致较小但仍明显的下降。移除 ToolFace 和 Tool 原语在所有指标上造成最陡下降,将 ToolBench 通过率降到完整配置的五分之一左右,并几乎消除 NESTFUL 准确率。移除结果验证是第二严重的消融,损失大于移除请求分解或值解析。完整配置在每列中都领先,而分解或解析的消融保留了中等性能,确认所有组件都有贡献,但部分组件更为关键。
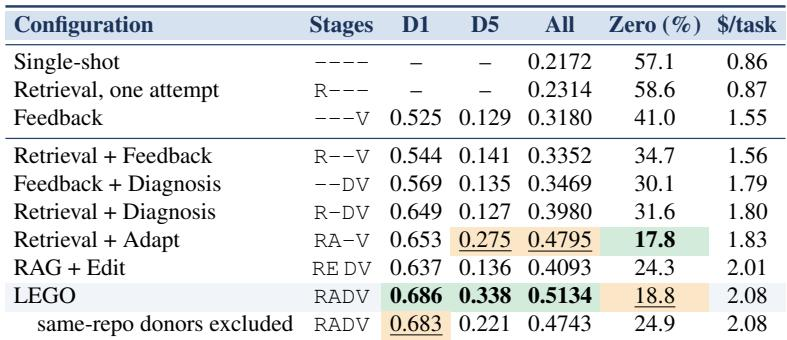
在 522 个仓库的构建基准上,与 single-shot 和 retrieval-only 基线相比,加入执行反馈和诊断可提高交付得分并降低零分率。最强配置 retrieval plus adaptation 在小型、大型和全部任务集上取得最高交付得分和最低零分率,同时其记录调用成本高于单次尝试基线。在所有配置下,大型任务仍然比小型任务难得多。single-shot 和 retrieval-only 单次尝试运行的整体交付得分最低,零分率最高,约为 57-59%。retrieval plus adaptation 在 D1、D5 和整体交付得分上领先,并将零分率降至 17.8%。在反馈中加入诊断后,零分率在比较配置中第二低。记录调用成本随着阶段增加而上升,从单次尝试基线的不到 1增加到retrievalplusadaptation的约1.83。即使最佳配置在最大任务上的得分也远低于最小任务,说明仍然存在持续的难度差距。
实验在 ToolBench 和 NESTFUL 函数调用基准、领域特定可靠性测试、消融和一个仓库构建基准上评估 HEART。使用 Qwen3-8B 的 HEART 在平均 ToolBench 通过率和胜率上优于参考系统,在多工具跨 API 任务上优势最大,并且在 one-shot 和 three-shot 设置下的 NESTFUL 嵌套调用指标上也处于领先。消融表明,ToolFace 及其 Tool 原语和结果验证是最关键的组件,而领域测试表明,重复试验通过标准会降低可靠性,模型优势因领域而异。在仓库构建中,加入执行反馈和 retrieval plus adaptation 显著提高交付得分并降低零分率,但记录调用成本更高。