Command Palette
Search for a command to run...
WeLM-Image:面向视觉智能的统一图像生成模型
WeLM-Image:面向视觉智能的统一图像生成模型
摘要
我们提出 WeLM-Image,这是一个统一的图像基础模型,将多模态理解融入文本到图像生成、指令引导编辑和多参考合成。该模型面向微信大规模消费级应用中的单 GPU 部署设计,将文本、参考图像和目标潜变量作为一个交错序列进行处理。其 Mixture-of-Transformers(MoT)主干网络将共享注意力与独立的理解和生成参数相结合,以限制优化干扰。每条路径配备 Mixture-of-Experts(MoE)模块以提供稀疏容量,存储参数为 31.7B,每个目标潜变量 token 激活约 5.4B 生成参数。面向生成的数据引擎将基于知识的视觉词表与大规模视觉聚类相结合,以平衡语义覆盖和编辑任务,同时训练时评估引导迭代式数据优化。双语标注和经过验证的编辑监督支持渐进式训练,直至原生 1.5K 分辨率。我们分别使用基于评分量规和检查清单的奖励对生成与编辑进行优化,然后通过噪声感知的在策略蒸馏整合专业化策略。在报告的综合对比中,1536 分辨率模型在 PRISM-Bench、Qwen-Image-Bench 和 UnicBench 上均位列所评估开源模型的第一名。基于 MeanFlow 的少步蒸馏得到 WeLM-Image-Turbo,在单个 NVIDIA H20 GPU 上使用 8 个无引导步骤生成 1024 × 1024 图像仅需 4.98 秒。
一句话总结
微信视觉(腾讯公司)的研究人员提出 WeLM-Image,一个统一的图像基础模型,用于文本到图像生成、指令引导编辑和多参考合成。该模型使用 Mixture-of-Transformers 骨干和 Mixture-of-Experts 模块(31.7B 存储参数、5.4B 激活生成参数)以支持单 GPU 部署;在报告的整体比较中,1536 分辨率模型在 PRISM-Bench、Qwen-Image-Bench 和 UnicBench 上位列所评估开源模型第一,而蒸馏得到的 WeLM-Image-Turbo 在单个 NVIDIA H20 GPU 上以 4.98 秒生成 1024 × 1024 图像。
核心贡献
- 提出 WeLM-Image,一个面向单 GPU 部署的统一图像基础模型,它将文本、参考图像和目标 latent 作为一个交错序列处理,以支持文本到图像生成、指令引导编辑和多参考合成。其 Mixture-of-Transformers 骨干将共享注意力与独立的理解和生成参数相结合,MoE 模块提供 31.7B 存储参数,每个目标 latent token 约激活 5.4B 生成参数。
- 描述了一个面向生成的数据与训练流程,该流程将知识锚定视觉词表与大规模视觉聚类、双语标注、经验证的编辑监督、训练时评估、渐进式训练到原生 1.5K 分辨率、任务特定的强化学习以及噪声感知的 on-policy 蒸馏相结合。
- 报告 1536 分辨率模型在 PRISM-Bench、Qwen-Image-Bench 和 UnicBench 上位列所评估开源模型第一。基于 MeanFlow 的少步蒸馏得到 WeLM-Image-Turbo,在单个 NVIDIA H20 GPU 上使用 8 个无引导步骤在 4.98 秒内生成 1024 × 1024 图像。
引言
作者研究面向微信等实际消费者服务中的图像生成与编辑问题,这些服务要求模型在严格的单 GPU 服务预算下处理长双语提示、准确文本渲染、复杂编辑、多参考合成以及大量请求。先前的图像基础模型以不同方式融合多模态理解,但可扩展的统一模型必须在语言建模与连续图像生成之间取得平衡,避免优化干扰,同时保持细粒度视觉控制。作者提出 WeLM-Image,一个统一图像基础模型,将文本到图像生成、指令引导编辑和多参考合成视为一个骨干网络中的交错文本和图像序列。其双路径 Mixture-of-Transformers 与 Mixture-of-Experts 设计将理解参数与生成参数分离,同时共享注意力在模型各处连接二者,并由专用 VAE 和文本兼容的 3D 旋转位置编码支持。
数据集
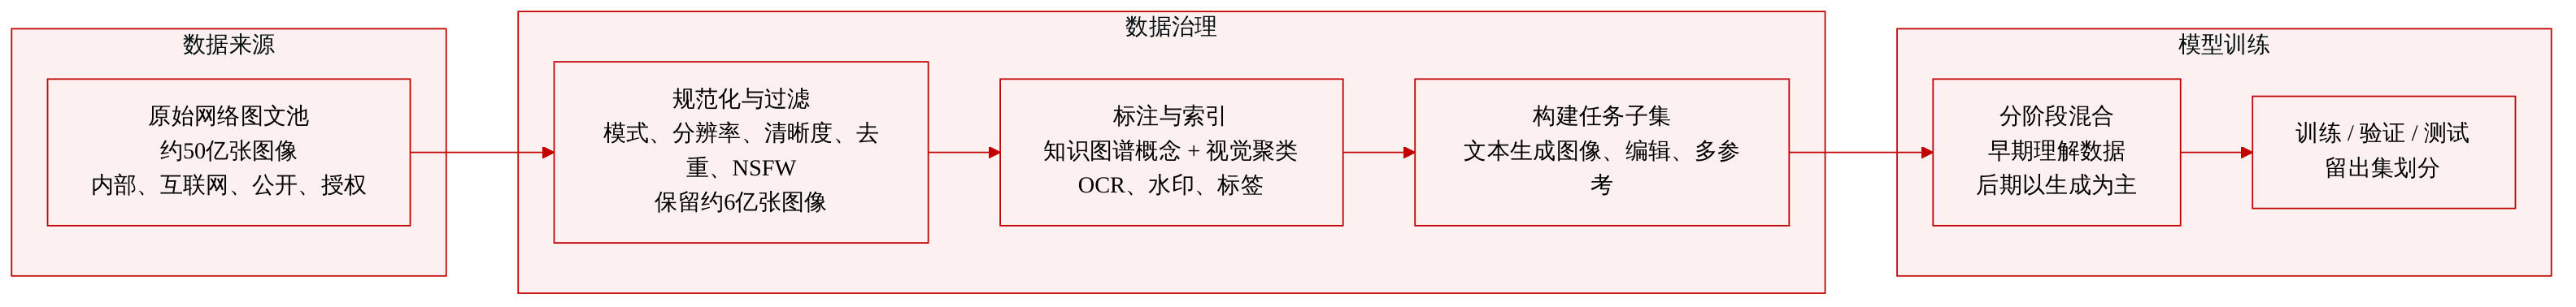
作者从原始网络规模图像-文本池构建 WeLM-Image 数据集,并重新组织用于可控生成、编辑和合成。流程总结如下。
数据来源与规模
- 原始池:约 50 亿张图像,来自内部数据、互联网数据、公开数据集和授权数据集。
- 筛选后池:经过质量过滤后约 6 亿张图像。
- 高分辨率占比:保留图像中 59.74% 达到 1024 分辨率或更高。
模式与过滤
- 每个样本被标准化为统一模式,保留图像身份、来源元数据、分辨率、宽高比、原始文本和存储信息。
- 质量过滤包括分辨率阈值、模糊和清晰度评估、去重以及带 NSFW 移除的安全过滤。
- 美学评分使用内部 Elo 式成对偏好模型,产生连续分数,用于后续数据混合构建。
- 过滤算子还保留细粒度质量、分辨率、安全和内容信号,用于下游采样、路由、混合构建和诊断。
标注与覆盖结构
- 大型 VLM 生成结构化标注,描述图像内容,用于检索、聚类、知识图谱对齐和任务构建。
- OCR 和水印算子识别文本密集型内容,例如截图、海报、广告、文档和 UI 布局。
- 语义标签捕获实体、属性、风格、场景和其他紧凑视觉语义。
- 知识锚定视觉词表:基于 Cilin 和微信知识图谱构建,经过 LLM 检查和 Qwen3 嵌入加重排序清洗,按层级组织,并扩展别名、描述短语、视觉关键词和搜索表达。
- 视觉聚类:使用 Qwen3-VL-Embedding 对图像编码,并在数亿张图像上通过球形 k-means 的平衡层级变体进行分组。
任务特定子集
- 文本到图像:KG 词表节点定义语义目标;概念到图像检索和图像到概念反向验证选择候选;每个概念的配额和全局唯一图像平衡长尾覆盖;标注使用随机双语模板,涵盖中性描述、简洁用户式表达和生成式提示;OCR 和水印信号被纳入文本密集型图像。
- 图像编辑:基于结构化编辑本体构建,涵盖对象添加、对象移除、背景替换、局部属性修改、人像编辑、产品编辑、修复和推理导向编辑;基于 VLM 的聚类到任务分配平衡类别;样本对来自聚类内的真实图像图和保持真实目标的反向构建;VLM 质量门验证源目标差异,提示多样化重写指令。
- 多参考:样本包含 2 到 4 张源或参考图像、一条指令和一个目标;角色包括身份、服装、对象、场景、风格或布局;定义 18 个任务;约 75 万张图像的实体池支持基于配额组装;反向构建保持真实目标,前向构建从真实源合成目标;VLM 过滤强制分辨率、去重、无源目标复制和可用性;数据集包含几十万示例。
- 理解数据:包括纯文本数据和来自 LLaVA-OneVision-1.5-Instruct、FineVision、Honey-15M 及专有描述数据的视觉语言指令数据;分类法涵盖 General VQA、Caption and Knowledge、Chart、OCR、Document、Grounding、Code、Math、Table、Science、Counting、GUI、Medical、Spatial 和 Egocentric 任务;过滤移除重复文本、低质量图像、极端宽高比和语言混合。反向对齐还可以将文本到图像数据转换为视觉语言对齐数据。
训练使用与混合
- 混合比例按训练阶段调度,而不是固定不变。
- 早期预训练保留面向理解的数据,以建立共享多模态接口。
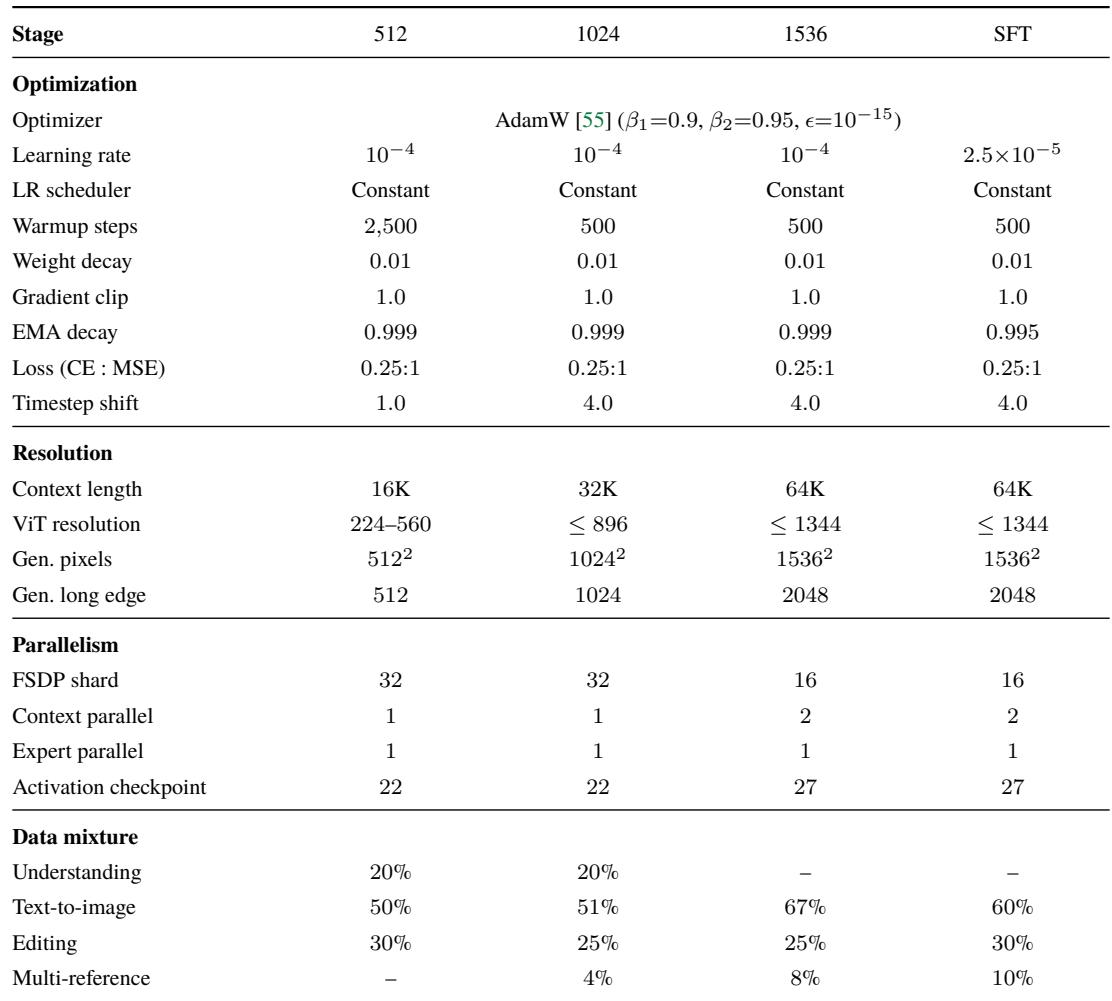
- 高分辨率继续训练和 SFT 将预算集中用于文本到图像、编辑和多参考生成,详见表 3。
- 训练时评估反馈到过滤阈值、检索查询、采样配额、任务分配和混合比例。
方法
WeLM-Image 是一个用于图像生成、指令引导编辑和多参考生成的统一模型。作者利用交错多模态序列表示,并结合双路径 Mixture-of-Transformers(MoT)骨干。该架构称为 MoT-MoE,在理解(UND)路径和生成(GEN)路径中均引入 Mixture-of-Experts(MoE)前馈层。
框架图如下:
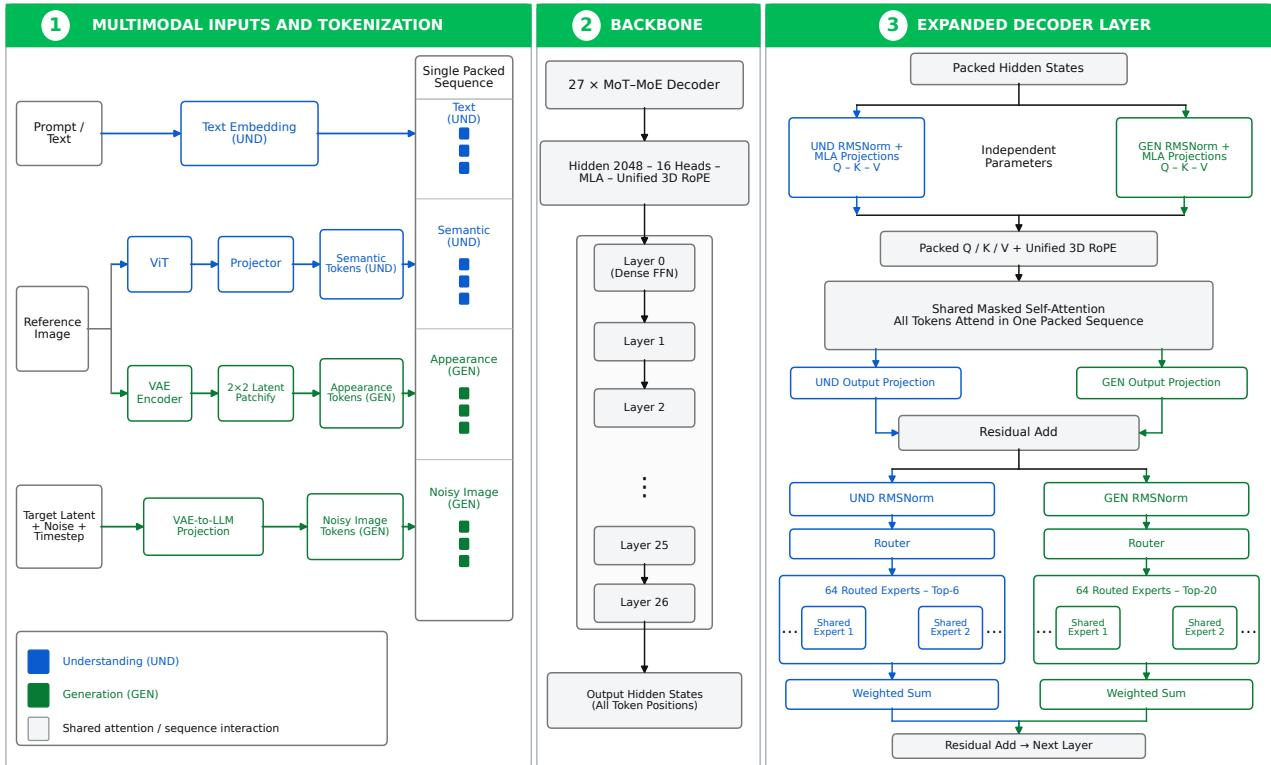
异构多模态输入被标准化为统一交错表示。文本和视觉元素被独立编码并投影到模型宽度的 token 序列。理解 token 包括文本和图像 Vision Transformer(ViT)特征,被路由到 UND 路径。生成 token 由干净和带噪图像 Variational Autoencoder(VAE)latent 组成,走 GEN 路径。学习到的路由器在所选路径内选择专家,而共享注意力耦合两条路径;两条路径在其他方面保持独立投影、归一化和专家。
为了处理文本问答、视觉理解、文本到图像合成和编辑等多种任务,模型采用统一的交错任务表示。模型、打包器和训练损失在单个有序多模态序列上运行,而不是任务特定格式。
如下图所示:
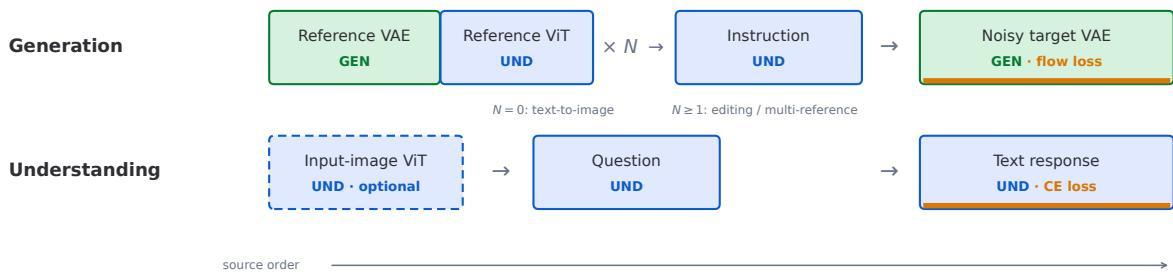
每个样本被序列化为保持源顺序的类型化文本和视觉段:
S=[S1;S2;…;SK],Sk∈{text segment, image segment}.在生成模板中,参考图像贡献相邻的 clean-VAE 段(GEN 路径)和 ViT 段(UND 路径)。指令走 UND 路径,而带噪目标 VAE 走 GEN 路径并接受 flow-matching 监督。设 N=0 得到文本到图像生成,而 N≥1 将模板扩展到编辑和多参考生成。在理解模板中,可选的输入图像 ViT 段和问题先于响应,next-token 交叉熵仅应用于响应。
每个图像段通过两个互补视觉编码器表示。ViT 编码器捕获高层内容,例如对象和空间关系,而 WeLM-Image-VAE 将图像映射为紧凑连续 latent,保留视觉细节以用于重建和生成。VAE 采用主成分压缩策略分三阶段训练:重建预训练、语义对齐和面向文本的解码器微调。语义对齐阶段联合训练轻量扩散 transformer,从损坏 latent 恢复高层语义特征,并通过匹配归一化自相似矩阵将其与冻结 DINOv2 编码器特征对齐:
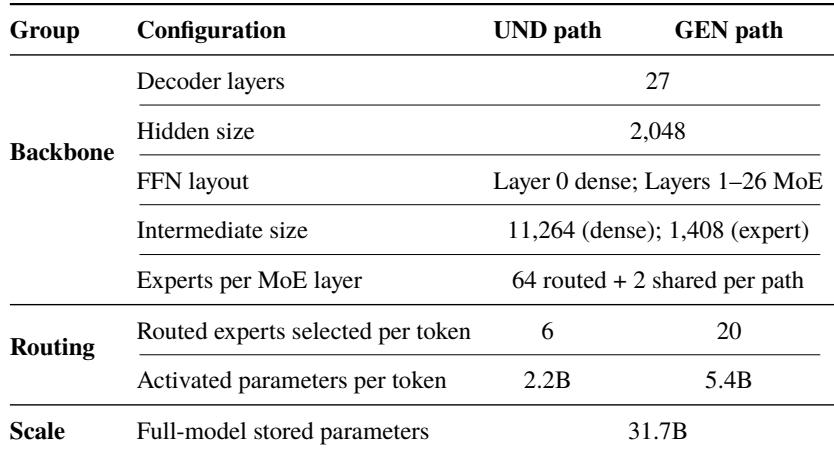
Lrep=rˉzrˉz⊤−rˉrˉ⊤F2,rˉ=∥r∥2r,rˉz=∥rz∥2rz.骨干包含 27 个解码器层。MoT 将理解和生成分离为独立参数路径,同时保留联合注意力进行跨模态交互。为了高效扩展,每个 MoT 路径配备独立的 MoE。第 0 层使用路径特定的密集前馈网络(FFN),而第 1 到 26 层将密集 FFN 替换为路径特定的 MoE 子层。
在每一个解码器层,隐藏状态按路径汇集,并通过路径特定的注意力前 RMSNorm 和多头潜在注意力(MLA)投影映射为查询、键和值。单个带掩码的缩放点积注意力操作在两条路径上共同应用。
注意力掩码图如下:
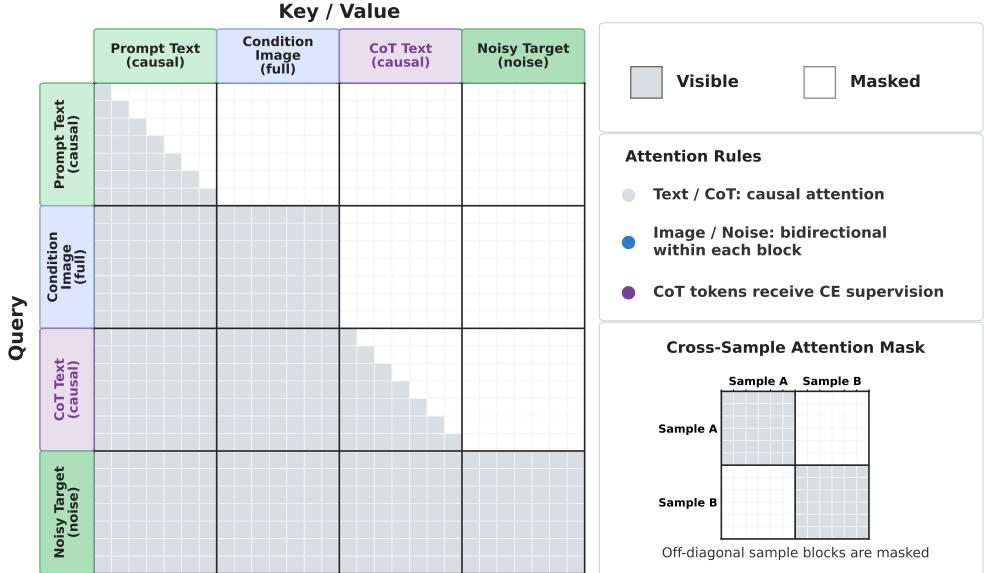
块结构化注意力掩码隔离打包样本,并强制任务依赖的可见性。文本遵循因果顺序,而 ViT 和干净参考 VAE token 在其段内使用双向注意力。带噪目标 VAE token 在目标 latent 网格内双向关注,并读取所有前置的非目标条件,但其键和值对其他段不可见,以防止目标泄漏。
在联合注意力之后,输出按路径重新分组,并通过 MoE 前馈子层。每个路径组合 64 个路由专家和两个始终活跃的共享专家。对于路径 p 上 token i 的隐藏状态 hi,前馈输出为:
FFNp(hi)=s=1∑2Ep,sshared(hi)+e∈Tp(i)∑αp,e(hi)Ep,erouted(hi).路由在 UND 路径使用 top-6 专家,在 GEN 路径使用 top-20 专家,并带有一个基于负载统计更新的非梯度校正偏置,以确保专家利用率稳定。
文本和视觉 token 共享一个注意力上下文,但需要不同的位置结构。作者将旋转嵌入提升到单三轴坐标系 (t,h,w),其中 t 是序列轴坐标,h,w 是空间坐标。
如下图所示:
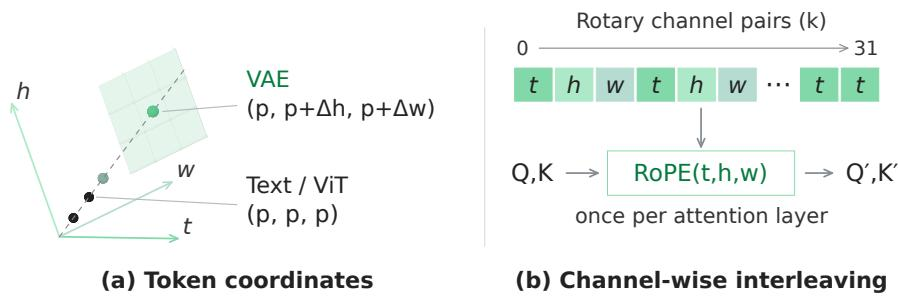
64 维旋转子空间形成 32 个通道对,其中 12 对分配给 t,h 和 w 各分配 10 对,以交错顺序排列。对于文本 token,坐标为 (p,p,p),确保与预训练 1D RoPE 精确兼容。VAE 外观 token 保持时间索引固定,同时添加居中空间偏移 (t,h,w)=(p,p+Δh,p+Δw)。
统一序列由独立的模态特定头解码。UND 路径上的文本状态通过自回归 next-token 预测训练。GEN 路径上的带噪目标状态被投影到 VAE latent 空间,以参数化 flow-matching 速度,并通过条件 flow matching 训练:
LFM=E[∥v^θ−v⋆∥22].联合目标结合交叉熵、flow-matching 和路由器正则化损失。flow-matching 损失在图像级别归一化,以防止较大图像主导目标。
作者构建面向生成的数据引擎,围绕可控生成任务重新组织网络规模数据。
数据流程示意图如下:
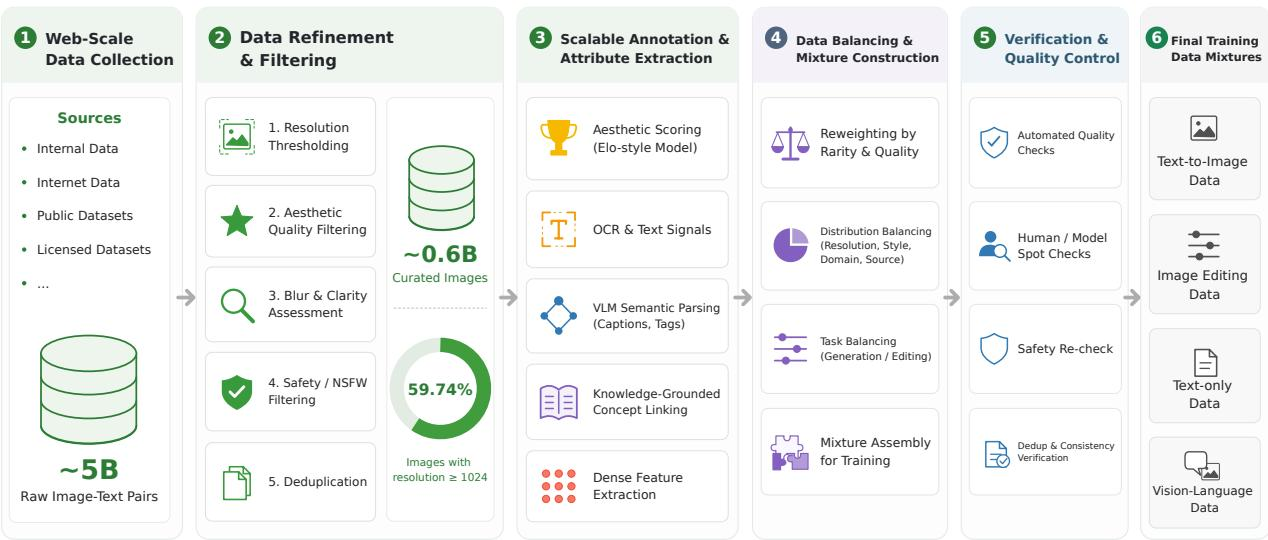
该流程清洗嘈杂网络数据以提高质量,保留经筛选的图像池。它沿知识锚定词表为命名视觉概念建立索引,并通过大规模视觉聚类为一致外观模式建立索引。在此组织化图像池上构建文本到图像、编辑和多参考生成的任务特定数据,训练时评估反馈到过滤和混合比例。
WeLM-Image 通过渐进预训练、指令监督微调(SFT)、任务分离强化学习(RL)和蒸馏阶段进行训练。双路径骨干的两条路径均从预训练语言视觉检查点初始化。
预训练分三阶段推进,将合成分辨率从 512 提升到 1536,上下文长度扩展至 64K tokens,同时将数据混合逐步转向生成任务。SFT 保持 1536 分辨率,并使用精选指令混合。
后训练将文本到图像和图像到图像编辑作为独立 RL 分支,使用 DiffusionNFT 优化。四个 VLM 奖励衡量 T2I 的图像文本对齐、美学、文本渲染和视觉自然度,而基于检查清单的奖励评估编辑。On-policy 蒸馏将两个 RL 专家的能力合并到单个学生检查点。最后,基于 MeanFlow 的少步蒸馏框架将模型压缩为无引导 8/4 步模型,用于高效推理。
实验
实验通过 NVIDIA H20 GPU 上的服务效率、文本到图像质量、文本渲染和图像编辑的定量基准以及定性案例研究,评估 WeLM-Image 作为统一生成与编辑模型。效率结果显示生成和编辑延迟与输入输出 tokens 近似线性扩展,蒸馏 Turbo 变体进一步降低成本;基准结果一致将 WeLM-Image 置于顶级开源模型之列,尤其在文本渲染、指令遵循以及单图和多图编辑方面具有优势。定性示例确认该模型可生成风格多样、文本丰富的图像,并能在保持预期内容的同时执行协调的多指令和基于参考的编辑。
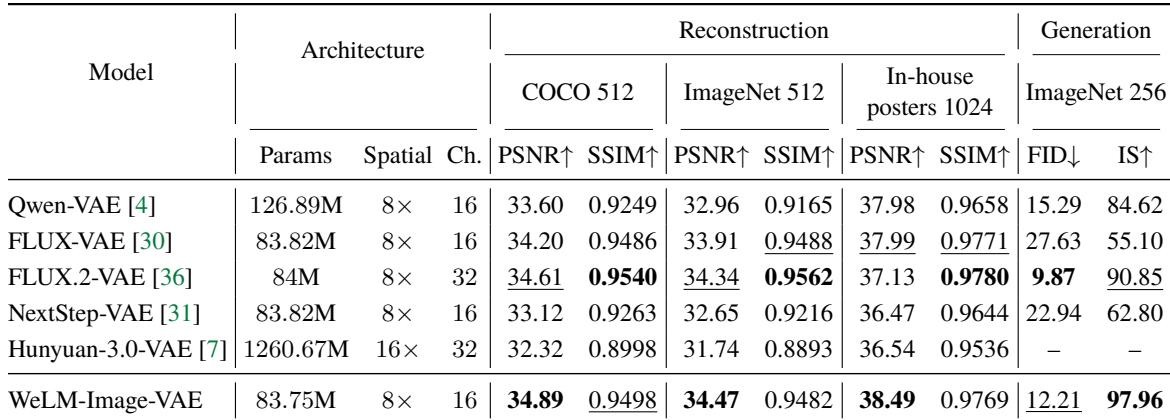
在被评估的 VAE 中,FLUX.2-VAE 在标准基准上实现最强重建保真度,并在 ImageNet 上取得最佳生成质量。FLUX-VAE 通常在重建上排名第二,而 Qwen-VAE 在生成上排名第二。Hunyuan-3.0-VAE 在标准基准上表现较弱,未进行生成评估。FLUX.2-VAE 在 COCO 和 ImageNet 上重建质量领先,也在 ImageNet 生成上取得最佳 FID 和 IS。FLUX-VAE 和 Qwen-VAE 分别在重建和生成中具有竞争力。在内部海报图像上,FLUX-VAE 和 FLUX.2-VAE 获得最高 SSIM 分数,而 FLUX-VAE 和 Qwen-VAE 在 PSNR 上领先。Hunyuan-3.0-VAE 在标准基准上的重建结果相对较弱,并缺少生成评估。
骨干将理解和生成分离为独立参数路径并共享联合注意力,在大多数解码器块中使用独立的 mixture-of-experts 前馈层。生成路径每个 token 路由到远多专家,并激活约 2.5 倍于理解路径的解码器参数。完整模型在存储总量中包含 ViT 编码器和冻结参数,但不包含 VAE。理解路径每个 token 使用 top-6 专家路由,生成路径使用 top-20 路由,形成较大的每 token 激活差距。理解 token 的激活解码器参数约为 2.2B,生成 token 约为 5.4B。第 0 层使用路径特定密集前馈网络,其余 26 层将密集前馈网络替换为路径特定 MoE 子层。每条路径拥有自己的 MoE 专家,而不是共享专家池,从而保持理解与生成之间的任务分离。
训练配方覆盖在不断提高分辨率和上下文长度上的渐进预训练,随后是监督微调。早期阶段保留适量理解数据以建立跨模态对齐,后期高分辨率和 SFT 阶段将混合限制为文本到图像、编辑和多参考生成。优化器设置在阶段之间基本保持不变,SFT 使用较低学习率。分辨率和上下文长度从 512 阶段逐步增长到 1024 和 1536 阶段。理解监督在 512 和 1024 阶段保留,但在 1536 和 SFT 混合中移除。SFT 阶段降低学习率,而优化器、权重衰减和梯度裁剪设置与早期阶段保持一致。并行设置保持 FSDP 分片和上下文并行大小的乘积固定为 32,专家并行设置为 1。
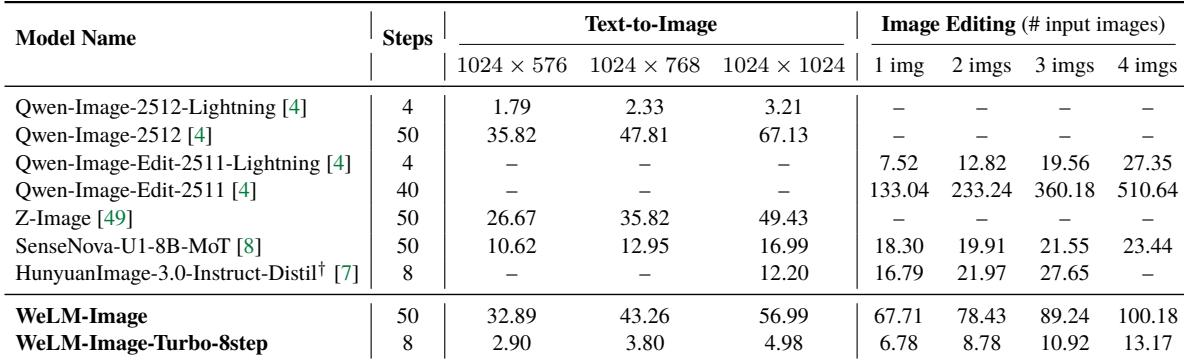
在 NVIDIA H20 GPU 上的延迟测量显示,少步无引导配置的端到端延迟远低于标准 classifier-free guidance 模型。对于标准的 50 步生成,延迟与输出像素近似线性扩展,而编辑延迟在若干基线中随输入图像数量急剧增长。SenseNova-U1-8B-MoT 是列出的最快的 50 步模型,并显示最平坦的多图编辑曲线,报告称在匹配 step 预算下 WeLM-Image 快于 Qwen-Image-2512。4 步 Lightning 配置与标准 40 到 50 步对应配置相比,在文本到图像和编辑任务中端到端延迟降低约一个数量级。Qwen-Image-Edit 的编辑延迟随输入图像从 1 增加到 4 急剧上升,而 SenseNova-U1-8B-MoT 在相同范围内几乎保持平坦。
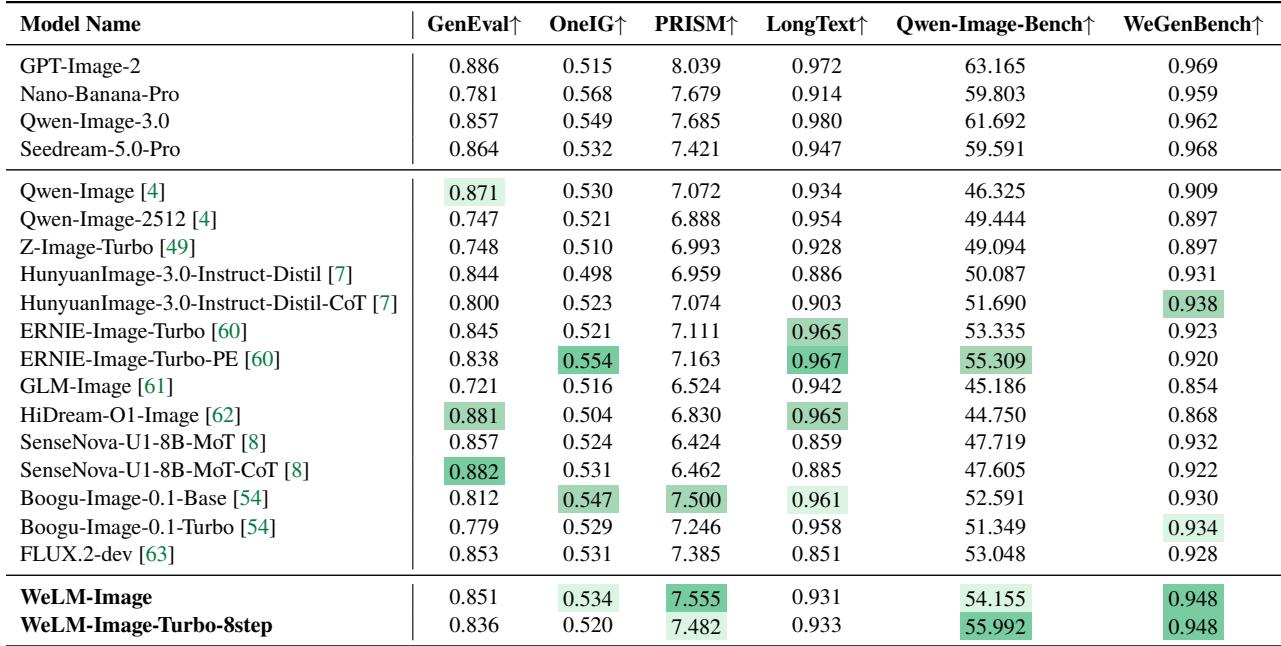
WeLM-Image 在文本到图像生成和文本渲染基准上表现出顶级开源性能,尤其在组合生成和视觉语言评估质量方面具有优势。闭源模型与开源排名突出显示分开处理。结果使 WeLM-Image 成为主流和新兴评估中领先的开源模型。WeLM-Image 在主流和新兴生成基准中位列顶级开源模型。它在 PRISM-Bench 上取得最佳开源总分,并在 Imagination、Style 和 Composition 上领先。在 OneIG-Bench 上,它在开源模型中取得第二对齐分数和总排名第三。WeLM-Image 系列在 GenEval 上表现强劲,Turbo-8step 变体在单对象生成分数上达到满分。
所评估实验覆盖 VAE 质量、模型架构、训练配置、推理延迟和生成基准。FLUX.2-VAE 是整体最强的 VAE,FLUX-VAE 和 Qwen-VAE 是有竞争力的替代方案;骨干将理解和生成分离为独立专家路径,生成路径激活显著更多参数。训练通过不断提高分辨率和上下文长度推进,并在后期移除理解数据;少步和 Lightning 配置大幅降低延迟;WeLM-Image 位列顶级开源模型,具有领先的组合和视觉语言质量。